单库单表到分库分表的平滑迁移
原创

背景
我们接下来用电商作为案例分享
业务视角
在业务初期,数据库基本上都是由单库单表实现的,这样既可以快速支持业务试错,同时又可以把资源成本控制到最低,但随着业务不断发展,数据量也会呈指数形式增长,最终会发现单库单表无法支撑业务快速发展,因此需要对现有数据库架构进行升级改造。
技术视角
根据前人经验,单表最多支撑2000W左右的数据,如果数据量再增长,则会影响读写效率,就需要对单库单表进行分库表的改造
单库单表存在的问题:
- 性能瓶颈:随着数据量的增加,数据库的读写、查询性能会逐渐下降。尤其当表中数据行达到百万级甚至更多时,即使是简单的查询操作也可能会变得非常缓慢
- 数据热点:所有数据操作都集中在一个数据库的一个表上,容易形成数据热点,导致某些数据行频繁被访问而成为性能瓶颈
- 高可用和灾备问题:单库单表的架构很难做到高可用性和灾备。一旦数据库发生故障,整个应用都会受影响。而且,数据恢复的时间较长,影响业务的正常运行。
- 扩展性问题:随着业务的发展,数据量和访问量不断增加,单库单表的架构很难通过简单的扩展来满足需求。水平扩展(增加更多的服务器)和垂直扩展(升级现有的服务器的硬件)都有局限性。
- 事务管理和锁竞争:在高并发的情况下,大量的事务和数据库操作会导致锁竞争问题,影响数据库的处理能力。
- 备份和维护难度:随着数据量的增加,对数据库进行备份和维护的难度和时间成本也会大幅度增加。
架构升级历程
参考:数据库架构演变过程
这里我们直接一步到位,实现单库单表到垂直拆库,水平分表
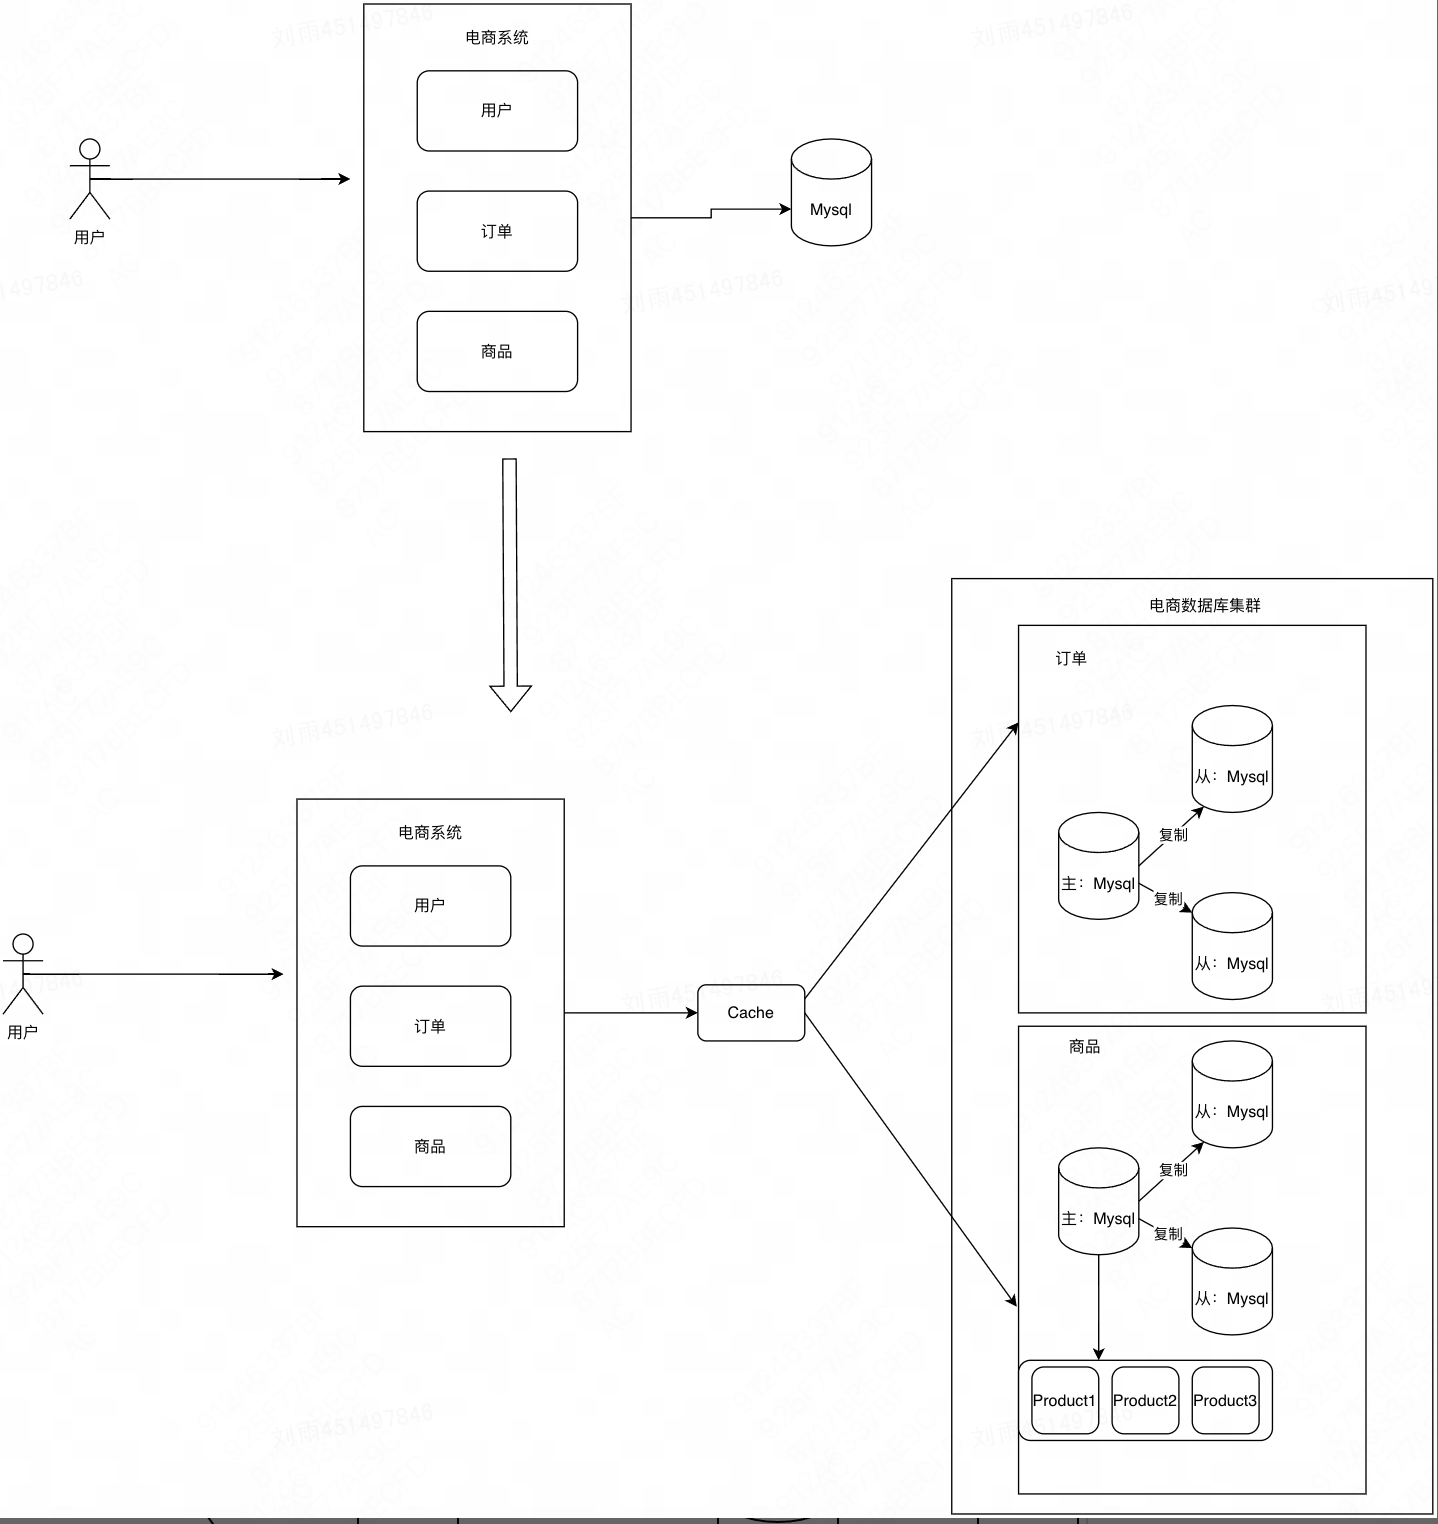
迁移过程
场景汇总
新老数据 | 读 | 写 |
|---|---|---|
老数据 | 是 | 是 |
老数据 | 是 | 是 |
迁移步鄹
- 实现新数据的读和写的能力
- 实现老数据到新数据的同步(监听binlog的方式)
- 实现新数据到老数据的同步(监听binlog的方式)
- 开始灰度新数据的读
- 新数据读全量后,关闭老数据的读
- 开始灰度新数据的写
- 新数据写全量后,关闭老数据的写
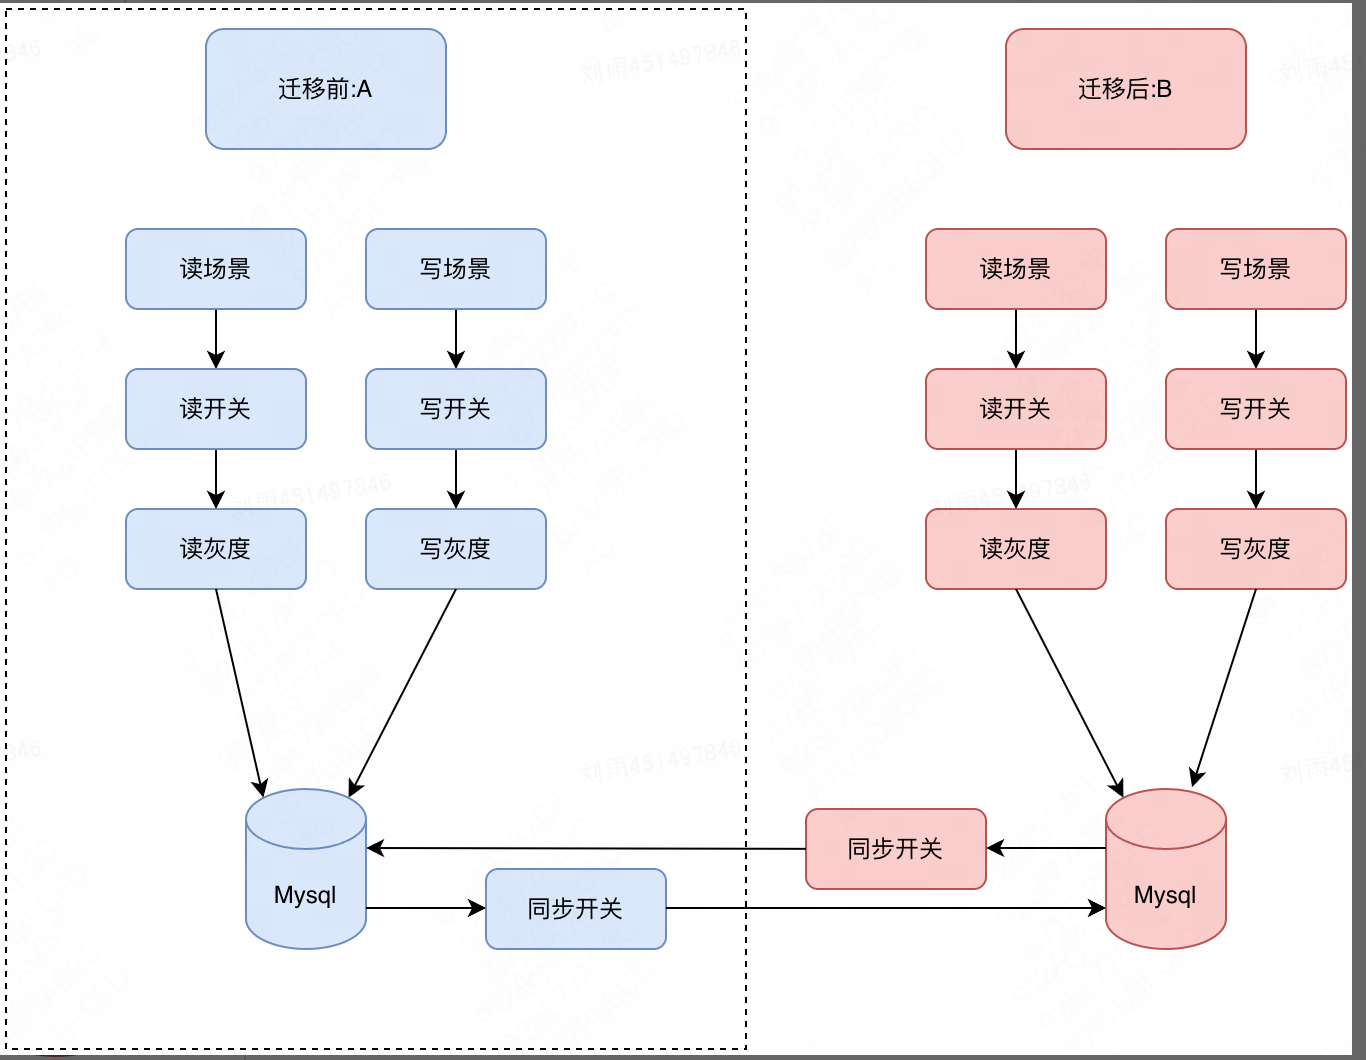
- 线上稳定运行一段时间后,关闭新老数据同步
- 归档老数据,下线老数据
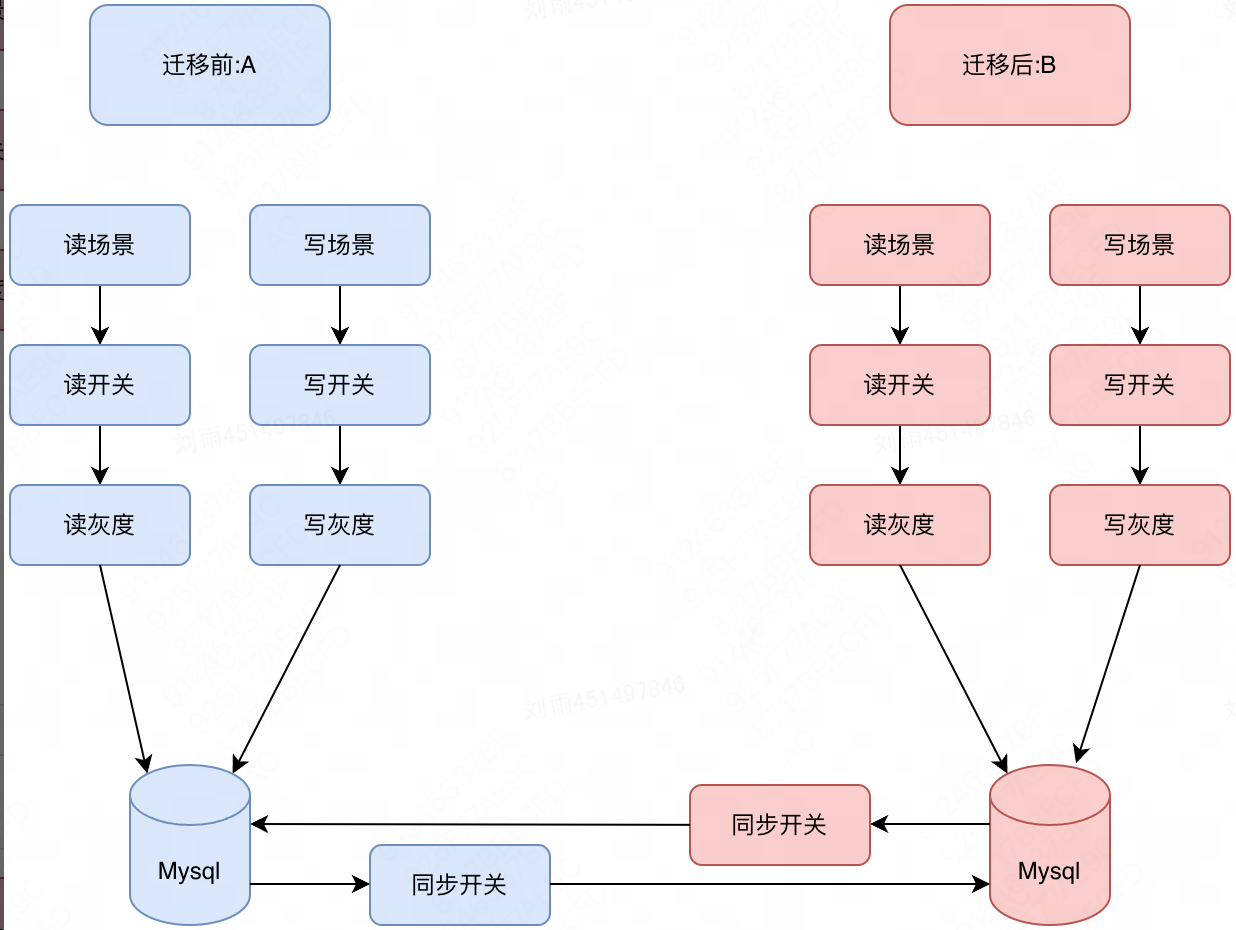
迁移前
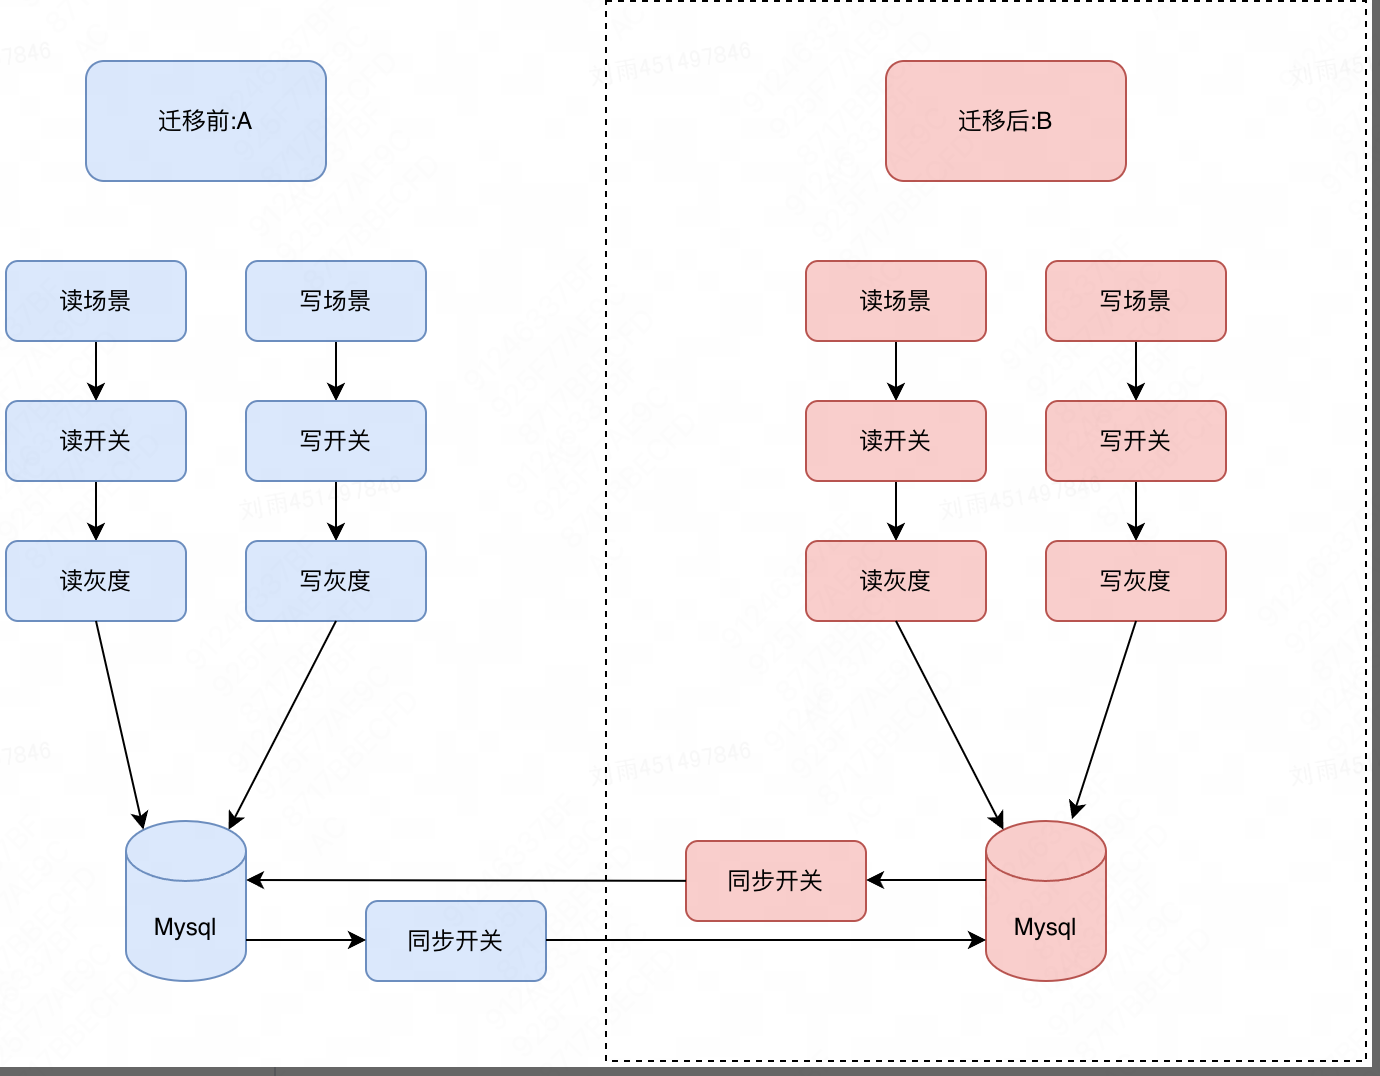
迁移中
迁移后
总结
自此就完成了数据库架构的升级,在整个迁移过程中,秉承着对业务影响最小的策略理念执行,最终实现数据和功能平滑迁移到新的数据库架构。大幅度提高了系统扩展性和吞吐量,可以有效支撑业务快速发展
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号