【RabbitMQ】仲裁队列、Raft协议,HAProxy详解

仲裁队列
RabbitMQ 的仲裁队列是一种基于 Raft 一致性算法实现的持久化,复制的 FIFO 队列。
- 仲裁队列提供队列复制的能力,保障数据的高可用性和安全性
- 使用仲裁队列可以在
RabbitMQ节点间进行队列数据的复制,从而达到在一个节点宕机时,队列仍然可以提供服务的效果
仲裁队列时 RabbitMQ 3.8 版本最重要的改动,它是镜像队列的替代方式。在 RabbitMQ 3.8 版本问世之前,镜像队列是实现数据高可用的唯一手段,但是它有一些设计的缺陷,这也是 RabbitMQ 提供仲裁队列的原因
- 经典镜像队列已被弃用,并计划在将来的版本中被移除,如果当前使用经典镜像队列的
RabbitMQ安装需要迁移,可以参考官方提供的迁移指南 - 官方文档: https://www.rabbitmq.com/docs/migrate-mcq-to-qq
Raft 协议介绍
什么是 Raft
官方文档:
Raft是一种用于管理和维护分布式系统的一致性的协议,它是一种共识算法,旨在实现高可用性和数据的持久性。Raft通过在节点间复制数据来保证分布式系统中的一致性,即使在节点故障的情况下也能保证数据不会丢失
在分布式系统中,为了消除单点提高系统可用性,通常会使用副本来进行容错,但这会带来另一个问题,即如何保证多个副本之间的一致性?
- 共识算法(
Consensus Algorithm)就是做这个事的,它允许多个分布式节点就某个值或一系列值达成一致性协议 - 即使在一些节点发生故障,网络分区或其他问题的情况下,共识算法也能保证系统的一致性和数据的可靠性
常见的共识算法有:
Raxos:一种经典的共识算法,用于解决分布式系统中的一致性问题Raft:一种较新的公式算法,Paxos不易实现,Raft是对Paxos算法的简化和改进,旨在易于理解和实现Zab:ZooKeeper使用的共识算法,基于Paxos算法,大部分和Raft相同,主要区别是对于Leader的任期。Raft叫做term,Zab叫做epoch。状态复制的过程中,Raft的心跳从Leader向Follower发送,而Zab则相反Gossip:其每个节点都是对等的,即没有角色之分。Gossip算法中的每个节点都会将数据改动告诉其他节点(类似于传八卦)
Raft 基本概念
Raft 使用 Quorum 机制来实现共识和容错,我们将对 Raft 集群的操作必须得到大多数(>N/2)节点的同意才能提交
- 节点指的是分布式系统中的一个独立成员
- 大于半数节点,保证集群中只能选举出一个
Leader,避免多个Leader并行工作,确保了Leader的唯一性 #高频面试 - 节点最好是奇数,避免平票的可能性 #高频面试
当我们向 Raft 集群发起一系列读写操作时,集群内部究竟发生了什么呢?我们先来简单了解一下
Raft 集群必须存在一个主节点(Leader),客户端向集群发起的所有操作都必须由主节点处理。所以 Raft 核心算法中的第一部分就是选主(Leader election)。没有主节点集群就无法工作,先选出一个主节点,再考虑其他的事情
主节点会负责接受客户端发过来的操作请求,将操作包装为日志同步给其他节点,在保证大部分节点都同步了本次操作后,就可以安全地给客户端回应响应了。这部分工作在 Raft 核心算法中叫日志复制(Log Replication)
因为主节点的责任非常大,所以只有符合条件的节点才能当选主节点。为了保证集群对外展现的一致性,主节点在处理操作日志时,也一定要谨慎,这部分在 Raft 核心算法中叫安全性(Safety)
Raft 算法将一致性问题分解为了三个子问题:Leader 选举、日志复制和安全性
下面我们详细介绍下 Raft 的选主过程
选主(Leader election)
选主(Leader election)就是在集群中抉择出一个主节点来负责一些特定的工作。在执行了选主过程后,集群中的每个节点都会识别出一个特定的、唯一的节点作为 leader
节点角色
在 Raft 算法中,每个节点都处于以下三种角色之一
Leader(领导者):负责处理所有客户请求,并将这些请求作为日志项复制到所有Follower。Leader定期向所有Follower发送心跳消息,以维持其领导者地位,防止Follower进入选举过程Follower(跟随者):接收来自Leader的日志条目,并在本地应用这些条目。跟随者不直接处理客户请求Candidate(候选者):当跟随者在一段时间内没有收到来自Leader的心跳消息时,它会变得不确定Leader是否仍然可用。在这种情况下,跟随者会转变角色为Candidate,并开始尝试通过投票过程,成为新的Leader
在正常情况下,集群中只有一个 Leader,剩下的节点都是 Follower,下图展示了这些状态和他们之间的转换关系
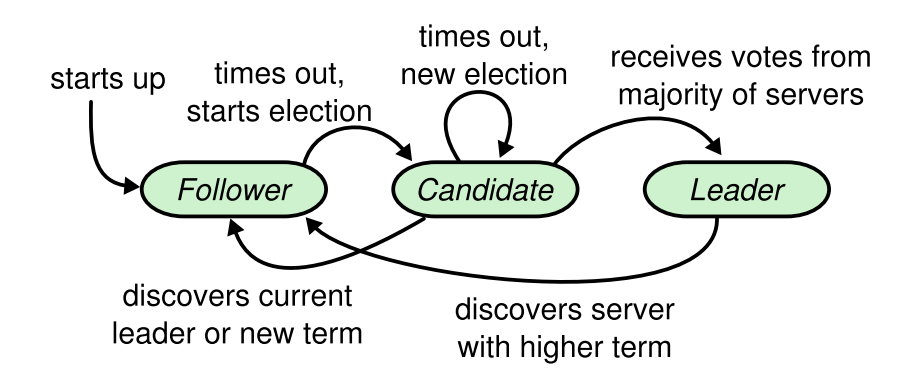
image.png
- 可以看出所有节点在启动时,都是
Follower状态,在一段时间内如果没有收到来自Leader的心跳,从Follower切换到Candidate,发起选举。 - 如果收到多数派(
majority)的投票(含自己的一票),则切换到Leader的状态 Leader一般会一直工作,直到发生异常为止
任期
Raft 将时间划分成任意长度的任期(term)。每一段任期从一次选举开始,在这个时候会有一个或者多个 Candidate 尝试成为 Leader。
- 在成功完成一次
Leader election之后,一个Leader就会一直管理集群,直到任期结束 - 在某些情况下,一次选举无法选出
Leader,这个时候这个任期会以没有Leader而结束(如下图t3) - 同时一个新的任期(包含一次新的选举)会很快重新开始
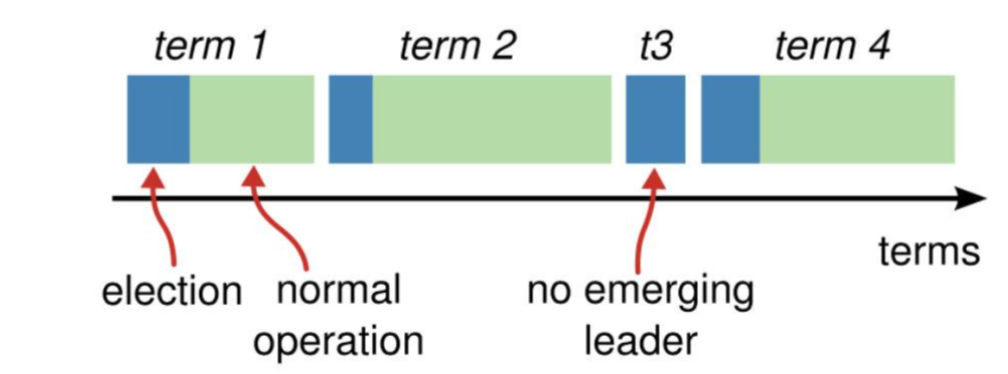
image.png
Term 更像是一个逻辑时钟(logic clock)的作用,就可以发现哪些节点的状态已经过期。每一个节点都保存一个 current term,在通信时带上这个 term 的值
每一个节点都存储着一个当前任期号(current term number)。该任期号会xua随着时间单调递增。节点之间通信的时候会交换当前任期号
- 如果一个节点的当前任期号比其他节点小,那么他就将自己的任期号更新为较大的那个值
- 如果一个
Candidate或者Leader发现自己的任期号过期了,它就会立刻回到Follower状态 - 如果一个节点接收了一个带着过期的任期号额度请求,那么它会拒绝这次请求
RequestVote RPCs:请求投票,由Candidate在选举过程中发出AppendEntries RPCs:追加条目,由Leader发出,用来做日志复制和提供心跳机制
选举过程
Raft 采用一种心跳机制来触发 Leader 选举,当服务器启动的时候,都是 Follower 状态。如果 Follower 在 election timeout 内没有收到来自Leader 的心跳(可能没有选出 Leader,也可能 Leader 挂了,或者 Leader 与 Follower 之间网络故障),则会主动发起选举
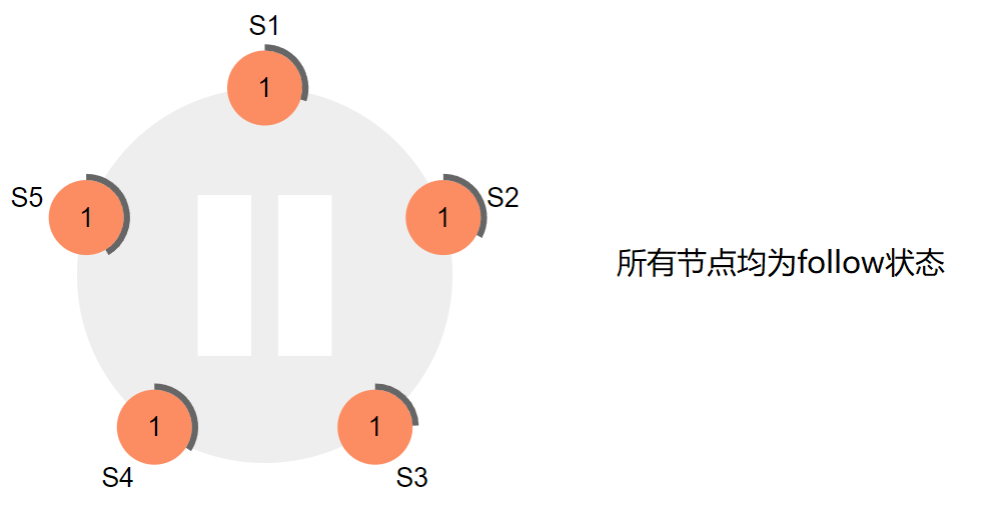
image.png
步骤如下:
- 率先超时的节点,自增当前任期号,然后切换为
Candidate状态,并投自己一票 - 以并行的方式发送一个
RequestVote RPCs给集群中的其他服务节点(企图得到他们的投票) - 等待其他节点的回复
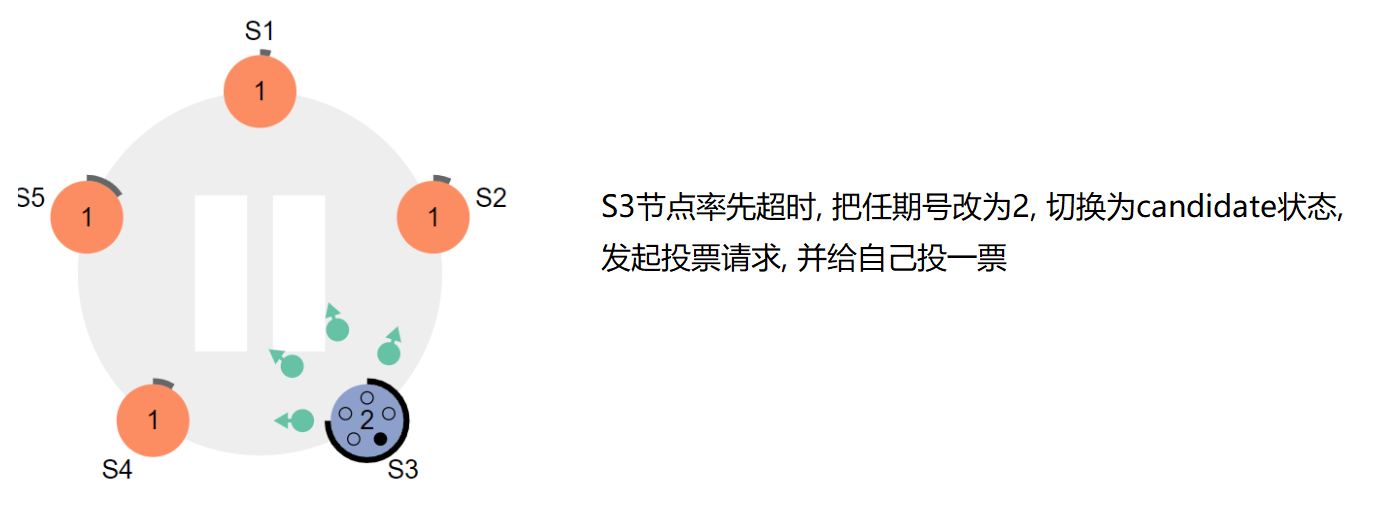
image.png
在这个过程中,可能出现三种结果:
- 赢得选举,成为
Leader(包括自己的一票) - 其他节点赢得了选举,它自行切换到
Follower - 一段时间内没有收到
majority(多数派)投票,保持Candidate状态,重新发出选举
投票要求:
- 每一个服务器节点会按照先来先服务原则,只投给一个
Candidate - 候选人知道的信息不能比自己的少
接下来对这三种情况进行说明:
第一种情况:赢得选举之后,新的 Leader 会立即给所有节点发送消息,广而告之,避免其他节点触发新的选举
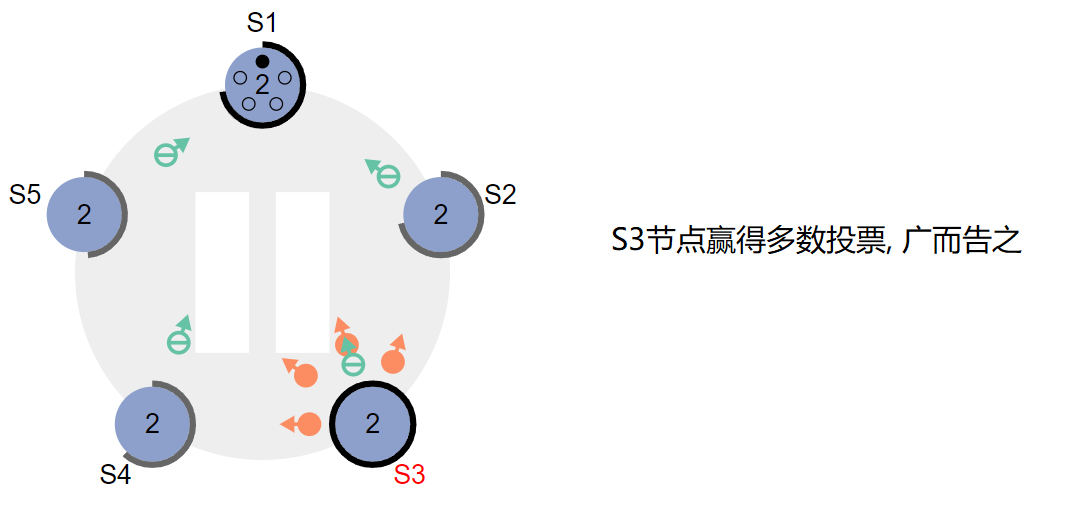
image.png
第二种情况:比如有三个节点 A B C,A B 同时发起选举,而 A 的选举消息先到达 C,C 给 A 投了一票,当 B 的消息到达 C 时,已经不能满足上面提到的第一个约束,即 C 不会投票给 B,这时候 A 就胜出了
A胜出之后,会给B,C发心跳消息,节点B发现节点A的term不低于自己的term,就知道已经有Leader了,于是把自己转换为Follower- 进行选举的节点,
term会自增1
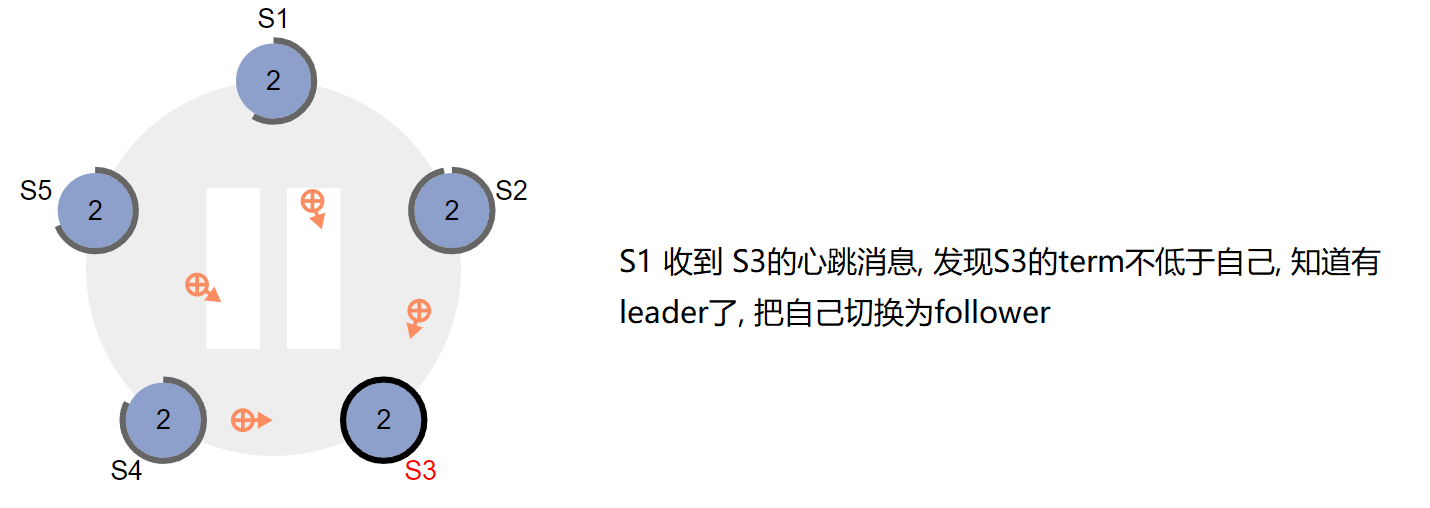
image.png
竞选主节点的节点在发送出消息之后,可能消息还没到远端的节点,投票就已经超过半数,选举成功了
第三种情况:没有任何节点获得 majority 投票。比如所有的 Follower 同事变成 Candidate,然后他们都将票投给自己,那这样就没有 Candidate 能得到超过半数的投票了。
当这种情况发生的时候,每个 Candidate 都会进行一次超时响应,然后通过自增任期号来开启新一轮的选举,并启动另一轮的 RequestVote RPCs。如果没有额外的措施,这种无结果的投票可能会无限重复下去
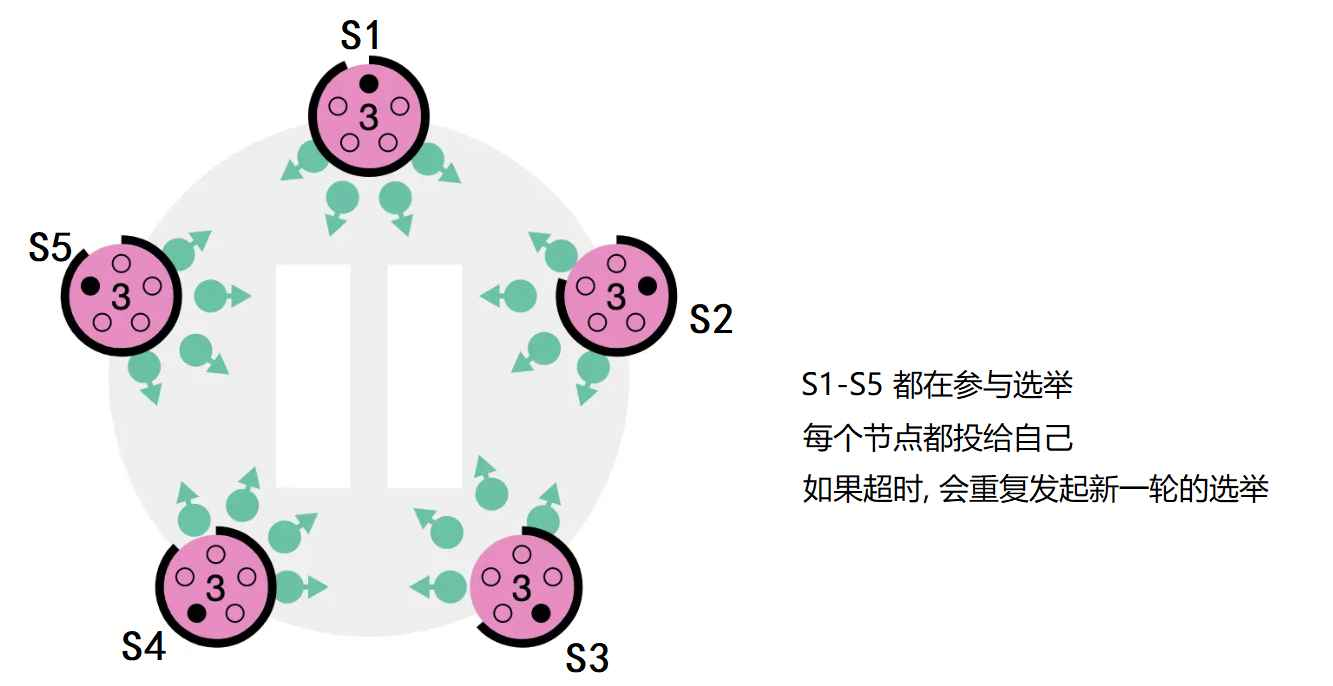
image.png|514
为了解决上述问题,Raft 采用随机选举超时时间(randomized election timeouts)来确保很少产生无结果的投票,并且就算发生了也能很快地解决。
- 为了防止选票一开始就被瓜分,选举超时时间是从一个固定的区间(比如,
150-300ms)中随机选择 - 这样可以把服务器分散开来,以确保在大多数情况下会只有一个服务器率先结束超时,那么这个时候,它就可以赢得选举,并在其他服务器结束超时之前发送心跳
Raft动画演示在线地址: https://raft.github.io/
Raft 下的消息复制
每个仲裁队列都有多个副本,它包含一个主和多个从副本。replication factor 为 5 的仲裁队列将会有 1 个主副本和 4 个从副本。每个副本都在不同的 RabbitMQ 节点上
客户端(生产者和消费者)只会与主副本进行交互,主副本再将这些命令复制到从副本。当主副本所在的节点下线,其中一个从副本会被选举成为主副本,继续提供服务
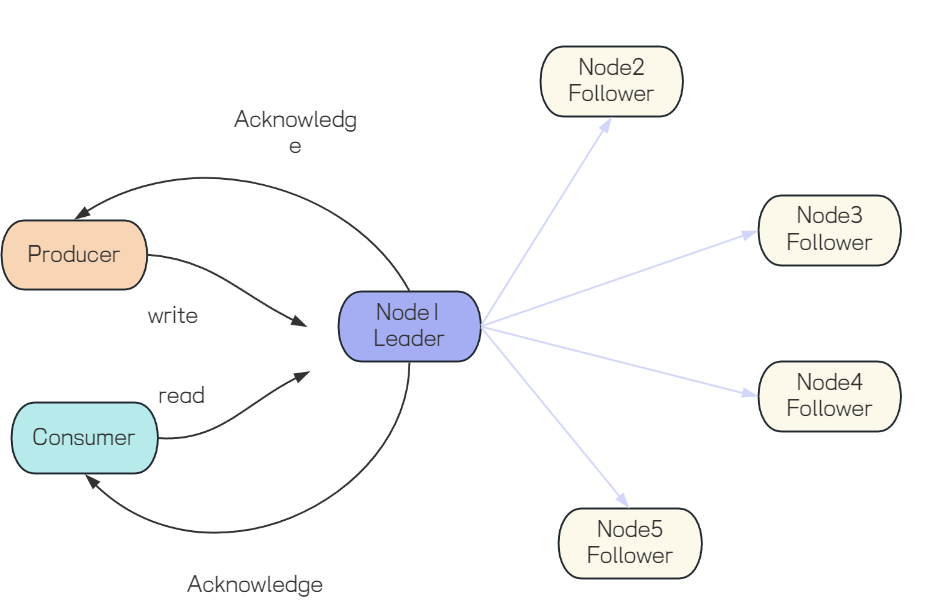
image.png
- 消息复制和主副本选举的操作,需要超过半数的副本同意。当生产者发送一条消息,需要超过半数的队列副本都将消息写入磁盘后才会向生产者进行确认,这意味着小部分比较慢的副本不会影响整个队列的性能
仲裁队列的使用
1. 创建仲裁队列
下面讲述三种创建方式
- 使用
Spring框架代码创建
@Bean("quorumQueue")
public Queue quorumQueue() {
	return QueueBuilder.durable("quorum_queue").quorum().build();
}- 使用
amqp-client创建
Map<String, Object> param = new HashMap<>();
parmm.put("x-queue-type", "quorum");
channel.queueDeclare("quorum_queue", true, false, false, param);- 使用管理平台创建
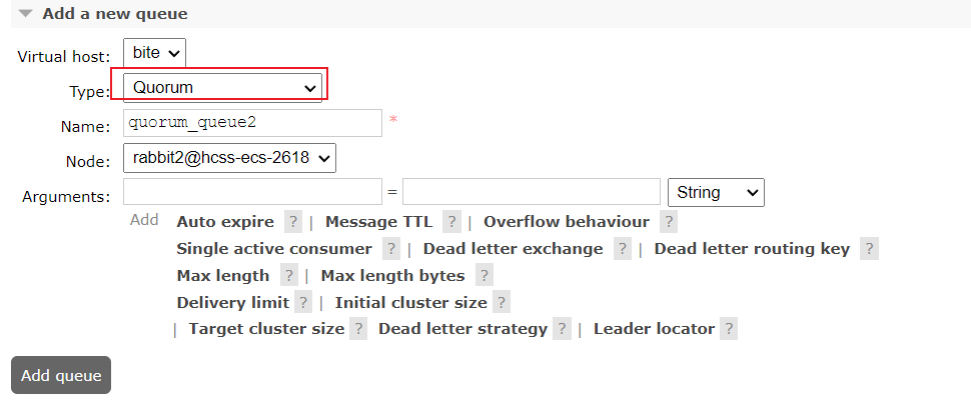
image.png
- 创建时选择
Type为Quorum,指定主副本
2 . 创建后观察管理平台
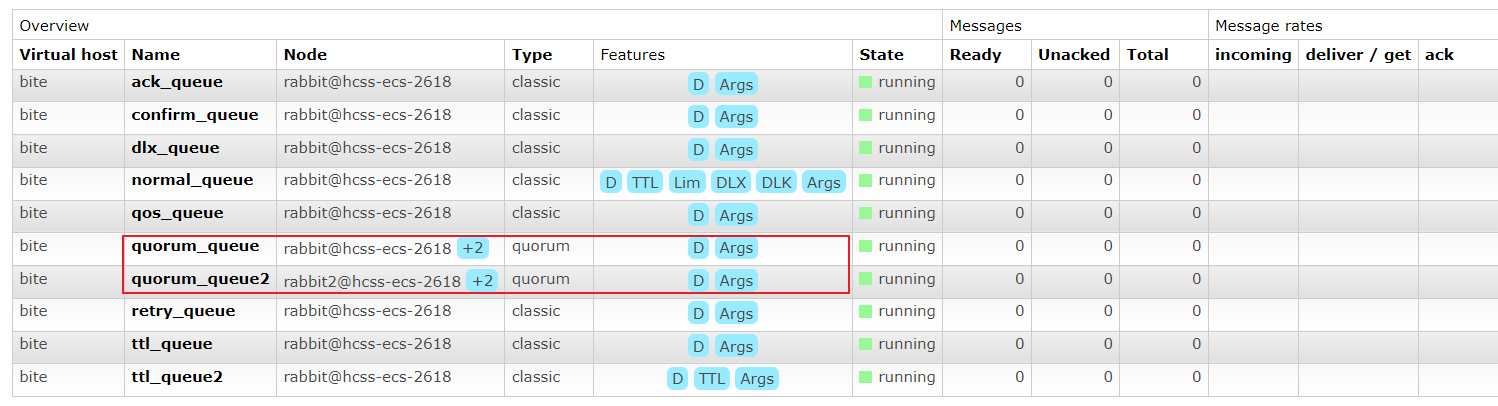
image.png
- 可以看到,仲裁队列后面有个
+2字样,代表这个队列有 2 个镜像节点
- 仲裁队列默认的镜像数为 5,即 1 个主节点,4个从副本节点
- 如果集群中节点数量少于 5,比如我们搭建了 3 个节点的集群,那么创建的仲裁队列就是 1 主 2 从
- 如果集群中的节点数大于 5 个的话,那么就只会在 5 个节点中创建出 1 主 4 从
点进去,可以看到队列详情
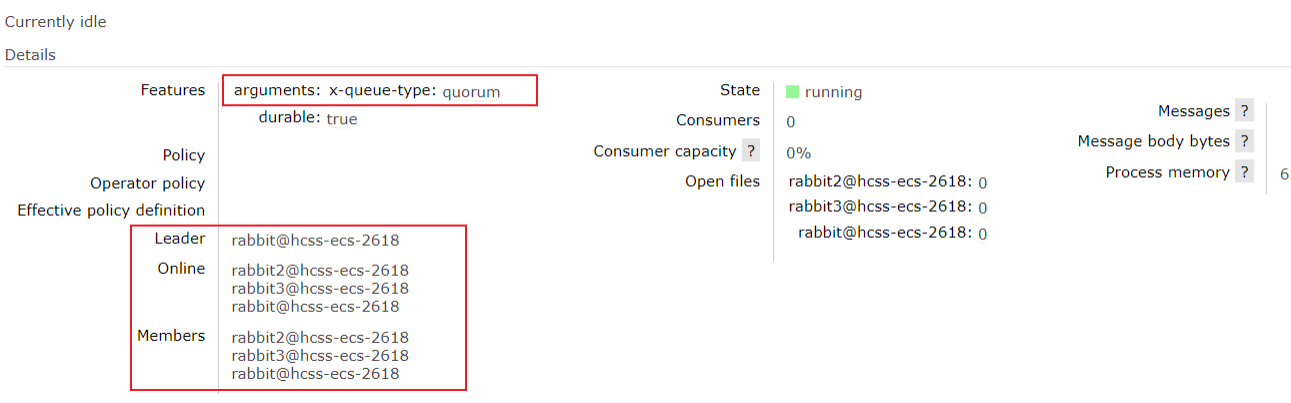
image.png
- 可以看到:当有多个仲裁队列时,主副本和从副本会分布在进群的不同节点上,每个节点可以橙子啊多个主副本和从副本
3. 接收/发送消息
仲裁队列发送和接收消息和普通队列一样
HAProxy 负载均衡
面对大量业务访问、高并发请求,可以使用高性能的服务器来提升 RabbitMQ 服务的负载能力。当单机容量达到极限时,可以采取集群的策略来对负载能力做进一步提升,但这里还存在一些问题
试想一下,如果一个集群中有 3 个节点,我们在写代码时,访问哪个节点呢?这时就存在两个问题
- 如果我们访问的是
node1,但是node1挂了,我们的程序也会出现问题,所以最好是有一个统一的入口,一个节点故障时,流量可以及时转移到其他节点 - 如果所有的客户端都与
node1建议连接,那么node1的网络负载必然会大大增加,而其他节点又由于没有那么多的负载而造成硬件资源的浪费
这时候负载均衡显得尤为重要
引入负载均衡之后,各个客户端的连接可以通过负载均衡分摊到集群的各个节点之中,从而避免前面的问题
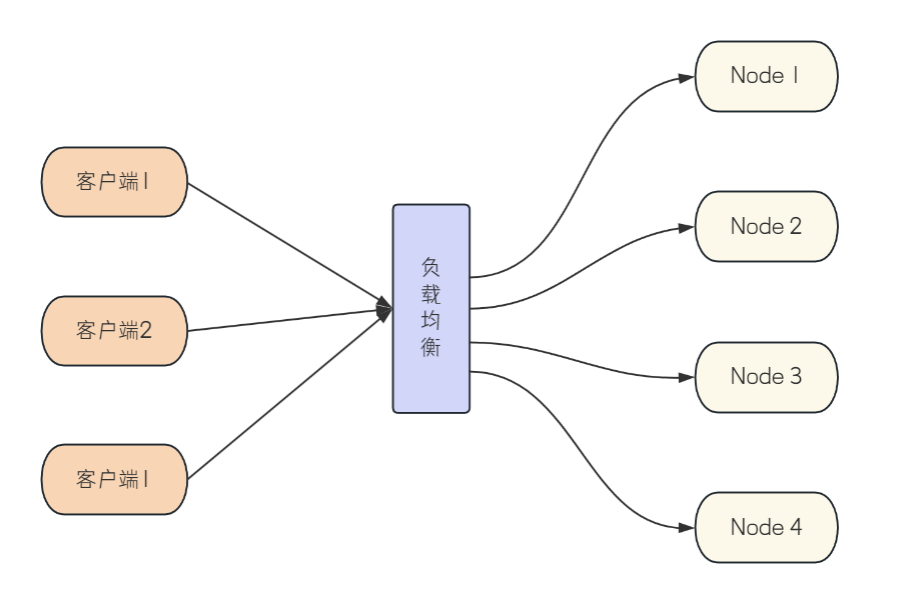
image.png
这里主要讨论的是如何有效的对 RabbitMQ 集群使用软件负载均衡技术,目前主流的方式有在客户端内部实现负载均衡,或者使用 HAProxy、LVS 等负载均衡软件来实现。
安装
接下来我们来安装 HAProxy,实现负载均衡
HAProxy(High Availability Proxy)是一个开源的负载均衡器和 TCP/HTTP 应用程序的代理服务器,它被设计用来提供高可用性,负载均衡和代理模式。HAProxy 主要用于分发网络流量到多个后端服务器,以提高网络的可靠性和性能
使用
引入 HAProxy 之后,RabbitMQ 的集群使用和单机使用一样,只不过需要把 RabbitMQ 的 IP 和 port 改为 HAPorxy 的 IP 和 port
- 修改配置文件
spring:
  rabbitmq:
addresses: amqp://study:study@127.0.0.1:5670/coding- 声明队列
test_cluster
public static final String CLUSTER_QUEUE = "cluster_queue";@Configuration
public class ClusterConfig {
@Bean("clusterQueue")
public Queue clusterQueue() {
return QueueBuilder.durable(Constant.CLUSTER_QUEUE).quorum().build();
}
}- 发送消息
@RequestMapping("/cluster")
public String cluster() {
	rabbitTemplate.convertAndSend("", Constant.CLUSTER_QUEUE, "quorum test ...");
	return "发送成功!";
}- 测试
发送消息到
cluster_queue
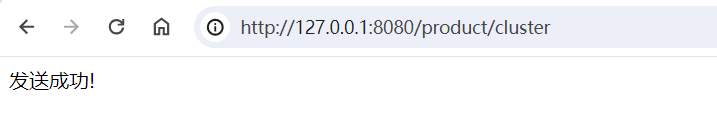
image.png
可以看到 IP 和端口号改成 HAProxy 的的之后,消息依然可以发送成功

image.png
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-08-12,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号