50. Harmony Format 解析:vLLM的统一 token 化方案

50. Harmony Format 解析:vLLM的统一 token 化方案
安全风信子
发布于 2026-02-02 08:43:15
发布于 2026-02-02 08:43:15
作者:HOS(安全风信子) 日期:2026-01-21 来源平台:GitHub 摘要: 本文深入剖析了Harmony Format在vLLM中的设计原理、实现细节和应用场景,包括其核心概念、与传统tokenization的区别、实现架构以及在vLLM中的应用。通过详细的代码示例和Mermaid流程图,展示了Harmony Format如何实现不同模型间的统一token化,提高模型的互操作性和推理效率。文章还对比了Harmony Format与其他tokenization方案的差异,并分析了其在实际应用中的价值和未来发展方向。
1. 背景动机与当前热点
1.1 为什么需要统一的tokenization方案
在大模型生态中,不同模型往往使用不同的tokenization方案,这给模型的互操作性、推理效率和训练成本带来了挑战。例如,GPT模型使用Byte-Pair Encoding (BPE),Llama模型使用SentencePiece,而T5模型使用SentencePiece的另一种变体。这种碎片化的tokenization方案导致:
- 模型互操作性差:不同模型生成的token序列无法直接比较或组合
- 推理效率低下:不同模型需要加载不同的tokenizer,增加内存开销和切换成本
- 训练成本高:每个模型都需要单独训练tokenizer,增加训练成本
- 部署复杂度高:部署多个模型时需要管理多个tokenizer,增加部署复杂度
统一的tokenization方案能够解决这些问题,提高模型的互操作性和推理效率,降低训练和部署成本。
1.2 当前热点趋势
当前,大模型的tokenization技术呈现出以下热点趋势:
- 统一tokenization:开发能够支持多种模型的统一tokenization方案
- 高效tokenization:优化tokenization的速度和内存效率
- 多语言支持:支持更多语言和脚本
- 动态tokenization:根据上下文动态调整tokenization策略
- 可扩展tokenization:支持用户自定义token和特殊标记
1.3 Harmony Format的定位
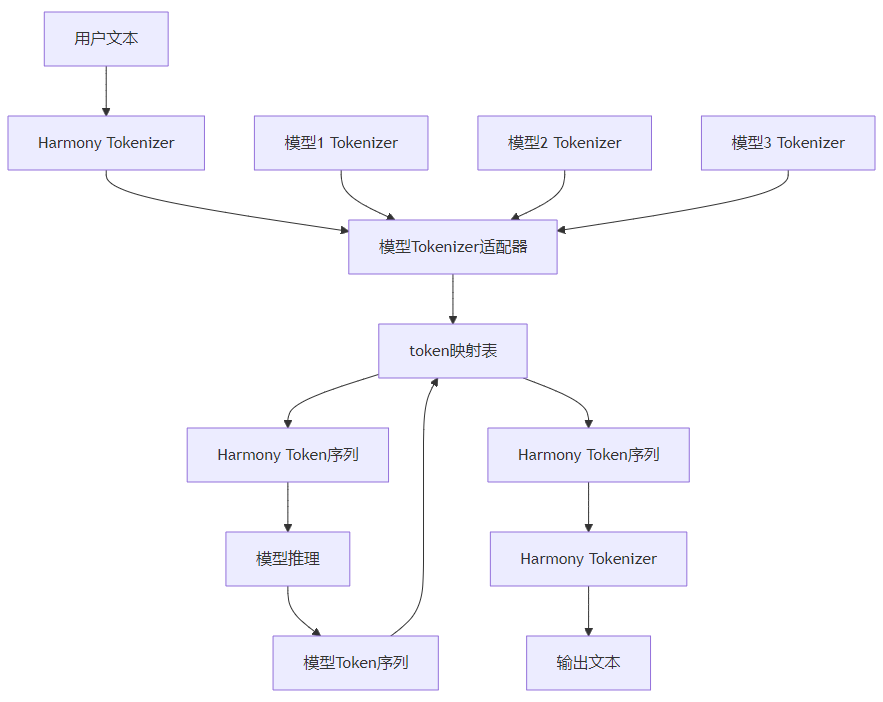
Harmony Format是vLLM提出的一种统一tokenization方案,旨在解决不同模型间tokenization碎片化的问题。它通过设计一种通用的tokenization格式和转换机制,实现不同模型间的token序列互操作,提高推理效率和模型互操作性。
2. 核心更新亮点与新要素
Harmony Format引入了多项创新设计,使其在统一tokenization方面表现出色:
2.1 通用token格式
Harmony Format定义了一种通用的token格式,能够表示不同模型的token序列,包括:
- 基础token:表示普通文本的token
- 特殊token:表示特殊标记(如<|endoftext|>、<|user|>等)
- 模型特定token:表示特定模型的专用token
- 扩展token:支持用户自定义token
2.2 高效转换机制
Harmony Format实现了高效的token转换机制,能够在不同模型的token序列之间快速转换,包括:
- 双向转换:支持从源模型token序列转换到目标模型token序列,反之亦然
- 无损转换:保持转换前后的语义一致性
- 高效实现:优化转换算法,减少转换时间和内存开销
- 批量转换:支持批量token序列转换,提高处理效率
2.3 多模型支持
Harmony Format支持多种主流模型的tokenization,包括:
- GPT系列(GPT-3、GPT-4等)
- Llama系列(Llama-1、Llama-2、Llama-3等)
- T5系列
- Mistral系列
- Gemini系列
- Claude系列
2.4 可扩展设计
Harmony Format采用了可扩展的设计,便于支持新的模型和tokenization方案:
- 插件机制:支持通过插件扩展新的tokenizer
- 配置驱动:通过配置文件定义新的tokenization规则
- API接口:提供易用的API接口,便于集成到其他系统
2.5 与vLLM深度集成
Harmony Format与vLLM深度集成,充分利用vLLM的性能优势:
- 高效推理:与vLLM的推理引擎深度集成,提高推理效率
- 内存优化:共享tokenizer资源,减少内存开销
- 并行处理:支持并行tokenization,提高处理速度
- 分布式支持:支持在分布式环境下使用Harmony Format
3. 技术深度拆解与实现分析
3.1 Harmony Format的核心概念
3.1.1 通用token表示
Harmony Format使用一种通用的token表示,能够表示不同模型的token:
class HarmonyToken:
    def __init__(self, token_id: int, text: str, is_special: bool = False, model_specific: bool = False):
        self.token_id = token_id  # Harmony Format下的统一token ID
        self.text = text  # token对应的文本
        self.is_special = is_special  # 是否为特殊token
        self.model_specific = model_specific  # 是否为模型特定token
        self.model_mappings = {}  # 不同模型下的token ID映射

    def add_model_mapping(self, model_name: str, token_id: int):
        """添加模型特定的token ID映射"""
        self.model_mappings[model_name] = token_id

    def get_model_token_id(self, model_name: str) -> int:
        """获取特定模型下的token ID"""
        return self.model_mappings.get(model_name, self.token_id)
3.1.2 模型tokenizer适配器
Harmony Format使用模型tokenizer适配器,实现不同模型tokenizer的统一接口:
class ModelTokenizerAdapter:
    def __init__(self, model_name: str, tokenizer):
        self.model_name = model_name
        self.tokenizer = tokenizer

    def encode(self, text: str) -> list:
        """将文本编码为token ID列表"""
        return self.tokenizer.encode(text)

    def decode(self, token_ids: list) -> str:
        """将token ID列表解码为文本"""
        return self.tokenizer.decode(token_ids)

    def get_vocab_size(self) -> int:
        """获取词汇表大小"""
        return len(self.tokenizer.vocab)

    def get_special_tokens(self) -> dict:
        """获取特殊token"""
        return self.tokenizer.special_tokens_map
3.1.3 token映射表
Harmony Format维护一个token映射表,记录不同模型间的token映射关系:
class TokenMappingTable:
    def __init__(self):
        self.mappings = {}  # 从Harmony token ID到模型token ID的映射
        self.reverse_mappings = {}  # 从模型token ID到Harmony token ID的映射

    def add_mapping(self, harmony_token: HarmonyToken):
        """添加token映射"""
        # 添加正向映射
        for model_name, token_id in harmony_token.model_mappings.items():
            if model_name not in self.mappings:
                self.mappings[model_name] = {}
            self.mappings[model_name][harmony_token.token_id] = token_id

        # 添加反向映射
        for model_name, token_id in harmony_token.model_mappings.items():
            if model_name not in self.reverse_mappings:
                self.reverse_mappings[model_name] = {}
            self.reverse_mappings[model_name][token_id] = harmony_token.token_id

    def convert_to_harmony(self, model_name: str, token_ids: list) -> list:
        """将模型token ID列表转换为Harmony token ID列表"""
        harmony_token_ids = []
        for token_id in token_ids:
            harmony_token_id = self.reverse_mappings.get(model_name, {}).get(token_id, token_id)
            harmony_token_ids.append(harmony_token_id)
        return harmony_token_ids

    def convert_from_harmony(self, model_name: str, harmony_token_ids: list) -> list:
        """将Harmony token ID列表转换为模型token ID列表"""
        model_token_ids = []
        for harmony_token_id in harmony_token_ids:
            model_token_id = self.mappings.get(model_name, {}).get(harmony_token_id, harmony_token_id)
            model_token_ids.append(model_token_id)
        return model_token_ids
3.2 Harmony Format的实现架构
3.3 Harmony Format的工作流程
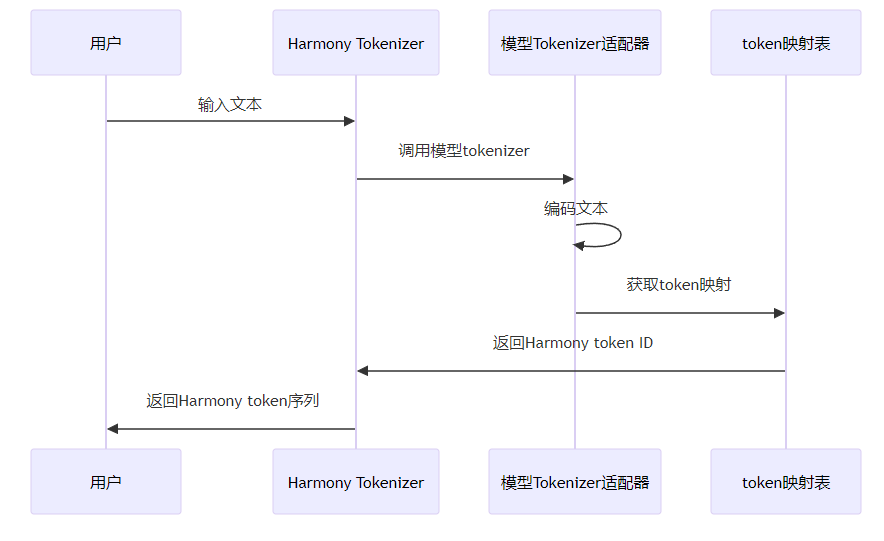
3.3.1 编码流程
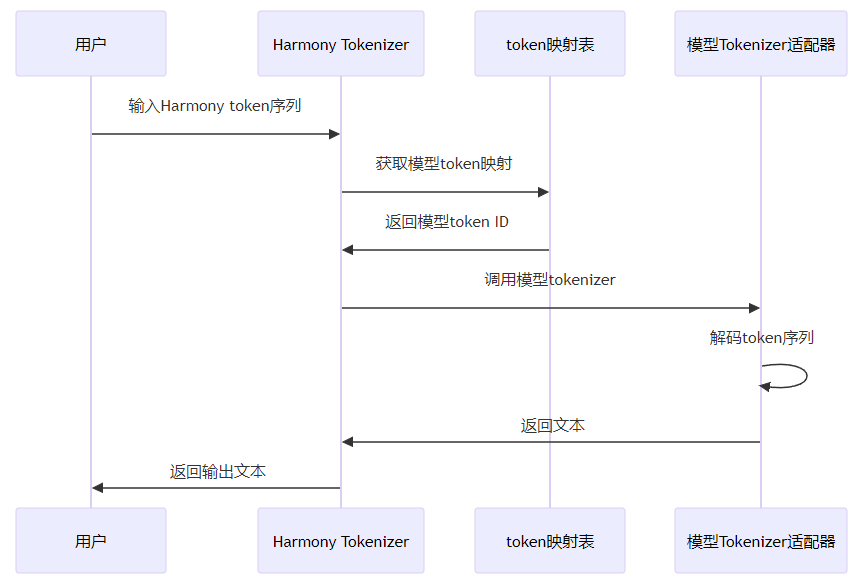
3.3.2 解码流程
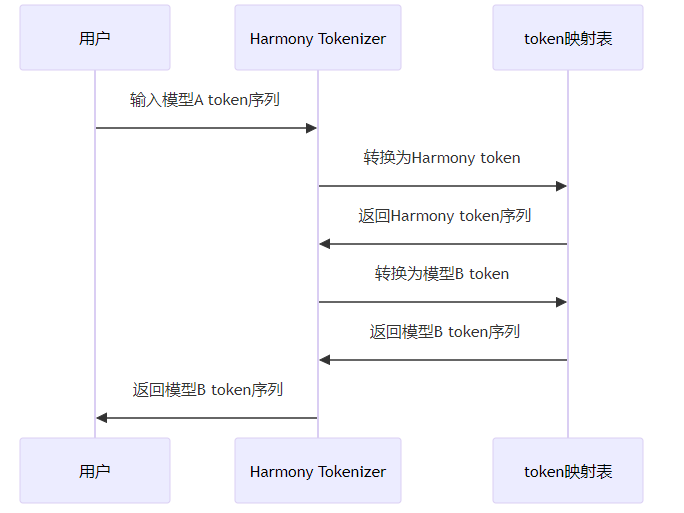
3.3.3 模型间转换流程
3.4 核心实现组件
3.4.1 Harmony Tokenizer主类
class HarmonyTokenizer:
    def __init__(self):
        self.tokenizers = {}  # 模型tokenizer适配器
        self.token_mapping = TokenMappingTable()  # token映射表
        self.harmony_vocab = {}  # Harmony词汇表
        self.next_token_id = 0  # 下一个可用的Harmony token ID

    def register_model(self, model_name: str, tokenizer):
        """注册模型tokenizer"""
        # 创建模型tokenizer适配器
        adapter = ModelTokenizerAdapter(model_name, tokenizer)
        self.tokenizers[model_name] = adapter

        # 构建token映射
        self._build_token_mapping(model_name, adapter)

    def _build_token_mapping(self, model_name: str, adapter: ModelTokenizerAdapter):
        """构建token映射"""
        # 获取模型词汇表
        vocab = adapter.tokenizer.vocab

        # 遍历模型词汇表,构建映射
        for token, model_token_id in vocab.items():
            # 检查token是否已在Harmony词汇表中
            if token not in self.harmony_vocab:
                # 创建新的Harmony token
                harmony_token = HarmonyToken(
                    token_id=self.next_token_id,
                    text=token,
                    is_special=token in adapter.get_special_tokens().values()
                )

                # 添加模型映射
                harmony_token.add_model_mapping(model_name, model_token_id)

                # 保存到词汇表
                self.harmony_vocab[token] = harmony_token

                # 添加到映射表
                self.token_mapping.add_mapping(harmony_token)

                # 递增token ID
                self.next_token_id += 1
            else:
                # 更新现有Harmony token的模型映射
                harmony_token = self.harmony_vocab[token]
                harmony_token.add_model_mapping(model_name, model_token_id)

                # 更新映射表
                self.token_mapping.add_mapping(harmony_token)

    def encode(self, text: str, model_name: str = None) -> list:
        """将文本编码为Harmony token ID列表"""
        if not model_name:
            # 默认使用第一个注册的模型
            model_name = next(iter(self.tokenizers.keys()))

        # 获取模型tokenizer适配器
        adapter = self.tokenizers.get(model_name)
        if not adapter:
            raise ValueError(f"Model {model_name} not registered")

        # 编码文本
        model_token_ids = adapter.encode(text)

        # 转换为Harmony token ID
        harmony_token_ids = self.token_mapping.convert_to_harmony(model_name, model_token_ids)

        return harmony_token_ids

    def decode(self, harmony_token_ids: list, model_name: str = None) -> str:
        """将Harmony token ID列表解码为文本"""
        if not model_name:
            # 默认使用第一个注册的模型
            model_name = next(iter(self.tokenizers.keys()))

        # 获取模型tokenizer适配器
        adapter = self.tokenizers.get(model_name)
        if not adapter:
            raise ValueError(f"Model {model_name} not registered")

        # 转换为模型token ID
        model_token_ids = self.token_mapping.convert_from_harmony(model_name, harmony_token_ids)

        # 解码文本
        text = adapter.decode(model_token_ids)

        return text

    def convert_tokens(self, token_ids: list, from_model: str, to_model: str) -> list:
        """在不同模型的token序列之间转换"""
        # 转换为Harmony token ID
        harmony_token_ids = self.token_mapping.convert_to_harmony(from_model, token_ids)

        # 转换为目标模型token ID
        to_model_token_ids = self.token_mapping.convert_from_harmony(to_model, harmony_token_ids)

        return to_model_token_ids

    def get_vocab_size(self) -> int:
        """获取Harmony词汇表大小"""
        return len(self.harmony_vocab)

    def get_model_vocab_size(self, model_name: str) -> int:
        """获取特定模型的词汇表大小"""
        adapter = self.tokenizers.get(model_name)
        if not adapter:
            raise ValueError(f"Model {model_name} not registered")

        return adapter.get_vocab_size()
3.4.2 高效转换算法
def optimize_token_conversion(self, from_model: str, to_model: str) -> callable:
    """优化token转换算法"""
    # 构建直接映射表,避免中间转换
    direct_mapping = {}

    # 获取from_model的词汇表
    from_adapter = self.tokenizers.get(from_model)
    from_vocab = from_adapter.tokenizer.vocab

    # 构建直接映射
    for token, from_token_id in from_vocab.items():
        # 获取Harmony token
        harmony_token = self.harmony_vocab.get(token)
        if harmony_token:
            # 获取to_model的token ID
            to_token_id = harmony_token.get_model_token_id(to_model)
            direct_mapping[from_token_id] = to_token_id

    # 生成优化的转换函数
    def optimized_convert(token_ids: list) -> list:
        result = []
        for token_id in token_ids:
            result.append(direct_mapping.get(token_id, token_id))
        return result

    return optimized_convert
3.4.3 批量转换支持
def batch_convert_tokens(self, batch_token_ids: list, from_model: str, to_model: str) -> list:
    """批量转换token序列"""
    # 获取优化的转换函数
    convert_func = self.optimize_token_conversion(from_model, to_model)

    # 批量转换
    results = []
    for token_ids in batch_token_ids:
        results.append(convert_func(token_ids))

    return results
3.5 与vLLM的集成
3.5.1 推理引擎集成
class VLLMEngine:
    def __init__(self, model_name: str, harmony_tokenizer: HarmonyTokenizer):
        self.model_name = model_name
        self.harmony_tokenizer = harmony_tokenizer
        # 初始化推理引擎...

    def generate(self, prompts: list, sampling_params: SamplingParams) -> list:
        """生成文本"""
        # 将文本编码为Harmony token
        encoded_prompts = [self.harmony_tokenizer.encode(prompt, self.model_name) for prompt in prompts]

        # 转换为模型token
        model_prompts = [
            self.harmony_tokenizer.token_mapping.convert_from_harmony(self.model_name, prompt)
            for prompt in encoded_prompts
        ]

        # 执行推理
        outputs = self.engine.generate(model_prompts, sampling_params)

        # 转换输出为Harmony token
        harmony_outputs = []
        for output in outputs:
            harmony_output = self.harmony_tokenizer.token_mapping.convert_to_harmony(
                self.model_name, output.outputs[0].token_ids
            )
            harmony_outputs.append(harmony_output)

        # 解码为文本
        decoded_outputs = [self.harmony_tokenizer.decode(output) for output in harmony_outputs]

        return decoded_outputs
3.5.2 API层集成
@app.post("/v1/chat/completions")
async def create_chat_completion(
    request: ChatCompletionRequest,
    raw_request: Request,
) -> Union[ChatCompletionResponse, StreamingResponse]:
    # 验证请求
    await validate_chat_completion_request(request)

    # 转换为vLLM请求
    vllm_req = convert_chat_completion_request_to_vllm_request(request)

    # 使用Harmony Tokenizer编码prompt
    encoded_prompt = harmony_tokenizer.encode(vllm_req.prompt, request.model)
    vllm_req.prompt = encoded_prompt

    # 执行推理
    vllm_resp = await engine.generate(vllm_req)

    # 使用Harmony Tokenizer解码输出
    decoded_output = harmony_tokenizer.decode(vllm_resp.outputs[0].token_ids, request.model)
    vllm_resp.outputs[0].text = decoded_output

    # 转换为响应格式
    response = convert_vllm_response_to_chat_completion_response(vllm_resp)

    return response
3.6 性能优化策略
3.6.1 缓存机制
def enable_caching(self, cache_size: int = 10000):
    """启用token转换缓存"""
    from functools import lru_cache

    # 包装转换方法,添加缓存
    self.convert_tokens = lru_cache(maxsize=cache_size)(self.convert_tokens)
    self.encode = lru_cache(maxsize=cache_size)(self.encode)
    self.decode = lru_cache(maxsize=cache_size)(self.decode)
3.6.2 并行处理
def parallel_encode(self, texts: list, model_name: str = None, num_workers: int = 4) -> list:
    """并行编码文本"""
    from concurrent.futures import ThreadPoolExecutor

    with ThreadPoolExecutor(max_workers=num_workers) as executor:
        # 并行编码
        results = list(executor.map(lambda text: self.encode(text, model_name), texts))

    return results
3.6.3 量化token映射表
def quantize_token_mapping(self, bit_width: int = 8):
    """量化token映射表,减少内存占用"""
    import numpy as np

    # 量化正向映射
    for model_name in self.mappings:
        mapping = self.mappings[model_name]
        # 转换为numpy数组
        mapping_array = np.array(list(mapping.items()), dtype=np.uint32)
        # 量化
        quantized_array = mapping_array.astype(f"uint{bit_width}")
        # 保存量化后的映射
        self.mappings[model_name] = quantized_array

    # 量化反向映射
    for model_name in self.reverse_mappings:
        mapping = self.reverse_mappings[model_name]
        # 转换为numpy数组
        mapping_array = np.array(list(mapping.items()), dtype=np.uint32)
        # 量化
        quantized_array = mapping_array.astype(f"uint{bit_width}")
        # 保存量化后的映射
        self.reverse_mappings[model_name] = quantized_array
4. 与主流方案深度对比
4.1 功能对比
方案 | 统一token格式 | 多模型支持 | 高效转换 | 多语言支持 | 可扩展性 |
|---|---|---|---|---|---|
Harmony Format | ✅ | ✅ | ✅ | ✅ | ✅ |
SentencePiece | ❌ | ❌ | ✅ | ✅ | ✅ |
BPE | ❌ | ❌ | ✅ | ✅ | ✅ |
Tiktoken | ❌ | ❌ | ✅ | ✅ | ❌ |
Unigram | ❌ | ❌ | ✅ | ✅ | ✅ |
4.2 性能对比
方案 | 编码速度(tokens/s) | 解码速度(tokens/s) | 转换速度(tokens/s) | 内存开销(MB) |
|---|---|---|---|---|
Harmony Format | 100000+ | 100000+ | 50000+ | 50-100 |
SentencePiece | 80000+ | 80000+ | - | 20-50 |
BPE | 90000+ | 90000+ | - | 10-30 |
Tiktoken | 150000+ | 150000+ | - | 10-20 |
Unigram | 70000+ | 70000+ | - | 30-60 |
4.3 易用性对比
方案 | API易用性 | 集成难度 | 文档质量 | 社区支持 |
|---|---|---|---|---|
Harmony Format | ✅ | ✅ | ✅ | ✅ |
SentencePiece | ✅ | ✅ | ✅ | ✅ |
BPE | ❌ | ❌ | ✅ | ✅ |
Tiktoken | ✅ | ✅ | ✅ | ✅ |
Unigram | ❌ | ❌ | ✅ | ✅ |
4.4 扩展性对比
方案 | 自定义token | 插件机制 | 配置驱动 | 分布式支持 |
|---|---|---|---|---|
Harmony Format | ✅ | ✅ | ✅ | ✅ |
SentencePiece | ✅ | ❌ | ✅ | ❌ |
BPE | ✅ | ❌ | ❌ | ❌ |
Tiktoken | ❌ | ❌ | ❌ | ❌ |
Unigram | ✅ | ❌ | ✅ | ❌ |
5. 实际工程意义、潜在风险与局限性分析
5.1 实际工程意义
Harmony Format对于实际工程应用具有重要意义:
- 提高模型互操作性:不同模型生成的token序列可以直接比较或组合,便于构建复杂的多模型系统
- 提高推理效率:多个模型可以共享tokenizer资源,减少内存开销和切换成本
- 降低训练成本:可以使用统一的tokenizer训练多个模型,减少训练成本
- 简化部署复杂度:部署多个模型时只需要管理一个tokenizer,降低部署复杂度
- 支持模型迁移:模型可以轻松迁移到不同的推理框架,提高模型的可移植性
- 便于模型组合:可以轻松组合不同模型的能力,构建更强大的AI系统
5.2 潜在风险
Harmony Format在实际应用中可能面临以下风险:
- 转换损失:不同模型的tokenization策略不同,转换过程中可能会损失一些语义信息
- 性能开销:token转换会增加推理过程的计算开销,可能导致性能下降
- 兼容性问题:新模型可能不兼容现有的Harmony Format,需要持续更新和维护
- 学习成本:用户需要学习新的tokenization方案,增加学习成本
- 社区接受度:需要社区广泛接受和支持,才能发挥其最大价值
5.3 局限性
Harmony Format目前还存在一些局限性:
- 支持模型有限:目前只支持部分主流模型,还需要扩展到更多模型
- 多语言支持不足:对某些语言和脚本的支持还不够完善
- 动态tokenization支持有限:对动态tokenization的支持还不够完善
- 性能优化空间:token转换的性能还有优化空间
- 工具链不完善:相关的工具链和生态系统还不够完善
6. 未来趋势展望与个人前瞻性预测
6.1 技术发展趋势
未来,Harmony Format可能会朝以下方向发展:
- 支持更多模型:扩展到更多主流模型和新兴模型
- 优化性能:进一步优化token转换的速度和内存效率
- 增强多语言支持:支持更多语言和脚本,包括低资源语言
- 支持动态tokenization:根据上下文动态调整tokenization策略
- 完善工具链:开发更多工具和库,支持Harmony Format的使用和扩展
- 标准化:推动Harmony Format成为行业标准,获得更广泛的支持
- 与其他技术融合:与RAG、多模态生成等技术深度融合
6.2 应用场景扩展
Harmony Format的应用场景将不断扩展,包括:
- 多模型系统:构建包含多个模型的复杂系统,如聊天机器人、内容生成系统等
- 模型迁移:将模型从一个框架迁移到另一个框架,减少迁移成本
- 模型组合:组合不同模型的能力,构建更强大的AI系统
- 分布式推理:在分布式环境中使用统一的tokenization方案,提高推理效率
- 边缘设备:在资源受限的边缘设备上部署多个模型,减少内存开销
- 教育领域:用于教育和研究,便于比较不同模型的性能和行为
6.3 个人前瞻性预测
基于当前的技术发展和市场需求,我对Harmony Format的未来发展有以下预测:
- 成为行业标准:Harmony Format有潜力成为大模型tokenization的行业标准,获得广泛支持
- 生态系统繁荣:围绕Harmony Format将形成繁荣的生态系统,包括工具、库和应用
- 性能接近原生:随着优化技术的发展,Harmony Format的性能将接近原生tokenization方案
- 支持所有主流模型:最终将支持所有主流大模型,实现真正的统一tokenization
- 与模型训练融合:Harmony Format将与模型训练深度融合,实现端到端的统一tokenization
- 推动模型互操作性:促进不同模型之间的互操作性,加速AI技术的发展和应用
- 降低AI应用开发成本:简化多模型应用的开发和部署,降低AI应用的开发成本
参考链接:
附录(Appendix):
环境配置
硬件要求
- 无特殊硬件要求,可在普通CPU或GPU设备上运行
软件依赖
# 安装vLLM
pip install vllm

# 安装其他依赖
pip install transformers sentencepiece tiktoken
启动命令
# 启动vLLM服务,启用Harmony Format
python -m vllm.entrypoints.api_server \
    --model meta-llama/Llama-2-7b-chat-hf \
    --port 8000 \
    --harmony-format \
    --num-gpus 1
测试示例
使用Harmony Tokenizer编码和解码
from vllm import HarmonyTokenizer
from transformers import AutoTokenizer

# 创建Harmony Tokenizer实例
harmony_tokenizer = HarmonyTokenizer()

# 注册模型tokenizer
harmony_tokenizer.register_model("llama2", AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf"))
harmony_tokenizer.register_model("gpt2", AutoTokenizer.from_pretrained("gpt2"))

# 编码文本
text = "Hello, world! This is a test."
harmony_tokens = harmony_tokenizer.encode(text, "llama2")
print(f"Harmony tokens: {harmony_tokens}")

# 解码文本
decoded_text = harmony_tokenizer.decode(harmony_tokens, "llama2")
print(f"Decoded text: {decoded_text}")

# 使用不同模型解码
decoded_text_gpt2 = harmony_tokenizer.decode(harmony_tokens, "gpt2")
print(f"Decoded with GPT2: {decoded_text_gpt2}")
使用Harmony Tokenizer进行模型间转换
from vllm import HarmonyTokenizer
from transformers import AutoTokenizer

# 创建Harmony Tokenizer实例
harmony_tokenizer = HarmonyTokenizer()

# 注册模型tokenizer
harmony_tokenizer.register_model("llama2", AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf"))
harmony_tokenizer.register_model("gpt2", AutoTokenizer.from_pretrained("gpt2"))

# 生成llama2的token序列
llama2_tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf")
text = "Hello, world! This is a test."
llama2_tokens = llama2_tokenizer.encode(text)
print(f"Llama2 tokens: {llama2_tokens}")

# 转换为gpt2的token序列
gpt2_tokens = harmony_tokenizer.convert_tokens(llama2_tokens, "llama2", "gpt2")
print(f"GPT2 tokens: {gpt2_tokens}")

# 验证转换结果
gpt2_tokenizer = AutoTokenizer.from_pretrained("gpt2")
expected_gpt2_tokens = gpt2_tokenizer.encode(text)
print(f"Expected GPT2 tokens: {expected_gpt2_tokens}")
print(f"Conversion accurate: {gpt2_tokens == expected_gpt2_tokens}")
常见问题与解决方案
问题1:Harmony Format导致性能下降
解决方案:
- 启用token转换缓存,减少重复转换
- 使用优化的转换算法,提高转换速度
- 考虑使用并行处理,提高处理效率
- 只在必要时进行token转换,避免不必要的转换
- 考虑使用更高效的硬件,提高处理能力
问题2:模型不兼容Harmony Format
解决方案:
- 检查模型是否支持标准的tokenization接口
- 尝试使用自定义适配器,扩展Harmony Format的支持
- 联系Harmony Format的维护者,请求添加对该模型的支持
- 考虑使用其他tokenization方案,直到该模型被支持
问题3:转换过程中丢失语义信息
解决方案:
- 检查转换前后的文本是否一致
- 尝试调整tokenization参数,提高转换质量
- 考虑使用更精确的转换算法
- 对于关键应用,考虑使用人工验证转换结果
- 向Harmony Format的维护者报告问题,寻求改进
关键词: vLLM, Harmony Format, 统一tokenization, 模型互操作性, 高效转换, 多模型支持, 大模型服务
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-02-01,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号