为什么说Youtu-GraphRAG 是图谱检索增强推理智能体的未来?

为什么说Youtu-GraphRAG 是图谱检索增强推理智能体的未来?
山行AI
发布于 2026-03-13 19:08:22
发布于 2026-03-13 19:08:22
历史知识图谱相关文章:
怎么使用 LLM 图转换器构建知识图谱
怎么将任意文本转换为图谱
从非结构化文本到交互式知识图谱 —— 利用大语言模型(LLMs)
轻松将文本转换为知识图谱重梳理之Graph Maker
如何使用知识图谱和向量数据库实现 Graph RAG -分步教程(下篇)
如何使用知识图谱和向量数据库实现 Graph RAG -分步教程(上篇)
Graphiti-构建适用于 AI 智能体的实时知识图谱
用 OpenAI Functions 从文本构建知识图谱实战篇
使用 LLM Graph Transformer 构建知识图谱
基于知识图谱的RAG——如何用固定的实体架构在Knowledge Graph上进行RAG检索
GenAI——LLM结合图谱RAG和LangChain实战指南
将文本输入或网址转换为知识图谱的AI应用—instagraph
🚀 革命性框架:相比 SOTA 基线实现 33.6% 更低 Token 成本、16.62% 更高准确率
简介
Youtu-GraphRAG 是一种垂直一体化的智能体范式,它通过 图谱模式(graph schema) 将整个框架紧密连接成一个复杂而精巧的整体。 它支持在图谱模式上进行无缝的领域迁移,几乎无需干预,即可展现出新一代 GraphRAG 在真实场景下的 卓越适应性。
何时以及为什么使用 Youtu-GraphRAG?
•多跳推理 / 总结 / 归纳:适用于需要 多步推理 的复杂问题场景。•知识密集型任务 : 处理依赖大量 结构化 / 私有 / 领域知识 的问题时,效果尤为突出。•领域可扩展性 : 只需对 图谱模式(schema) 做极少干预,就能轻松支持 百科全书、学术论文、商业/私有知识库 等多种领域。
🏗️ 框架架构
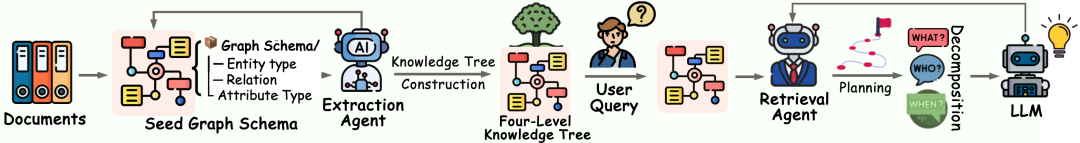
Youtu-GraphRAG Framework Architecture
Youtu-GraphRAG 框架架构示意图
交互式界面
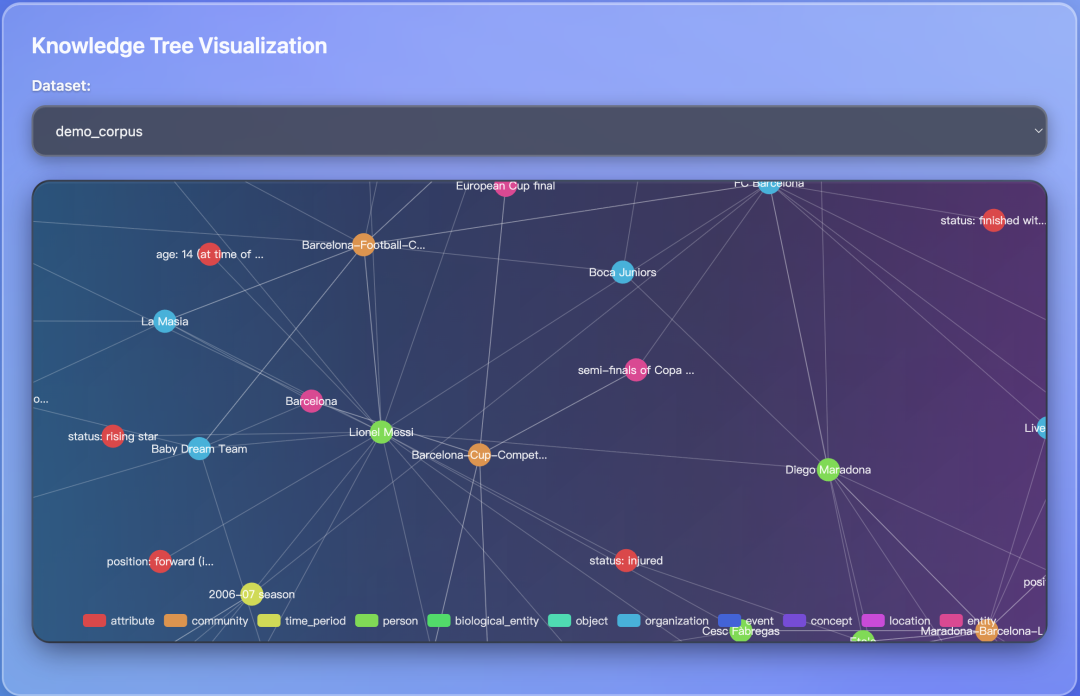
Graph Construction
创新与贡献
基于我们提出的 统一智能体范式 Graph Retrieval-Augmented Generation (GraphRAG), Youtu-GraphRAG 引入了若干关键创新点,使整个框架形成了紧密的一体化集成:
1. 基于 Schema 的分层知识树构建
•🌱 种子图谱 Schema:通过目标实体类型、关系和属性类型约束自动抽取代理•📈 可扩展的 Schema 拓展:持续扩展以适应未知领域•🏢 四层架构:•Level 1 (Attributes):实体属性信息•Level 2 (Relations):实体三元组关系•Level 3 (Keywords):关键词索引•Level 4 (Communities):层级社区结构•⚡ 快速适配工业应用:可在最小化干预下实现领域迁移
2. 双重感知的社区发现
• 新型社区检测算法:融合结构拓扑与子图语义,提供更全面的知识组织方式• 分层知识树:自然支持自顶向下的过滤与自底向上的推理,性能优于传统的 Leiden 和 Louvain 算法• 社区摘要:利用 LLM 生成社区级别的摘要,实现更高层次的知识抽象

Youtu-GraphRAG Community Detection
3. 智能体检索(Agentic Retrieval)
• Schema 感知的分解:利用相同的图谱 schema 将复杂查询拆分为可处理的并行子查询• 迭代反思:通过 IRCoT(Iterative Retrieval Chain of Thought) 机制进行反思,实现更高级的推理能力
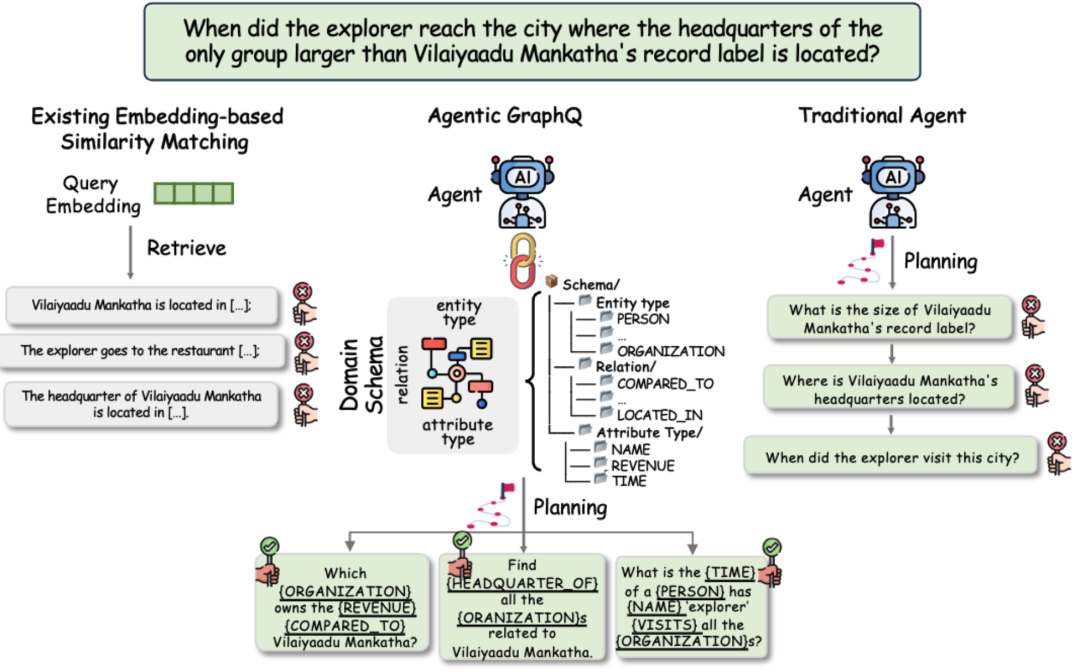
Youtu-GraphRAG Agentic Decomposer
4. 面向真实部署的高级构建与推理能力
• 性能优化:通过优化提示词、索引与检索策略,实现更低的 Token 成本和更高的准确率• 用户友好的可视化:在 output/graphs/ 中,四层知识树支持 Neo4j 导入,让推理路径和知识组织直观可见• 并行子问题处理:对分解后的子问题并行处理,提升复杂场景下的效率• 迭代推理:逐步构建答案,并保留推理链路(Reasoning Traces)• 领域可扩展性:为企业级部署而设计,新领域迁移所需的人工干预最小
5. 公平匿名数据集 AnonyRAG
•数据链接:Hugging Face AnonyRAG[1]•防止知识泄露:应对 LLM / 向量模型预训练中的知识泄漏问题•真实检索性能测试:对 GraphRAG 的检索效果进行深入评测•多语言支持:提供 中英文版本
6. 统一配置管理
•集中化参数管理:所有组件通过单一 YAML 文件 配置•运行时参数覆盖:支持执行时动态调整配置•多环境支持:最小化 schema 干预即可实现领域迁移•向后兼容性:确保已有代码可继续运行
性能对比
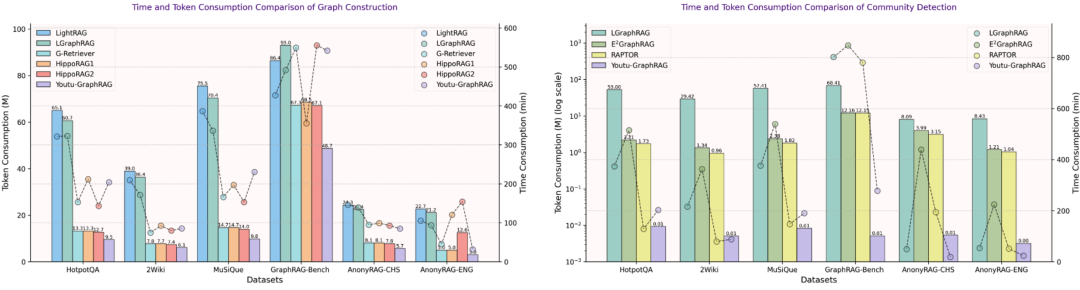
在 GraphRAG-Bench、HotpotQA、MuSiQue 等六个挑战性基准上的广泛实验表明: Youtu-GraphRAG 的鲁棒性得到验证,显著推动了 Pareto 前沿(Pareto Frontier),实现:
•Token 成本节省高达 90.71%•准确率提升 16.62%
结果表明该框架具有极强的适应性,能够在最小化 schema 干预下实现无缝领域迁移。
(见成本/准确率的雷达图对比)
Cost/acc performance
项目结构
youtu-graphrag/
├──📁 config/# 配置系统
│├── base_config.yaml # 主配置文件
│├── config_loader.py # 配置加载器
│└── init.py # 配置模块接口
│
├──📁 data/# 数据目录
│
├──📁 models/# 核心模型
│├──📁 constructor/# 知识图谱构建
││└── kt_gen.py # KTBuilder - 分层图谱构建器
│├──📁 retriever/# 检索模块
││├── enhanced_kt_retriever.py # KTRetriever - 主检索器
││├── agentic_decomposer.py # 查询分解器
│└──└── faiss_filter.py # DualFAISSRetriever - FAISS 检索器
│
├──📁 utils/# 工具模块
│├── tree_comm.py # 社区检测算法
│├── call_llm_api.py # LLM API 调用工具
│├──eval.py # 评估工具
│└── graph_processor.py # 图谱处理工具
│
├──📁 schemas/# 数据集 Schema
├──📁 assets/# 资源文件(图片、图表)
│
├──📁 output/# 输出目录
│├── graphs/# 已构建的知识图谱
│├── chunks/# 文本分块信息
│└── logs/# 运行日志
│
├──📁 retriever/# 检索缓存
│
├── main.py # 🎯 主程序入口
├── requirements.txt # 依赖列表
├── setup_env.sh # 安装 Web 依赖脚本
├── start.sh # 启动 Web 服务脚本
└── README.md # 项目文档
快速开始
我们提供两种方式来运行和体验 Demo 服务。 考虑到底层环境的差异,推荐优先使用 Docker 部署。
💻 使用 Dockerfile 启动
该方式依赖于 Docker 环境,请根据官方文档[2]安装 Docker。
# 1. 克隆 Youtu-GraphRAG 项目
```bash
git clone https://github.com/TencentCloudADP/youtu-graphrag

2.创建.env 文件(参考.env.example)
cd youtu-graphrag && cp .env.example .env
在.env 文件中配置你的 LLM API,格式与OpenAI API 相同,例如:
# LLM_MODEL=deepseek-chat
# LLM_BASE_URL=https://api.deepseek.com
# LLM_API_KEY=sk-xxxxxx

3.使用Dockerfile构建镜像
docker build -t youtu_graphrag:v1 .

4.运行Docker容器
docker run -d -p 8000:8000 youtu_graphrag:v1

5.访问服务
curl -v http://localhost:8000
然后即可在浏览器中访问:
http://localhost:8000
💻 Web 界面体验
该方式依赖 Python 3.10 及相应的 pip 环境,请根据官方文档[3]安装 Python。
# 1. 克隆 Youtu-GraphRAG 项目
git clone https://github.com/TencentCloudADP/youtu-graphrag

2.创建.env 文件(参考.env.example)
cd youtu-graphrag && cp .env.example .env
在.env 文件中配置你的 LLM API,格式与OpenAI API 相同,例如:
# LLM_MODEL=deepseek-chat
# LLM_BASE_URL=https://api.deepseek.com
# LLM_API_KEY=sk-xxxxxx

3.配置运行环境
./setup_env.sh

4.启动Web服务
./start.sh

5.访问服务
curl -v http://localhost:8000
然后即可在浏览器中访问:
http://localhost:8000
📖 完整使用指南
更多高级配置与使用方式请参考:🚀 FullGuide[4]
立即开始使用 Youtu-GraphRAG,体验智能问答的强大能力! 🚀
贡献指南
我们非常欢迎社区的贡献!以下是你可以参与的方式:
💻 代码贡献
1.Fork 本项目2.创建功能分支 (git checkout -b feature/AmazingFeature)3.提交更改 (git commit -m 'Add some AmazingFeature')4.推送分支 (git push origin feature/AmazingFeature)5.提交 Pull Request
🔧 扩展指南
•新增种子 Schema:添加高质量的种子 Schema 和数据处理逻辑•自定义数据集:以最小的 Schema 干预整合新数据集
•领域专用应用:为特定应用场景扩展框架,并结合 "最佳实践(Best Practice)"
https://github.com/TencentCloudADP/youtu-graphrag?tab=readme-ov-fileReferences
[1] Hugging Face AnonyRAG: https://huggingface.co/datasets/Youtu-Graph/AnonyRAG
[2] 官方文档: https://docs.docker.com/get-started/
[3] 官方文档: https://docs.python.org/3.10/using/index.html
[4] FullGuide: https://github.com/TencentCloudADP/youtu-graphrag/blob/main/FULLGUIDE.md
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-09-16,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号