MedCortex:把生物医学论文从选题到投稿,塞进一个 agent 智能体系统
原创
MedCortex:把生物医学论文从选题到投稿,塞进一个 agent 智能体系统
原创
用户7200114
发布于 2026-09-01 18:08:19
发布于 2026-09-01 18:08:19
MedCortex:把生物医学论文从选题到投稿,塞进一个 agent 智能体系统
— 16 个演示视频看下来,这是它真正在做的事
做生物医学研究的同仁大概率都经历过这种节奏:选题卡半个月,分析跑两个月,写稿改稿投稿又三个月。每一段都有人帮你,但工具之间互相不买账——临床数据库在 Excel 里,分析在 R 里,参考文献在 EndNote 里,论文模板在 Word 里,图还要丢到 AI 里重画一遍。
如果有一套 agent 智能体系统,能把这些环节打包成一条流水线,让 AI 一步步推着走,并且每一步都"留证据"——你愿不愿意花十分钟看看?
这一篇,我用 MedCortex 自带的 16 段官方演示视频做素材,把它的真实界面、真实输出、真实结果图一一截下来给你看。一句话先放这儿:这不是又一个聊天机器人,而是一套由多个 AI 智能体协同工作的 agent 智能体系统,能调用本地 R/Python、能下载并解析 PDF 论文、能让多个 AI 角色互相挑刺。
一、工作台长什么样?先看一眼
打开 MedCortex,先看到的不是聊天框,是一个完整的"科研项目管理界面"——左边是一排功能模块入口,中间是你的项目主页。
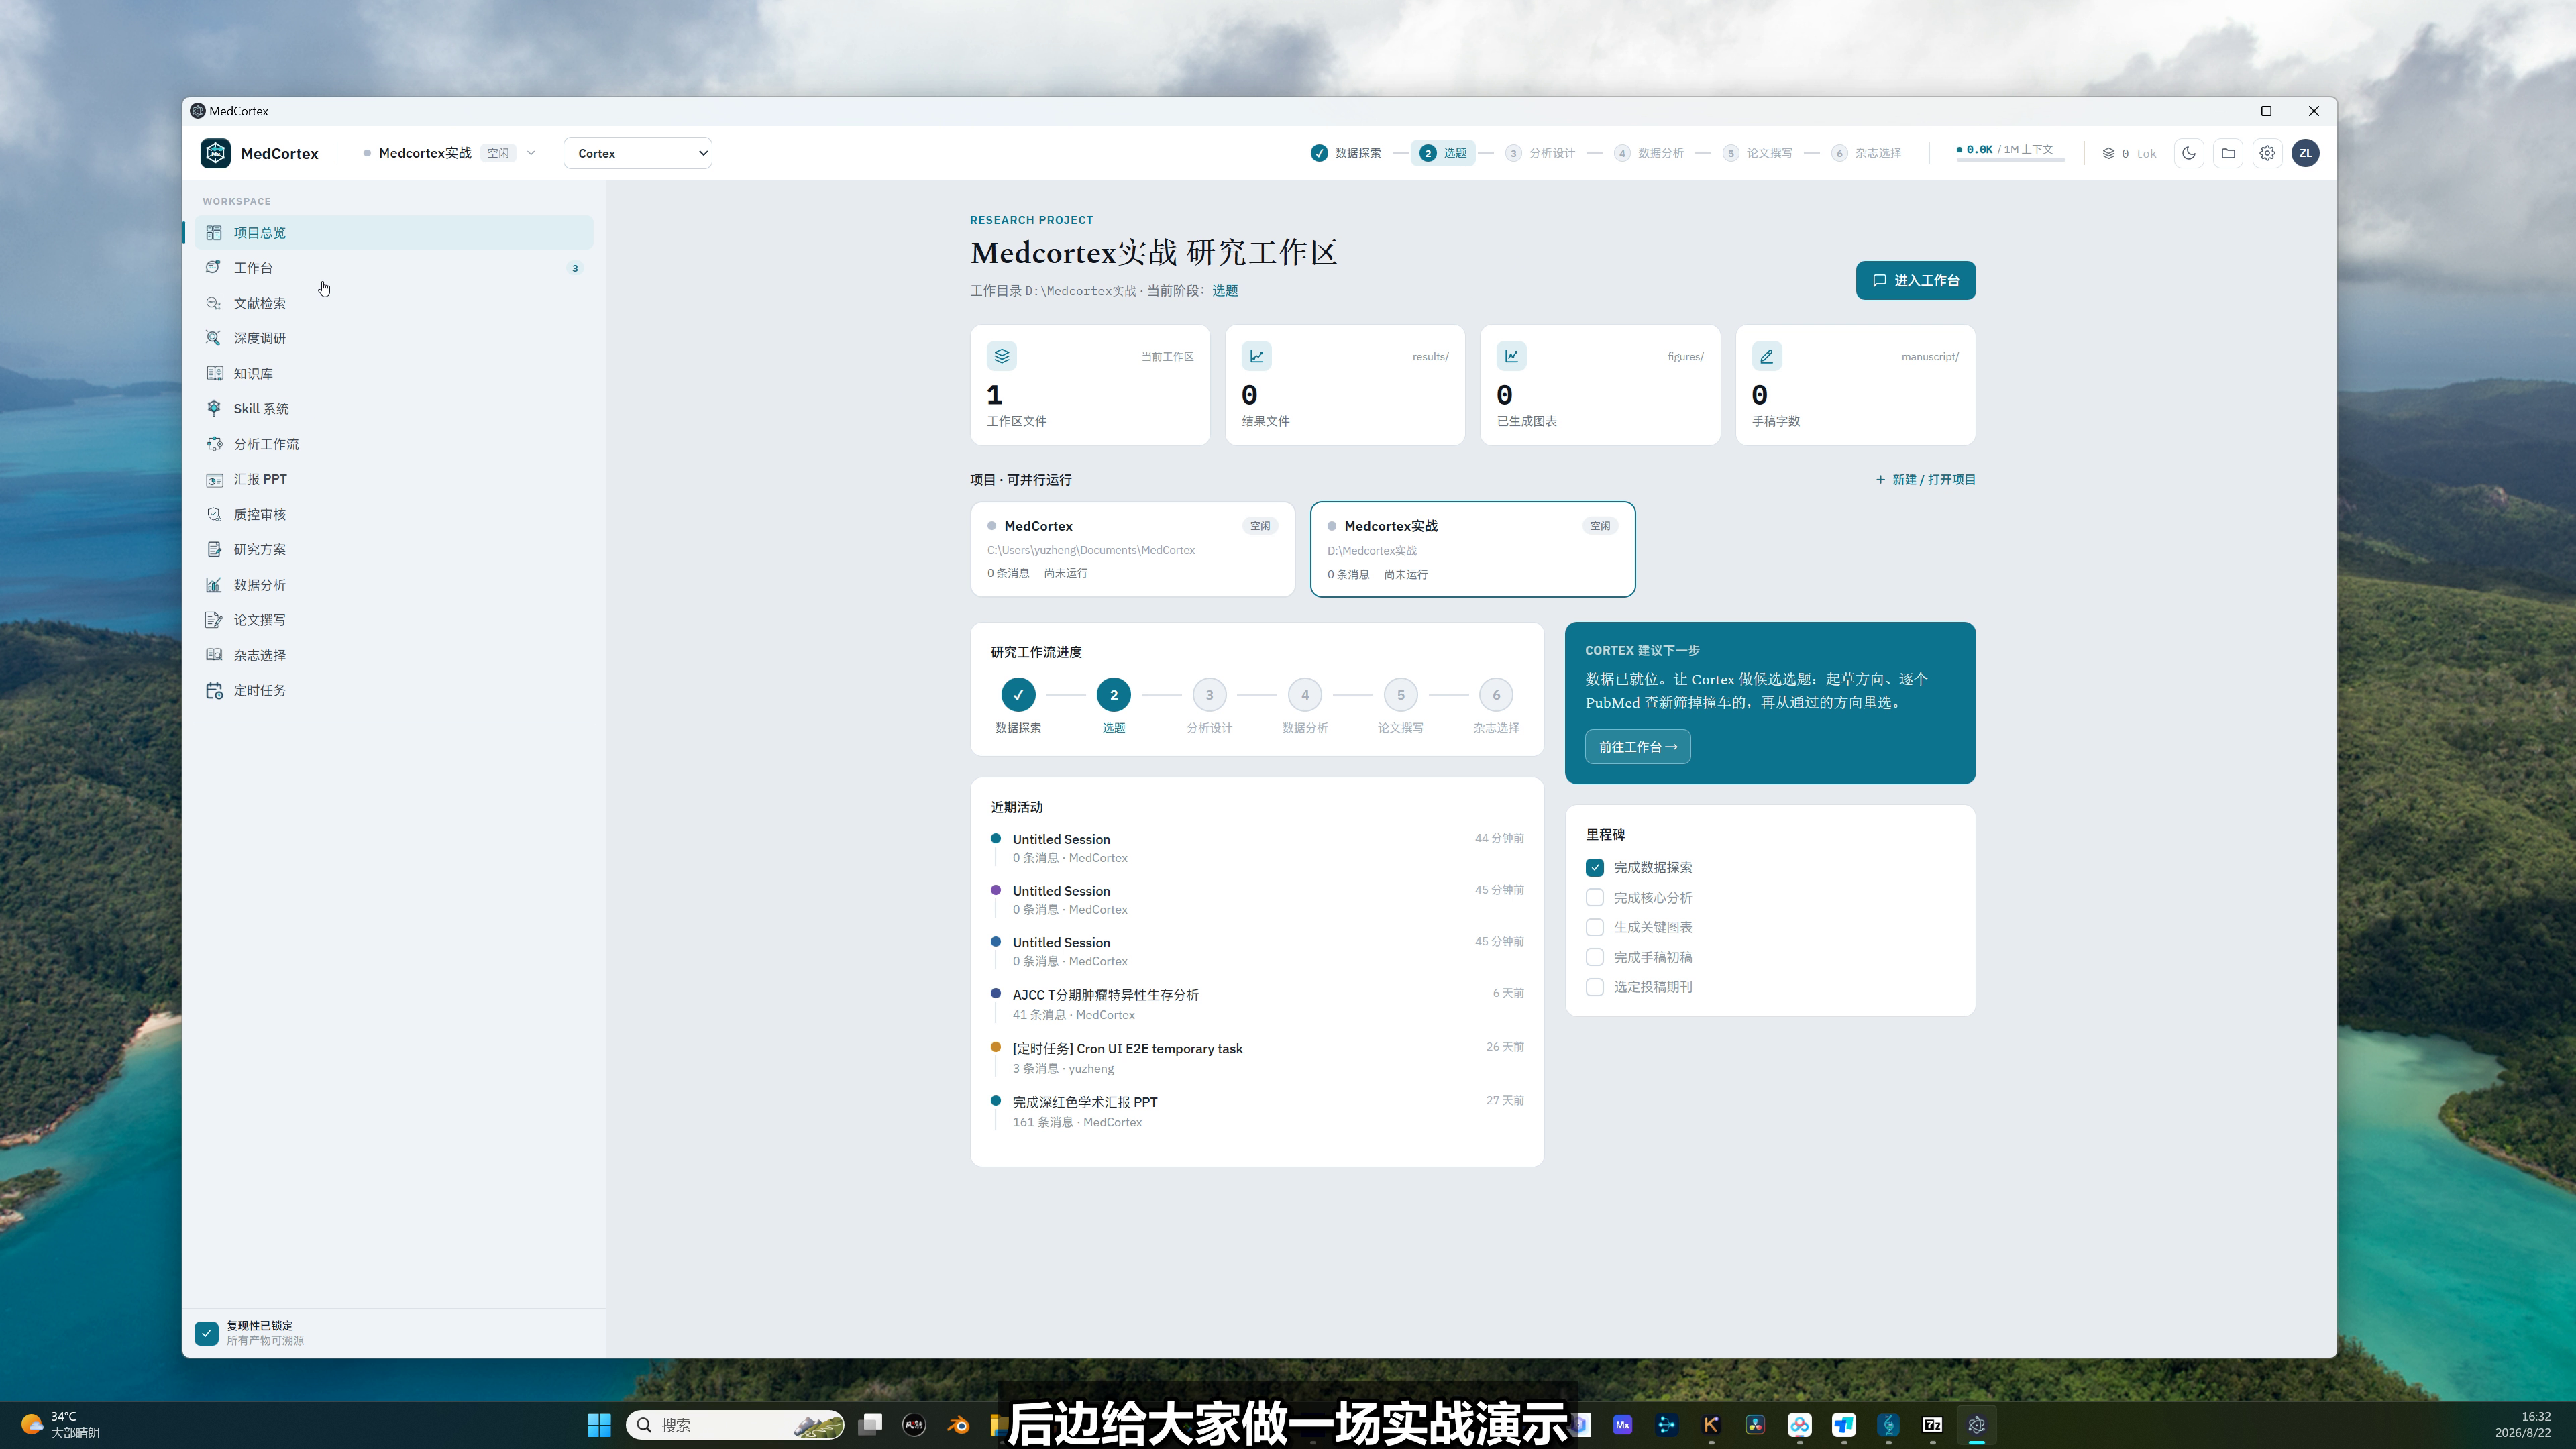
▲ 项目主页:顶部一条研究工作流进度条,左侧 14 个功能模块入口,中间是项目状态卡片
这个界面里能读出的信息不少:顶部那条 6 阶段的进度条,就是一条论文从"数据探索 → 选题 → 分析设计 → 数据分析 → 论文撰写 → 杂志选择"的流水线,每一步都标了序号和当前状态。左侧导航栏把这条流水线展开成了 14 个独立入口:项目总览、工作台、文献检索、深度调研、知识库、Skill 系统、分析工作流、汇报 PPT、质控审核、研究方案、数据分析、论文撰写、杂志选择、定时任务。
中间四张数字卡告诉你当前这个项目的状态:工作区文件 1 个、结果文件 0 个、已生成图表 0 张、手稿字数 0。下面"研究工作流进度"小条复述了顶部那条流水线,"Cortex 建议下一步"直接告诉你现在该做啥——数据已经就位,让 Cortex 做候选选题。
💡 一句话记住:MedCortex 不是聊天工具,是一套把整个论文生命周期都装下的 agent 智能体系统。
二、整体流水线是怎么跑的?
我把那 16 段视频浓缩成一张流水线图。从左往右走,就是一篇论文的"出生"过程。
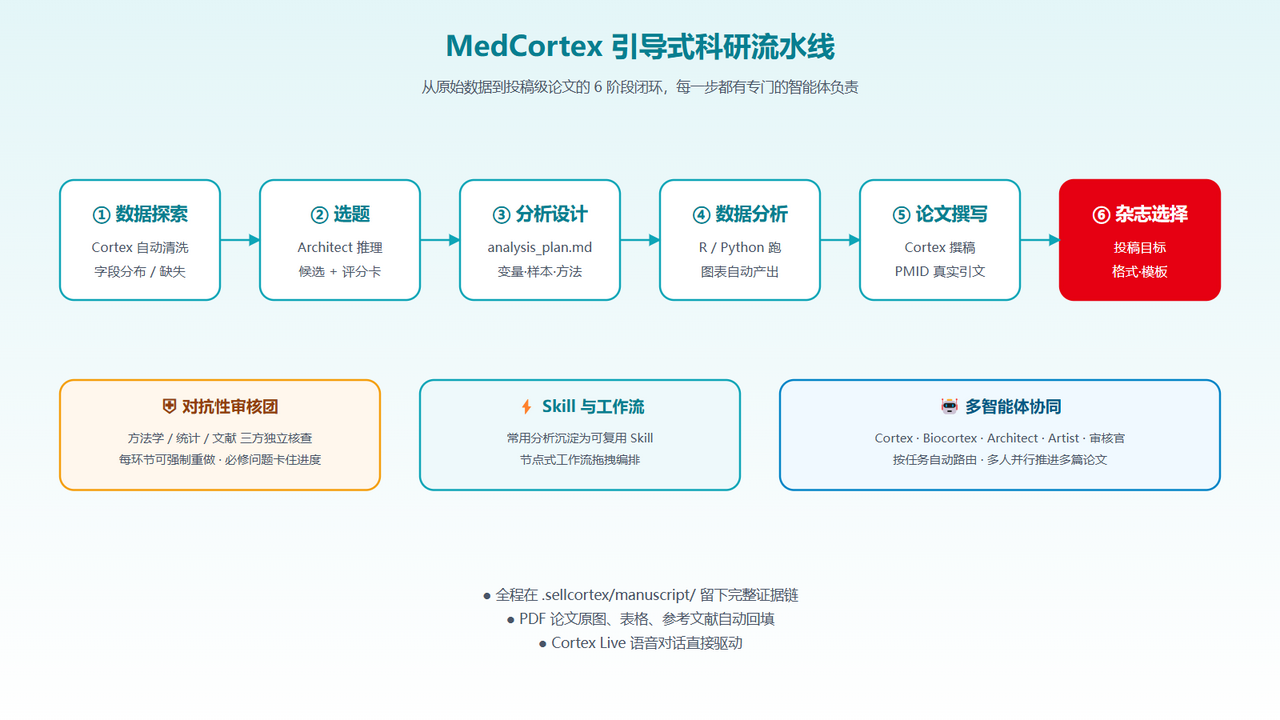
▲ 6 阶段流水线 + 3 个支撑层(对抗性审核团、Skill 与工作流、多智能体协同)
展开说每一段在视频里都演了什么:
- 数据探索:Cortex 把 Excel 拖进来,自己做字段分布、缺失值、变量类型识别。
- 选题:Architect 接过去,调用 PubMed 检索几十篇相关文献,对每个候选方向打分,给出 A-H 的多个选题卡片。
- 分析设计:落成一份
analysis_plan.md,里面写清楚用 SEER 数据库、纳排标准、变量清单、统计方法、Figure 1~4 各是什么。 - 数据分析:在右侧的代码面板里跑 R,KM 曲线、Cox 回归、RCS 限制性立方样条、随机森林,一个不落。
- 论文撰写:Cortex 把结果写成英文学术段落,自动插真实 PMID 引用。
- 杂志选择:根据内容匹配投稿目标期刊,给出格式模板。
流水线下面铺了三层支撑——这是视频里反复出现的"幕后":
- 对抗性审核团:方法学、统计、文献三个独立审核官"挑刺",必修问题不修不让过。
- Skill 与工作流:把常用分析沉淀为可复用 Skill,节点式工作流支持拖拽编排和分支。
- 多智能体协同:Cortex、Biocortex、Architect、Artist 各管一摊,按任务自动路由。
三、最重要的特色——一次给你 8 个选题,多篇同时推进
看 MedCortex 的演示视频,标题里最让我眼前一亮的一句话是"同时推进多篇不同方向论文"。这不是吹的——视频里能看到,Architect 在选题环节一次性给出了 8 个候选方向,让你可以同时挑 2~3 个进入并行分析。
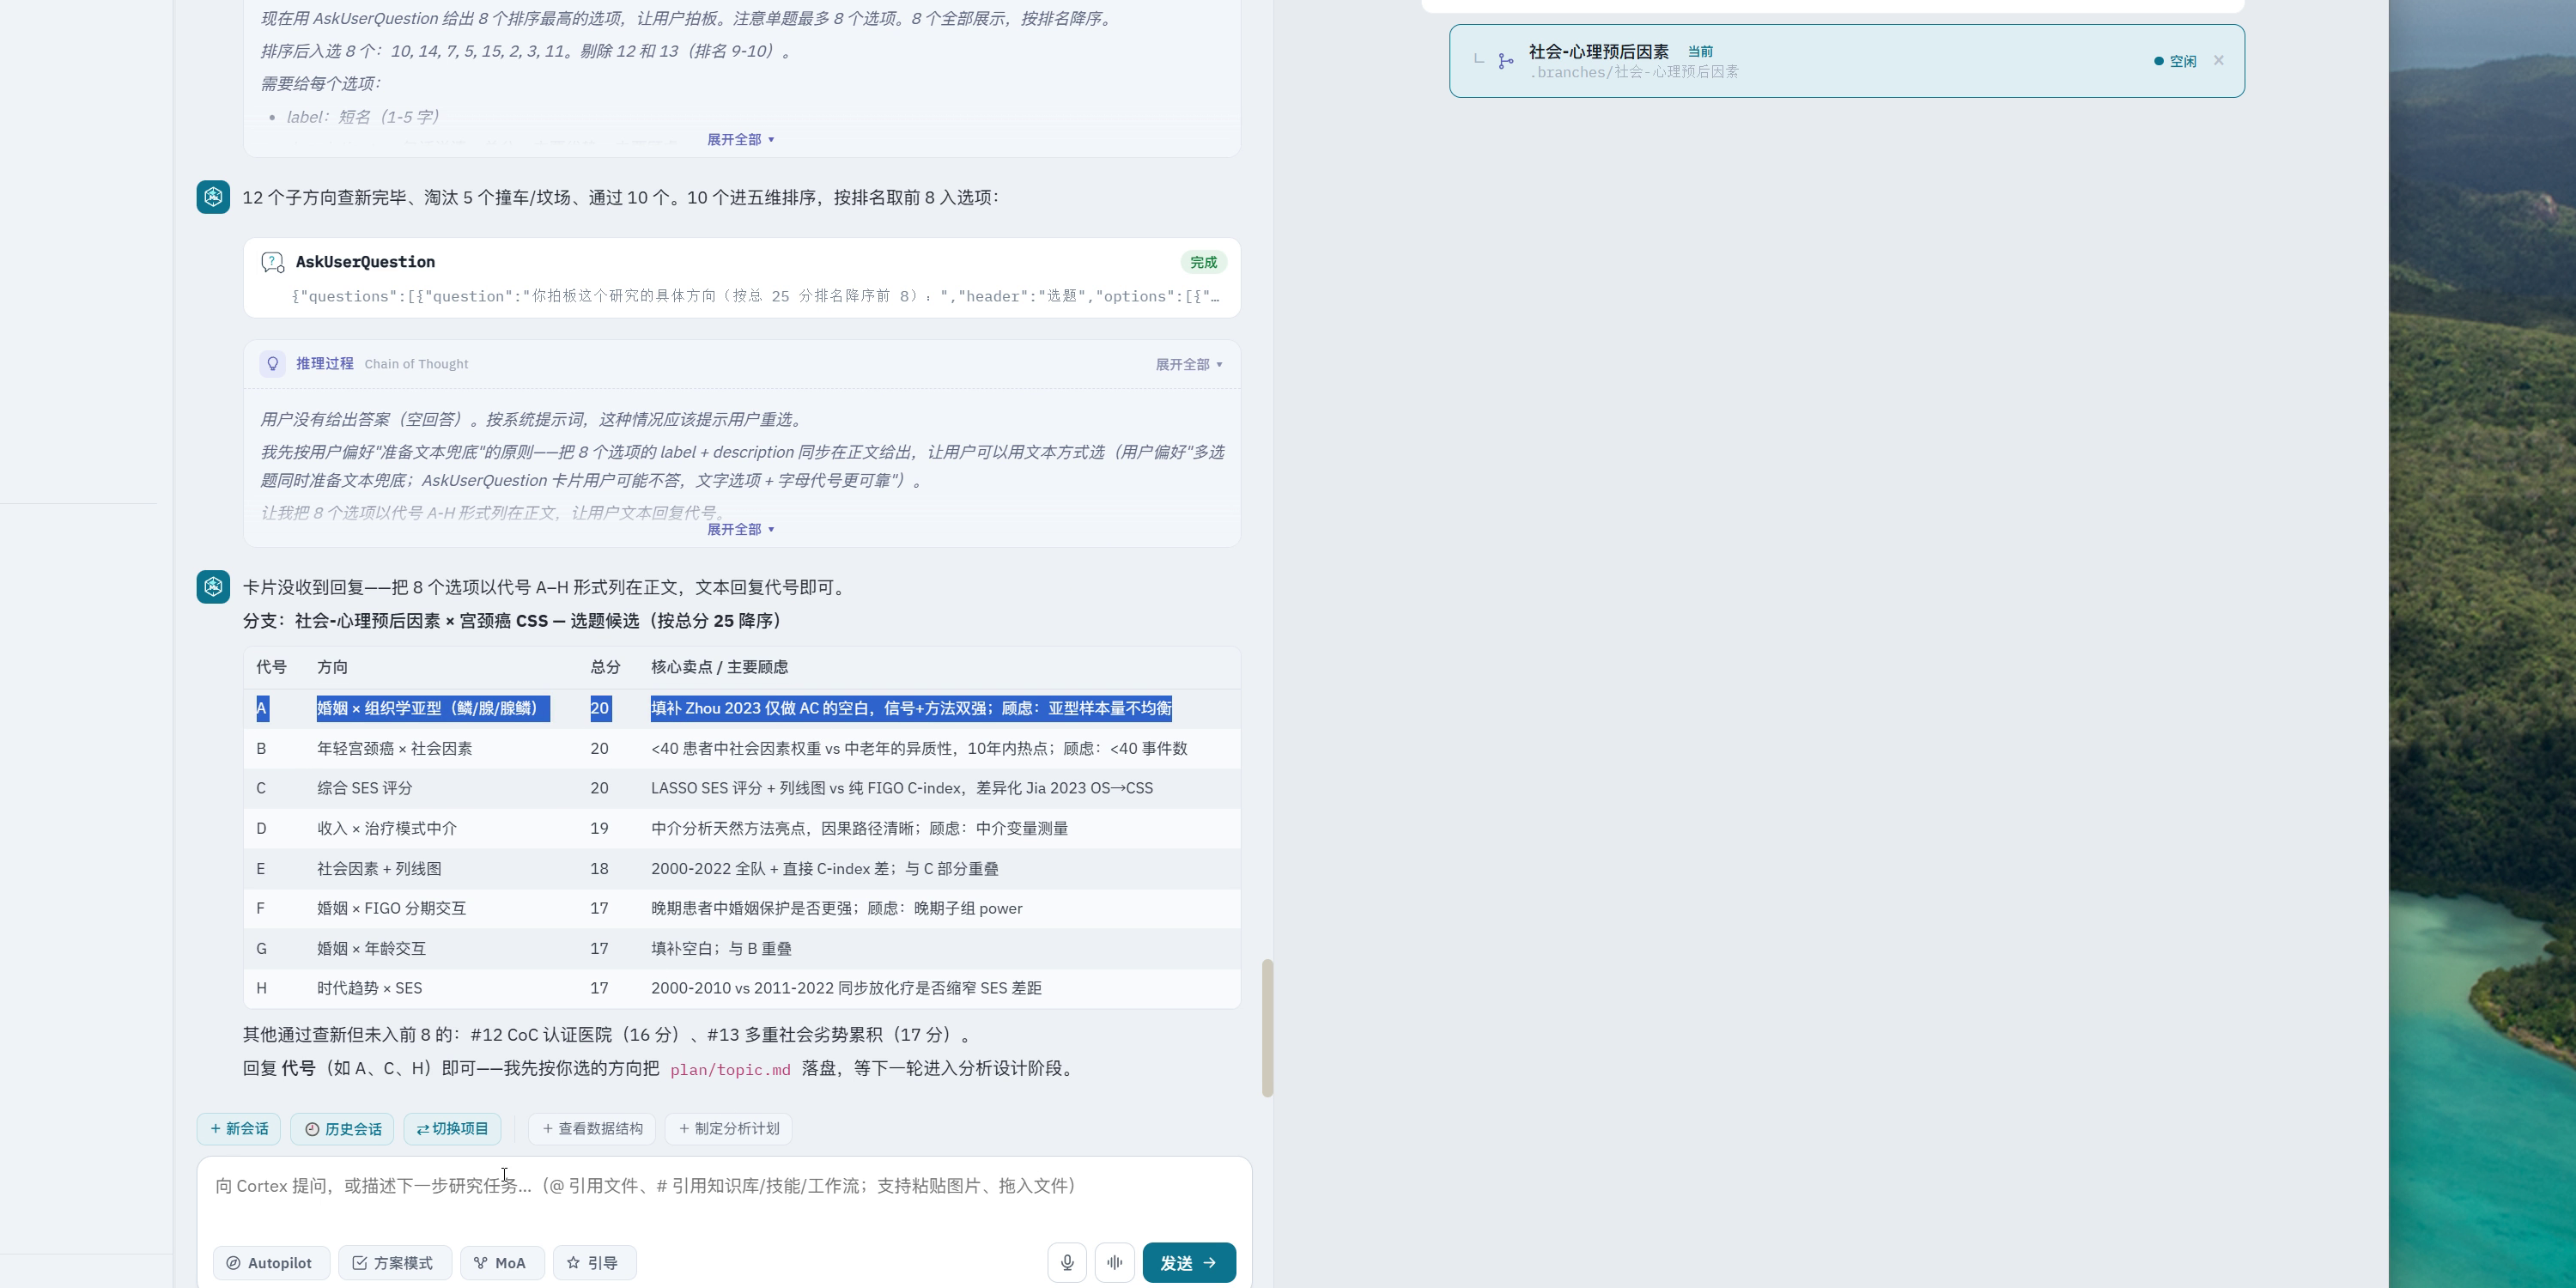
▲ Architect 给出的 8 个候选选题(A-H),每个方向都有总分、核心卖点、主要顾虑
把这一屏展开讲:MedCortex 在数据探索阶段调研了 12 个子方向,淘汰了 5 个撞车/攻场的(命中率 41.7%),剩下 10 个进入五维排序,最终排名前 8 入选项。每个候选都列了三件事:
- 方向代号(A~H):方便你后文用代号引用,不用反复念长标题。
- 总分(满分 25):基于影响力、可行性、热门、稀缺性、深度五个维度评分。
- 核心卖点 + 主要顾虑:直接告诉你这个方向"为什么值得做"和"哪里可能有坑",不再需要你自己查一遍文献去判断。
看具体几个方向:
- A(20 分):婚姻 × 组织学亚型(鳞/腺/腺鳞)——填补 Zhou 2023 仅有 AC 的空白,方法双强;顾虑是亚型样本量不均衡。
- B(20 分):年轻宫颈癌 × 社会因素——<40 患者中社会因素权重 vs 中老年的异质性,10 年内热点;顾虑是 <40 事件数偏少。
- C(20 分):综合 SES 评分——LASSO SES 评分 + 列线图 vs 纯 FIGO C-index,差异化 Jia 2023 OS→CSS。
- E(18 分):社会因素 + 列线图——2000-2022 全队 + 直接 C-index 差;与 C 部分重叠。
选哪个?视频里 MedCortex 直接给你一个"AskUserQuestion",把 8 个方向列入单选,你用 A、C、H 这种代号回复就行,比在对话框里敲一长串标题快得多。回复后,它会把你选的方向落成 plan/topic.md,等下一轮进入分析设计阶段。
关键在"多篇同时推进"——视频里能清楚看到,右侧"研究方向"面板下挂着多个项目分支("社会-心理预后因素"已经标记为"当前"分支),每个分支独立跑各自的流水线。这意味着你可以让 Cortex 同时跑"宫颈癌社会心理学分析"和"心血管病饮食模式",两篇论文在后台并行推进,互不打架。
💡 一句话记住:MedCortex 不是让你"一篇一篇写",而是让你"一组方向并行探"。这恰好契合临床医学"不知道哪条路能跑通"的真实痛点。
四、不只是一个智能体——是 5 个角色互相挑刺
很多人以为 MedCortex 只是把 ChatGPT 包了一层界面,但视频里能看到,它内置了至少 4 个不同专长的智能体,外加一个独立的审核团体系。
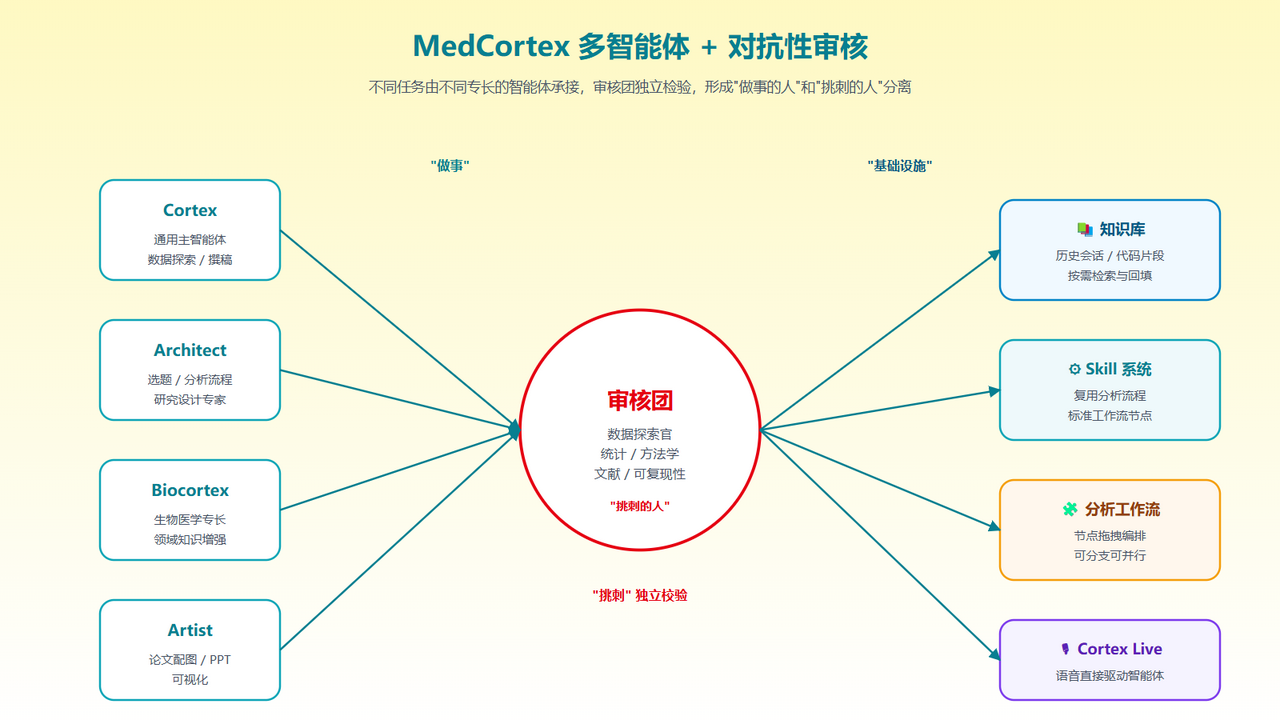
▲ 左边"做事"的 4 个智能体 + 中间"挑刺"的审核团 + 右边 4 个基础设施
左侧 4 个角色各司其职:
- Cortex:通用主智能体,负责数据清洗、文献调研、撰稿、PPT 制作等通用任务。
- Architect:选题与分析流程专家,专门做研究设计和方法学推理。
- Biocortex:生物医学专长角色,带领域知识增强。
- Artist:论文配图、PPT 美化的可视化角色。
中间那个红色圆圈就是"挑刺的人"——审核团。它会独立派数据探索审核官、统计/方法学审核官、文献/可复现性审核官,对结果逐条核查,发现的必修问题直接卡住进度。
右边 4 个是基础设施:
- 知识库:历史会话和代码片段可检索复用,不会"做完就忘"。
- Skill 系统:把常用分析流程封装成可调用模块。
- 分析工作流:节点拖拽式编排,可分支可并行。
- Cortex Live:实时语音对话直接驱动整个智能体团队。
⚠ 关键差别:"做事"和"挑刺"是分开的。这意味着你的结果不会被同一个人工智能自己审完就过——有第三方独立校验。
五、数据分析跑出来什么样?看一张真图
光说"自动跑分析"是空的。我们直接看 MedCortex 在 SEER 宫颈癌数据上自动跑出的一张限制性立方样条图(Restricted Cubic Spline for age-CSS association by FIGO stage)。
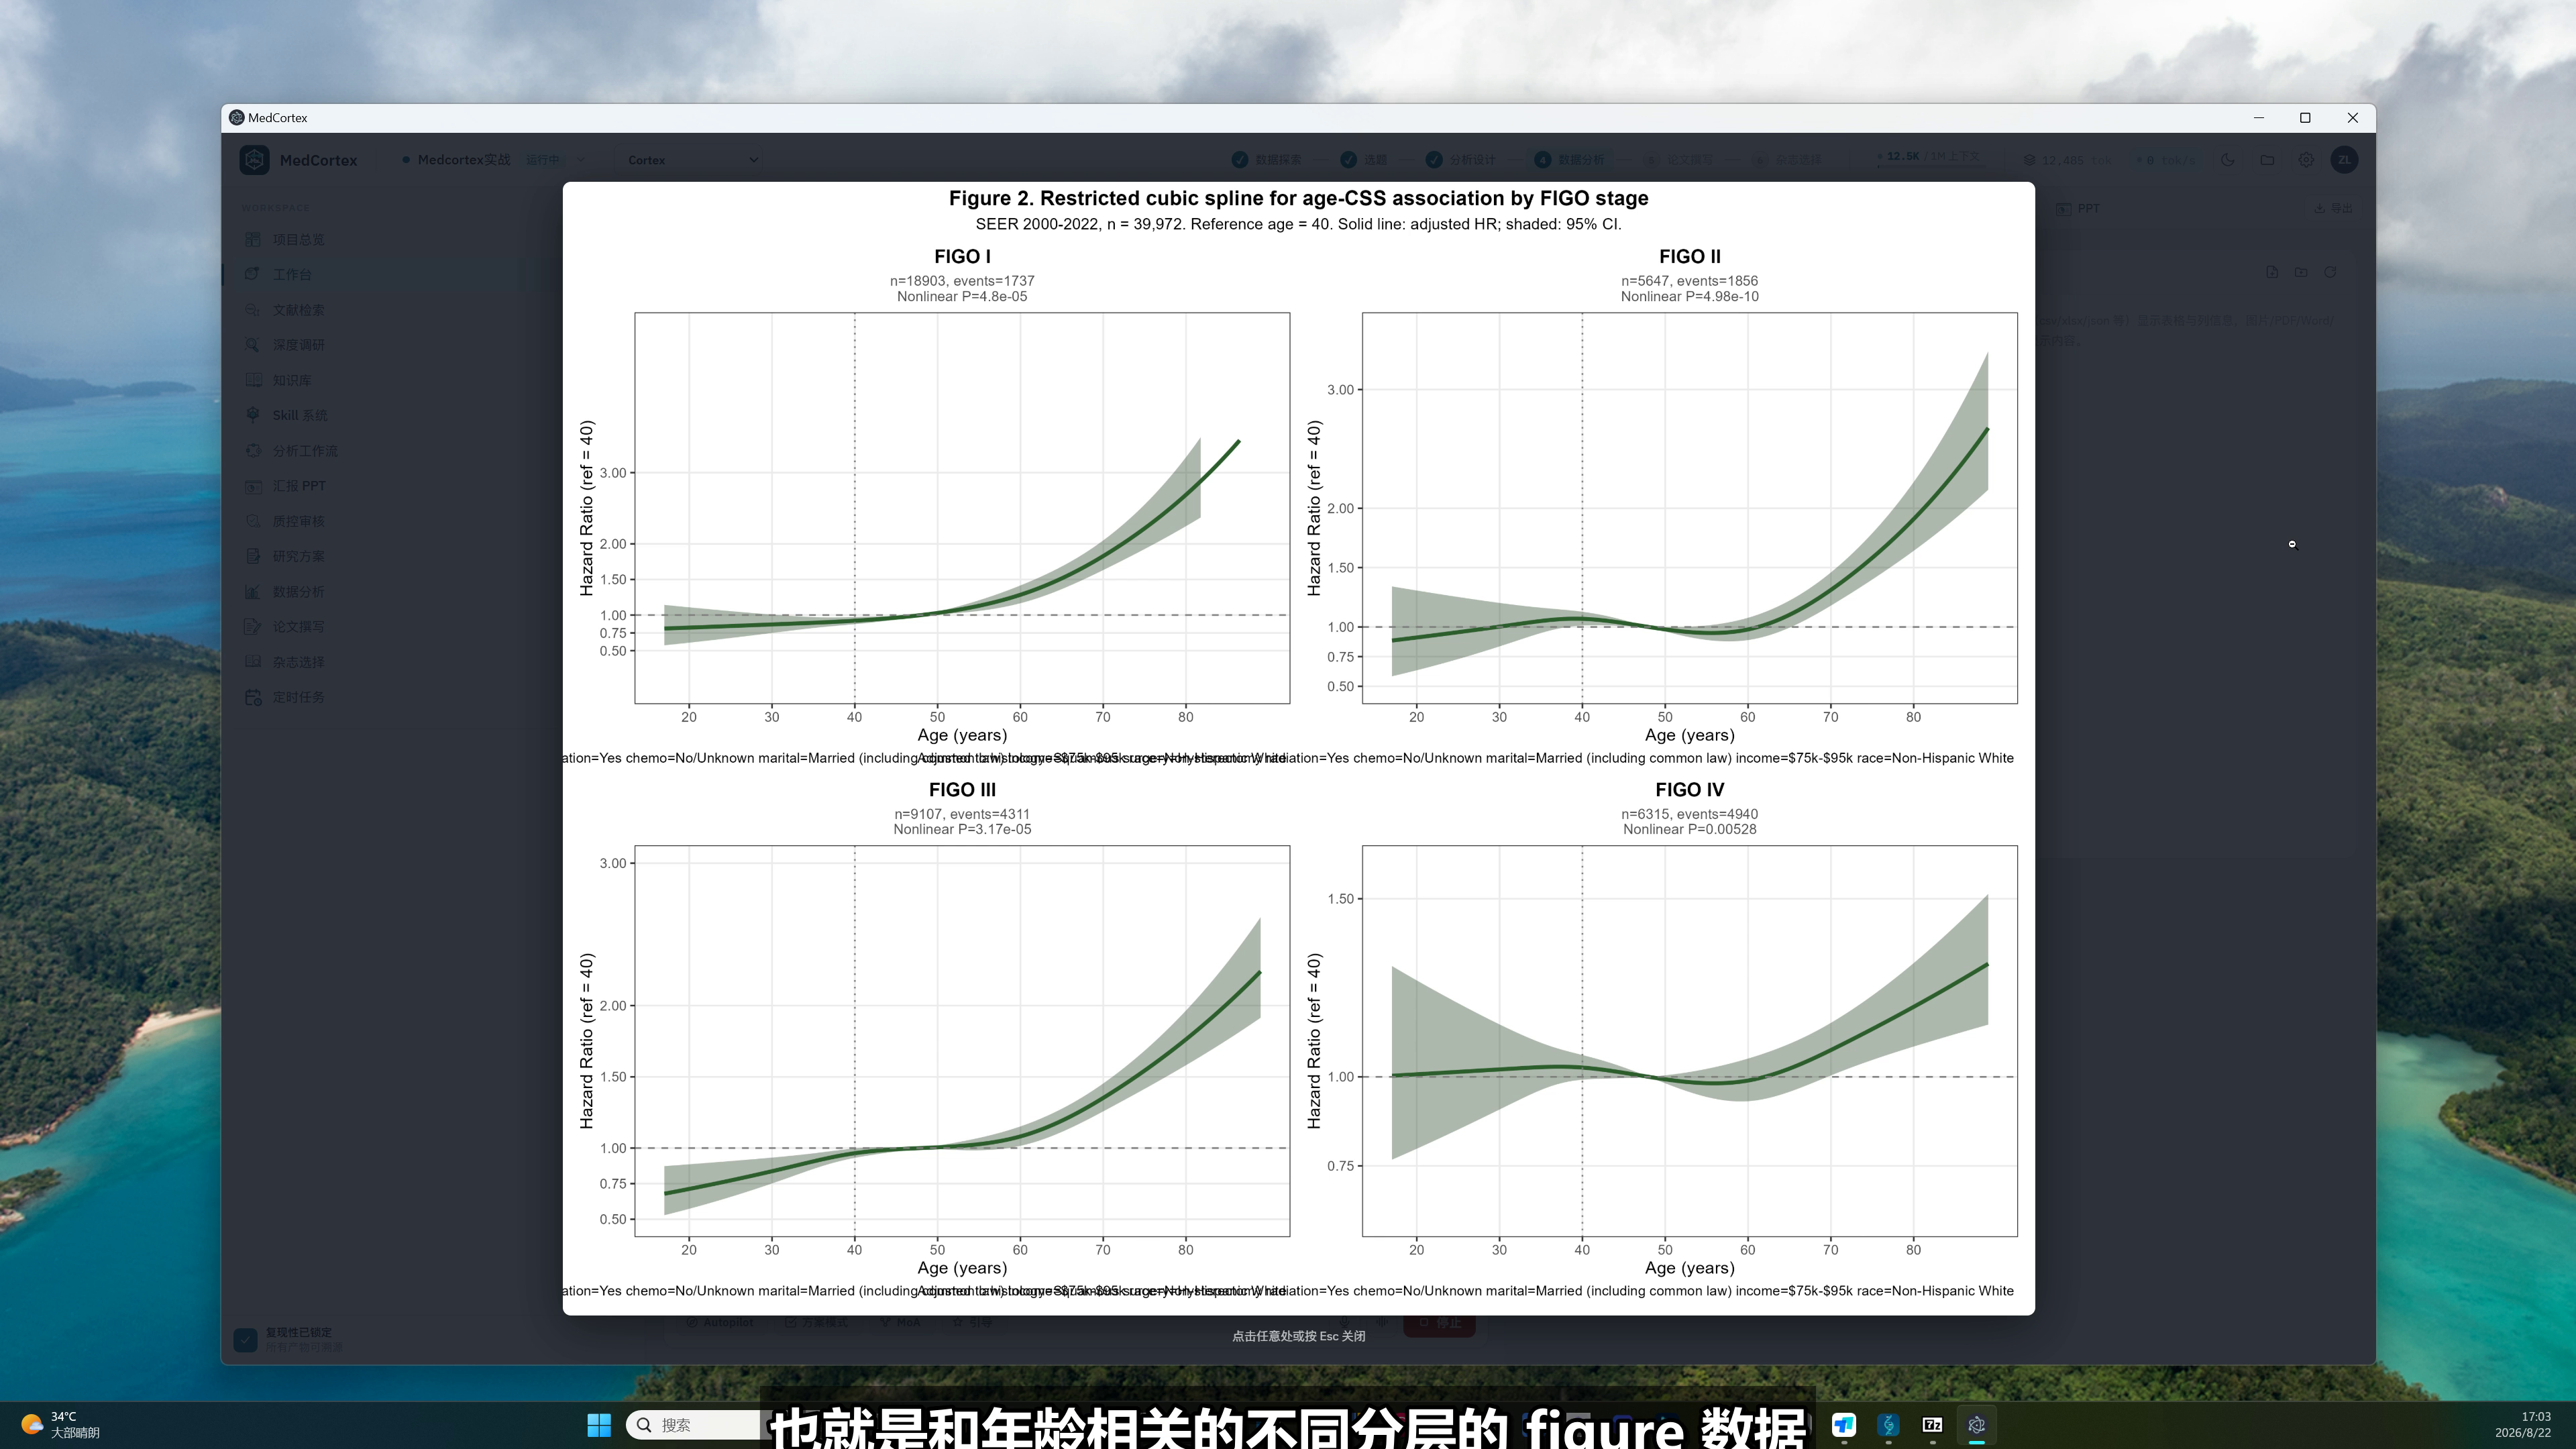
▲ SEER 2000-2022,n=39,972,按 FIGO 分期拆成 4 个子图,年龄 vs CSS 风险比,灰色阴影为 95% CI
这一张图你不用看细,就能看出几个硬指标:
- 4 个 FIGO 分期(I/II/III/IV)各一张子图,n=18,903 / 5,647 / 9,107 / 6,315,样本量足够大。
- 每个子图都标了 Nonlinear P 值(4.8e-5、4.98e-10、3.17e-5、0.00528)——非线性关系显著。
- 所有置信区间都是 95% CI,灰带画到位。
这种图在真实临床研究中是要单独写一段方法学和统计细节才能产出的。MedCortex 自动跑出来,并且按可发表标准画好了版式。
六、产出物长什么样?看一份投稿级稿件
这是 MedCortex 真正让我吃惊的一段:分析跑完之后,它直接生成了一份投稿级表格和一份投稿级英文正文。打开 WPS 看一眼就知道——这不是凑数的草稿。
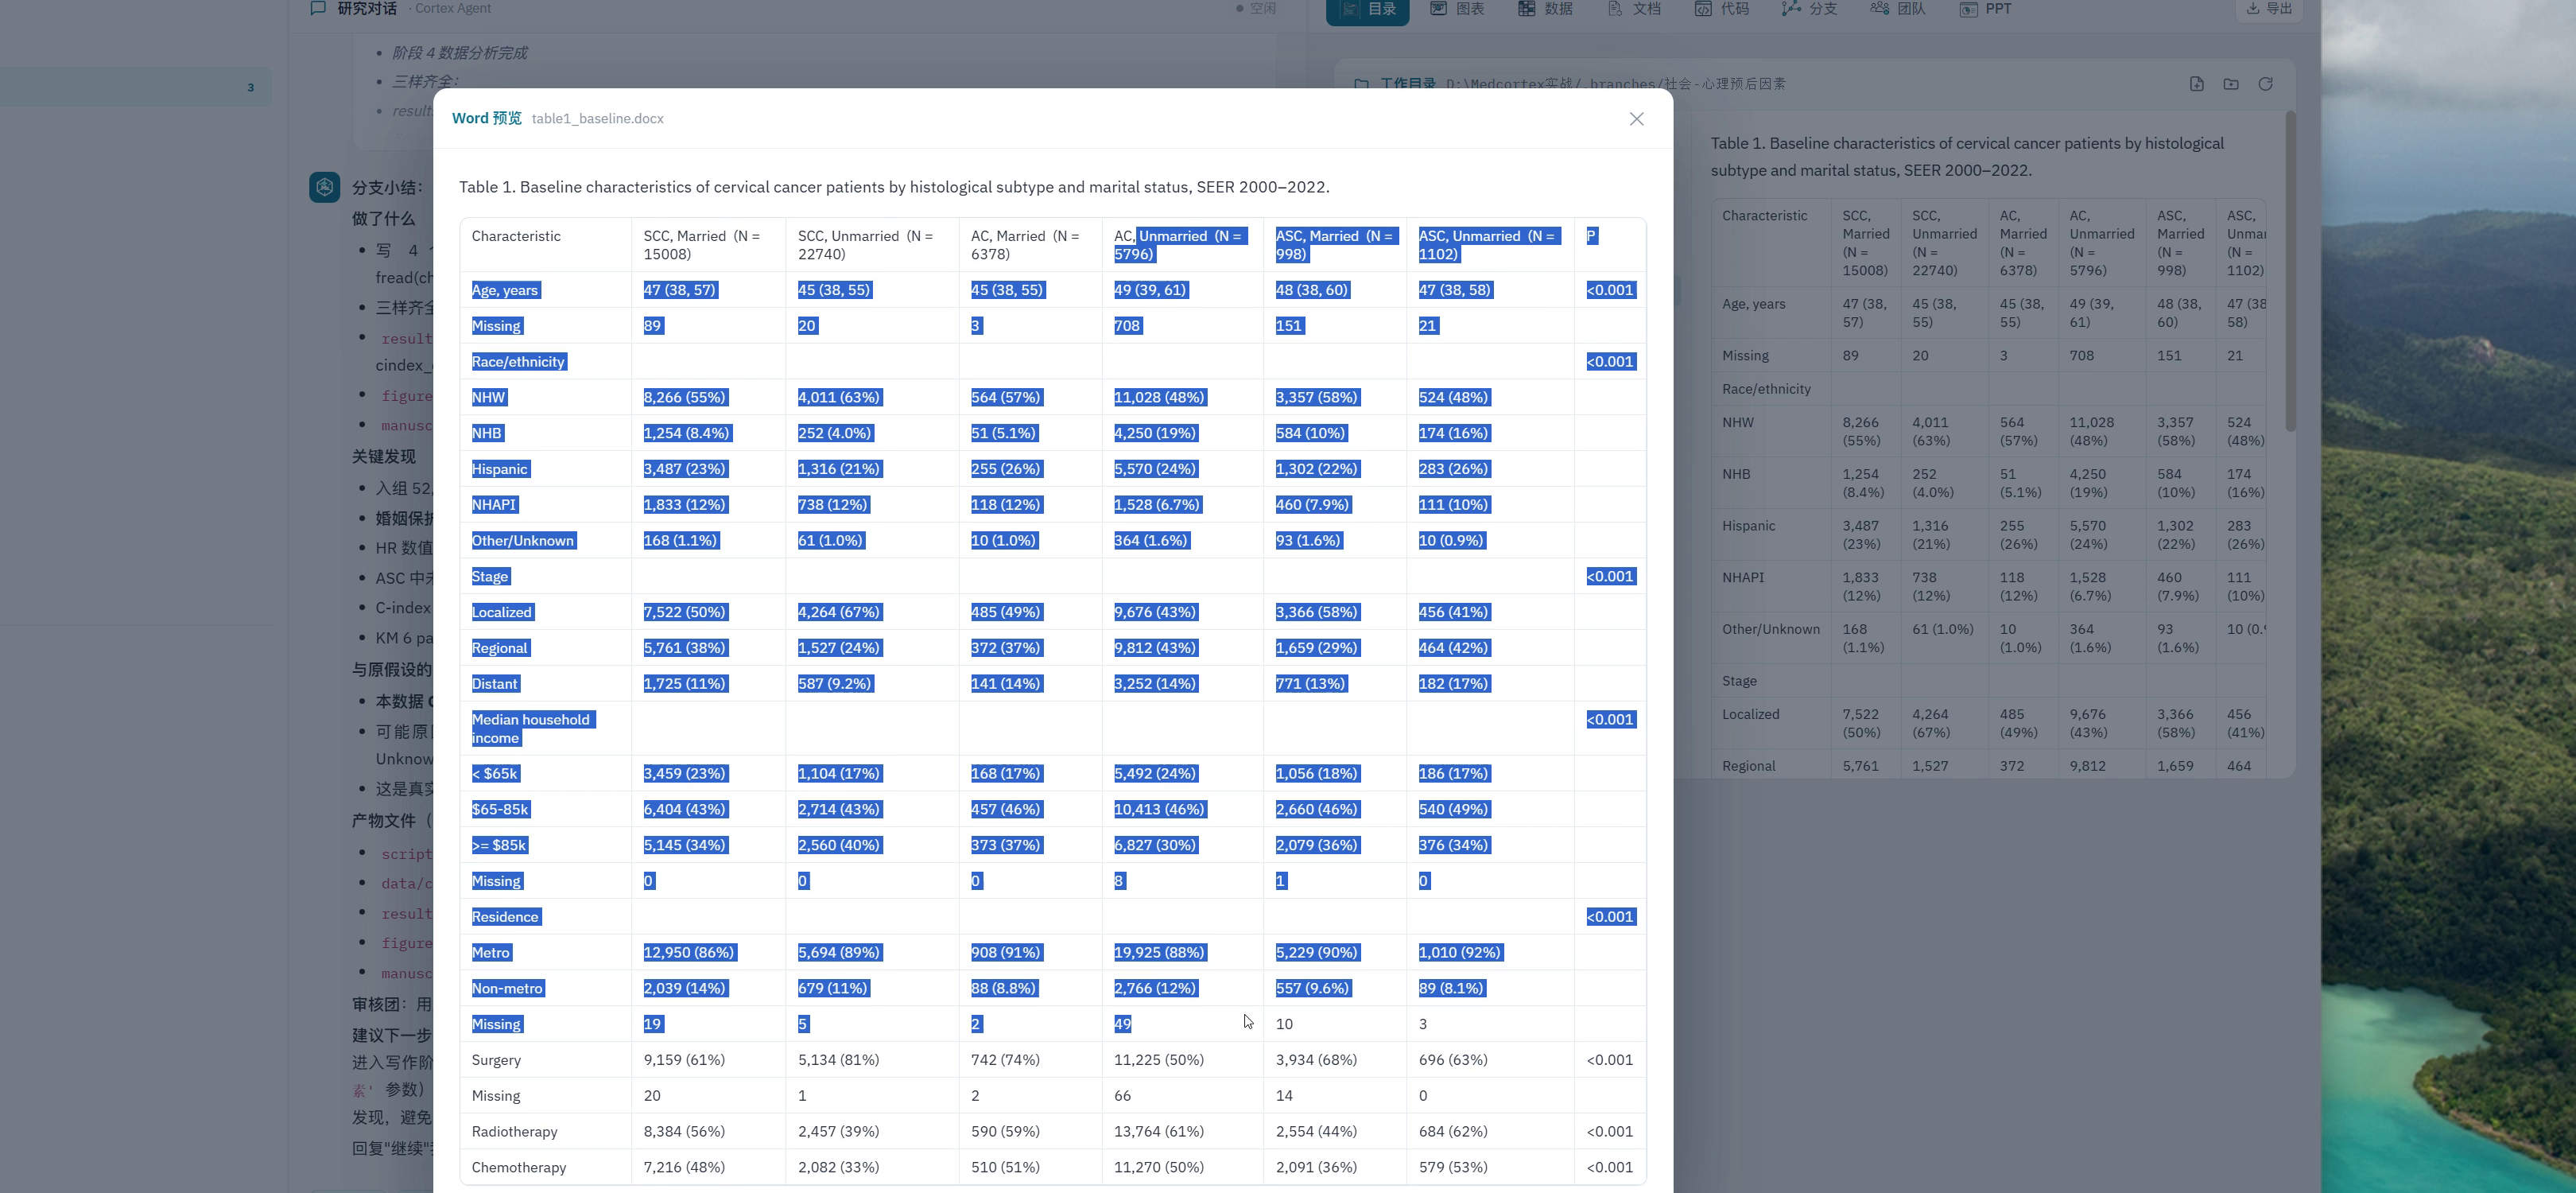
▲ Table 1:按组织学亚型(SCC/AC/ASC)× 婚姻状态(Married/Unmarried)六分层基线特征,SEER 2000–2022
这张 Table 1 的结构非常标准:标题清晰、行项目覆盖 Age、Race/ethnicity、Stage 等所有 SEER 常用变量;六列分别是三种组织学亚型 × 两种婚姻状态,N 值都标到了每个 cell。这正是 Cancer / Medicine / Frontiers in Oncology 这类期刊投稿要求的基线表版式。
再来看正文:
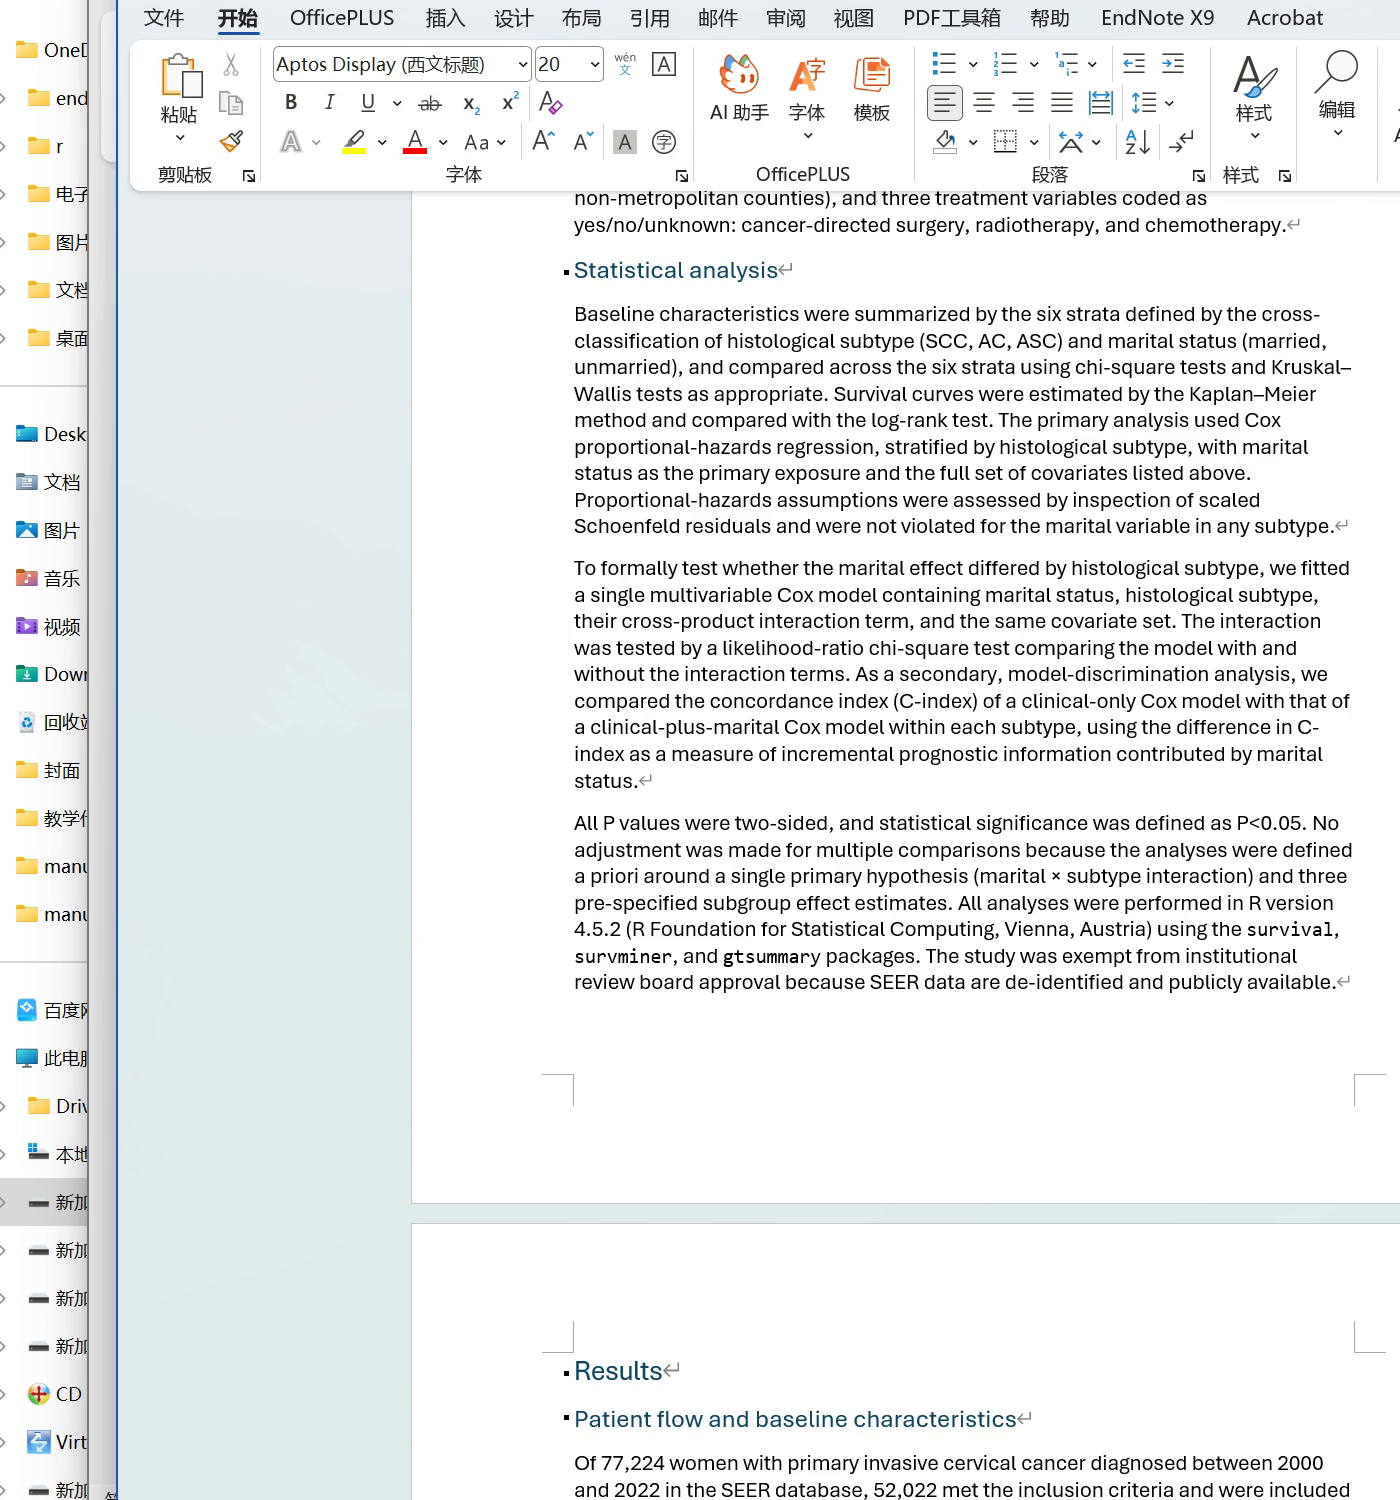
▲ WPS 中 Statistical analysis 与 Results 章节:六分层、K-M、Cox、Kruskal–Wallis,全套英文成稿
注意看 Statistical analysis 章节的英文行文:六分层(cross-classification of histological subtype and marital status)、Kruskal–Wallis 检验、K-M 曲线、log-rank 检验、Cox proportional-hazards regression、Schoenfeld residuals 检验比例风险假设——术语准确、句式规范。结果章节起头一句"Of 77,224 women with primary invasive cervical cancer diagnosed between 2000 and 2022 in the SEER database, 52,022 met the inclusion criteria",正是英文临床论文的标志性开头。
💡 翻译过来:从一份 CSV 到投稿级表格和投稿级正文,整条流水线都跑通了。
七、图都画完了,还能怎么调?看"图床排版"
另一个让我眼前一亮的,是 MedCortex 的"图床排版"功能。跑出来的图不是丢给你一堆 PNG 就完事,而是能在一个弹窗里把多张图摆成投稿级别的多面板布局。
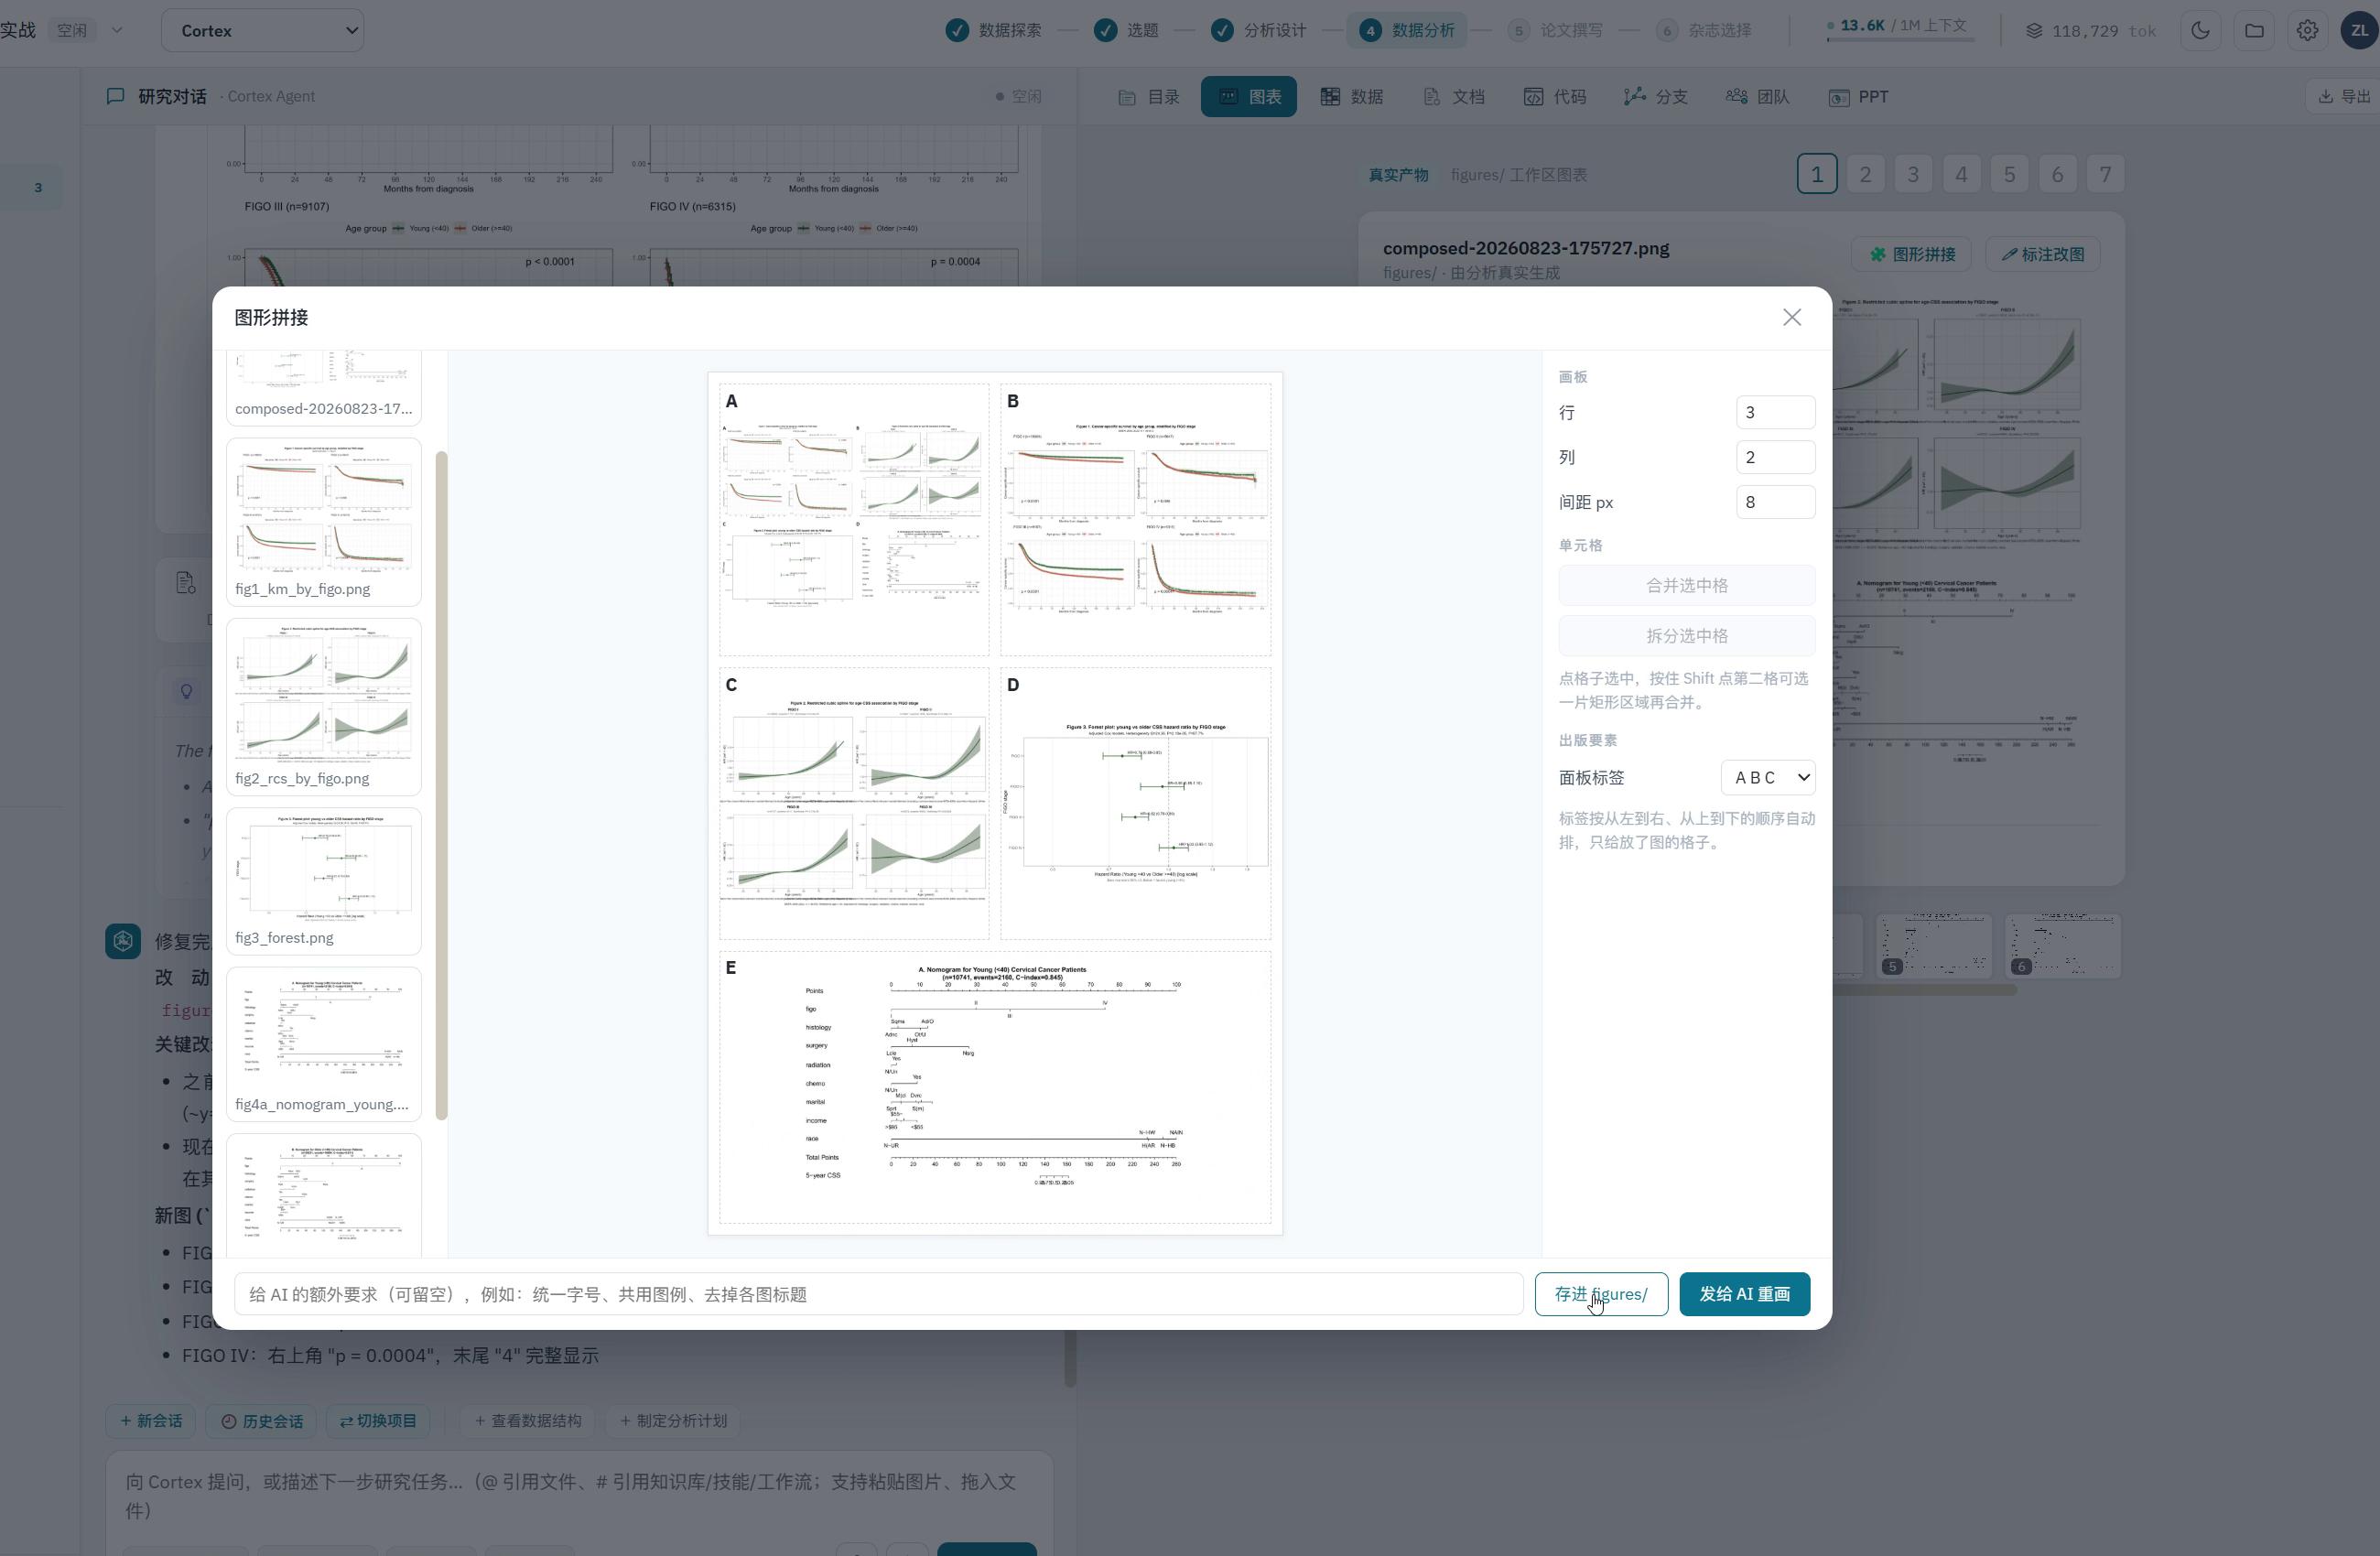
▲ 左侧是 figures/ 文件夹的图源,中间是 3×2 画板(A/B/C/D/E 五个面板标签),右侧设置行/列/间距
左边的图源列表能看到 fig1_km_by_figo、fig2_rcs_by_figo、fig3_forest、fig4a_nomogram_young 等;中间画板默认 3 行 × 2 列,每个面板都能拖入具体的图,标签按从左到右、从上到下自动 ABCDE 排;右边可以改行、列、间距、面板标签格式。最关键的是"发给 AI 重画"按钮——你嫌哪张图的字号不对、配色不统一,直接告诉 AI,让它把整套图重画一遍同步风格。
这一段对经常被审稿人打回"图字体不统一、面板标签不规范"的同仁来说,是真的省事。
八、对抗性审核团到底能挑出什么问题?
这是 MedCortex 区别于其他 AI 工具最硬核的一块。"审核团"会派专门的审核官,对数据探索、数据分析、论文撰写等每一个环节出一份独立报告。
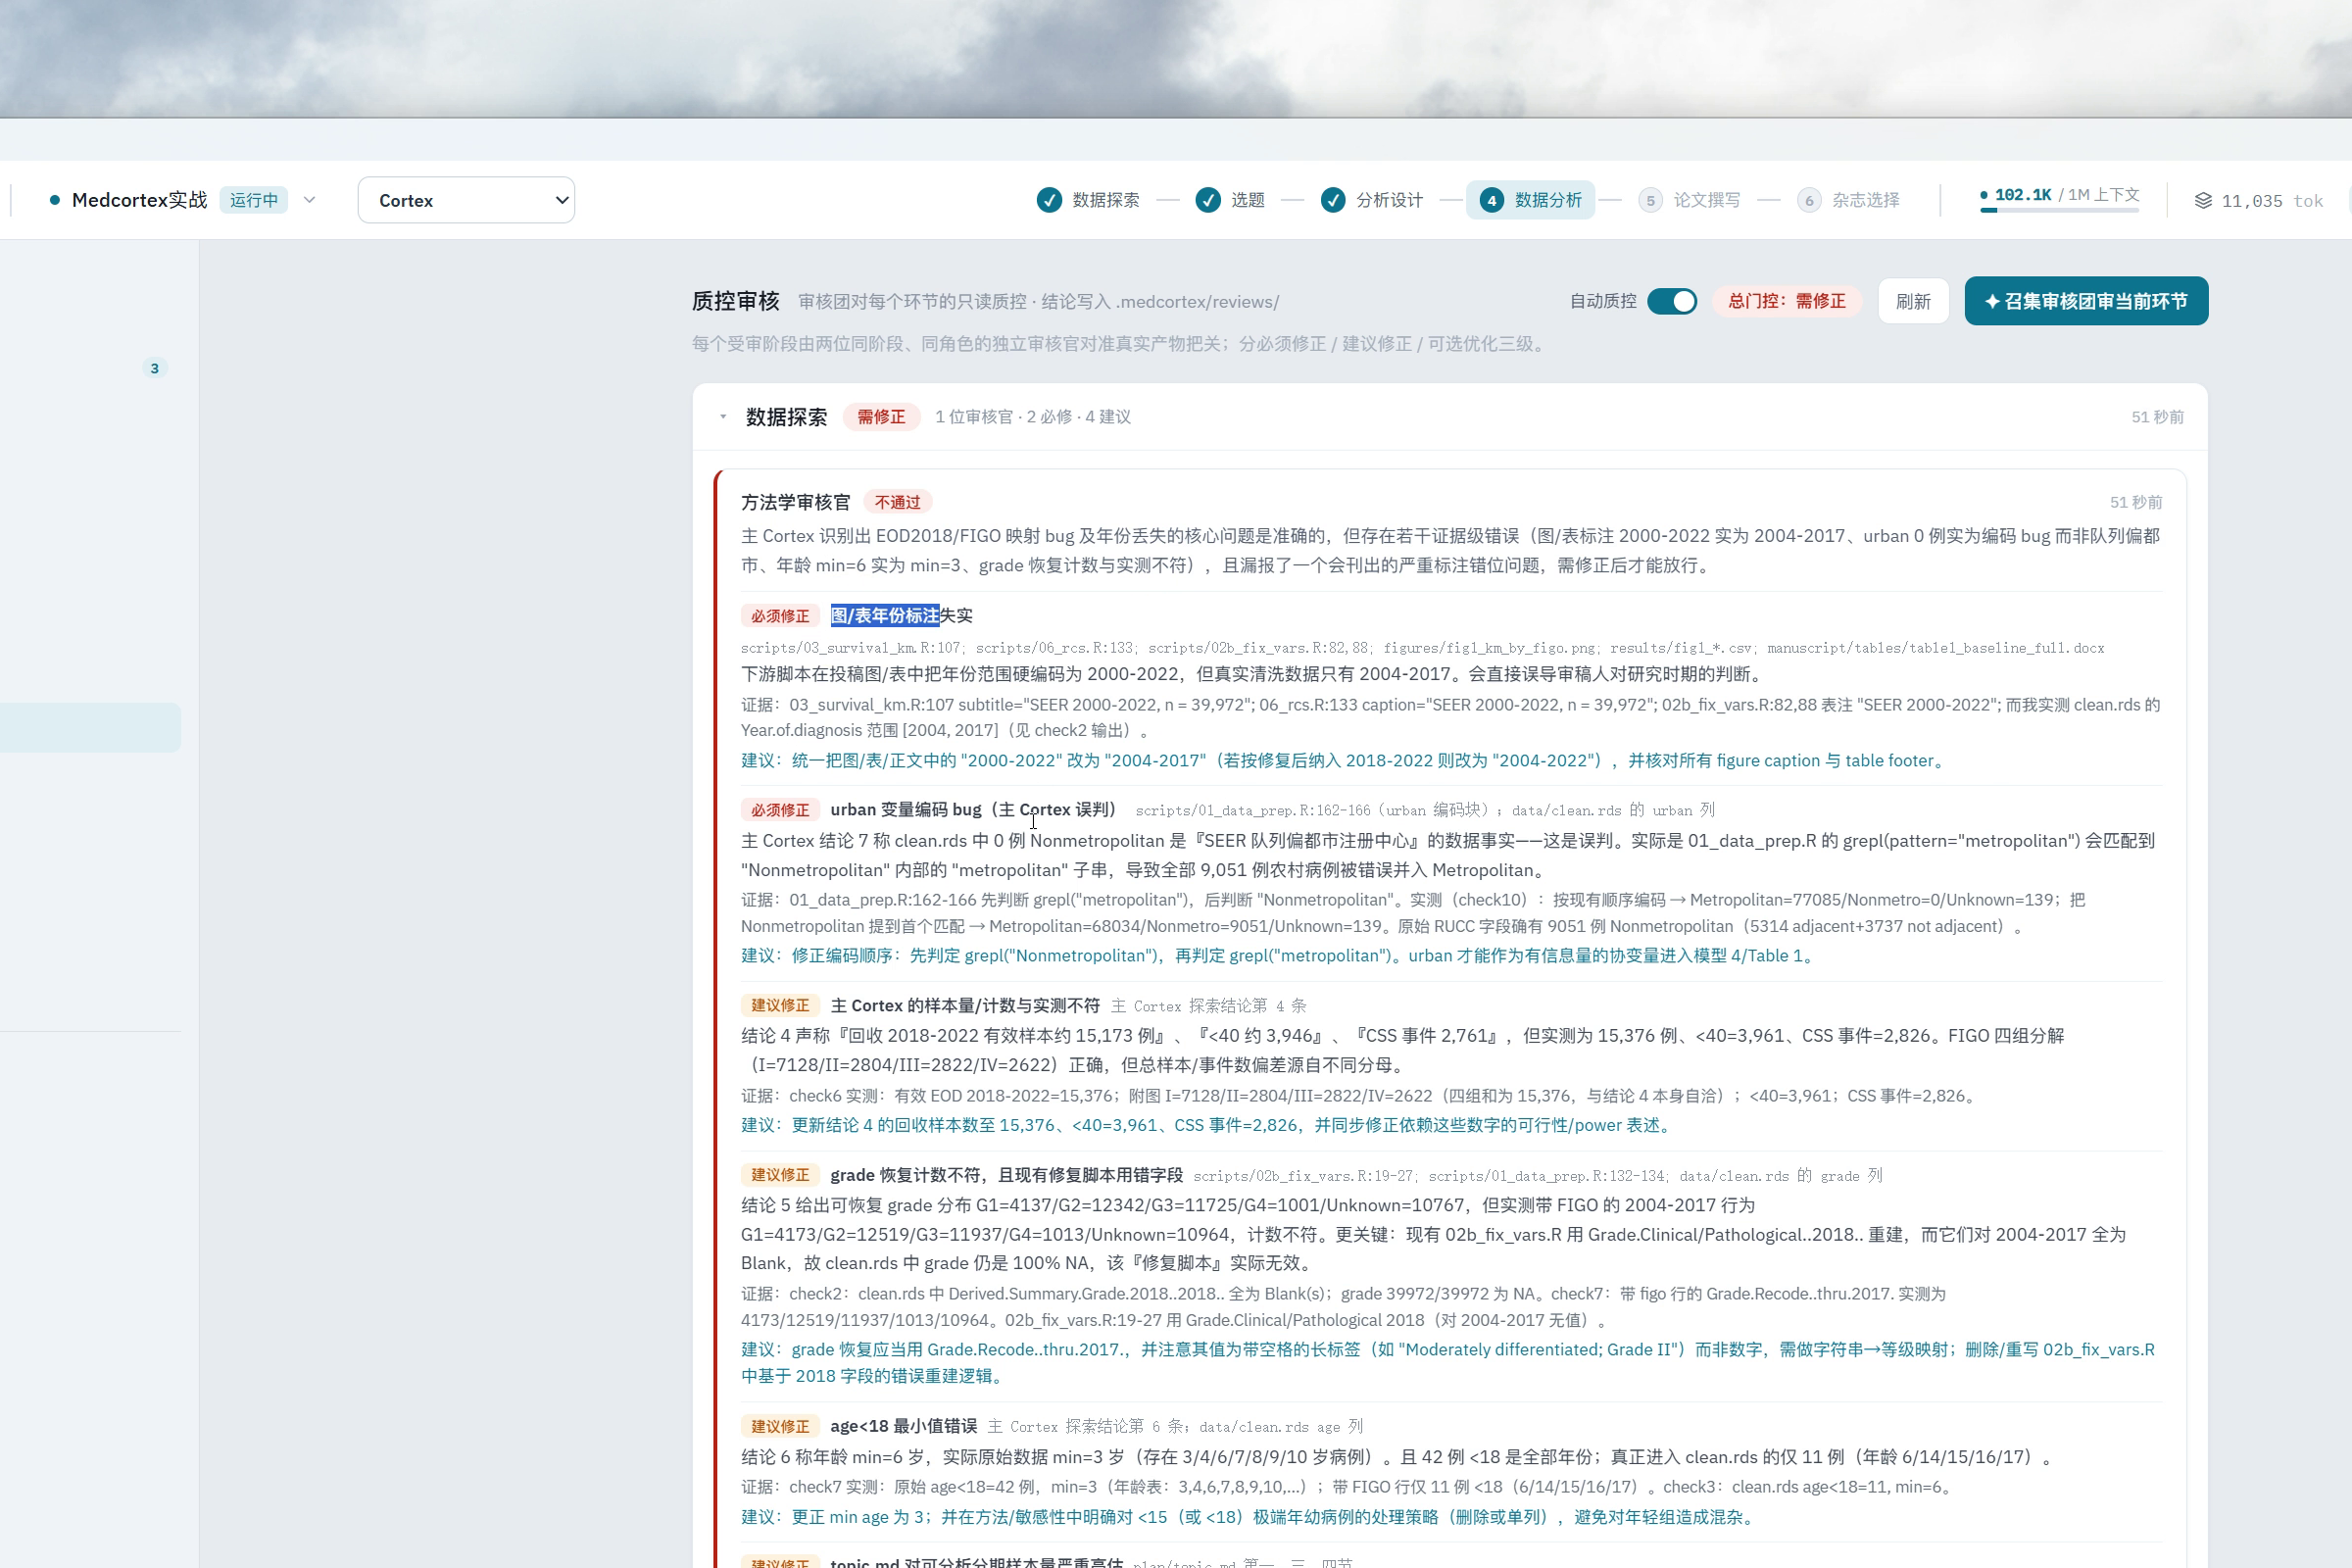
▲ 方法学审核官的"不通过"报告:1 位审核官给出 2 必修 + 4 建议
把这段报告的核心挑刺列一下(来自视频画面):
- 必须修正:图/表年份标注失实——脚本里硬编码了"SEER 2000-2022",但实际清洗数据是 2004-2017,会直接误导审稿人对研究时段的判断。
- 必须修正:urban 变量编码 bug——主 Cortex 误判 0 例"Nonmetropolitan"为队列偏倚,实际是 9,051 例农村病例被错并入 Metropolitan。
- 建议修正:主 Cortex 样本量/计数与实测不符——结论 4 声称"n=15,173",实测 15,376;CSS 事件 2,761 实测 2,826。
- 建议修正:grade 恢复计数不符——主 Cortex 给出 grade 分布 G1=4,137/G2=12,342,实际 G1=4,173/G2=12,519,02b_fix_vars.R 用了 Grade.Clinical/Pathological.2018 但对 2004-2017 行为 Blank。
- 建议修正:age<18 最小值错误——声称 min=6 岁,实测 min=3 岁(存在 3/4/6/7/8/9/10 岁病例)。
这些都是非常具体、有文件路径和行号定位的真问题。视频里能看到,谁能说"AI 自动跑的数据完全可信"?MedCortex 自己就把这类硬伤揪出来了。
⚠ 对做生物医学的人,这种"做事的人 + 挑刺的人"分离的设计,比单纯"AI 写一段结果"安全得多。
九、模型可以自己选,GPT/Claude/DeepSeek/Gemini 都能接
最后一个让我安心的点:MedCortex 不绑定任何一家模型。设置里能直接切换 MiniMax-M3、DeepSeek V4、智谱 GLM-5.3、Kimi K3、小米 MiMo v2.5、ChatGPT Plus/Pro、Ollama 本机、通用 Anthropic 接口等。
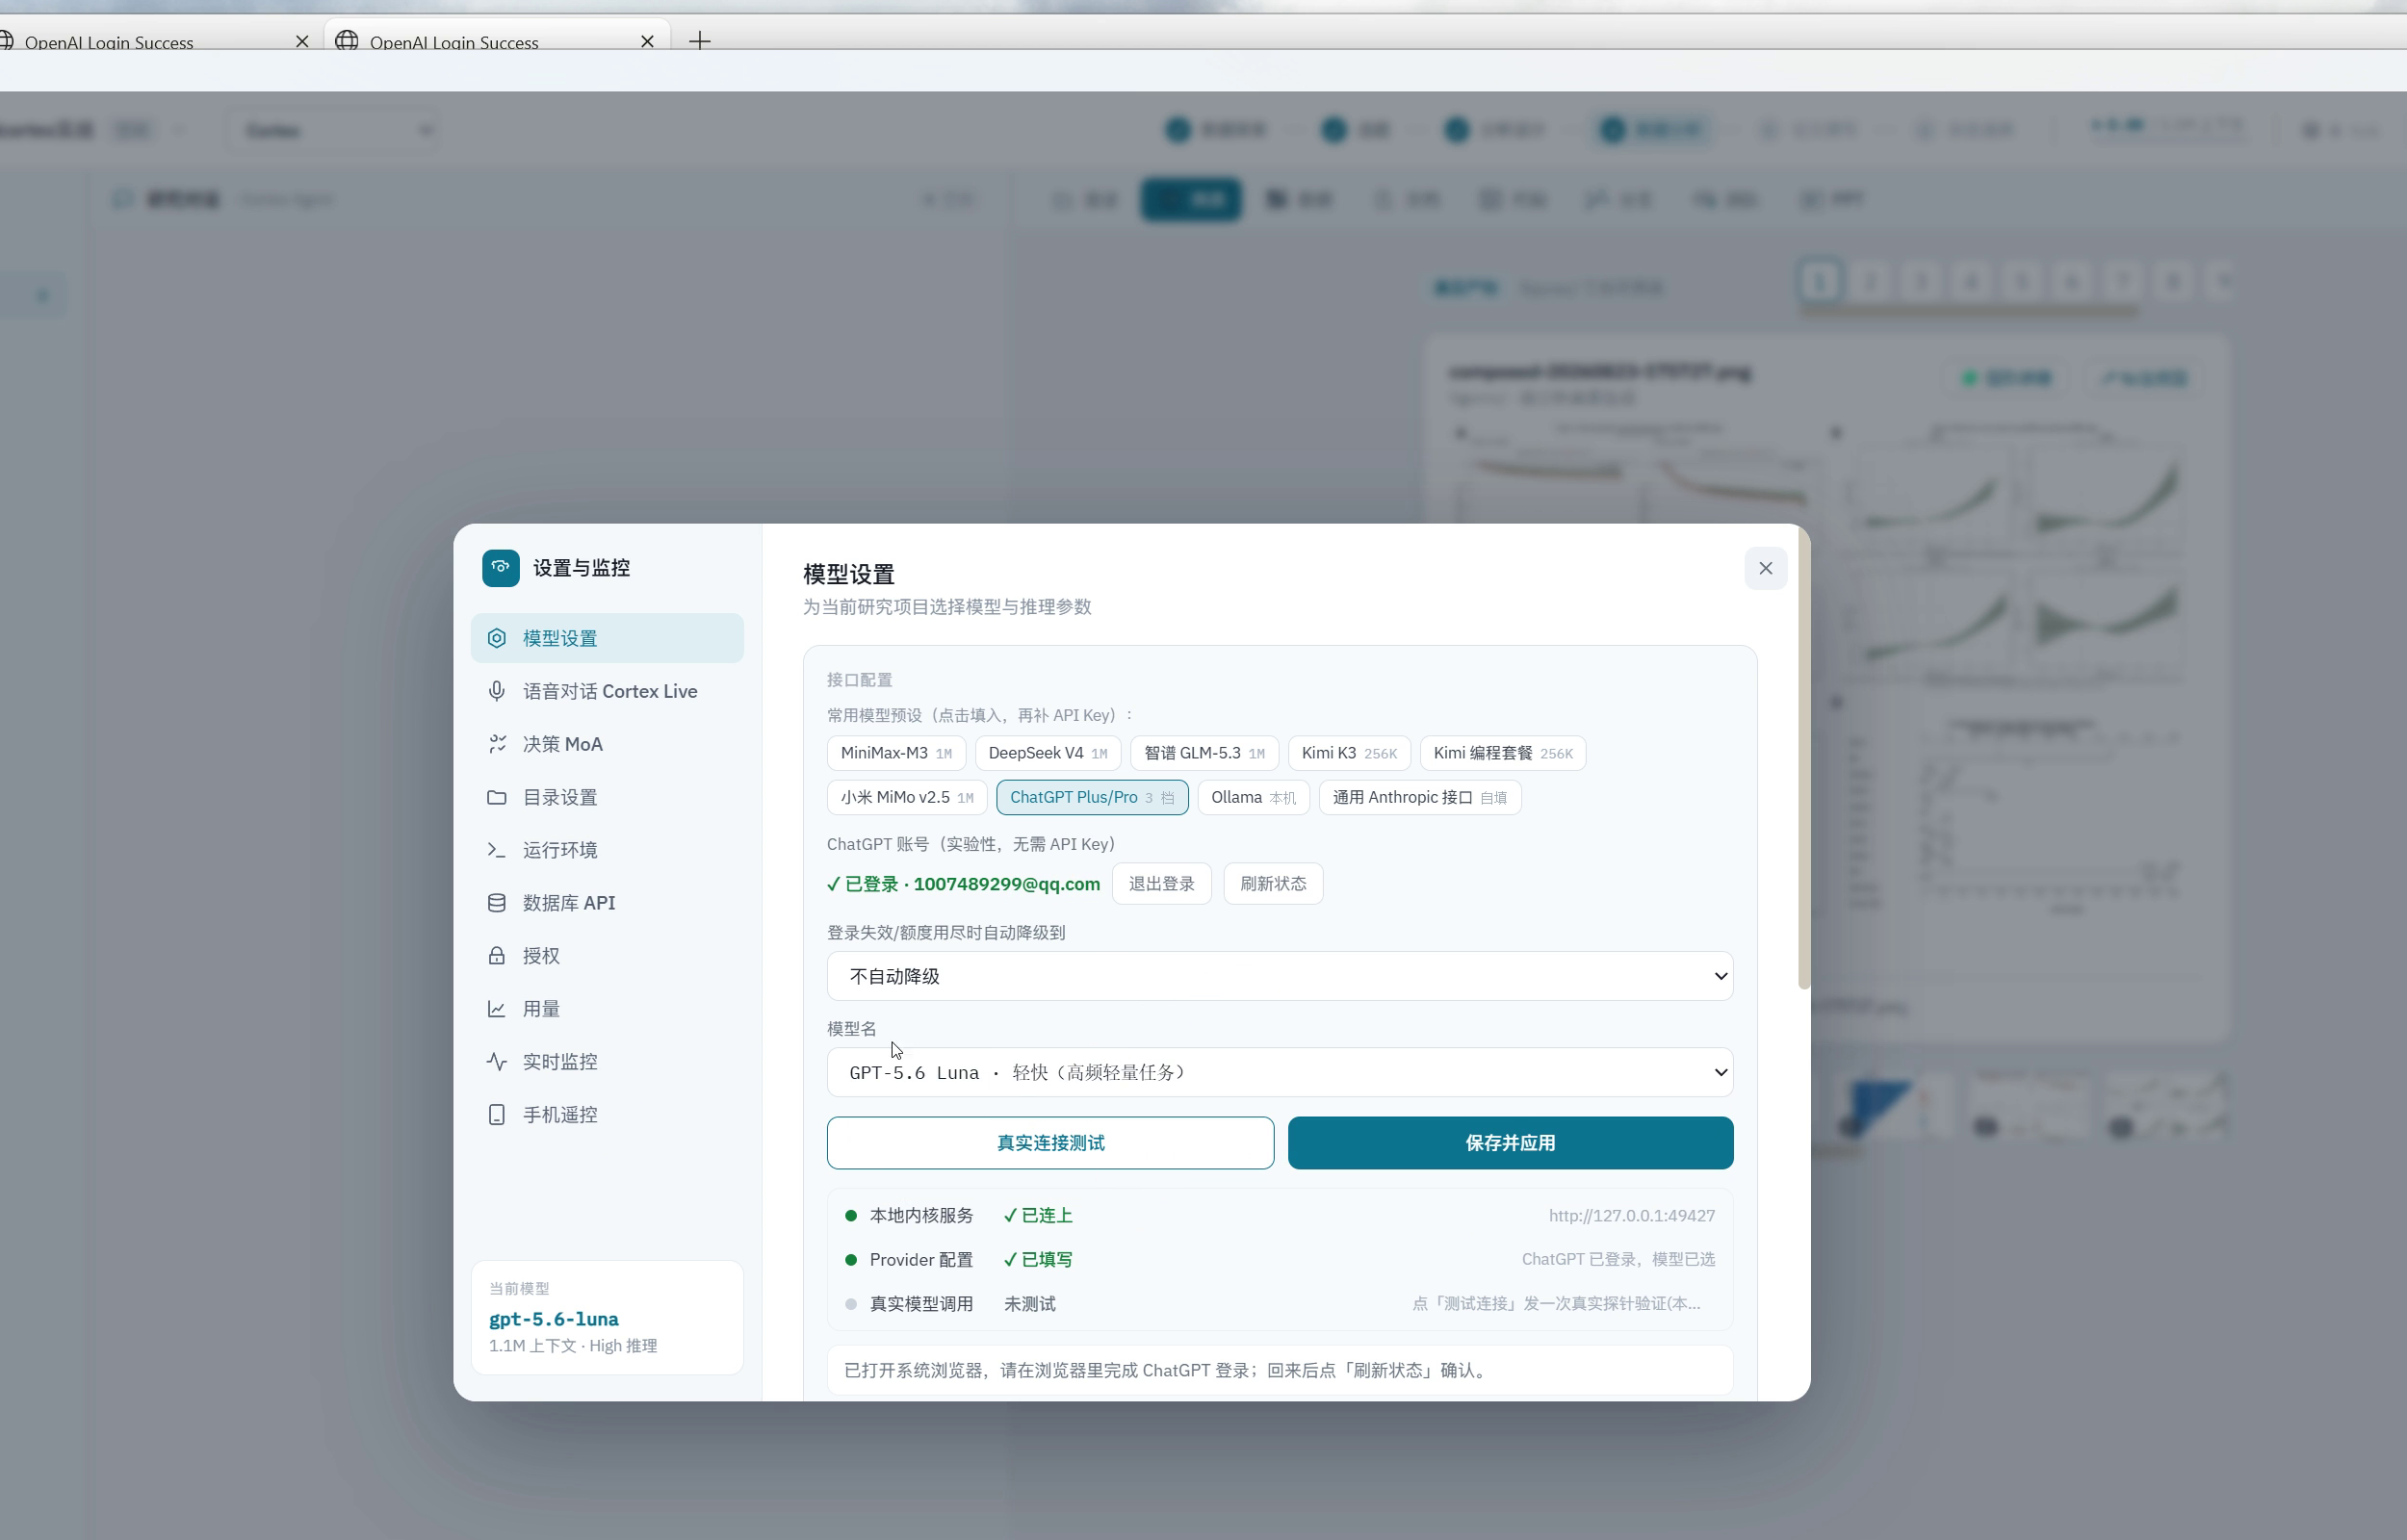
▲ 设置与监控 → 模型设置:常用模型预设点击填入,ChatGPT 账号 OAuth 登录,登录失效可自动降级
点击预设按钮填入,再补 API Key 就行。ChatGPT 账号是 OAuth 登录的(视频里能看到已经登录的状态),不需要单独申请 API Key。"登录失效/额度用尽时自动降级"选项意味着即便主力模型挂了,也能自动切到备用模型,不会让流水线断掉。
对在意数据隐私或单位有合规要求的人,还能选 Ollama 本机或 Anthropic 自填接口,把推理完全跑在自己机器上。
十、如果你也想试试,按这个顺序走一遍
16 段视频看完,我自己的体感是:
- 如果你是导师 / 课题负责人:重点看"多智能体协同 + 对抗性审核"——它能让你的学生少在数据清洗和参考文献上翻车。
- 如果你是临床医生或研究生:重点看"6 阶段流水线 + 多模型切换"——可以把"卡壳"环节外包给 AI,把精力放在真正需要判断的地方。
- 如果你是生信 / 统计方向:重点看"Skill 系统 + 分析工作流"——你自己的标准流程可以沉淀成可复用模块。
视频里演示的复现顺序大概是这样:
- 拖入 SEER 数据 → 让 Cortex 做字段分布
- 让 Architect 生成候选选题和评分卡
- 落 analysis_plan.md,明确变量、统计方法、Figure 1~4
- 跑 R:KM / Cox / RCS / 森林图 / 列线图
- 打开图床排版,3×2 拼接,发给 AI 重画统一风格
- Cortex 撰稿,PMID 真实引文自动回填
- 召集团审核报告,修必修项,再投稿
🚀 想自己跑一遍这个流程?
MedCortex 是一套 agent 智能体系统(视频里能看到它跑在 macOS 的多窗口里运行),下载方式、视频里没有展示;演示里没看到报价、试用或购买入口,具体开通流程请以官方渠道为准。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号