Cloudflare 9·15新政倒计时:用IP风险画像识别AI爬虫,防止误伤Googlebot
原创
Cloudflare 9·15新政倒计时:用IP风险画像识别AI爬虫,防止误伤Googlebot
原创
创意信号站_思绪棱镜
发布于 2026-09-04 10:54:09
发布于 2026-09-04 10:54:09
9月15日,Cloudflare会对一批站点默认启用新的AI爬虫拦截策略,范围是新增域名、新开的站点、从没动过爬虫设置的免费账号。默认动作:带广告的页面屏蔽 Training(训练)和Agent(代理)两类爬虫,Search(搜索)类放行。
听着是好事,但有个坑。Googlebot、Bingbot这类爬虫是"混合用途",既做搜索索引,又给AI喂数据。按Cloudflare的规则,只要你选了"屏蔽Training",这些混合爬虫会一起被挡,你的站就从Google搜索结果里消失了。
别一刀切,先用风险画像区分
你怎么知道请求你网站的是真Googlebot,还是顶着Googlebot名义的采集机器人?看IP风险画像。
真Googlebot的出口IP集中在谷歌的ASN段(AS15169),真人概率高、代理状态干净。冒充的采集机器人,IP大多来自IDC机房、代理节点或秒拨池,风险画像一查就能现形。
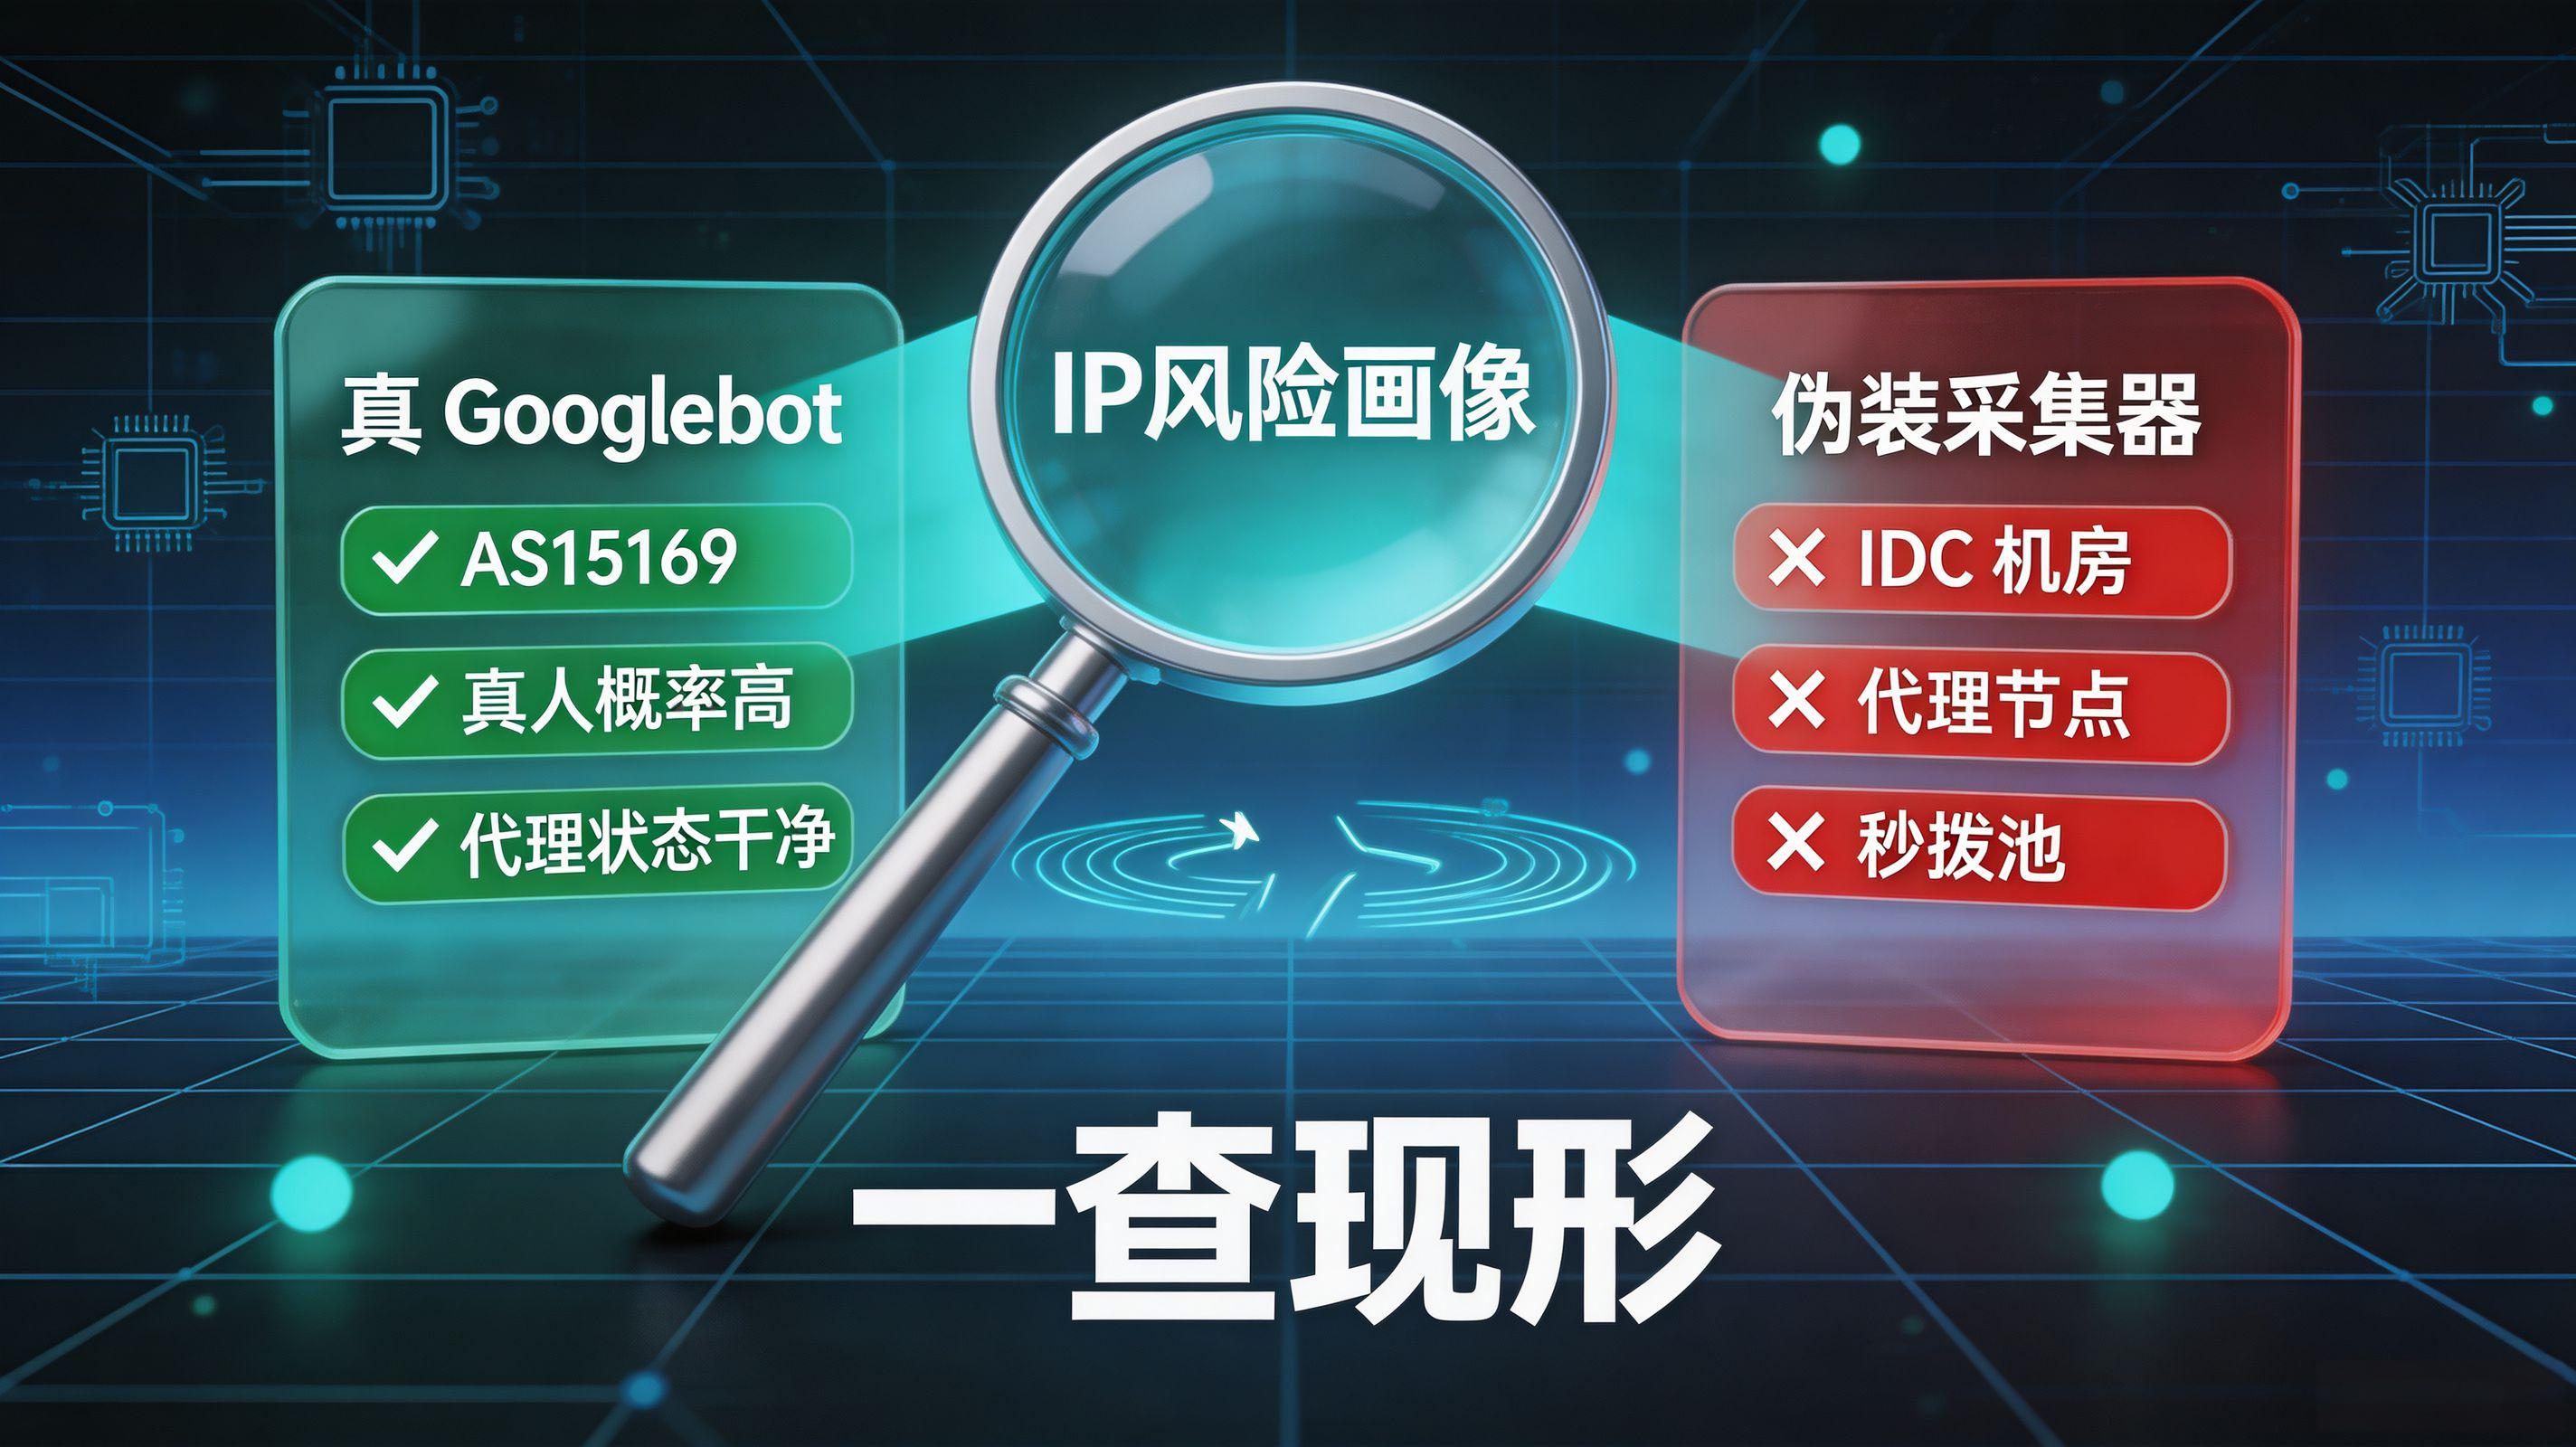
IP风险画像区分真Googlebot与伪装采集器对比图
代码落地
与其手动猜,不如在网关层做一层校验。以IP数据云的风险画像接口为例,对访问来源IP做识别:
python
import requests
def _to_int(v, default=0):
 try:
 return int(v)
 except (TypeError, ValueError):
 return default
def check_bot(ip, api_key):
 url = "https://api.ipdatacloud.com/v2/risk"
 params = {"ip": ip, "key": api_key}
 try:
 resp = requests.get(url, params=params, timeout=3)
 resp.raise_for_status()
 data = resp.json()
 except (requests.exceptions.RequestException, ValueError):
 return None
 if data.get("code") != 200:
 return None
 info = data.get("data", {})
 return {
 "ip": ip,
 "asn": info.get("asn"),
 # 兼容驼峰/下划线两种字段命名
 "is_proxy": info.get("isProxy", info.get("is_proxy")),
 "real": _to_int(info.get("real")),
 "risk_score": info.get("riskScore", info.get("risk_score")),
 }
def is_googlebot(r):
 # 兼容 "AS15169" / "15169" / 15169 三种写法
 asn = str(r.get("asn", "")).upper().replace("AS", "", 1)
 return asn == "15169" and r.get("real", 0) > 90
for ip in ["66.249.64.1", "203.0.113.10"]:
 r = check_bot(ip, "你的key")
 if r is None:
 print(f"{ip} -> 查询失败,跳过")
 elif is_googlebot(r):
 print(f"{ip} -> 放行真Googlebot: {r}")
 else:
 print(f"{ip} -> 需二次验证: {r}")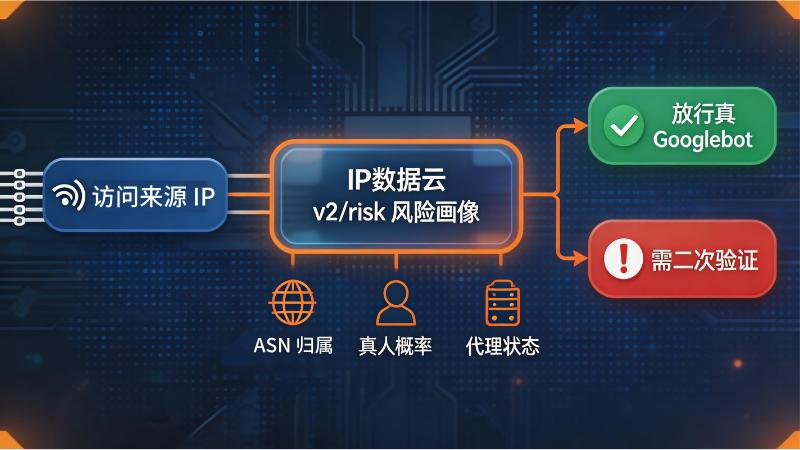
IP风险画像三信号识别AI爬虫决策链路示意图
把ASN归属、真人概率、代理状态三个信号拼起来,真爬虫和伪装的采集器就分开了。Search类爬虫放心放行,Training和Agent按你9月15日之后的策略处理,两不耽误。
最后
Cloudflare这轮默认策略,是把"拦不拦AI爬虫"的选择权交回给站长。可要选,得先认得清对方是谁。9月15日之前把风险画像的校验接到网关里,你的站不会被误伤出 Google,也不至于被AI爬虫白嫖。
数据来源
- Cloudflare官方博客《AI Crawl Control》与9月15日默认策略说明
- Cloudflare Radar 2026年6月互联网流量报告(非人类流量57.4%)
- Search Engine Roundtable关于Googlebot/Applebot爬虫IP识别报道
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号