反射内存卡数据帧格式与通信协议深度解析
原创

反射内存卡数据帧格式与通信协议深度解析
一、为什么值得深挖协议细节
很多工程师使用反射内存卡时,只停留在"打开设备、映射内存、直接读写"的层面,对数据在光纤上到底以什么格式传输并不关心。这本身没有错——反射内存的设计目标之一就是软件透明。但当你遇到性能瓶颈、需要精确计算延迟、排查间歇性丢包,或者要把反射内存接入一个更大规模的实时系统时,理解数据帧格式与协议细节就成为绕不开的功课。本文从硬件寄存器、帧结构、寻址方式、数据包长度等角度,对反射内存卡的通信协议做一次系统梳理。
二、板卡资源与寄存器体系
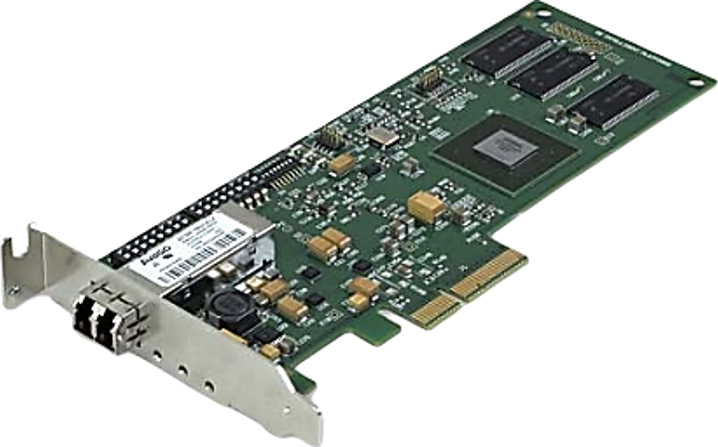
以经典的 5565 系列反射内存卡为例,板卡资源主要由三部分组成:本地配置寄存器、反射内存控制与状态寄存器,以及板载反射内存 RAM。
本地配置寄存器:负责 PCI/PCIe 接口层面的配置,其中与反射内存运行关系最密切的是中断控制与状态寄存器(INTCSR)和 DMA 控制寄存器。这些寄存器决定了板卡如何向主机报告状态、如何发起 DMA 传输。
反射内存控制与状态寄存器:实现 5565 系列反射内存板的独特功能,包括反射内存运行状态、PCI 中断源的精细控制、以及网络中断的访问控制。通过这套寄存器,上层驱动可以查询链路状态、使能/屏蔽中断、读取错误标志等。
板载反射内存 RAM:常见 64MB、128MB、256MB 等规格,带奇偶校验(部分型号支持 ECC)。这块内存对主机表现为普通物理内存映射,对 FPGA 则作为网络数据的中转仓库。值得注意的是,奇偶校验功能在上电时可能默认未启用,需要通过寄存器显式打开。
理解这三大资源,就理解了驱动与硬件交互的入口。上层所有操作——无论是内存读写、中断配置还是 DMA 设置——最终都要落到寄存器与内存映射上。
三、数据帧结构:极简但完整
反射内存卡在光纤上传输的数据包,刻意去掉了传统网络的 IP 头、MAC 头、端口号等"冗余",只保留实时性所必需的字段。一个典型的反射内存数据帧包含以下几个部分:
同步头:用于接收端识别帧起始位置,实现字节对齐与帧同步。这是硬件串行链路的标准做法。
地址字段:指示本次数据写入的目标内存地址(或相对于内存基址的偏移)。接收节点根据该字段,将后续数据写入自己板载 SDRAM 的对应地址——这正是"全网同一地址拥有相同数据"的硬件基础。
数据字段:携带实际要写入共享内存的数据。反射内存支持动态包长,每个数据包的有效数据为 1~64 字节。数据量小时用短包,避免浪费带宽;数据量大时用长包,提高传输效率。
校验字段:通常是 CRC 校验码,用于接收端检测传输错误。一旦校验失败,接收节点可通过寄存器上报错误状态。
(中断包)中断信息字段:当传输的是中断消息时,帧内还会携带发送者节点 ID、目标节点 ID、中断类型信息以及 32 位用户自定义数据。接收节点将这些信息存储到对应的 FIFO 中,并触发主机中断。
值得注意的是,反射内存帧的"极简"是有意的设计取舍——它不为复杂路由、流控、重传预留字段,而是把可靠性交给物理层质量、CRC 检测、冗余链路和 Bypass 机制去保障。这正是实时网络的本质:宁可快速失败并上报,也不愿为可靠性牺牲确定性。
四、寻址方式与节点 ID
反射内存网络能支持多达 256 个节点,其寻址机制建立在"全局共享地址空间"之上。
节点 ID(Node ID):每个节点通过跳线、拨码开关或软件分配一个唯一编号(0~255)。节点 ID 主要用于中断消息的定向(点到点)或广播(目标 ID 设为广播值,如 0xFF),也用于故障定位与诊断。
地址空间:所有节点映射同一段内存空间,同一物理地址在所有节点上含义相同。当一个节点向地址 X 写入数据时,FPGA 捕获"地址 X + 数据",打成帧广播,其他节点收到后写入本地同一地址 X。因此,保证所有节点的内存映射基址一致,是全网数据一致性的前提——这一点在应用配置中必须严格校验。
数据子区域:在应用层面,常把整块共享内存按功能划分为多个子区域。例如某飞机仿真试验系统将每个节点的共享区划分为命令字段段、试验配置段、通道配置段、数据段和预留段等,各系统只读写与自己相关的区域,实现结构化、有序的数据交互。
五、动态包长与 FIFO 缓冲
反射内存采用动态包长设计(1~64 字节),这一特性与收发 FIFO 配合,决定了数据传输的吞吐与延迟表现。
动态包长的意义:小数据(如单个控制字)用短包,减少填充开销;大数据(如整块参数)用长包,提高单帧效率。驱动通常会自动根据写入长度选择合适的包长,开发者无需手工干预。
发送/接收 FIFO:PCIe 总线速度与光纤速率不匹配,FIFO 起到缓冲作用。发送端 FIFO 缓存主机写入的数据,等待光纤空闲时发出;接收端 FIFO 缓存到达的数据,等待 FPGA 写入 SDRAM。当 FIFO 接近写满时,板卡通过流控机制让主机放慢写入,防止丢包。理解 FIFO 的存在,有助于解释一个现象:突发写入大量数据时,主机侧写入速度可能被板卡"回压",这是保护机制而非故障。
六、冗余模式与数据传输速率
反射内存支持冗余传输模式,即数据通过两条物理链路并行发送,接收端比较并选择正确的一份。这一设计显著提升了抗瞬时错误能力,代价是带宽减半。
具体到 5565 系列:非冗余模式下,单长字访问约 43MB/s,64 字节突发可达 170MB/s;冗余模式下,相应降至约 20MB/s 与 87MB/s。此外,光纤速率(如 2.125Gbps 或 2.5Gbps)是物理层上限,实际有效带宽还受 8b/10b 编码和帧头开销影响,工程上常以实测值为准。
七、通信协议的分层思考
从整体看,反射内存的"协议栈"与传统网络完全不同:
• 物理层:光纤 + 光模块 + SERDES,负责电光转换与串行收发。
• 链路层:帧同步、CRC 校验、FIFO 缓冲、流控。
• 传输语义:内存地址寻址 + 广播复制,天然实现"一写多读"。
• 应用层:内存映射读写 + 中断通知 + DMA。
每一层都由硬件实现,CPU 只在应用层通过内存读写参与。这种"硬件协议栈"正是反射内存能实现微秒级确定性延迟的根本原因——没有操作系统调度、没有软件封装、没有排队等待。
八、对开发者的实践建议
基于对协议的理解,给开发者几点可落地的建议:
第一,明确包长与带宽的关系。若大量传输 1~4 字节的小数据,有效带宽会显著低于突发模式标称值,此时应尽量合并小数据为批量写入,或评估是否需要提高单帧长度。
第二,用好寄存器诊断信息。遇到链路异常时,优先读取反射内存状态寄存器,查看是否上报了 CRC 错误、链路断开、FIFO 溢出等标志,这比盲目换线更高效。
第三,保持映射一致性。全网节点的内存映射基址必须一致,否则同一地址在不同节点上含义不同,"共享内存"前提即被破坏。
第四,理解流控回压。大量突发写入时主机可能被减速,这是正常保护行为,不应视为故障;若频繁触发,应检查写入节奏与 FIFO 深度的匹配。
九、结语
反射内存的通信协议,本质上是"为确定性而生的极简硬件协议"。它把传统网络七层协议栈压缩为"地址 + 数据 + 校验"的硬件流水线,以放弃复杂路由与重传为代价,换来了微秒级、可预测的实时通信。理解数据帧结构、寄存器体系、寻址方式与动态包长机制,不仅有助于把反射内存用得更好,更能在排查疑难问题、优化系统性能时做到有的放矢。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号