2026 年企业 AI 最大的误判:把钱花在更强的模型上,塌在没人验货上

2026 年企业 AI 最大的误判:把钱花在更强的模型上,塌在没人验货上
Mixlab Lz
发布于 2026-09-09 21:51:14
发布于 2026-09-09 21:51:14
过去 18 个月,所有人都在抢更强的模型——更大的参数、更长的上下文、更低的推理单价。
这件事基本成了。AI 一小时能给你写 1000 段代码、1000 份合同、1000 张报表,生成端的成本被打到地板上。
但 AI 进公司真正的瓶颈,已经从"做不做得出来"挪到了"信不信得过"。 没建"验货关"就上 AI 的公司,生成得越快,塌得越惨。
上海某 SaaS 创业公司周一晨会上发生的事
朋友上周讲了一个场景,画面感极强。
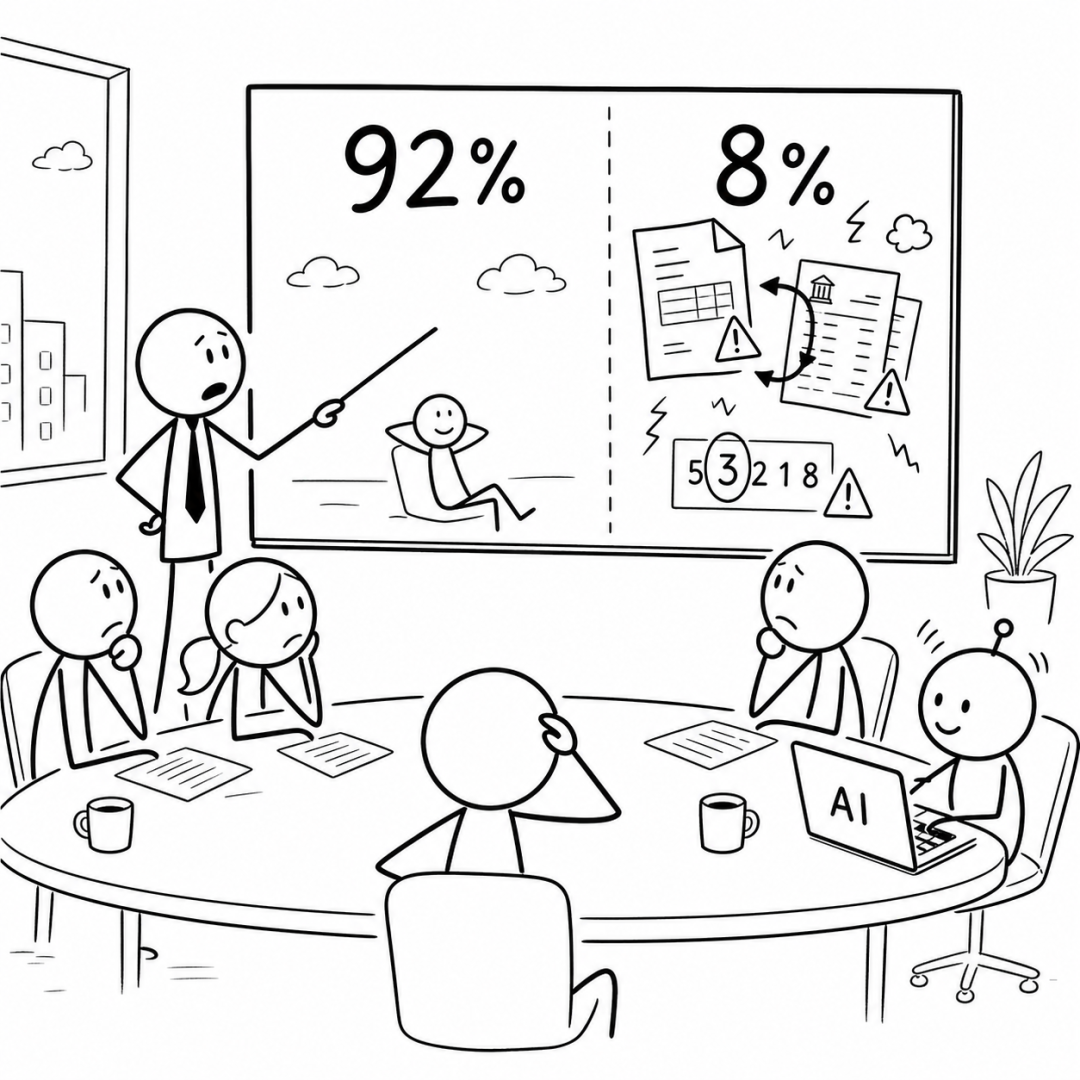
他是一家做企业财税 SaaS 的联合创始人,团队花了 3 个月把"AI 自动跑账"接进了客户的财务系统,模型用的是当时最热的国产大模型,准确率 92%。92% 听起来漂亮,但剩下那 8% 在企业财税场景里就是会爆雷的那 8%。
周一晨会,财务合伙人甩出一组客户数据:7 个客户里有 1 个反馈"AI 把应税科目算错了,少缴了 1.2 万"——客户来追责;3 个客户的银行流水里有重复入账,AI 没识别出来,月底对账时间从 3 天涨到 7 天;1 个客户因为 AI 把发票号 OCR 错了一位,整个报销流程卡了一周。
他对着 PPT 苦笑:"我们花了 3 个月提升 0.5% 的准确率,客户根本不在乎。客户问的是:'错了你赔不赔、能不能查到、谁来改。'"
翻译成工程语言:客户问的不是 AI 能不能生成,是 AI 能不能被验证——能不能告诉我它为什么给出这个数、用了哪些数据、有没有人复核、错了能不能追溯到人。
这个场景本身,就是"AI 落地的瓶颈从生成挪到验证"的活证据。这家公司的 92% 不是技术问题,是没有验货机制的技术问题。

过去两年,企业 AI 的注意力全在生成上,没人管验证
回到 2024 年初,大模型刚火的时候,整个行业只问一个问题:"AI 能不能做出来?" OpenAI o1、Claude 3.5 Sonnet、Gemini 2.0 排队发布,所有企业的 AI 预算都被吸到"接最强的模型"这一条线上。
到了 2025 年,问题变成"AI 能不能做得准"——准确率从 70% 拉到 85%,再拉到 92%。每提升 1 个百分点,要烧掉几百万条人工标注数据。这条曲线到 2025 年底开始变平——再往上拉,需要 10 倍的数据、10 倍的钱,只换来 1% 的提升。
到了 2026 年,真正卡住企业 AI 的不是模型不够强,是没人能告诉 CFO:这一笔账是 AI 算的,依据是什么、用了哪些原始凭证、有没有人复核。
DEV.to 2026 年 7 月 13 日一篇《"Post-Documentation" is a Myth》把这件事说得很狠:如果你把内容生成完全交给一个没人管的 AI,会陷入"用一堆糊弄的东西,去描述另一堆糊弄的东西"(slop describing slop)的死循环。它转得飞快,产出海量,但全是噪音,不是清晰。
翻译成企业语言:生成没有边界,验证没有机制,AI 越能干,企业越失控。

对比画面:海外 DoorDash、Anthropic、OpenAI 2025 年下半年就开始把"AI 评审团""可追溯推理"做成产品;国内 2026 年上半年大多数企业还在比模型版本号。
不是验证不重要,是之前 AI 还不够会生成,大家顾不上。现在 AI 已经够会了,验证就从配角升到了主角。
95% 企业的 AI 预算花错了地方
把视线拉回国内。
反共识判断:2026 年企业 AI 的预算,95% 都花错了地方。
错在所有人都在抢"更强的模型",没人抢"更可信的验证"。一个国产模型厂商的朋友讲过:他的客户 2025 年 60% 的 AI 预算花在"升级模型版本"上(GPT-4 → GPT-5),剩下 40% 才是"接入系统 + 数据准备 + 培训"。"验证"这个环节,连 5% 都不到。
结果是——模型越升越强,客户投诉越来越多。客户投诉的不是"AI 答得不准",是"AI 答错了没人告诉我、错了改不掉、改了查不到原因"。
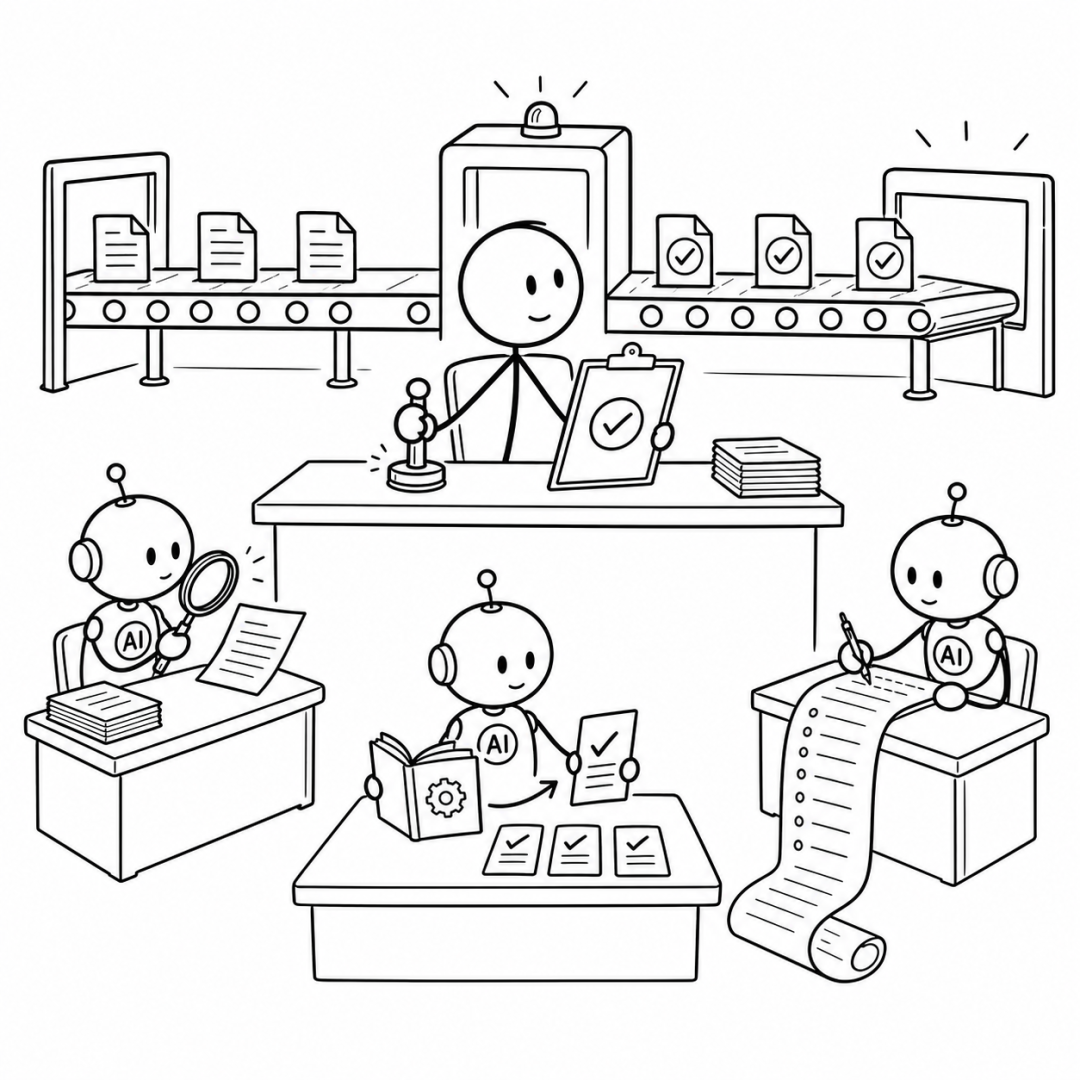
打个比方。以前工厂的瓶颈是产能,因为造得慢。现在 AI 把"造"的成本打到地板上,瓶颈挪到了质检口——货堆成山,但没人替你验货,这山货就是废的。
反共识金句:AI 越会生成,验证越值钱。下一笔 AI 预算,不该花在模型上,该花在验货关上。
2026 年开始,4 件事在同时把"验证"推上 C 位
如果你还在犹豫要不要建验货关,2026 年的 4 个时间窗口会把犹豫替你解决。
第一,监管在收紧。 欧盟 DAC8 2026 年 1 月 1 日全面生效,要求所有数字资产交易可追溯、可审计;美国 1099-DA 表格 2026 年起要求加密交易经纪商报送客户身份和交易明细;加拿大 CARF 框架同步推行。凡是 AI 替你做的财务决策,必须留痕、可查、有人能拍板。
第二,企业级 AI Agent 已经在跑真金白银。 36 氪 2026 年 7 月 14 日报道 FinTax × Stair AI:某个机器支付网络里 AI Agent 一年完成 1.65 亿笔交易,活跃 Agent 近 7 万个。Gartner 预测 2028 年 33% 企业软件整合 AI Agent,15% 日常决策由 AI 自主完成。15% 不是试点,是真业务。
第三,AI 编程语言已经把"人来把关"写进了地基。 Hacker News Show HN 2026 年 7 月推荐了 Jacquard 编程语言,设计目标写在脸上——专为"AI 写代码、人审查代码"而生。连编程语言这一层都开始默认"生成归 AI、验证归人"。
第四,海外巨头已经在用 AI 评审团做大规模生产。 DoorDash 2026 年用 LLM Juries(AI 评审团)升级几百万条食品元数据——多模型组成"陪审团"互相投票打分,准确率提升 20%、调优速度快 10 倍、推理成本降 90%。注意,让这套跑起来的核心不是"更强的模型",是"更好的评审机制"——验货关本身在创造价值。

4 件事叠在一起,2026 下半年到 2027 上半年,是企业 AI 从"生成优先"切到"验证优先"的窗口期。
金句:不是 AI 不够聪明,是 AI 太能干了,老板兜不住。
建验货关的 4 条硬标准,缺一条就别启动
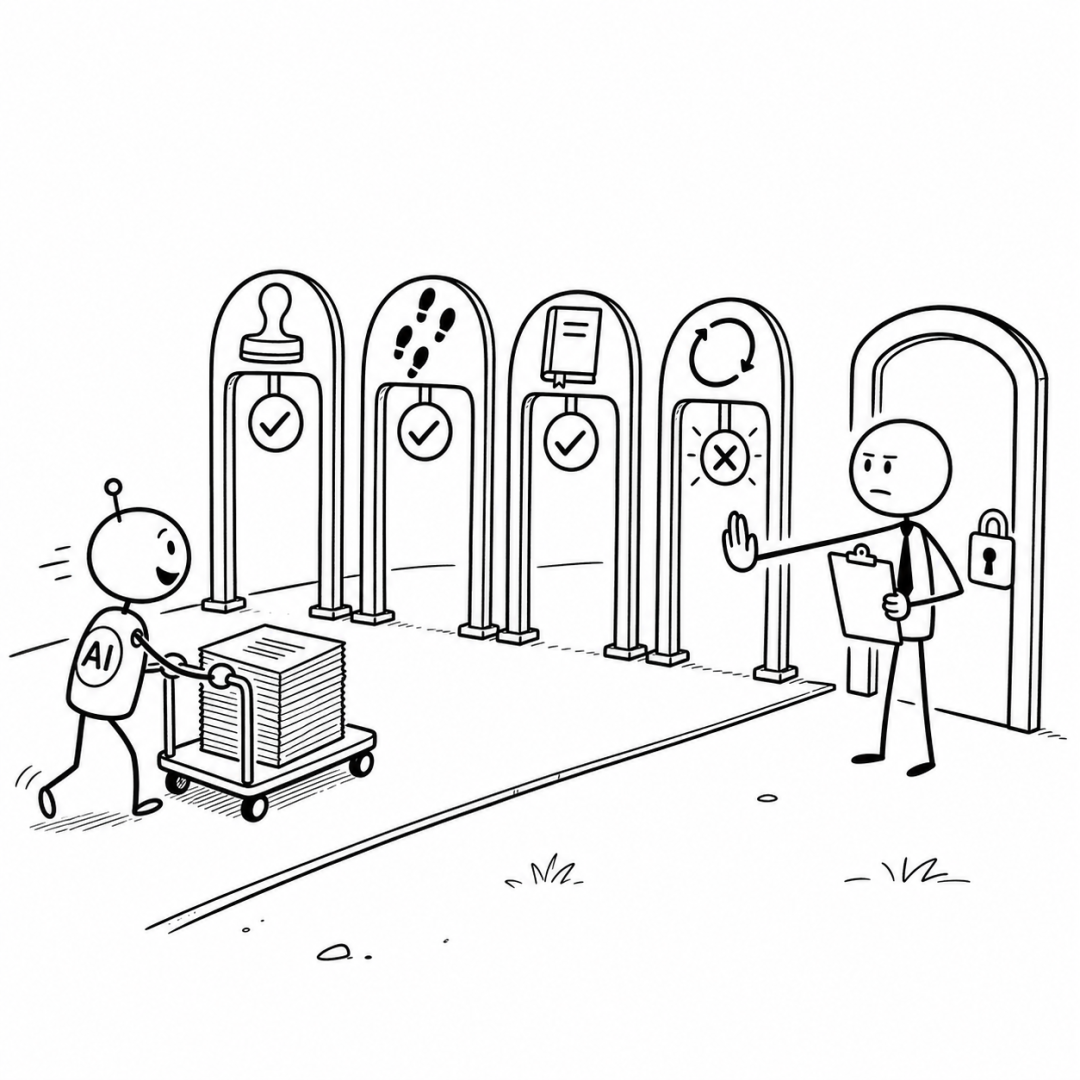
把上面 4 件事叠起来,给企业建验货关一套可操作的硬标准——4 条同时满足,缺一条都不算建好:
第 1 条:每一个 AI 输出都必须经过一道独立的"验货关"。 可以是人工抽检(适合核心流程,月抽 10%-30%),也可以像 DoorDash 那样用多个 AI 模型组成"评审团"互相打分(适合大批量、低风险场景)。没有一个 AI 输出可以不经检查直接进业务——这是底线。
第 2 条:核心流程必须"可追溯",不留痕不让上。 凡是 AI 出现在财务、合同、对外承诺、监管报送这类"错一位就出事"的地方,光看结果对不够,要看它基于什么数据、谁授权、能不能复查、错了归谁。FinTax 那本"执行账本"(Reasoning Ledger)就是把这件事做进系统——AI 每一步怎么推理、用了什么数据、谁授权、谁复核,全部记下来可查。留痕不是麻烦,是让 AI 能进核心流程的通行证。
第 3 条:把公司自己的判断标准,喂给 AI。 通用大模型不懂你的行业规矩。你过去几十年"什么叫做对了"的经验——客户分级标准、合同条款红线、行业合规边界——这些是让 AI 少出错的护城河,对手抄不走。AI 验货关的本质是"把公司的私货变成 AI 的常识"。
第 4 条:建一个"验货关失败的兜底机制"。 AI 会持续进化、监管会持续收紧、业务会持续变化——你的验货关要能跟着迭代,每季度复盘一次"这季度 AI 出过几次错、哪类错最多、下一季度怎么调"。
把 4 条去对照国内已经在做 AI 的企业,画面非常清晰:
- 只接模型,没建验货关的企业(占大头,约 70%):第 1 条做不到,第 2 条做不到,第 3 条勉强。结论:不算上了 AI,是"用 AI 的胆子"
- 接模型 + 简单人工抽检(约占 20%):第 1 条做到(人工抽检 5%-10%),第 2 条部分做到,第 3 条做到。结论:过了及格线,但不是高质量验货
- 接模型 + AI 评审团 + 全链留痕 + 行业规则沉淀(约占 10%):4 条全做到。结论:是真正把"验证"做成基础设施的企业——国内这一类还很少,但 2026 年下半年会快速增加
对比海外,DoorDash / Anthropic / OpenAI 这一档几乎全在第三类;国内第三类企业占比不到海外的三分之一。Mixlab Launchpad 自己在做的事属于第三类——帮企业把第 1-4 条一次性搭起来,而不是只卖模型、卖完就走。

这 4 条是"必要条件",不是"充分条件"。每条都做得敷衍,照样会塌。难点不是"有没有",是"做得多细、跟得多紧"。
99% 的企业撑不过"反人性 12 个月"
为什么验货关这件事,明明所有人都知道重要,95% 的企业还是建不起来?
不是技术问题,是组织问题。 验货关这件事的设计本身就是反人性的。
反人性 1:让最慢的环节卡住最快的环节。 AI 生成可以快到秒级,但人工抽检、规则沉淀、留痕追溯——每一步都是慢活。老板算账的时候,"秒级生成"的回报是显性的(节省多少时间),"慢活验货"的回报是隐性的(避免多少爆雷)。 大部分老板会选显性回报。
反人性 2:让"做事的人"反过来管"做事的人"。 验货关本质上是在 AI 和业务之间加一道"门",这道门会拖慢流程、增加成本。业务部门天然讨厌这道门,因为它是阻力。 能撑过这道阻力的企业,靠的是老板的意志——老板愿意为"不出事"付"慢一点"的代价。
反人性 3:让 AI 的判断标准跟公司的判断标准打架。 通用大模型训练的是"平均人类的常识",公司要的常常是"这个行业的特殊规矩"。当 AI 答得"对"但答得"不合规矩",企业必须有能力让 AI 听公司的。这件事需要持续投入"规则喂养"——长期、隐性、看不出 ROI。99% 的企业撑不过 12 个月。
把这 3 条放在一起:显性 vs 隐性、阻力 vs 安全感、AI 标准 vs 公司标准——任何一个撑 12 个月都需要极强的组织能力。
大金句:99% 的企业撑不过反人性 12 个月。能撑过去的,是一开始就把"验证"当成 AI 落地的第一道工程。
国内建验货关的 3 个亚种
既然严格意义的验货关在国内跑起来这么难,国内实际跑出来的是 3 个变种。
亚种 1:"模型优先 + 轻验证"型(最普遍,约占 70%)
- 代表:大量正在"上 AI"的中小企业
- 形态:先接最强模型,跑起来再说;验证靠"用一段时间发现问题再补"
- 优势:启动快、能看到 AI 效果
- 劣势:客户投诉一上来就崩,回头补课的成本是启动的 5-10 倍
亚种 2:"流程优先 + 重验证"型(约占 20%)
- 代表:金融、医疗、政务等强监管行业的 AI 项目
- 形态:先把业务规则、留痕机制、人工抽检比例设计好,再让 AI 上场
- 优势:监管安全、能进核心流程
- 劣势:启动慢、决策周期长(6-12 个月)
亚种 3:"行业规则 + AI 评审"复合型(约占 10%)
- 代表:把"行业 know-how + AI 评审 + 全链留痕"做成一体的服务商
- 形态:卖的不是单一模型,是"模型 + 验货关 + 行业规则"组合交付
- 优势:客户不用自己花 12 个月建体系,直接用现成的
- 劣势:服务占比高;但客单价高(80-300 万)、决策周期短(2-3 个月)
Mixlab Launchpad 自己属于亚种 3。我们帮金融、医疗、制造业客户做 AI 落地这几年,看到的事实是:亚种 1 跑得快但塌得快,亚种 2 跑得稳但跑得慢,亚种 3 跑得快也跑得稳——前提是亚种 3 自己先把验货关吃透。 三个亚种都有饭吃,但吃的是不同档次的市场。
AI 时代,验货关本身也要被 AI 化
最后聊一个问题:验货关会不会被 AI 自己替代?
短期 1-2 年:不会。 验货关里最关键的一步是"基于什么数据、谁授权、能不能复查"——这件事的核心是责任归属,而责任归属是法律和组织层面的事,AI 替代不了。AI 可以帮人审得快一点,但 AI 不能替人承担责任。
中期 3-5 年:部分会。 DoorDash 的 LLM Juries 已经验证了一件事:AI 评审团可以在大批量、低风险场景里替代 70%-90% 的人工抽检。未来 3-5 年,企业 AI 验货关的 50% 工作会被 AI 工具替代——但剩下那 50% 是"责任归属 + 行业规则 + 监管合规",AI 替代不了。
长期 5 年以上:重新定义验货关。 真正的变化不是"验货关消失",是"验货关升级为 AI-native 验货关"——1 个真人验货负责人 + 3 个 AI 验货助理(AI 抽检助理、AI 规则喂养助理、AI 留痕审计助理)= 现在 1 个完整验货团队的 5 倍产能。
配置图:未来 5 年的企业验货关 = 1 真人 + 3 AI 助理
- 真人:验货负责人(对结果负全责)
- AI 助理 1:AI 抽检助理(每天自动抽检 1000 条 AI 输出,标记疑似错误)
- AI 助理 2:AI 规则喂养助理(把公司新出的业务规则自动翻译成 AI 验货标准)
- AI 助理 3:AI 留痕审计助理(自动记录每一条 AI 决策的依据 + 授权人 + 复核人)

金句:未来 5 年最稀缺的,不是会写 AI 的人,是会建验货关的人。
最后
总结一下这轮聊的 3 个核心论点。
第一,AI 落地的瓶颈已经从"生成"挪到了"验证"。 过去两年所有人抢模型,但 2026 年的现实是:模型已经够强,强到没人能兜得住。没有验货关,AI 越能干,企业越失控。
第二,95% 企业的 AI 预算花错了地方。 真正的瓶颈不在模型,在验货关。2026 下半年到 2027 上半年是窗口期——监管收紧 + Agent 落地 + 编程语言重构 + 海外巨头验证,4 件事在同时把"验证"推上 C 位。
第三,建验货关是反人性的组织能力,不是技术活。 国内真正能把验货关建起来的企业不到 10%——多数要么跑得太快(亚种 1)、要么跑得太慢(亚种 2)、要么靠外部服务商(亚种 3)。
最后送你一个观察:
验货关不是一道工序,是企业 AI 落地的组织能力。 能持续把验货关建好、迭代好、用得好的企业 = 能持续在 AI 时代不出大事的企业。这背后拼的不是哪个明星模型,是公司能不能撑过"反人性 12 个月"的整套组织配套。
想都是问题,做才有答案。
参考来源:
- DoorDash Careers Blog — LLM Juries 评审团升级百万级食品元数据,准确率提升 20%、调优速度快 10 倍、推理成本降 90%
- Hacker News Show HN — Jacquard:为"AI 写代码、人审查代码"而生的编程语言
- 36 氪 / FinTax × Stair AI(2026-07-14)— 机器支付网络 AI Agent 一年完成 1.65 亿笔交易,活跃 Agent 近 7 万个
- DEV.to(2026-07-13)— "Post-Documentation" is a Myth:警惕 slop describing slop 的死循环
- Gartner 2026 — 预测 2028 年 33% 企业软件整合 AI Agent、15% 日常决策由 AI 自主完成
- 欧盟 DAC8(2026-01-01 全面生效)— 数字资产交易可追溯、可审计强制要求
- 美国 1099-DA(2026 起执行)— 加密交易经纪商报送客户身份和交易明细
- 加拿大 CARF(2026 同步推行)— Crypto-Asset Reporting Framework 加密资产报告框架
- Reasoning Ledger(FinTax 设计理念)— AI 每步推理/数据/授权/复核全记录可审计
- a16z — 企业 AI 落地"反 SaaS"架构分析
- IBM 2026-06 — AI 治理缺口拉大研究
- Codenotary 2026-06 — 单日 300 万 AI Agent 交互监控规模
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号