一个字段,一份副本:Elasticsearch 列式存储如何舍弃倒排索引
原创
一个字段,一份副本:Elasticsearch 列式存储如何舍弃倒排索引
原创
点火三周
发布于 2026-09-10 16:15:06
发布于 2026-09-10 16:15:06
作为 9.5.0 版本的一部分,Elasticsearch 以技术预览形式引入了列式索引模式与 logsdb_columnar 索引模式。Elasticsearch 自 1.0.0 版本起就通过 Lucene 的 doc values 提供了列式存储。Lucene 的 doc values 支撑着分析和搜索功能,例如按字段分组和排序。那么,列式索引模式带来了哪些变化呢?
变化主要体现在存储和性能,以及开箱即用(OOTB)体验上。在 9.5.0 版本之前,Elasticsearch 默认以基于文档的搜索引擎运行。虽然可以配置为在存储层面表现得像列式系统,但这并非默认体验。列式索引模式带来了若干根本性变化,使 Elasticsearch 能够优化列式分析和搜索场景:
- 字段仅作为 doc values 存储一次,默认不再建立索引。
- 新的多值语义。默认保留每个文档每个字段多个值(例如数组)的原始顺序。
- 映射始终是扁平化的,映射中的对象和透传字段(passthrough fields)会自动扁平化。
列式索引模式如何融入 Elasticsearch
列式索引模式的许多变化源于时间序列数据流(TSDS)。作为将 TSDB 打造成具有竞争力的指标解决方案的一部分,我们改进了磁盘上的 doc values 格式,并且仅将维度和指标字段作为 doc values 存储一次。我们还提升了查询性能。TSDB 今天已经是列式存储了。本质上,这使得 TSDB 的存储模式变为列式。从 TSDB 中获得的经验现在正被更广泛地应用于 Elasticsearch。
请注意,列式索引模式是可选的,列式索引和基于文档的索引可以在同一个集群中共存。企业搜索场景可以使用面向文档的索引模式,而日志场景可以使用 logsdb_columnar 索引模式并完全采用列式存储,它们都在同一个集群中。实际上,目前共有七种索引模式,索引可以在同一个集群中混合使用任意模式。
没有倒排索引,列式存储如何保持快速
索引字段(对于字符串字段使用倒排索引,对于数值字段使用块 k 维树(BKD tree))使 Elasticsearch 能够非常高效地按字段查询或过滤。但代价是额外增加了一个昂贵的数据结构,会占用大量磁盘空间,并且在索引和合并时构建成本很高。在列式索引模式下,字段默认不再建立索引,那么对于不再索引的字段,我们如何保证查询性能仍然可接受呢?
一个主要变化是改进了 doc values 的扫描性能。这是关键,也是任何列式系统所依赖的基石。以前,doc values 的扫描基本上是逐文档进行的。Lucene 的 doc values API 只允许一次查找一个值。从历史上看,这符合搜索引擎的执行模型。在我们自己的 doc values 格式中,我们构建了批量读取值的能力,以支持 Elasticsearch 查询语言(ES|QL)查询。此外,在最近的 Lucene 小版本中,Lucene 的 doc values API 增加了对批量读取的支持。没有这一点,快速的列式扫描就不可能实现。
其次,我们全面采用了doc values 跳跃器,这是一种基于 doc values 的层级跳跃表。与倒排索引或 BKD 树相反,doc values 跳跃器是轻量级的数据结构。其核心是,跳跃器允许查询跳过不匹配查询条件的一组文档范围。它之所以能做到这一点,是因为它存储了诸如最小值和最大值之类的信息。因此,例如,当执行范围查询时,可以根据中间结果以及 doc values 跳跃器的最小值和最大值,跳过一段文档区间。doc values 跳跃器的有效性取决于文档在磁盘上的排列顺序。这就是为什么应该启用或调整索引排序以匹配实际场景。
通过显著提升列式扫描能力并加倍投入 doc values 跳跃器,我们能够默认避免为字段建立索引。请注意,字段仍然可以索引;index 映射属性在列式模式下只是默认值为 false。此规则的例外是基于文本的字段,它们默认仍然建立索引。这是因为文本字段提供全文搜索,包括文本分析、短语匹配和通配符匹配。这与单纯的过滤不同。
Elasticsearch 如何处理高基数和低基数字段
在设置包含字符串字段的模式时,一个重要的配置参数通常是基数,即预计会有大量唯一值还是少量唯一字符串值。许多系统有针对低基数和高基数字符串字段的专用字段或列类型。
低基数字段通常使用字典来存储,字典包含所有唯一值。然后,对于每一行偏移量,存储该行所包含词条在字典中的偏移量。这通常被称为序数(ordinal)。对于低基数字段,这种方法效果很好,因为每个文档只存储一个序数,占用的空间要小得多。像增量编码、偏移量编码和位打包这样的编码技术对于序数很有效,可以将每个文档的存储压缩到仅需几个比特。
然而,对于高基数字段,字典和序数方法可能适得其反。如果较大比例的文档都有唯一值,构建字典的成本会变得很高,存储节省也会减少。字典随后成为读取值的另一层间接引用。这就是为什么大多数系统在这种情况下会使用基于块的压缩以列式方式存储值。例如,多个行的值存储在 128KB 的块中,使用基于滑动窗口字典的压缩算法(如 zstandard 或 lz4)。一般来说,这是一种存储高基数字段的简单有效的方法,并且避免了构建和维护字典。
在基于文档的 Elasticsearch 中,有两种方式映射字符串:使用 keyword 字段映射或基于文本的字段映射之一。前者存储倒排索引和基于字典的 doc values。后者只存储倒排索引。这就是为什么通常文本字段映射器会与 keyword 映射器结合使用,作为多字段。此外,keyword 字段映射器(顾名思义)用于关键词或基数较低的字段,并使用基于字典的 doc values 实现。然而,在实践中,keyword 字段映射器也用于高基数场景。
在列式模式下,每个字段默认只存储一次。对于 keyword 字段,这意味着只存储 doc values,没有倒排索引。基于文本的字段现在默认也会存储 doc values 和倒排索引。基于文本的字段映射器与 keyword 字段映射器不同,因为它们不会通过 Elasticsearch 的列式索引动态映射逻辑自动使用,因此文本字段默认仍然保留倒排索引。
对于 keyword 和 text 字段,我们都没有选择公开一个基数映射属性。有时无法提前知道一个字段是低基数还是高基数。在将段刷新和合并到磁盘时,Elasticsearch 会看到所有值,并可以确定字段的基数。这就是为什么我们选择使用一个简单的基数阈值,自动判断是使用字典和基于序数的编码,还是使用基于块的压缩。如果某个字段低于此阈值,则使用字典和基于序数的编码;否则使用基于块的压缩。这简化了映射的配置,并使得随着数据演变自动优化存储成为可能,因为同一个字段的不同段可能使用字典,而其他段可能使用块。然而,这目前尚未就绪,因此在 9.5.0 版本中,在列式模式下,keyword 和 text 字段映射器都将值存储在 doc values 中,采用基于块的压缩布局。
两种方法的对比如下:
字典和序数编码 | 基于块的压缩 | |
|---|---|---|
适用场景 | 低基数字段 | 高基数字段 |
存储内容 | 包含所有唯一值的字典,外加每个文档一个序数 | 将多个文档的值压缩在一起,形成块 |
压缩方式 | 增量编码、偏移量编码和位打包将每个序数减少到几个比特 | 滑动窗口字典压缩,如 zstandard 或 lz4,通常针对 128KB 块 |
读取路径 | 解析序数,然后在字典中查找值 | 解压块,然后直接读取值 |
基数上升时的成本 | 字典变大,节省空间减少,额外间接引用不变 | 稳定,无需构建或维护字典 |
在列式模式技术预览中使用 | 尚未使用 | 是,同时用于 keyword 和 text 字段 |
列式映射属性:multi_value、nullability、on_failure
列式索引模式提供了对数据如何存储为 doc values 的更多控制。默认情况下,Elasticsearch 是宽松的,接受所有非格式错误的值(例如,每个字段和文档的 null 值和多个值)。如果文档中的字段有多个值或没有值,doc values 会存储额外的数据结构来处理它们,因此会隐式增加成本。
通过列式模式,新的映射属性提供了额外的控制。请注意,这些新映射属性目前仅适用于列式索引模式,但最终将适用于所有索引模式。
涉及三个新的映射属性:
属性 | 默认值 | 强制行为 | 违反时 | 可用版本 |
|---|---|---|---|---|
multi_value | true | 每个文档每个字段仅一个值 | 文档索引失败 | 9.5.0 |
nullability | true | 字段必须有值 | 文档索引失败 | 9.5.0 |
on_failure | fail | 上述失败如何处理 | 设置 fail 或 ignore 行为 | 下一个次要版本 |
multi_value:强制单值字段
默认情况下,Elasticsearch 接受每个文档多个值。要理解其影响,我们首先需要看看 Elasticsearch(使用 Lucene 的 doc values)如何存储一个密集数值字段,其中所有文档都有单个值:
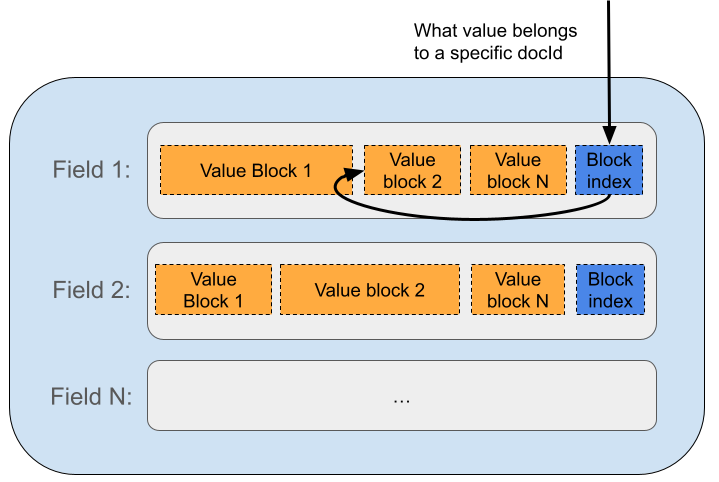
列式存储 doc values 布局:值块和块索引解析哪个值属于哪个 docId
在这种布局中,所有值都存储在块中。每个块中的值数量取决于索引模式,但通常是 128 个值,并且在同一个索引内始终保持一致。一个块中的所有值使用各种编码技术进行编码,如增量编码和位打包,因此每个块的大小可能不同,具体取决于编码技术对值的压缩效果。这就是为什么需要块索引。
Lucene 有 docid 的概念(文档的内部编号),本质上是一个行标识符。
- 查询产生匹配的 docid。
- 对于密集字段,可以直接从 docid 解析出块 ID。
- 可以从块索引中解析出块的偏移量。
- 一旦查找完成,目标块被解码,所有值均可获取。
- 最后,从 docid 可以解析出解码后值数组中的序数,从而得到最终值。
现在,让我们看看当文档具有多个值时,数据布局如何变化:
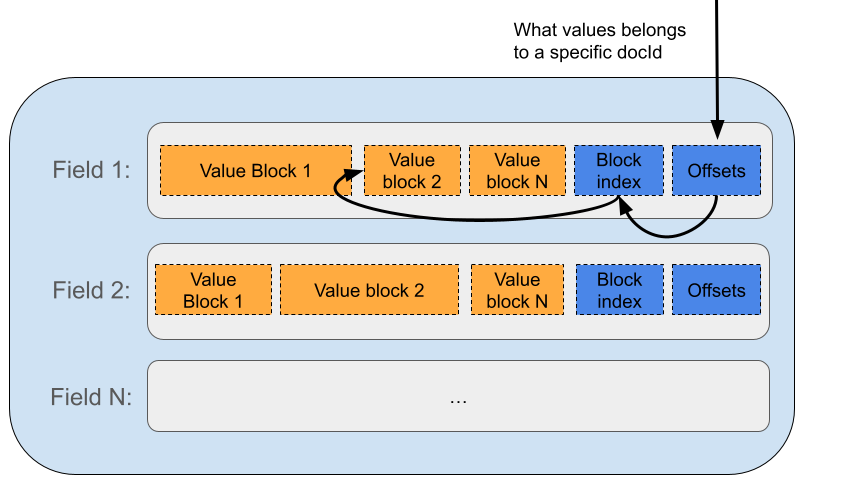
列式存储中的多值 doc values 布局:偏移量将 docId 映射到跨越值块的值
为了确定一个 docid 对应多少个值,需要进行偏移量查找。
在这种情况下,一个 docid 有一个或多个偏移量。每个偏移量指向一个块索引。单个文档的值是连续的,但可能跨越多个块。一般来说,由于值相似,值的压缩在块中效果很好。然而,如果每个字段和文档的值数量很大且值不相似,多值字段可能导致压缩效率降低。这一点加上额外的偏移量存储,导致多值字段通常在磁盘上占用更高的存储空间。
如果一个字段确实是单值的,您可能希望强制这一属性。multi_value 映射属性现在使得这一点成为可能。一个例子是日志级别字段。日志通常只有一个日志级别(如 debug、info 或 error)。在映射中强制该字段为单值,有助于避免意外使用比预期更多的存储空间。以下是一个映射片段示例,禁止字段 log.level 有多个值:
{
  "properties": {
    "log.level": {
      "type": "keyword",
      "multi_value": false
    }
  }
}
请注意,即使一个字段允许多个值,也不意味着会存储偏移量查找。只有当 Lucene 段中至少有一个文档具有两个或更多值时,才会发生这种情况。multi_value 映射属性仅用于强制约束。
nullability:要求每个文档都有一个值
默认情况下,Elasticsearch 接受字段没有值或值为 null 的文档。正如每个文档多个值需要额外的记账,没有值的文档也需要额外的记账来识别哪些文档至少有一个值。
如果某个段中并非所有文档都有值,doc values 会存储一个 docid 到偏移量的查找表(在 Lucene 中称为 IndexedDISI)。对于单值字段,该偏移量直接指向块索引;对于多值字段,则指向偏移量查找表。与存储的值块相比,这个查找表是紧凑的。然而,如果为那些每个文档至少应该有一个值的字段创建它,那将是一种浪费。
nullability 映射属性允许您控制文档是否允许没有值。与 multi_value 映射属性类似,nullability 属性用于强制约束。以下是一个映射片段示例,要求 log.level 字段必须有值:
{
  "properties": {
    "log.level": {
      "type": "keyword",
      "nullability": false
    }
  }
}
on_failure:验证失败时如何处理
如果文档的某个字段有多个值,而 multi_value 映射属性设置为 false,或者当字段映射的 nullability 设置为 false 且文档不包含该字段时,会发生什么?目前,索引此类文档将失败并返回错误请求。
作为下一个次要版本的一部分,on_failure 映射属性将可用。它允许您指定如何处理这些验证失败,基于每个映射字段。它支持两个值:
- Fail:使用客户端错误使整个文档的索引失败。这是 Elasticsearch 9.5.0 中的当前行为。
- Ignore:忽略验证错误,将该字段标记为已忽略,并将该字段的值存储在一个隐藏字段中,以便在请求源时可以检查。
尝试列式索引模式
列式索引模式仍在积极开发中,但我们鼓励您试用一下。在我们为列式索引模式准备通用可用性(GA)的过程中,我们将添加更多性能和效率改进。我们相信,通过采用列式思维,许多场景将受益于更高成本效益或更好的性能特性。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号