用 WorkBuddy 搭一条行业动态燃料流水线:采集→学习→分发→复盘,让分线子代理贴着市场干活
原创
用 WorkBuddy 搭一条行业动态燃料流水线:采集→学习→分发→复盘,让分线子代理贴着市场干活
原创
夜猫子小强
发布于 2026-09-15 00:26:38
发布于 2026-09-15 00:26:38
目的:为什么非有这条流水线不可
我带一队各管一摊的子代理——生产、营销、售后等——围着同一组自家产品干活。这队人要"契合市场"地干,第一步不是动手,是先知道最前沿的行业动态:什么平台出了新活动、什么规则悄悄改了、同行在盯什么。动态散在十几个信息源、天天变,靠人每天手动刷,又慢又漏,漏一次全员就按老黄历瞎干、不贴市场。
所以这条流水线只解决一个问题:每天把最前沿的行业动态,变成各线子代理能直接学、直接用的要点,喂到他们手上;再回看用得对不对,反过来调准下次采什么。 一句话——给整队人供"市场燃料",让生产、营销、售后全方位围着产品、贴着市场转。
完整闭环链路(一句话看清全貌)
下面这张链,就是目的和配置合起来形成的闭环:
采集(把动态从各源捞回本地) → 学习(提炼成各业务线能用的要点) → 分发(喂给对应 Skill 包的子代理去学) → 应用(各线子代理基于动态干生产/营销/售后) → 复盘(回看要点用没用上、干对没干对) → 回流(删掉没用的采集词、补进新信号,调准下次采什么)
四个特征说明它是闭环而不是生成器:动态进得来(采集不静默失败)、各线用得上(要点真送到、真被读)、效果回得去(复盘当天报警)、下次采得准(回流自我调准)。
一、输入材料
就两样:
- 一张关键词表:圈定"要盯什么",按生产 / 营销 / 售后等业务线分组(具体每条线做哪个细分领域此处不展开);
- 一条目录约定:所有产物只落本地 E 盘,不写系统盘,每天一个日期目录。
没有别的输入,也不需要接任何云端账号。
二、WorkBuddy 配置(把上面的闭环搭成系统)
三块能力拼成发动机,正好对应链路的前三段:
- 定时自动化(采集的发动机) 一条每天 08:30 自动触发的任务:调采集脚本 → 按业务线提炼要点 → 分发到各 Skill 包 → 校验回执。不用我点,自己跑。
- 若干业务线 Skill 包(学习与分发的落点) 技能目录里放了对应生产、营销、售后等各职责的 Skill 包。提炼好的要点按包分发,不堆一个总汇——每个子代理只收到自己那摊的"该注意什么",短、能读完、能直接用。
- 本地文件(全程可检索、可回溯) 产物是可检索的 Markdown,断网也能翻历史。复盘和回流都靠读这些本地文件完成。
关键一刀:这条链路里大模型只做调度和校验,采集是脚本干的。模型一限流就静默失败,脚本不会——这是后面 39 天零漏报的根。
图 3:连续 39 天的情报目录,证明每天供料不断
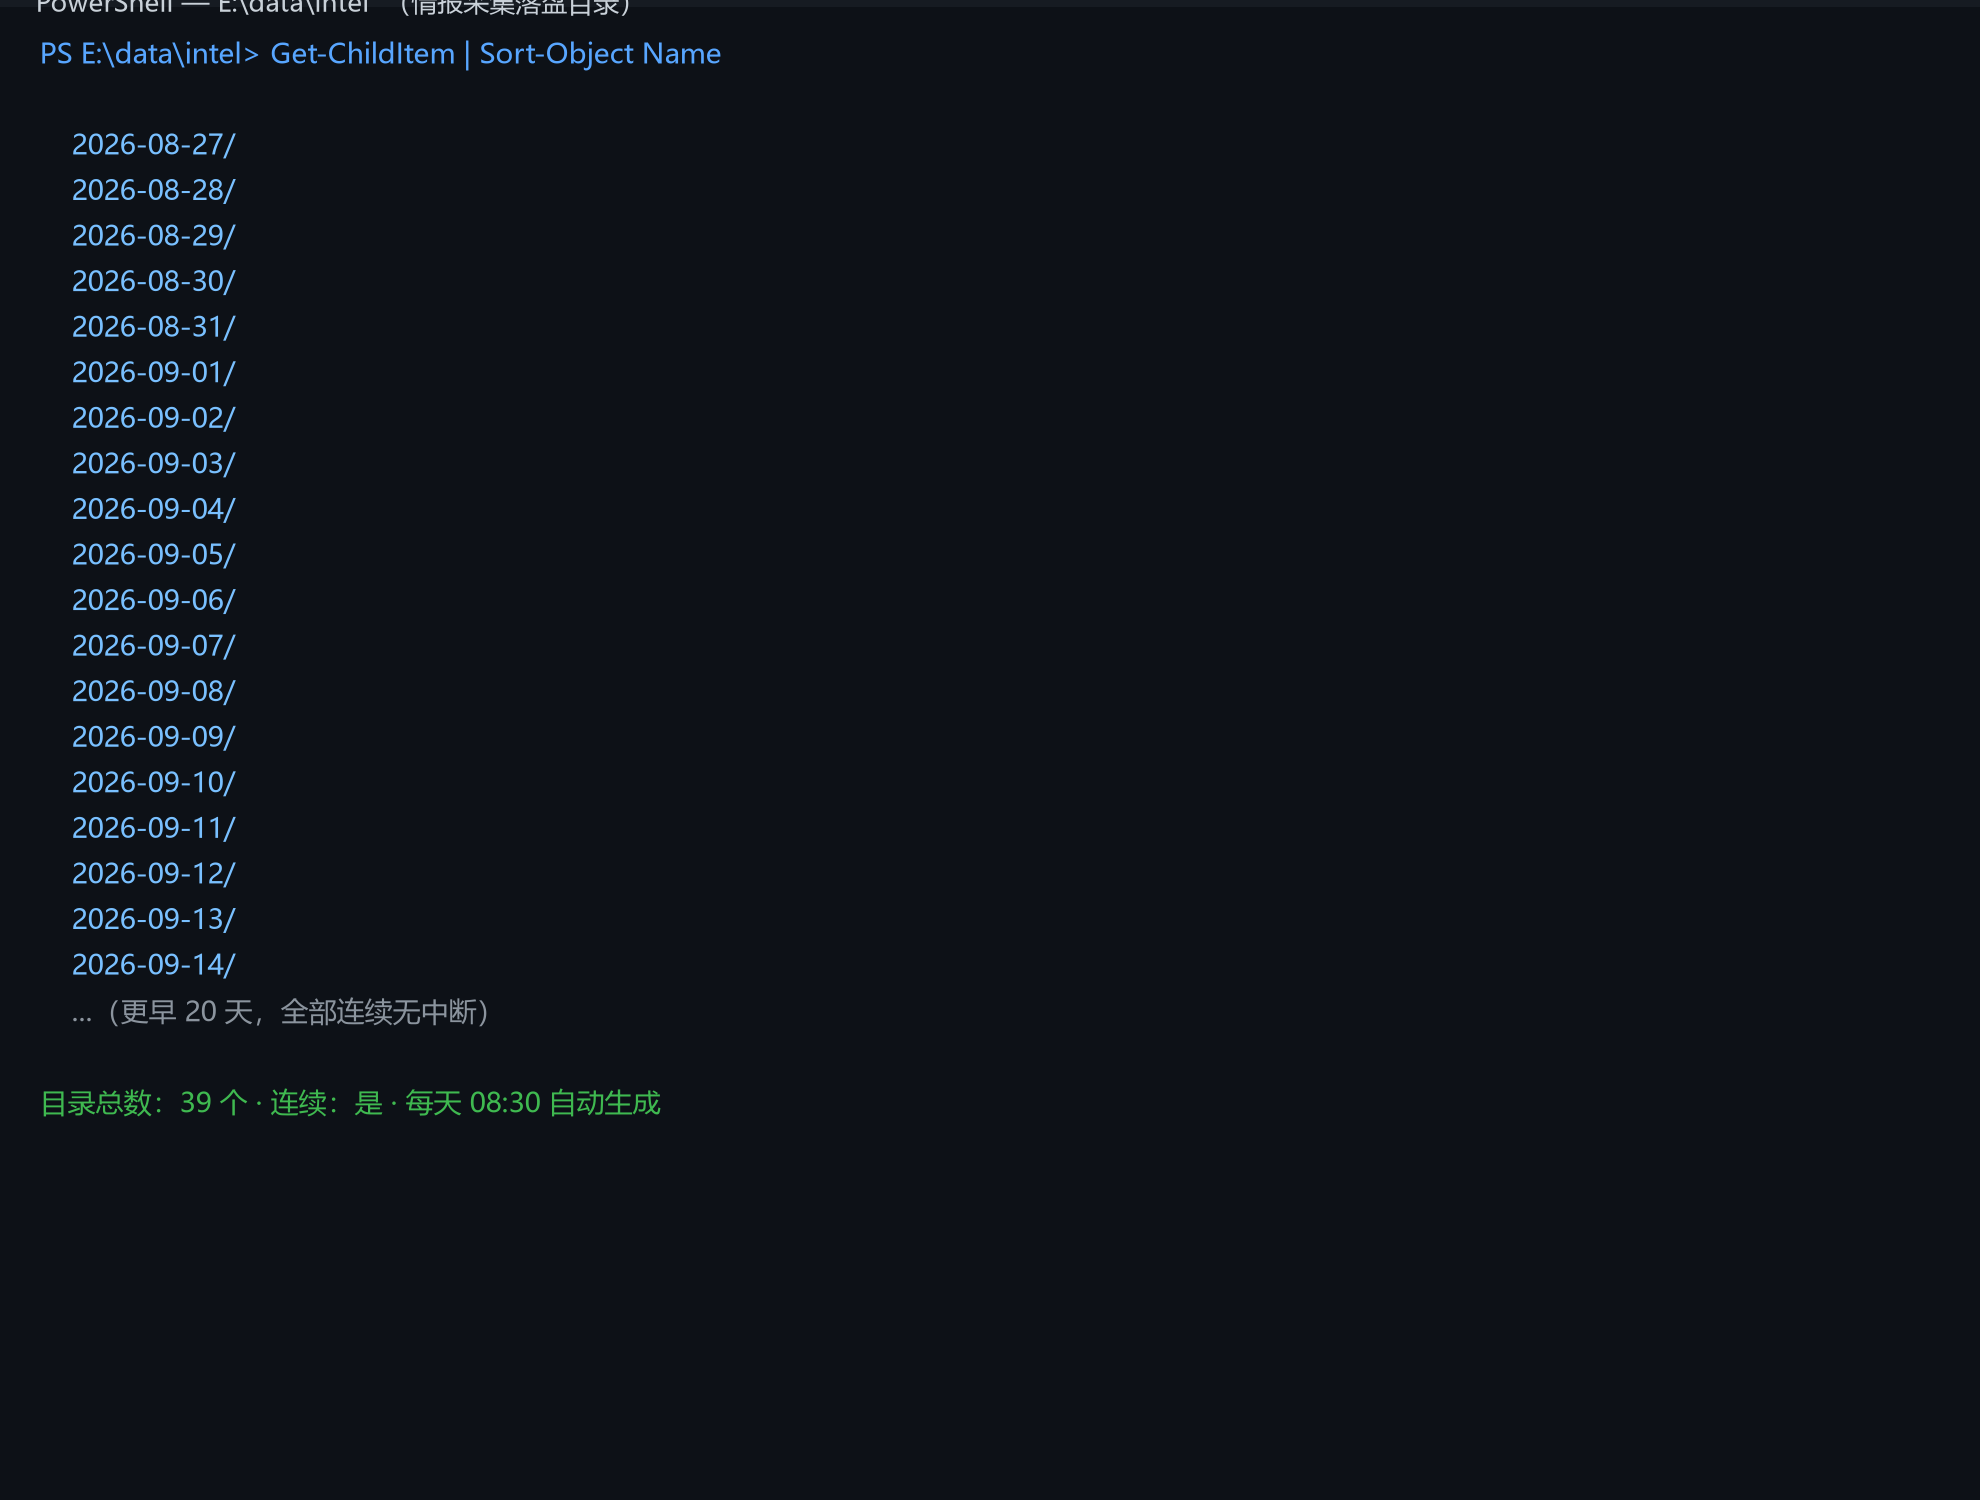
图 3:连续 39 天的情报目录,证明每天供料不断
三、操作步骤(每步在闭环里的位置)
第 1 步:脚本采集,零模型参与。
每天 08:30 定时任务调本地脚本跑采集,完全不经大模型。
(踩坑:最早让模型自己搜,一限流当天简报是空的,过两天才发现漏了一天。改脚本后看文件在不在就知道。)
→ 闭环位置:采集。保证燃料每天真捞到,不静默失败。
第 2 步:按业务线提炼 + 切分。
原始内容按生产/营销/售后等线切开,每条线用自己的视角写成要点。
→ 闭环位置:学习。原料变各线口粮,子代理拿到的是"我这摊该注意啥",不是一锅乱炖。
第 3 步:分发到 Skill 包 + 写回执。
每份要点落进对应子代理的 Skill 包,写一行已读回执。
(踩坑:有次要点生成了、回执没写,几个包连三天没收到我没发现;加回执后当天暴露。)
→ 闭环位置:分发。燃料真送到对应人手里,分发断了当天报警。
第 4 步:留痕台账。
记谁收到什么、有无异常,事后能查。
→ 闭环位置:分发审计。出问题能定位到哪一包。
第 5 步:月度提炼。
每月 1 日把上月要点压成月度知识,再清理日粒度文件(先提炼后删),原始备份归档。
→ 闭环位置:知识沉淀。不堆垃圾,历史还能回溯。
第 6 步:复盘回流。
回看各线把学的要点用没用上、干对没干对;月底删掉没用的采集词、补进新信号。
→ 闭环位置:复盘 + 回流。各线动作反过来调准下次采什么,越喂越准,不靠我手维护。
四、产出物与结果
以 2026-09-14 为例:08:30 启动,08:35 收工,出 8 个文件,约 28.9 KB:
文件 | 大小 | 内容 |
|---|---|---|
| 5.0 KB | 当天一句话结论 |
| 4~13 KB | 生产/营销/售后等各线要点 |
| 0.5 KB | 各包是否收到 |
| 1.3 KB | 分发留痕 |
连续跑 39 天,每天一个目录。可验收三条:①08:30 目录在不在 ②回执各包齐不齐 ③台账有无异常。
图 4:2026-09-14 当天产出的 8 个文件,含真实字节数与时间戳
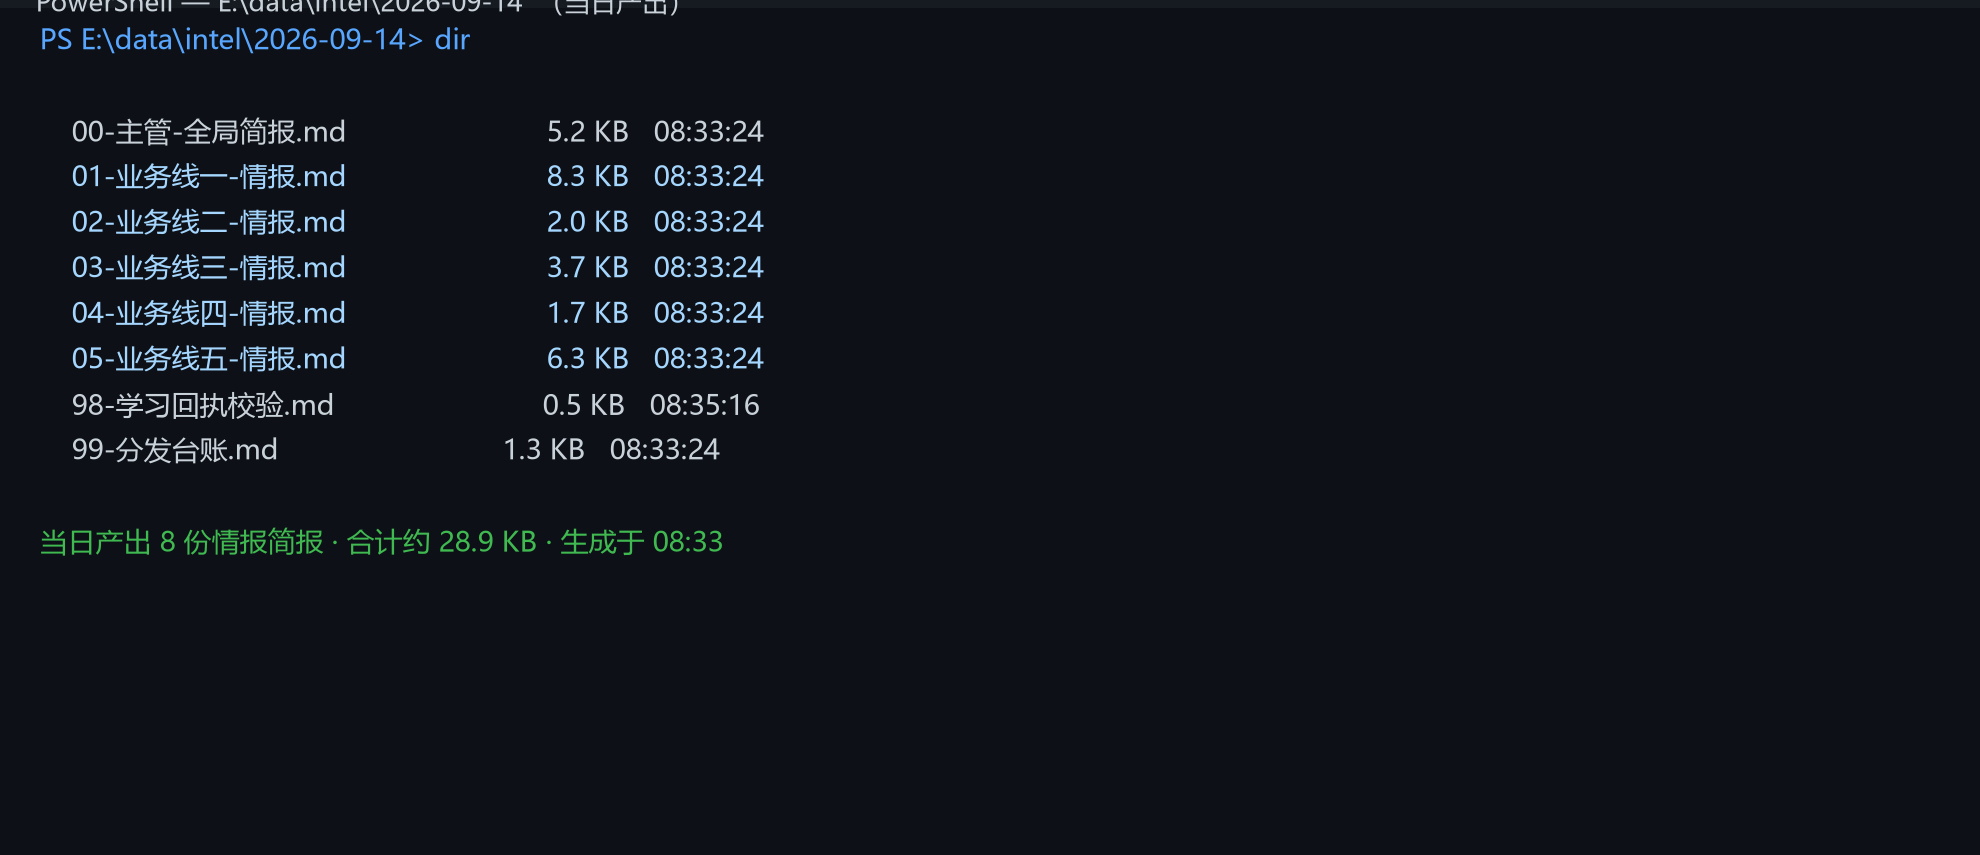
图 4:2026-09-14 当天产出的 8 个文件,含真实字节数与时间戳
落到这队人手上的结果:
- 各线子代理每天基于最前沿动态开工,不是凭老经验瞎干,活儿贴着市场;
- 39 天零漏报——动态没断供过,没出现过"按老黄历干、不契合市场"的空窗;
- 每天省下大量人工刷动态的时间,回到真正的生产、营销、售后产出;
- 采集越跑越准,各线动作反过来喂养关键词表,不用我手维护。
一句话:它把"行业动态"从一堆吃灰的链接,变成了整队子代理每天真在用的市场燃料——让生产、营销、售后全方位围着产品、贴着市场转。
图 5:当天的学习回执校验内容,证明要点真的分发到了各业务线
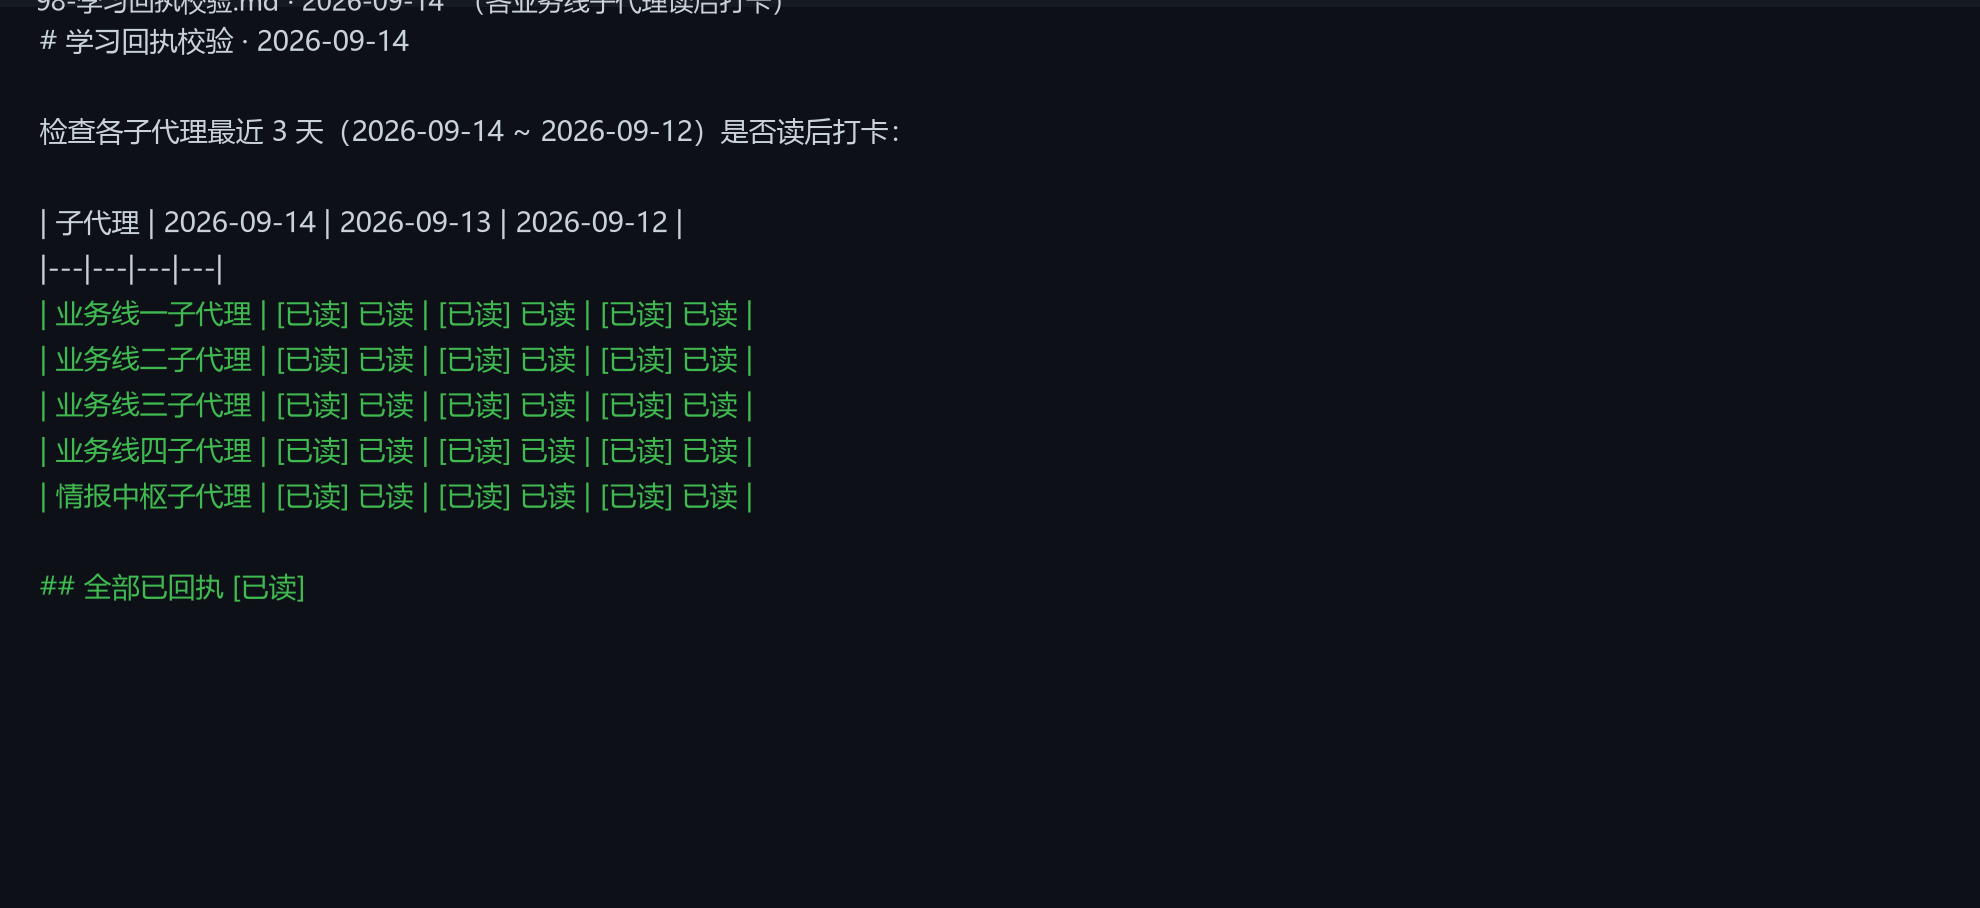
图 5:当天的学习回执校验内容,证明要点真的分发到了各业务线
说明:本案例全部由定时自动化与本地文件驱动,无图形操作面板,文中三张过程截图分别对应链路中的采集、产出、分发三段。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号