NVIDIA开源SoL-Pi:让AI自己学会省token,成本砍掉一半

NVIDIA开源SoL-Pi:让AI自己学会省token,成本砍掉一半
dolphin57
发布于 2026-09-15 14:04:16
发布于 2026-09-15 14:04:16
让 Claude Code 或 Codex 连续跑几个小时处理一个复杂任务,账单往往比你想象的更刺激。NVIDIA 最近开源的 SoL-Pi,干的事情不是让 agent 少干活,而是让 agent 自己学会「怎么更省地干活」——在保留 Pi 约 94% 能力的条件下,把 token 消耗砍掉 45–49%。
一、背景:Coding Agent 的账单,到底贵在哪?
如果你已经试过用 Claude Code、Codex 或类似工具处理一个真实代码库,应该对这种感觉不陌生:任务确实在推进,但后台的成本曲线也在悄悄爬坡。
显性成本是每次模型调用的价格;隐性成本却藏在整个 harness 的运行方式里:
- 重复模型轮次:改完文件后,agent 总要单独发一轮去执行
pytest、npm test这类验证命令; - 上下文重放:大段工具输出被反复塞进 prompt,哪怕模型只关心其中一小部分;
- 已完成子任务残留:已经结束的步骤仍占据着上下文窗口,继续消耗 token;
- 长日志全文阅读:模型花一整轮去读诊断日志,其实只有几行影响下一步决策。
这些浪费不会出现在单次对话里,但在一个跑上数小时、甚至数天的 agent 任务里会积少成多。
SoL-Pi 的 slogan 很直接:Spend less without getting less done. 花更少,但做不少。
二、SoL-Pi 是什么?
SoL-Pi 是 NVIDIA 为 Pi 这个轻量级 coding-agent harness 开发的独立扩展。它的核心问题可以概括成一句话:在继续扩大模型能力之前,能不能先让 AI 把 AI 自己的工作流程变得更便宜?
项目名字里的 SoL 指「Self-Optimizing Loop」,即「用自动研究循环去规模化地发现效率改进」。它通过一个可扩展的 递归自我改进(RSI) 管道来工作:
图:SoL-Pi 图——分层代码论文被递归研究路径追踪至一个验证结果
- 构建可执行的 agent 环境;
- 让其他 agent 观察现有 harness 的运行轨迹;
- 把观察转化为效率改进提案;
- 实现、验证、筛选出真正有效的机制;
- 最终沉淀为可复用的 harness 扩展。
研究团队最初提出了 152 个效率方向,覆盖上下文、进度追踪、工具调用、任务委托、提示策略、评估方法等六个家族。经过 Oracle 预筛选后,这些方向被送入多个独立的 auto-research 谱系;最终只有 4 个机制 同时通过了「能力下限」和「效率提升」两道闸门,进入正式 harness。
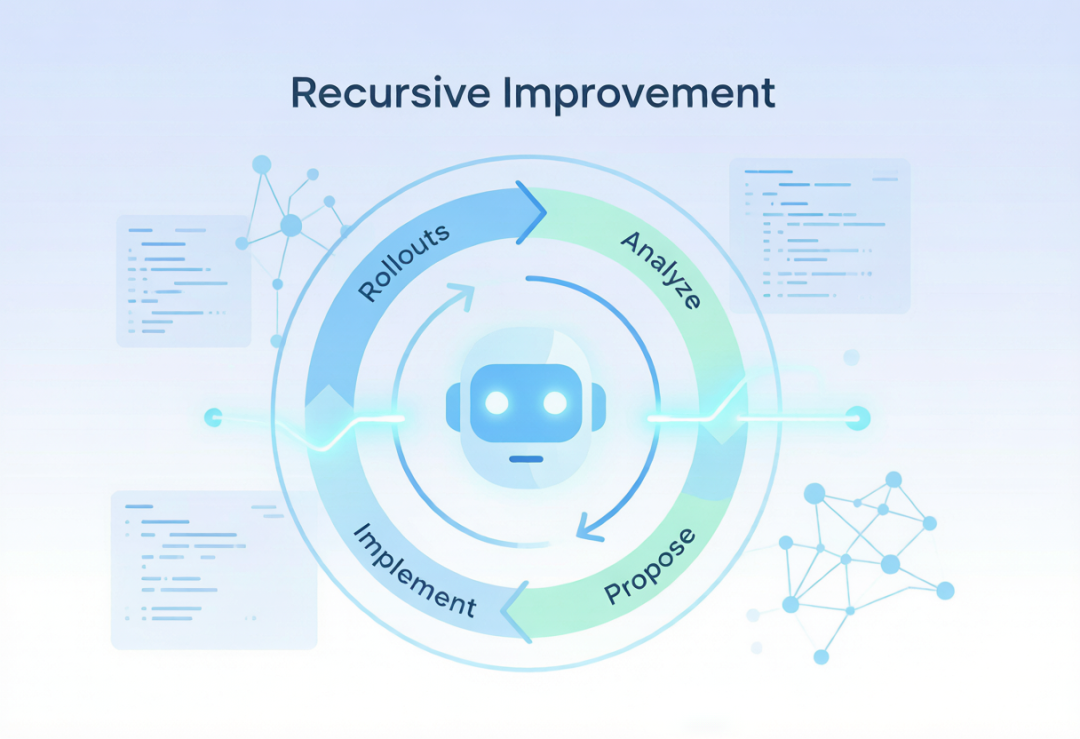
图 1:自动研究循环——让 AI 自己发现 agent harness 的效率瓶颈
三、自动研究循环是怎么运转的?
SoL-Pi 的方法论本身也经历了几轮迭代,最终定型为一条可并行、可丢弃、可验证的流水线:
七阶段流水线
- Trajectory Rollouts:在真实或合成环境中运行大量 agent 轨迹;
- Map-Reduce Analysis:独立分析器分别检查单条轨迹,reducer 合并证据;
- Proposal:基于证据提出效率改进方案;
- Implementation:把方案实现为 harness 扩展;
- Reviewer:内部 reviewer 检查正确性;
- In-Trajectory Validation:在训练轨迹内验证改进效果;
- Held-Out Validation:在从未见过的测试集上再次验证。
关键设计有三点:
- 能力下限约束:任何改进都必须保证核心能力指标不掉出预声明容差,禁止用「少做」换省钱;
- 训练/测试隔离:效率机制的开发只看训练轨迹,最终评估使用严格保留的 EdgeBench 等 held-out 任务;
- 一次性 skill 模板:把最小循环模板复制成独立副本运行,跑完就丢弃,避免代码无限累积,也方便并行扩展。
四、四大幸存机制详解
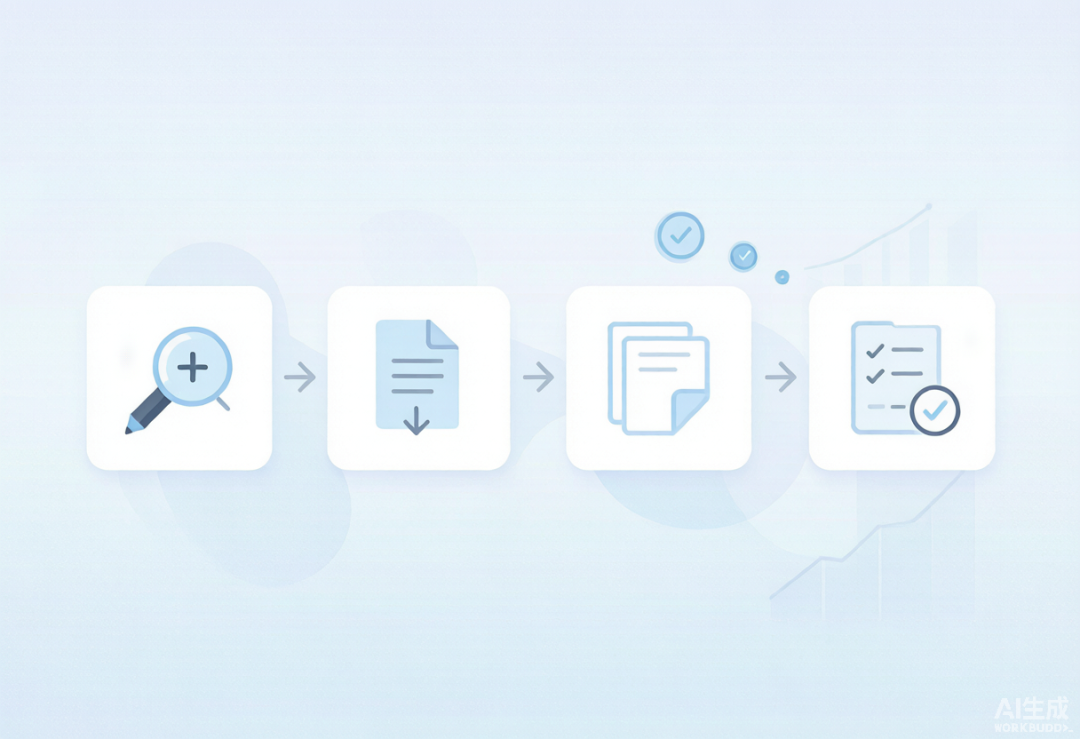
图 2:SoL-Pi 最终沉淀的四大效率机制
1. Action Fusion:把「编辑+验证」熔成一次调用
最常见的浪费之一,是「编辑文件 → 模型决定下一步 → 执行验证命令」这套动作被拆成两轮。Action Fusion 的思路很直接:把一次编辑和紧随其后的 bash/test 命令打包成一个本地序列,变成一次工具调用。模型只决策一次,后续动作在 harness 本地执行。
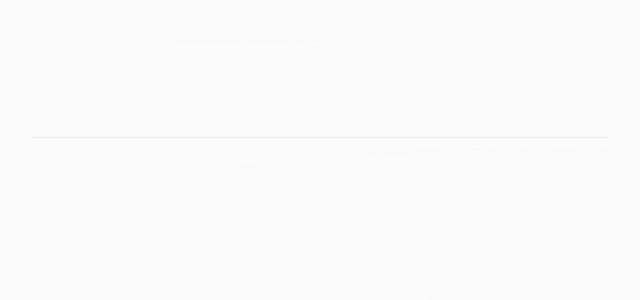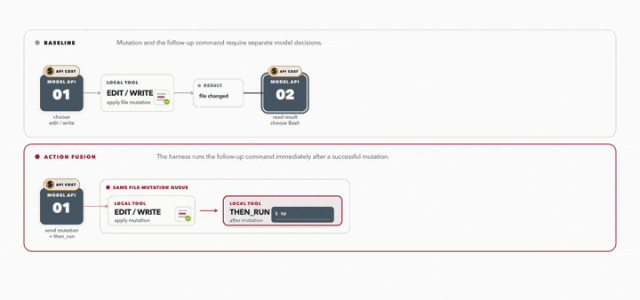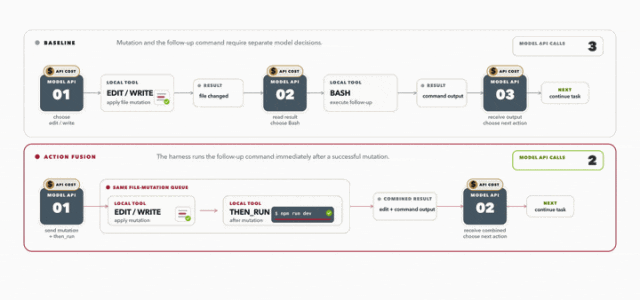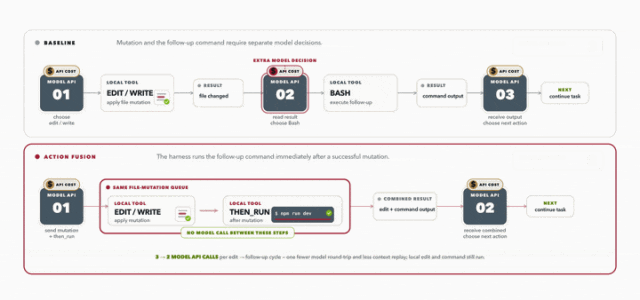
图:Action Fusion 把「编辑 + 后续命令」合并为一次本地序列调用
2. Online Context Compact:子任务完成就压缩
传统做法往往依赖 KV cache 复用或晚期压缩,但上下文窗口里的冗余其实从子任务边界就开始堆积。Online Context Compact 在子任务完成时触发重写,把已结束工作的内部细节压缩成高层摘要;更重要的是,它在重写前会估算「重写成本」能否被未来节省覆盖,避免为了压缩而压缩。
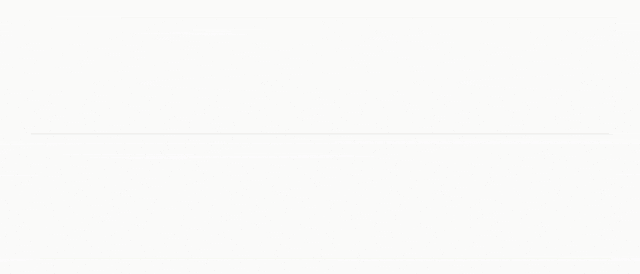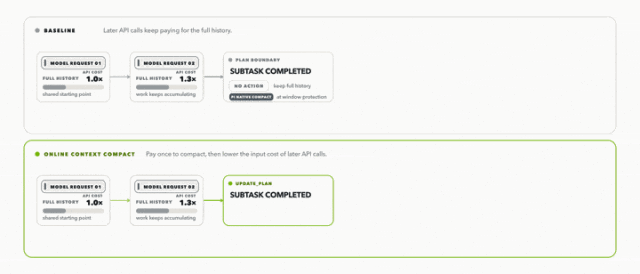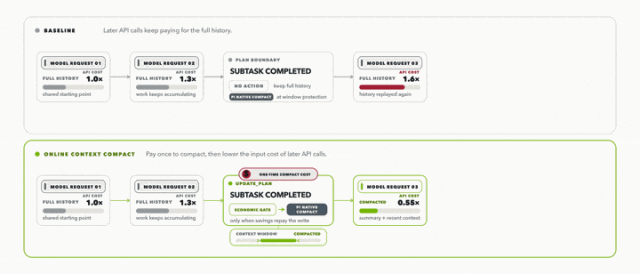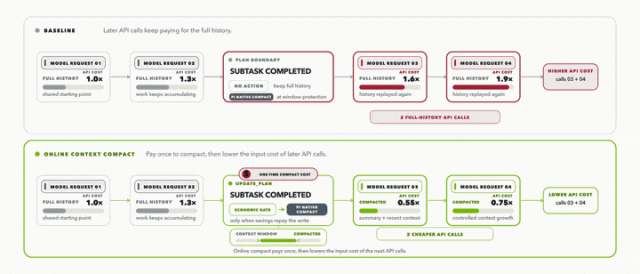
图:Online Context Compact 在子任务完成时主动压缩上下文
3. ObservationPack:大输出用「句柄」代替
agent 运行中经常出现大文件或长工具输出被反复引用。ObservationPack 的做法是:在上下文中只保留一个稳定句柄(handle)和一段短摘录,原始 payload 本地归档;当模型需要精确内容时,再按页召回。这样既减少了上下文体积,也没有丢失可验证性。
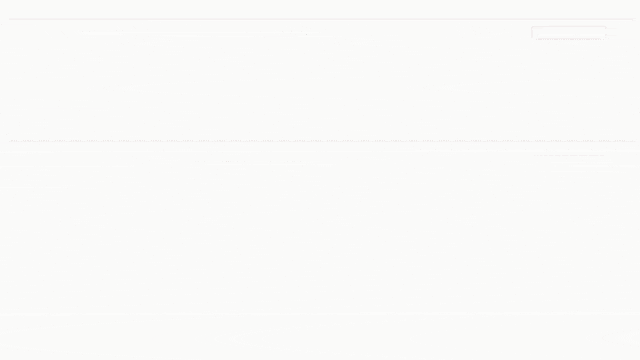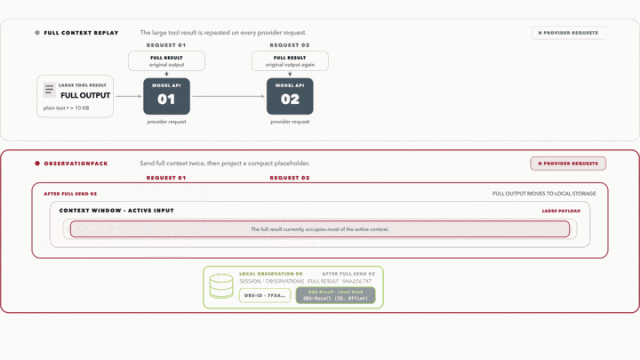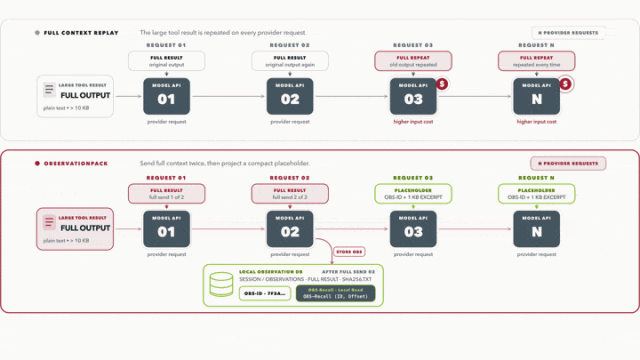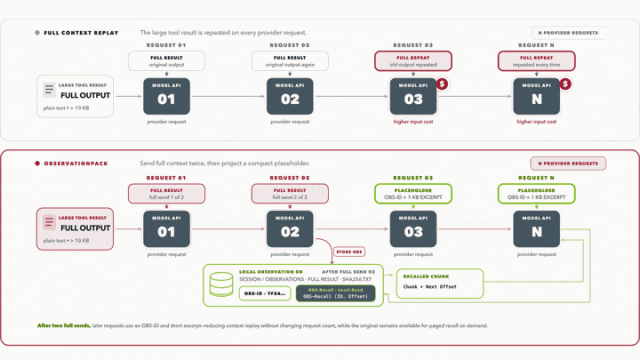
图:ObservationPack 用紧凑句柄替换重复工具输出,并保留按需召回能力
4. Evidence-Preserving Reducer:长日志先看摘要,再逐行验证
把整段长诊断日志直接塞进主模型既贵又低效。SoL-Pi 把它交给成本更低的模型首读,生成一份带行号引用的「收据」(receipt);主 agent 不读整段日志,只读收据,并且逐行验证引用是否真实存在。摘要不等于证据,引用才是。
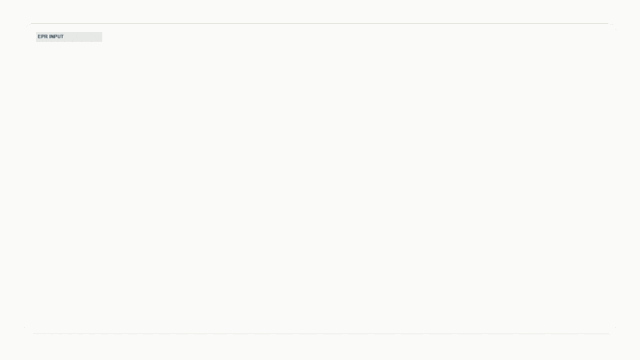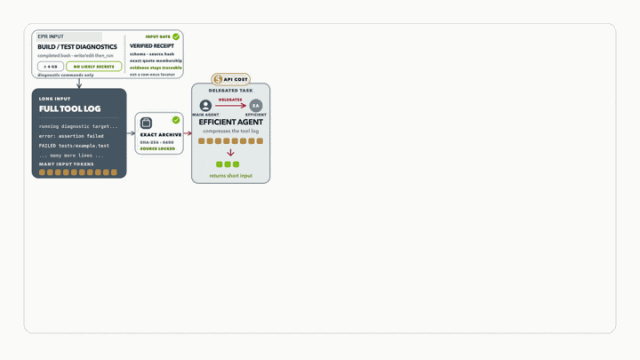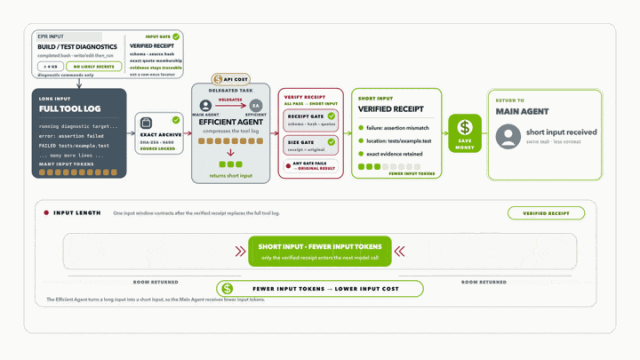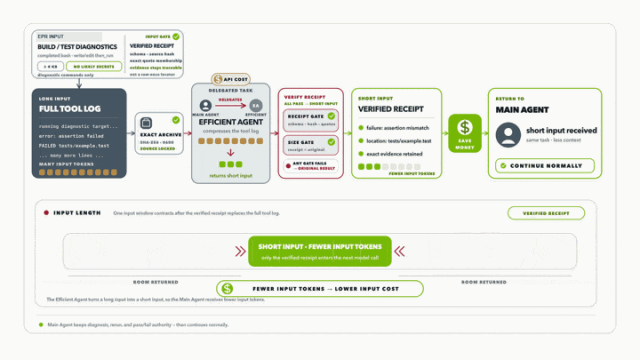
图:Evidence-Preserving Reducer 把长日志转成带行号引用的已验证收据
五、实测数据:省钱,但没怎么掉能力
SoL-Pi 的评估覆盖了三个层面:单任务基准、多任务 benchmark,以及多 agent 协作场景。
EdgeBench:保留 94% 能力,成本大幅下降
EdgeBench 是团队严格保留的 51 个任务 held-out 测试集。结果显示,SoL-Pi 在保留 Pi 约 94% 平均分 的同时,token 和 API 成本显著下降:
对比基线 | Token 降幅 | API 成本降幅 |
|---|---|---|
vs Pi | 45–49% | 约 1/3 |
vs 原生 Codex / Claude harness | 35–64% | 50–54% |
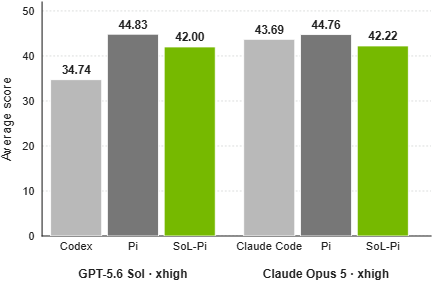
图:EdgeBench 上各 harness 平均性能与 token / API 成本对比(SoL-Pi 明显更低)
Terminal-Bench 4:单次解题成本最低
在 63 个 CPU-only 任务的 Terminal-Bench 4 上,SoL-Pi 的解题数略低于 Pi(15 对 18),但总成本和单次解题成本都是最低的:
Harness | 解题数 | 总成本 | 每题成本 |
|---|---|---|---|
Codex | 18/63 | $272.35 | $15.13 |
Pi | 18/63 | $286.45 | $15.91 |
SoL-Pi | 15/63 | $211.12 | $14.07 |
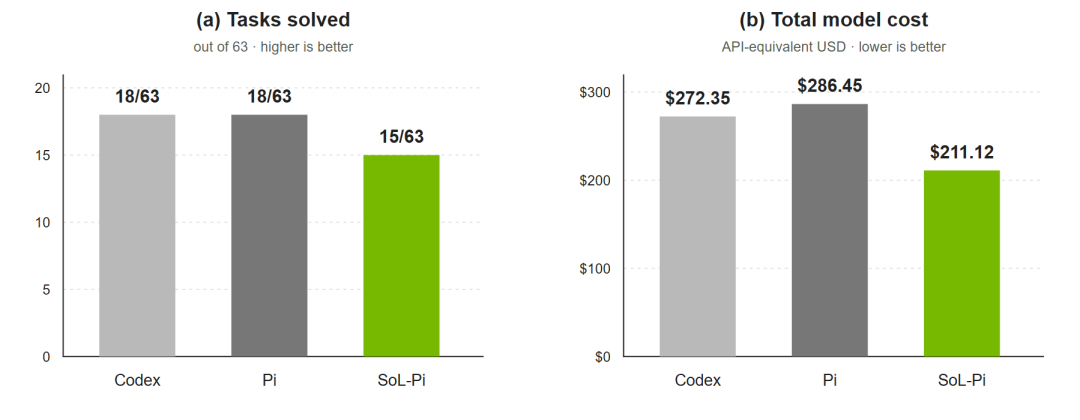
图:Terminal-Bench 4 各 harness 解题数与总成本对比
Swarm 场景:多 agent 协作也更省
在 120 分钟的多 agent 任务中,1 个 Sol 协调器 + 20 个 SoL-Pi worker 的组合,相比 20 个 stock Pi worker:
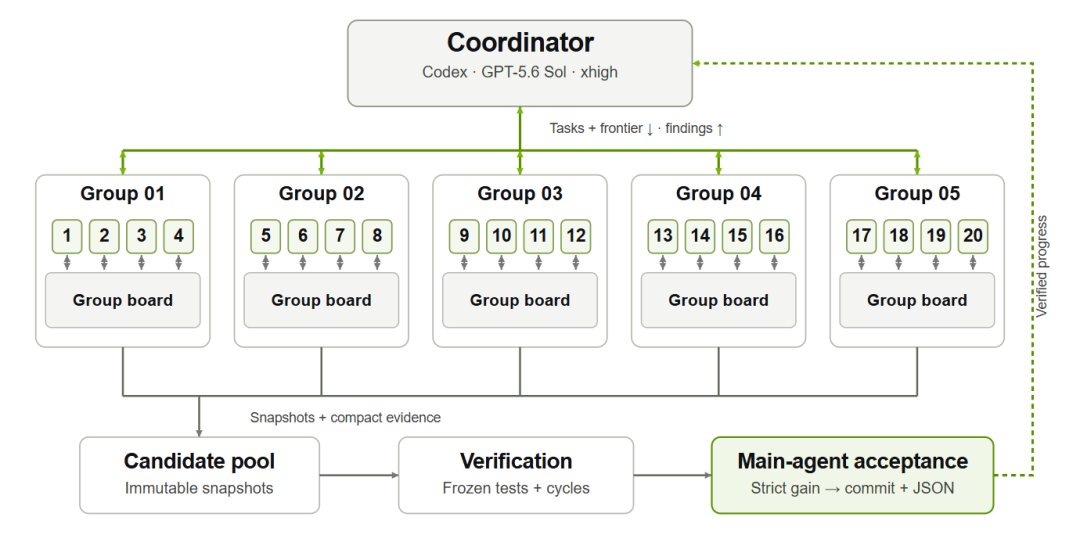
图:SoL-Pi Swarm 架构——1 个 Sol 协调器指挥 5 组共 20 个 SoL-Pi worker
配置 | Cycles | 模型成本 | 速度门限 |
|---|---|---|---|
Sol + 20 SoL-Pi | 1,127 | $60.11 | 8/8 |
Sol + 20 stock Pi | 1,366 | $82.12 | 7/8 |
单 Sol | 1,333 | $39.20 | 8/8 |
SoL-Pi swarm 比 stock Pi swarm 少了 17.5% cycles,模型成本低了 26.8%。单 Sol 虽然最便宜,但 cycles 最多、最慢;加入 SoL-Pi worker 后在速度和成本之间取得了更好的平衡。
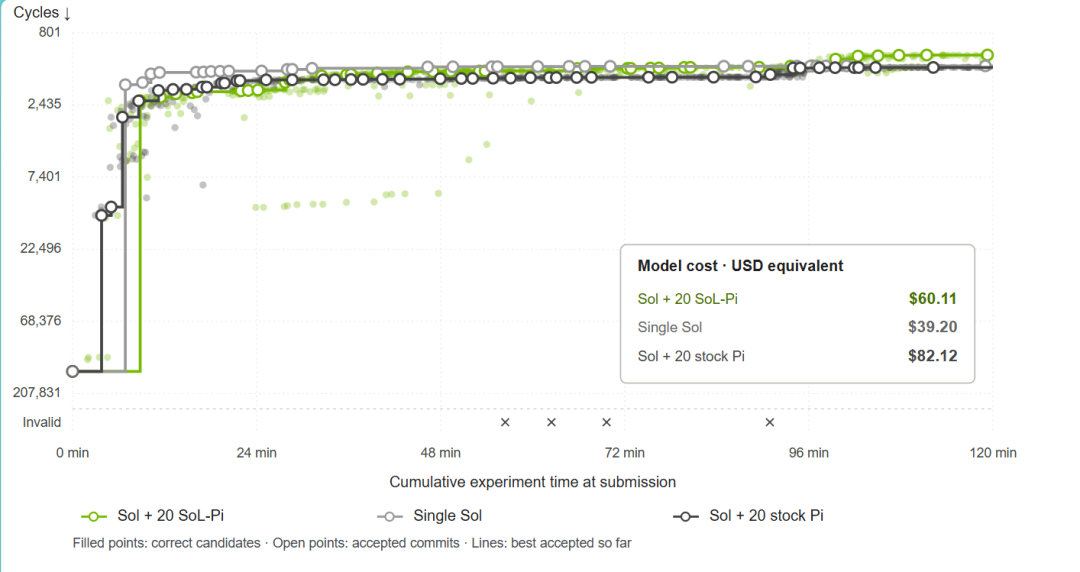
图:Swarm 场景下两种配置的 cycles 与模型成本对比
六、对企业 AI 落地意味着什么?
对正在内部落地 coding agent 的团队,SoL-Pi 至少带来四点启示:
1. 成本是可被「工程化」压缩的
不是简单换更便宜的模型,而是减少无意义的 token 流量和模型轮次。这种节省是可量化、可复现的,而且直接反映在账单上。
2. 效率优化本身可以自动化
把 agent 的运行轨迹、成本日志、工具调用记录、上下文快照收集起来,就能构建自己的自动研究循环。今天你手动发现的浪费,明天可以让另一个 agent 去批量扫描。
3. 别用「少做」换省钱
SoL-Pi 明确设置了 capability floor:所有改进必须同时满足「能力指标不掉出容差」+「至少一项效率指标改善」。这比单纯砍成本更接近真实业务价值。
4. 机制比单次结果更重要
四个机制(动作融合、在线压缩、观察包、证据保留摘要)都是 harness 层面的可复用改进。它们不绑定具体模型,也不绑定具体任务类型。
七、怎么上手?
SoL-Pi 的安装方式很直接,基于 Pi 的公开扩展接口:
# 安装测试过的 Pi 版本 npm install --global @earendil-works/pi-coding-agent@0.84.2 # 安装 SoL-Pi pi install git:github.com/NVlabs/SoL-Pi # 仅对当前项目生效 pi install git:github.com/NVlabs/SoL-Pi --local --approve
需要注意:
- SoL-Pi 当前是 Pi 的扩展,不是独立 harness;
- 每个机制都是 opt-in 且默认关闭,可以逐项开启观察效果;
- 效率收益在不同任务类型和模型后端上会有差异,建议先用内部任务跑 A/B。
八、局限与边界
客观地说,SoL-Pi 还处于早期探索阶段,有几个边界需要关注:
- 绑定 Pi:如果你想直接用于 Claude Code 或 Codex 原生 harness,需要移植;
- 能力-成本权衡:Terminal-Bench 4 显示,解题数从 18 降到 15,说明省钱并不总是「免费」的;
- 研究成本:自动研究循环本身需要消耗算力和 token,它适合长期、高频运行的 agent 场景,短期小任务不一定划算。
结语
SoL-Pi 的真正价值,不只是开源了四个省 token 的技巧。
它证明了一件事:在大模型继续卷能力之前,我们可以先让 AI 改进 AI 自己的工作流——把效率优化变成可扩展、可验证的自动研究循环。
对企业 AI 团队来说,这意味着 coding agent 的成本曲线不再只能交给模型厂商,而是可以靠数据和工程方法自己往下压。
值得跟踪,也值得动手一试。
AgentAI EfficiencyNVIDIASoLPi企业AI落地
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-14,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号