用 AI 做卡拉OK字幕视频 — MP3 Karaoke Subtitle Generator

用 AI 做卡拉OK字幕视频 — MP3 Karaoke Subtitle Generator
用户12724357
发布于 2026-09-15 18:49:59
发布于 2026-09-15 18:49:59
一首歌,一张封面,一份歌词文本——如何快速生成带逐字高亮的卡拉OK字幕视频?
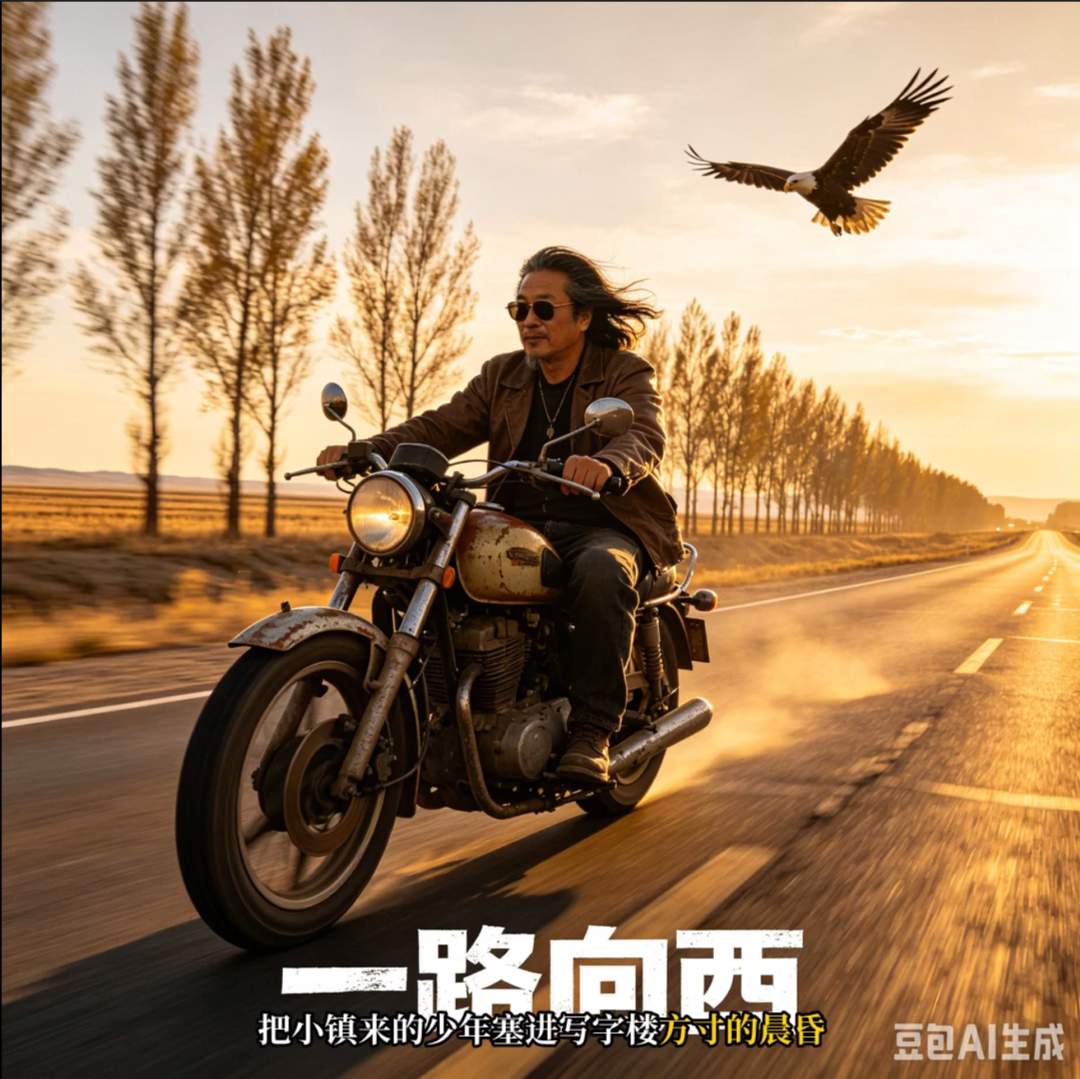
今天介绍一个我这两天做的开源项目MP3 Karaoke Subtitle Generator,它利用 WhisperX 语音识别和 wav2vec2 强制对齐技术,将 MP3 音频和歌词文本自动对齐,生成 1080×1080 的卡拉OK字幕 MP4 视频。整首歌的每一句歌词、每一个字,都能精确匹配到演唱时间。
项目开发
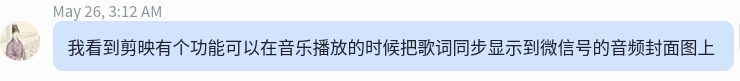
之所以做这个么项目,是因为我之前看到我的一个同学的公众号上发布的音频背景图上竟然可以显示歌词字幕,于是我打听到这是剪映的一个付费功能,我没有用过这个软件,付费是不可能的。
下面是我和我的Hermes Agent助手小明聊天,进行项目调研的过程。
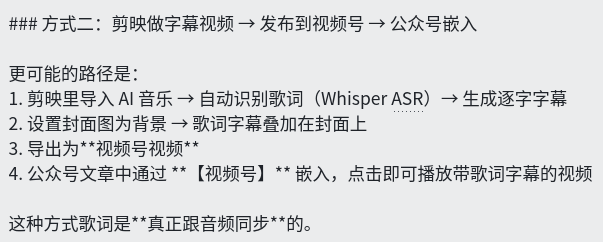
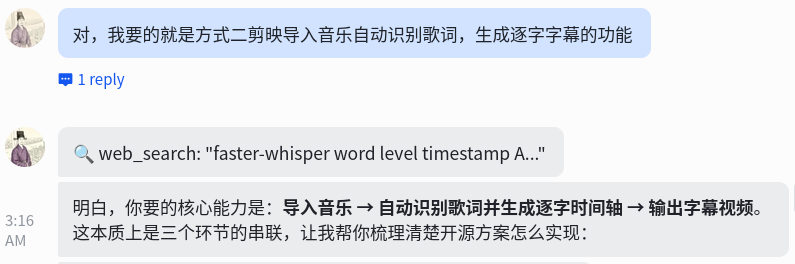
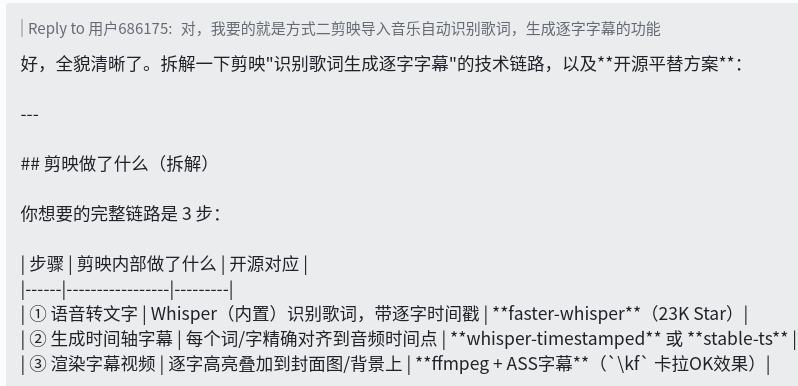
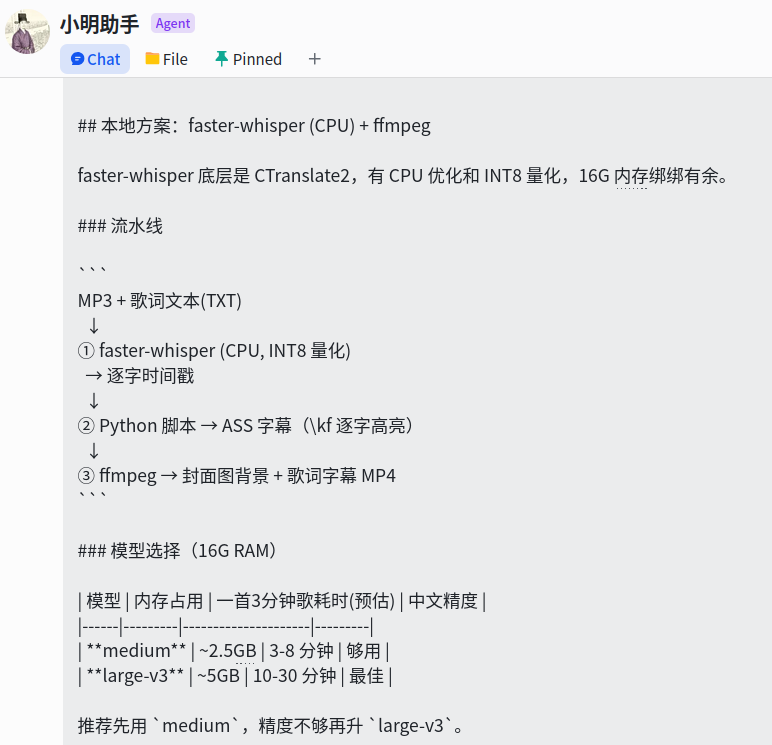
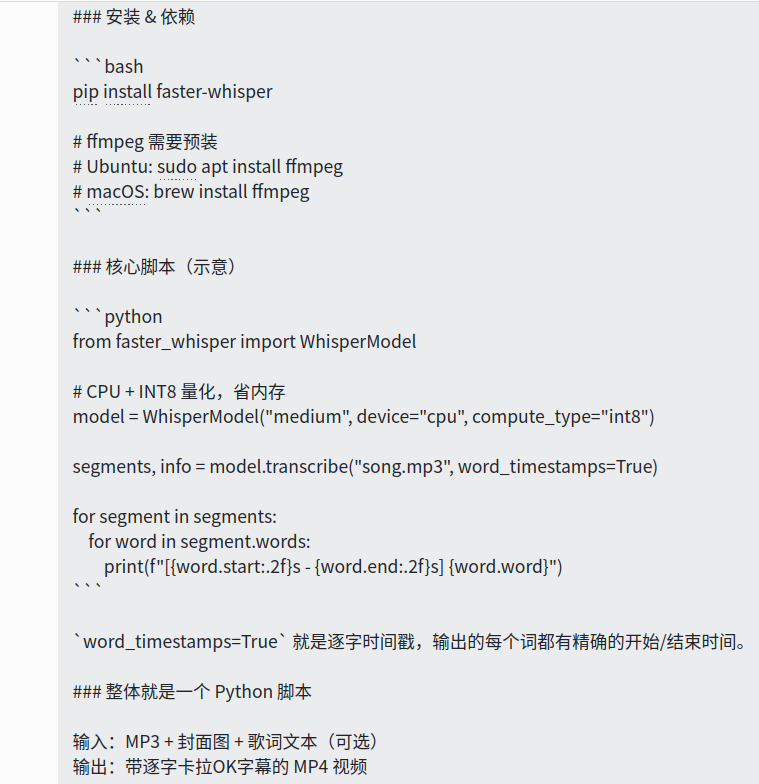
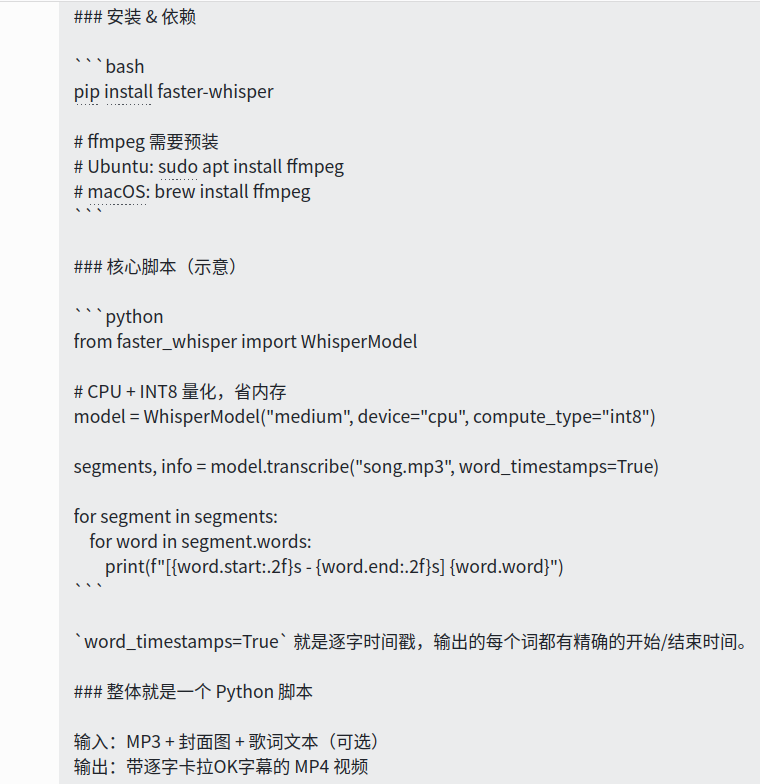
接下来,把上面的开发方案保存的一个文件里,打开Claude Code, 模型使用Minimax M2.7,使用技能
/superpowers:brainstorming读取上面保存的开发方案,进行具体项目规范设计。
等到草稿完成,另外开一个窗口,启动Claude Code, 模型使用GLM 5.1, 告诉它这是Minimax M2.7写的一个项目规范设计,帮助review一下,效果很好,指出一些设计上没有考虑到的问题,最后确认,进行开发,时间不长,代码生成也就十几分钟,还包括单元测试。
效果展示 一路向西
输入一段 MP3 音频 + 歌词文本:
黄昏的余晖 染红了车窗外的风尘
把小镇来的少年 塞进写字楼方寸的晨昏
黄朝九晚五 像被雨水打湿的枯叶失了神
输出一个视频:背景是封面图(支持模糊背景),歌词逐字高亮跟随演唱节奏,就像真正的卡拉OK。
核心功能
- 逐字精确时间戳
基于 wav2vec2 强制对齐,不是简单的逐行估算,而是每个字符都有独立的开始/结束时间
- ASS \kf 平滑高亮 字幕不是突然变色,而是像流水一样从左到右平滑扫过,卡拉OK经典效果
- 多种背景模式 静态封面图、GIF 动图、多图轮播(淡入淡出切换),三种模式任选
- 中文音频优化 默认使用 Whisper large-v3 模型,对中文识别和对齐效果最佳
- 自动歌词检测 歌词文件放在 material/{歌名}/{歌名}.txt,自动识别无需手动指定
项目架构
项目模块架构 MP3 音频 输入 歌词文本 输入 背景图片 可选 封面图 可选 transcribe.py WhisperX 转录 + wav2vec2 强制对齐 align.py 歌词对齐 + 头部解析 subtitle.py ASS \kf 卡拉OK字幕生成 render.py ffmpeg 视频渲染管线 build/{歌名}.mp4 — 1080×1080 卡拉OK字幕视频 逐字高亮 + 封面背景 + 音频合成 输入 AI 核心 生成 渲染 输出
工作流程
① 转录 WhisperX large-v3 识别音频,获取语音片段边界和文本 输出:11 个片段,每个包含起止时间和识别文本 ② 文本匹配 + 强制对齐 用 SequenceMatcher 将歌词行匹配到转录片段 再用 wav2vec2 将正确歌词文本直接对齐到音频波形 关键:歌词文本是正确的,对齐精度远高于 ASR 文本 ③ 间隙插值 转录间隙中的歌词行,按比例分配到前后对齐行之间 保证时间连续、无跳跃 ④ 字幕生成 ASS 格式 + \kf 标签,每个字符独立高亮时长 \kf50 = 该字符在 50 厘秒内完成高亮 ⑤ ffmpeg 渲染 背景(封面/GIF/多图轮播)+ 音频 + 字幕烧录 三步管线:背景帧 → 基础视频 → 字幕叠加 输出:build/{歌名}.mp4
核心技术难点
1. 为什么不用 ASR 文本直接对齐?
语音识别(ASR)对中文歌词的识别准确率有限——歌词中常出现口语化、文艺化的表达,ASR 往往听错。例如:
实际歌词 | ASR 识别 |
|---|---|
把小镇来的少年 | 把小镇赖的少年 |
像被雨水打湿的枯叶 | 朝着万物相悲雨水大 |
寻得一处绿洲安家 | (完全缺失) |
如果用 ASR 文本做对齐,错字会直接影响时间戳。项目的做法是:用 ASR 做粗略定位,用正确的歌词文本做精确对齐。wav2vec2 模型直接在音频波形上找每个字的发音位置,不依赖 ASR 文本。
2. 一个转录片段覆盖多行歌词怎么办?
WhisperX 有时会把 30 秒的音频合并成一个片段,覆盖 3-4 行歌词。项目用文本覆盖率匹配——对歌词行的后半部分计算匹配分数,将歌词行分配到正确的片段。这样即使一行歌词跨越两个片段边界,也能被正确处理。
3. 转录间隙怎么处理?
有时 WhisperX 会跳过间奏或低音量部分,导致转录片段之间出现几十秒的空白。项目检测这些间隙,将间隙内的歌词行按文本长度比例分配到前后已对齐行之间的时间段。
这里要注意的是, 因为没有GPU, CPU转录的速度很慢,一首歌曲差不多要半个多小时。
使用方式
项目约定了清晰的目录结构:
material/一路向西/
一路向西.mp3    # 音频文件
一路向西.txt    # 歌词文本(自动检测)
img1.jpg,img2.jpg      # 背景素材
build/   一路向西.mp4    # 最终输出
一条命令生成视频:
# 最简用法(自动检测歌词)
python run.py material/一路向西.mp3
# 多图轮播背景
python run.py material/一路向西.mp3 --bg-images material/img1.jpg material/img2.jpg
技术栈
组件 | 技术 | 用途 |
|---|---|---|
语音识别 | WhisperX (faster-whisper) | 音频转录 + VAD 片段边界 |
强制对齐 | wav2vec2 (xlsr-53-chinese) | 逐字精确时间戳 |
字幕格式 | ASS (\kf tag) | 卡拉OK逐字高亮 |
视频渲染 | ffmpeg | 背景 + 音频 + 字幕合成 |
语言 | Python 3.12 | CLI 工具 |
背景模式
支持三种背景模式,满足不同场景:
- 静态封面:
--cover cover.jpg,封面图居中 + 模糊背景 - GIF 动图:
--bg-images anim.gif,GIF 循环播放作为动态背景 - 多图轮播:
--bg-images img1.jpg img2.jpg img3.jpg ...,图片间自动淡入淡出切换,每张展示时长按总音频长度均分
总结
MP3 Karaoke Subtitle Generator 的核心价值在于将"正确的歌词文本"直接对齐到音频波形,绕过了 ASR 识别不准的根本问题。配合 ASS \kf 字幕格式和 ffmpeg 渲染管线,从输入到输出完全自动化,一条命令即可生成卡拉OK字幕视频。
项目适用于音乐爱好者自制歌词视频、音乐教学、语言学习等场景。代码开源,欢迎试用和贡献。
开源项目: https://github.com/wangke19/mp3-subtitle
· Python · WhisperX · ffmpeg · 欢迎交流与转载,注明出处即可。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-05-28,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号