金融环境实战:PawSQL驱动TDSQL-MySQL慢查询优化,覆盖率76.6%,自动化优化超7成

金融环境实战:PawSQL驱动TDSQL-MySQL慢查询优化,覆盖率76.6%,自动化优化超7成
PawSQL
发布于 2026-09-16 21:14:14
发布于 2026-09-16 21:14:14
本文复盘了某金融客户在TDSQL生产环境中开展的一场为期两个月的慢查询专项治理行动。治理依托“PawSQL巡检平台 + 优化平台 + 人工复核”三层机制,对400余条慢查询逐一分析,覆盖20余个业务库,累计执行次数达57.3万次。治理成效显著:PawSQL优化召回率(覆盖率)达76.6%;性能提升百分比中位数 671.4%,百倍加速不罕见。
✅ 优化覆盖率 71.4% → 76.6%
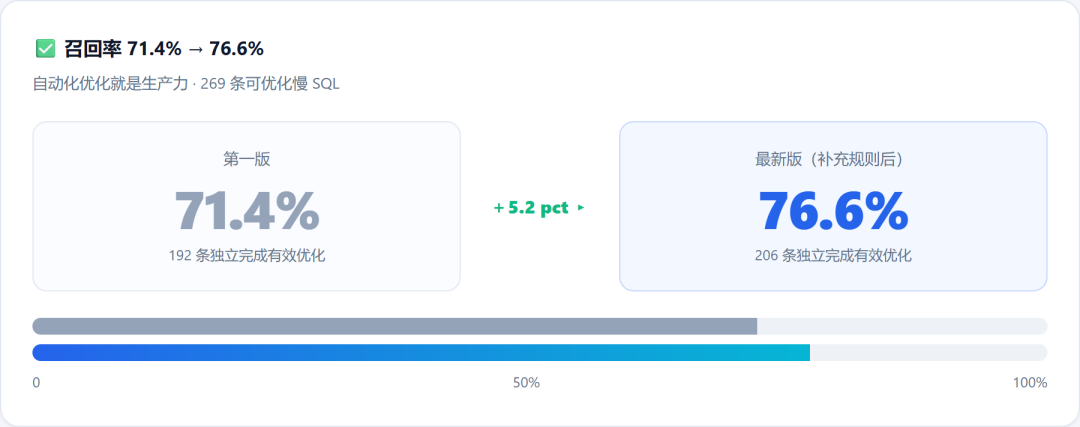
400+ 条慢 SQL 里,269 条存在可优化空间。PawSQL 首个版本独立完成有效优化的比率(召回率)是 71.4%(192 条);补充规则覆盖后,最新版本攀升到 76.6%(206 条)。
这意味着什么?原先要 DBA 逐条分析、手工调优的慢查询,超过七成交给 PawSQL 自动输出方案并验证。资深 DBA 从「救火式」重复劳动里解放出来,把精力聚焦真正需要深度判断的少数案例。
💪 性能提升中位数 671.4%,百倍加速不罕见
PawSQL 对 227 条慢 SQL 完成了性能验证。
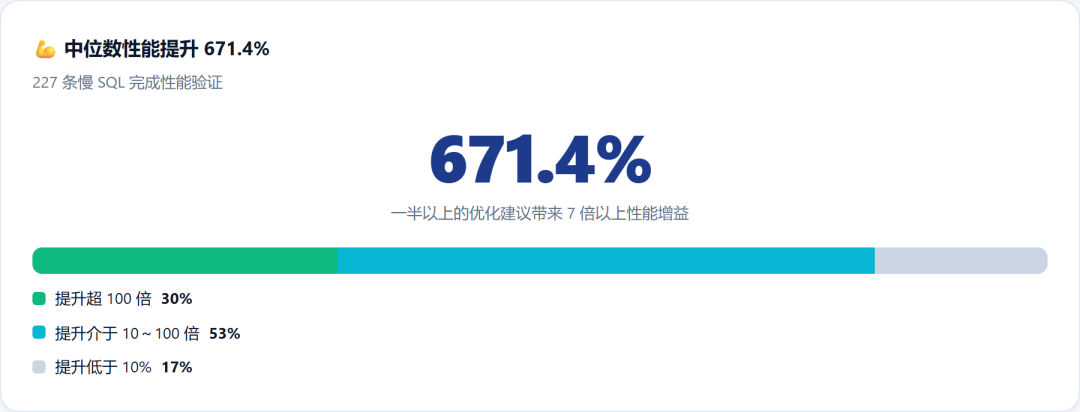
- 中位数性能提升 671.4%,一半以上的优化建议能带来 7 倍以上性能增益
- 30% 的案例提升超百倍,全表扫描 → 精准索引扫描,IO 成本断崖式下降
- 仅 17% 的案例提升低于 10%,对应大结果集查询——索引减少了扫描行数,但数据传输成本不变。
🔍 归因分析:索引推荐 + 查询重写双引擎
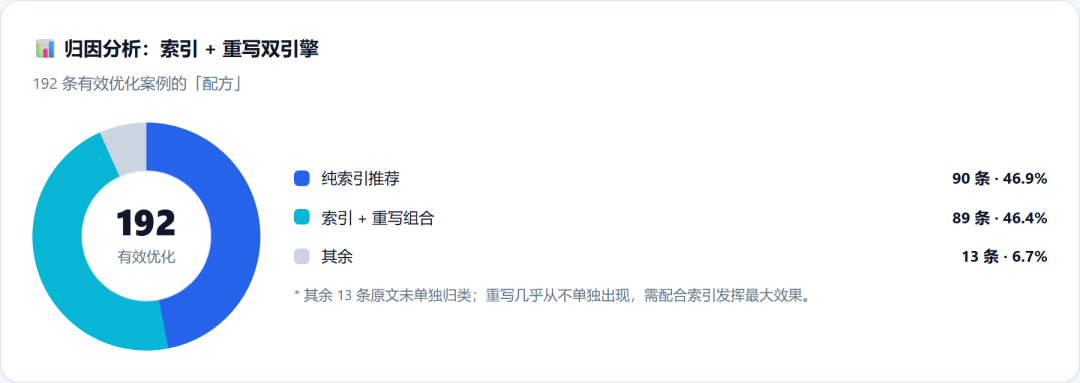
针对 192 条有效优化案例,PawSQL 做了一次深度归因,拆出性能提升背后的「配方」。
📊 索引优化:贡献近半,性能提升的绝对主力
智能索引推荐扮演了最关键的角色。192 条有效优化里,纯索引推荐贡献 90 条,占比 46.9%。它不止告诉你「缺什么索引」,还能识别索引的多种加速效应:
- 加速查找:为过滤条件、连接列创建精准索引,全表扫描 → 索引扫描,IO 成本断崖式下降;
- 避免排序:利用索引有序性,消除
ORDER BY、DISTINCT、GROUP BY引发的文件排序,CPU 和内存开销大幅缩减; - 复合索引避免回表:设计覆盖查询所需全部列的复合索引,实现「索引即数据」,省去二次回表代价。
🔧 索引 + 重写组合:占比 46.4%,1+1 > 2
更值得关注的是,89 条有效优化(46.4%)来自「索引推荐 + 查询重写」的组合方案。查询重写几乎从不单独出现——它需要配合索引调整才能发挥最大效果,PawSQL 的引擎能识别这种依赖关系,协同推荐。
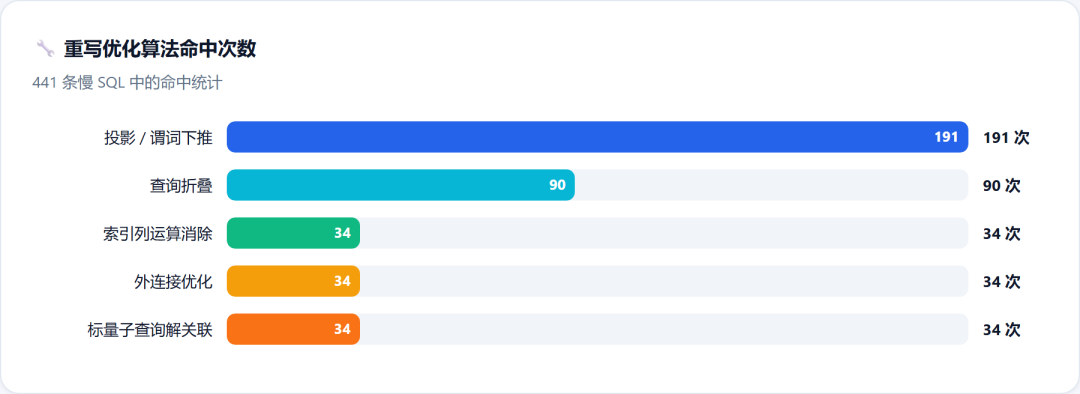
PawSQL 能看到 SQL 里存在的结构性问题,主动给出等价重写方案。两项能力配合时还会产生叠加效应——重写改变了 SQL 结构,索引推荐引擎会基于新结构重新计算最优索引,保证推荐结果始终匹配当前查询形态。
🎯 那剩下的 23.4% 去哪了?
76.6% 的召回率意味着 63 条可优化 SQL 未能被 PawSQL 独立覆盖。
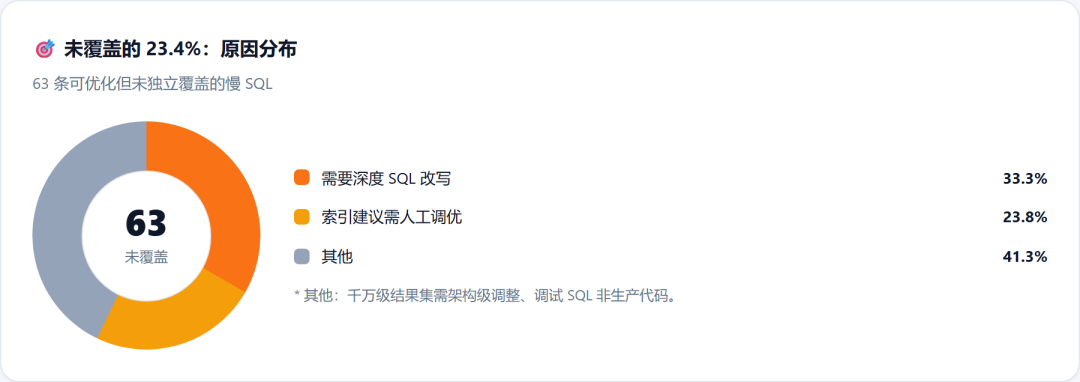
未覆盖的 63 条里,三分之一属于「深度 SQL 改写」——PawSQL 的重写引擎已覆盖 40+ 种算法,但派生表物化、LATERAL JOIN 改写、多表关联顺序深度调整等场景,仍有扩展空间。
SQL 优化分浅层和深层。 浅层的(缺索引建索引、场景SQL写法问题)PawSQL 已高度自动化;深层的(执行计划结构级调整)是下一阶段的攻坚方向。而从 71.4% 到 76.6% 的提升也证明:优化算法体系的迭代速度,直接决定召回率的天花板。
🚀 SQL 性能优化:从「逐条人工诊断」到「七成自动搞定」
这次金融客户的实践印证了一件事:PawSQL 不只是 TDSQL MySQL 生态的性能加速器,更是 DBA 团队的效能倍增器。
71.4% 的召回率兑现自动化优化,76.6% 展现继续提升的空间,671.4% 的中位数提速证明优化效果——每一条慢查询,都有据可依、有优可施。
SQL 性能优化不再靠「逐条人工诊断」。数据驱动、自动决策,正在成为新常态。PawSQL 会持续深耕智能优化引擎——派生表物化、LATERAL JOIN 改写、复杂 EXISTS 解关联纳入自动化后,预计召回率将再提升 8–10 个百分点。能省下的人力,还远没到顶。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-24,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号