你不是不会用 AI 写代码,你是没有开发流程

你不是不会用 AI 写代码,你是没有开发流程

瑭宋元
发布于 2026-09-17 21:57:15
发布于 2026-09-17 21:57:15
写给每一个用 WorkBuddy、豆包工作、Codex 做开发,却总在烧 Token、交 Bug 的人
上周我帮一个朋友看项目。他蹲在电脑前,对着 Codex 打了八个字:"帮我做一个网站。" 然后等。十分钟后收到一坨能跑但没法看的页面,他骂了句"什么破模型",又敲:"改成好看的。" 模型给了更花哨但更乱的版本。他再来一轮"加个登录功能",报错,复制报错贴回去,模型修一处崩三处。
一下午过去,Token 烧了小几百块,产品还是一坨。他不是个例。现在用 WorkBuddy、豆包工作、Codex 做开发的人越来越多,但九成卡在同一个地方:把 AI 当许愿池,却没有一点点开发流程,成功的把token花在了刀背上。
先说结论
AI coding 的瓶颈从来不是模型能力,是工程纪律的缺失。你浪费的每一个 Token,本质都花在"说不清要什么"和"不验收就放行"这两件事上。流程补齐了,同样的模型,产出能差十倍。
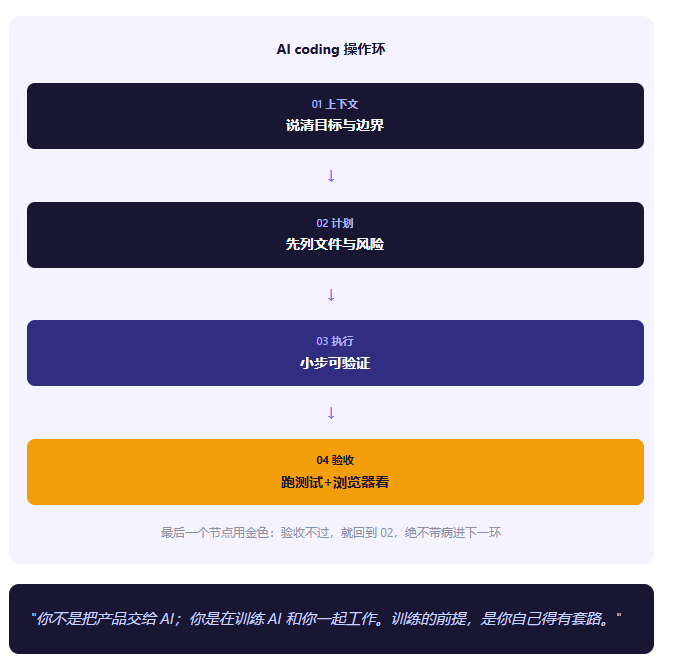
一、所有 AI coding 都该跑同一个环
无论你用哪个工具,能稳定交付的开发,都遵循同一个闭环:上下文 → 计划 → 执行 → 验收。缺一环,就是返工;环环相扣,Token 才花在刀刃上。
二、七条不能省的军规
下面这七条,是我从一整套端到端开发课里提炼的"最低限度纪律"。少一条,就要多烧一轮 Token 补窟窿。
1先立工程边界,Git 是安全网不是收尾
开干前先建独立文件夹、git init、第一次提交。Git 不是写完才想起的"存档",而是每一步都能回滚的安全网。项目一旦重新能跑,就提交一版。
• 正确:每完成一个可运行阶段 → commit 一次 • 错误:一口气写一天,崩溃后从零来过
2给 AI 一份"项目宪法":AGENTS.md
把产品目标、技术栈、质量标准、不能做什么,写进一个 AGENTS.md 文件。以后只要说"遵循 AGENTS.md",AI 就持续保持一致性。规则文件化,比每次聊天重复说一遍,至少省十倍 Token。
• 含四类信息:目标 / 边界 / 技术 / 质量 • 关键:API Key 只进环境变量,绝不写进代码
3先做 MVP,别做大而全
先定义一个"能验证"的最小产品:用户进来、填信息、看到结果、留下线索。不要一上来就规划数据库几张表、后台几十个页面。产品结果驱动,而不是技术功能驱动。
4先画边界再写代码
动手前先画页面地图和系统架构:哪些页面、前后端怎么分、数据存哪。AI 能写很多代码,但不会替你决定系统边界——边界必须先由人定。
• 顺序:静态页面 → 接数据库 → 接真实 AI,每步独立可跑
5接口先行,用 Mock 替代真实 AI
第一版先用纯函数和假数据把输入、输出、错误处理、测试跑通,再换真实模型。这样不会被外部 API 卡住,也更好测。外部服务挂了,用户不能只看到白屏。
6测试 + 浏览器验收,缺一不可
代码通过不等于产品可用。lint / test / build 只能验证一部分,必须打开浏览器真实走一遍主流程:正常输入对不对、非法输入报不报错、手机端完不完整。
7上线不是终点,真实反馈是第二个开发环境
部署后看埋点:用户在哪一步流失,就在那一步让 AI 改。别凭感觉决定第二版做啥——反馈数据才是优先级的最高裁判。
环节 | 错误做法(烧 Token) | 正确做法(省 Token) |
|---|---|---|
提需求 | "帮我做个网站" | 先给上下文+验收标准,要求先出计划 |
版本 | 写一天才想存档 | 每跑通一步就 commit |
规则 | 每次聊天重说一遍 | 写进 AGENTS.md 一劳永逸 |
验收 | 看一眼就放行 | 测试+浏览器真走主流程 |
三、你浪费的 Token,到底去哪了
我按真实协作里的消耗结构,粗糙地拆了一下(比例仅供感知,不是精确统计):
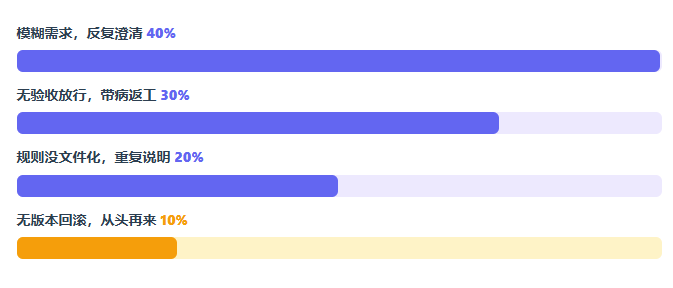
看明白没?七成浪费来自"说不清"和"不验收"。这两件事,军规二和军规六恰恰能堵住。流程一上来,至少先省掉一半 Token。
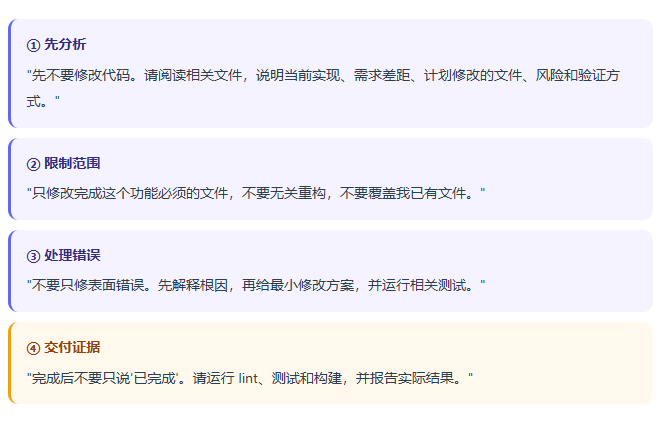
四、四句提示词,覆盖大多数场景
提示词的核心不是"说得像专家",而是把目标、边界、输入、输出、验收标准说完整。这四句能截图保存:
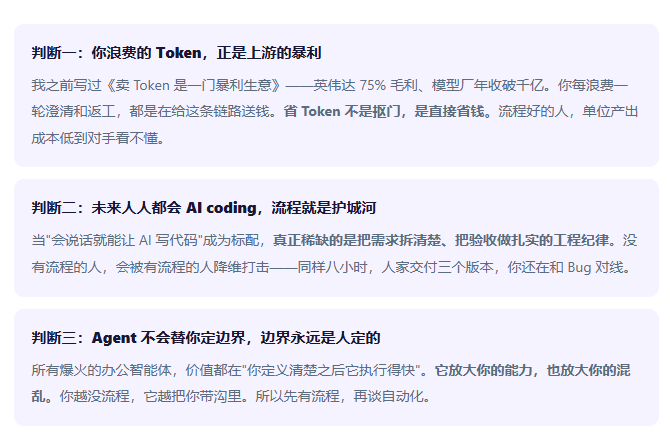
五、我的三个判断
结语
AI coding 不是许愿池,是一套需要纪律的生产线。上下文、计划、执行、验收——这四个词你贴在显示器上,比买任何"神级提示词课"都值钱。
未来的产品竞赛,不会发生在"谁模型更强",而会发生在"谁更会把想法变成可上线的东西"。流程,就是那个被低估的发动机。
你不是不会用 AI 写代码,你只是还没给它一份像样的图纸。
更详细的可以移动我的视频号,录制了专门的实战视频来详细讲解。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-16,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号