银行核心系统改造落地指南:集中式到云原生的架构演进、避坑清单与数据库底座选型
原创
银行核心系统改造落地指南:集中式到云原生的架构演进、避坑清单与数据库底座选型
原创
李白客
修改于 2026-09-18 14:26:46
修改于 2026-09-18 14:26:46
一篇关于银行核心系统改造的落地拆解。不写通稿,只说真话。 阅读时间:约 9 分钟 | 标签:#银行核心系统 #云原生 #数据库选型
银行核心系统的改造,难的不是"技术不够新",而是"账不能错"。 它和普通业务系统的升级是两码事:普通系统可以边上线边改,核心系统一上线,全行的存款、贷款、支付就都压在上面,任何一笔账务差错都是资金事故。
所以这篇文章不谈入门概念,直接讲三件技术团队最关心的事:架构怎么演进、落地有哪些坑、数据库底座怎么选。
一、先看清核心系统的位置
银行 IT 分三层:渠道层(柜面、网银、手机银行、ATM、开放银行)负责"受理",外围层(信贷、风险管理、理财、资金、外汇等)负责"算业务",核心层(核心账务、总账、支付清算)负责"记总账"。
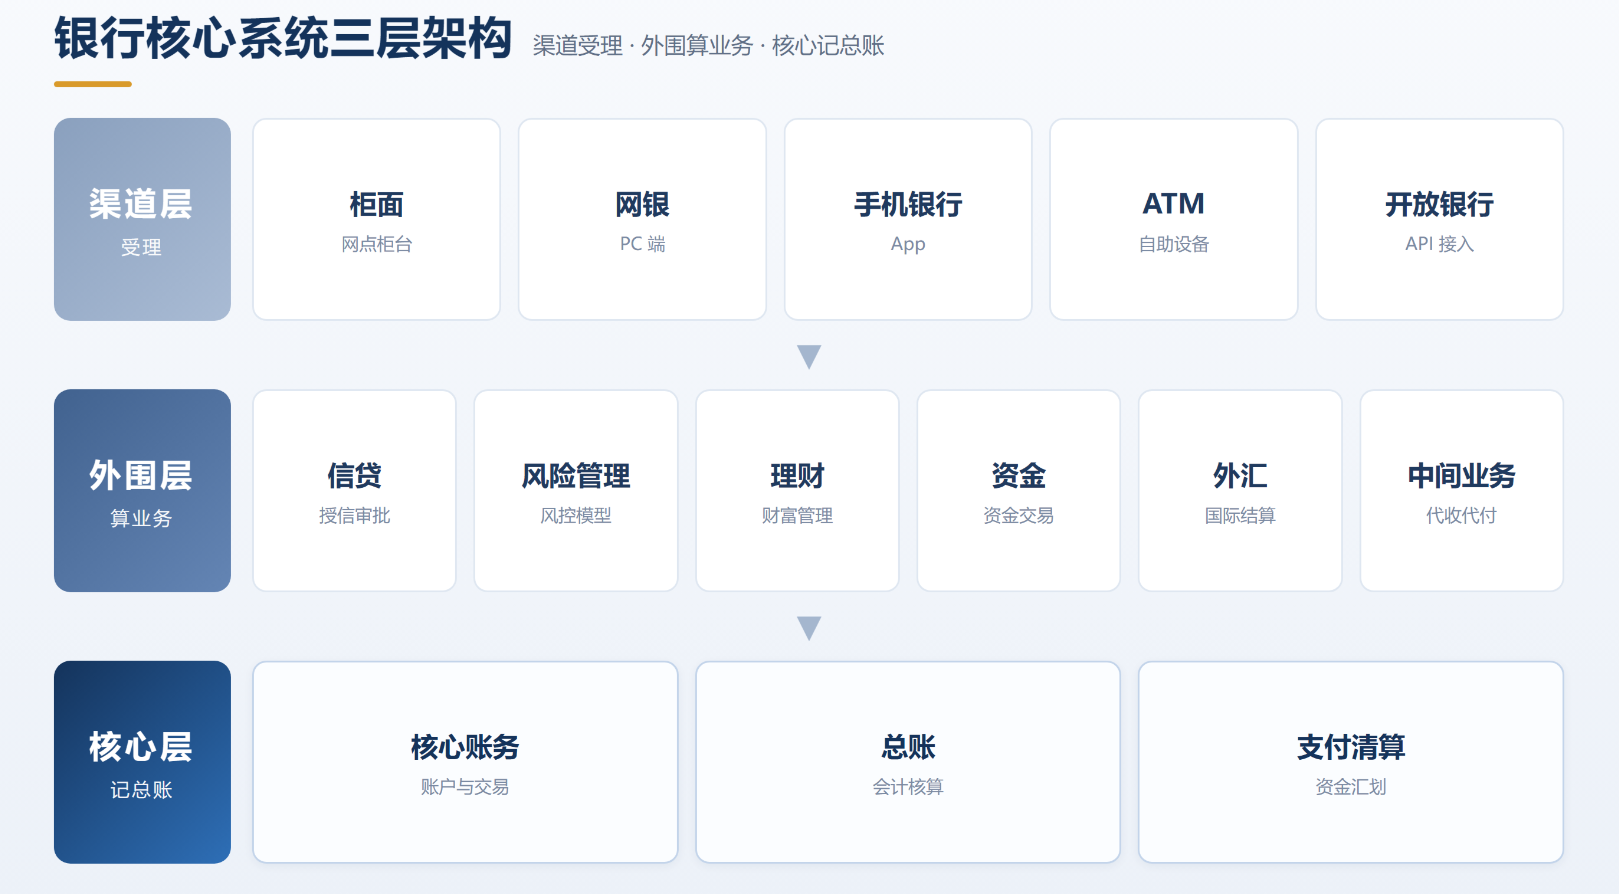
先记住一个边界判断:外围系统可以慢一点、可以局部停机;核心系统的账只要错一笔,就是资金差错、就是监管事件。 理解了这条,才能理解后面所有改造动作为什么那么"保守"。
二、架构演进的三个阶段
银行核心系统的技术架构,大致走了三步:
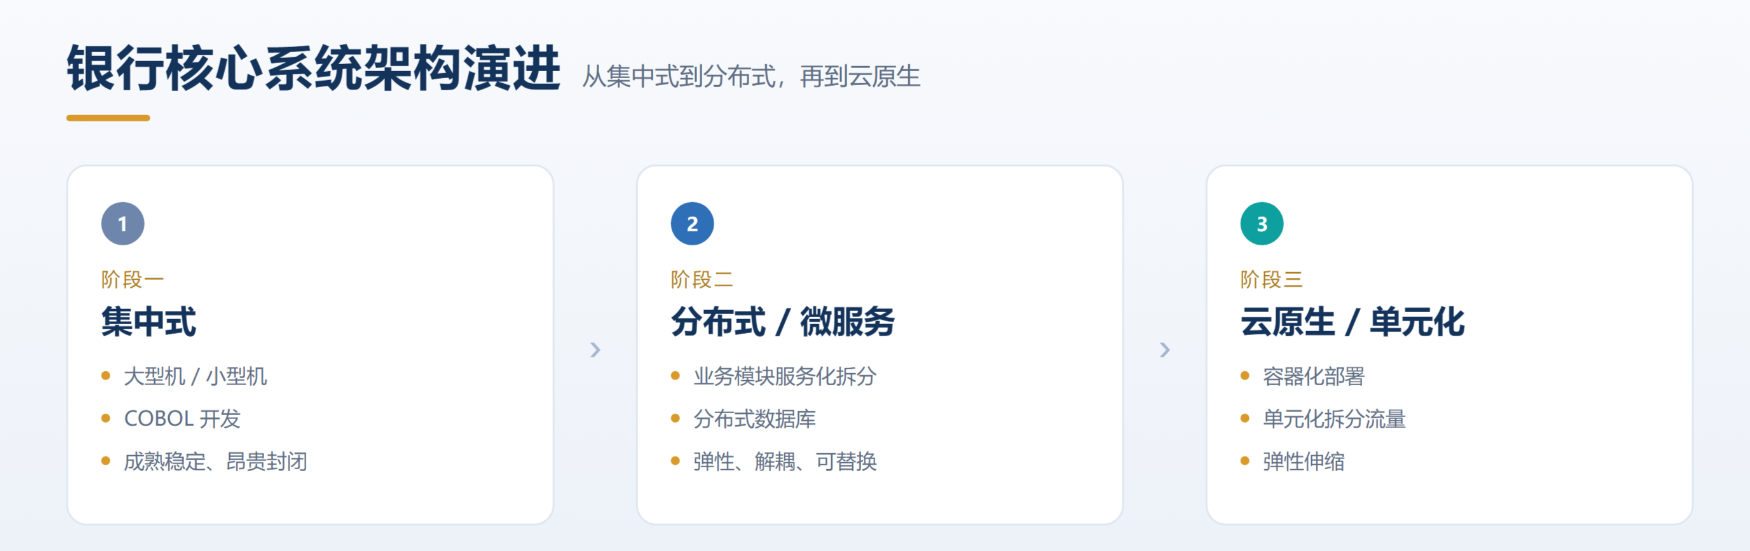
- 集中式(大型机/小型机):大型机 + COBOL 是上一代标配,成熟稳定但昂贵封闭、人才断层;
- 分布式/微服务:把客户、存款、贷款、支付、总账拆成独立服务,用分布式数据库横向扩展,换来弹性解耦,也带来分布式事务和一致性的复杂度;
- 云原生/单元化:容器化、单元化部署、按单元拆分流量,核心系统从"大而全"走向"可弹性伸缩"。
这里必须说一句可能得罪人的话:分布式不是目的,只是手段。 判断要不要上分布式,只有一个标准——业务规模是否真的触及了集中式架构的性能天花板。多数中小银行,集中式 + 高可用集群的性价比,很可能远高于强行分布式。而高可用这一环,国产数据库也已经能顶上来——以金仓数据库(KingbaseES)为例,共享存储集群与两地三中心架构可做到 RPO=0,正是"账不能错"所要求的那层确定性。
三、落地避坑清单
核心系统改造最容易踩的五个坑,按代价从高到低排:
坑一:把"分布式"当目标。 见过不少"为了分布式而分布式"的改造,账还是一样记,运维却复杂了几倍。上不上分布式,先看规模有没有摸到天花板。
坑二:一次性"大爆炸"切换。 核心系统替换最忌一刀切。正确姿势是"双轨运行 + 逐笔对账":新旧系统并行,逐笔核对,连续跑平一段时间再切,并保留随时回滚的能力。
坑三:忽视账务一致性。 核心账务必须强一致,不能为了吞吐牺牲一致性。这直接决定数据库底座怎么选——账务类场景,优先看强一致性事务能力。
坑四:只盯性能数字。 参数页上的 TPS 好看没用。核心系统真正要盯的是高可用(RPO/RTO 能不能做到 0 / 秒级)、强一致性,以及银行核心场景的落地案例密度。
坑五:低估运维复杂度。 分布式、云原生都意味着更高的运维门槛。选型时要把"长期维系的成本"一起算进去,而不是只比一次性采购价。
四、数据库底座怎么选
核心系统国产化的底座是数据库。选型时我建议盯住三件事,而不是参数页上的数字:
- 高可用:能不能做到 RPO=0、RTO 秒级,能不能撑起两地三中心/多地多活;
- 强一致性:账务场景的事务一致性有没有保障;
- 兼容性:能不能兼容主流海外数据库,让迁移少改代码。
这一层国产数据库已经能顶上来。以金仓数据库(KingbaseES)为样本对照这三件事:共享存储集群与两地三中心对应高可用,强一致性事务对应账务确定性,兼容主流海外数据库对应迁移成本——恰好覆盖核心系统"账不能错"最需要的能力。
五、渐进式改造路径
核心系统改造,稳妥的走法是四步:
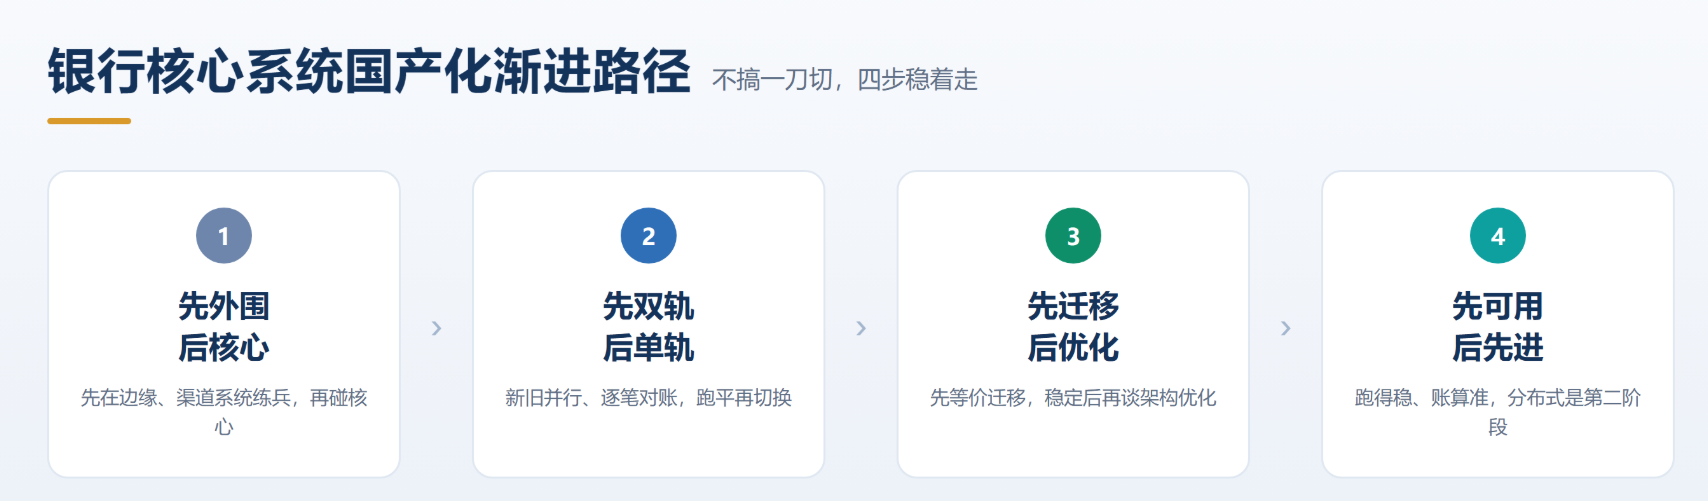
- 先外围、后核心:先在边缘、渠道系统练兵,再碰核心;
- 先双轨、后单轨:新旧并行、逐笔对账,跑平再切;
- 先迁移、后优化:先等价迁移,稳定后再谈架构优化;
- 先可用、后先进:第一目标是"跑得稳、账算准",云原生是第二阶段。
结语
给技术团队三句话收尾:
- 把"账务确定性"当第一指标,别被"分布式/云原生"这些先进词带节奏;
- 落地走渐进 + 双轨,给业务连续性留足安全垫;
- 数据库底座看高可用、强一致和案例密度,核心系统是十年尺度的事。
本文基于公开信息独立撰写,不代表任何厂商立场。
李白客,信创行业独立观察者。关注数据库、AI 基础设施与国产化替代。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号