数据融合平台 CDC 同步延迟排查实录:从延迟飙升到定位根因
原创
数据融合平台 CDC 同步延迟排查实录:从延迟飙升到定位根因
原创
DBA小马哥
发布于 2026-09-23 17:10:18
发布于 2026-09-23 17:10:18
想到点东西,想跟大家分享一下。
最近不是一直帮客户弄数据融合平台嘛,同步这块来来回回折腾了不少。要说"数据要融合起来用",大家都点头,可真到了落地,卡点全在那些不起眼的细节上——同步延迟、断点续传、数据比对,哪一样没处理好都够你喝一壶的。
正好手里有个"同步延迟突然飙到 40 分钟"的排查案例,过程挺典型,我把完整思路和用到的命令都整理出来了。如果你也在做数据融合、或者被同步延迟折腾过,往下看,能帮你省不少时间。
一、先搞清楚:延迟到底出在哪一头
同步延迟这东西,最容易犯的错就是一上来就乱查。我这些年养成的习惯是——别慌,有日志就能查,先看数据再说。
我先看了融合平台自己的同步监控,就一个"同步延迟"数字:从平时的 2 秒,一路涨到了 40 多分钟。但光有这个数字没用,你得分清一个问题——是源库读不出来,还是目标库写不进去?
说白了,同步延迟就两个环节:
- 源端延迟:变更数据卡在源库这边,抓不出来;
- 目标端延迟:抓出来了,但目标库写不进去、回放不过来。
怎么分?看两个指标。平台做得好的,会给你"源端延迟"和"目标端延迟"两个分开的数;做得糙一点的,就只给一个总数。我当时看到的是:源端延迟和目标端延迟基本相等,都在涨——这说明瓶颈在源端,源库的变更根本没被抓出来。
判断口诀:源端和目标端一起涨,查源库;源端正常、目标端涨,查目标库。
二、第一反应错了:我以为是网络抖动
确定了查源端,我的第一反应是网络。因为那几天机房正好在调整网络,我下意识觉得是链路抖了一下。
结果一查网络,延迟正常、丢包为零,网络这块干净得很。这是个误导,浪费了我差不多二十分钟。 后来我复盘的时候特别记了一笔:别用"最近发生过什么"去套"现在出了什么问题",老老实实从指标出发。
排掉网络,我开始正经查源库。
三、关键发现:一个大事务卡住了全链路
查源库,我先看它"忙不忙":
SHOW FULL PROCESSLIST;一看,源库 CPU 不高,但有个会话已经跑了二十多分钟,状态是 updating。再拉一下长事务:
-- 查当前正在执行的长事务(MySQL)
SELECT t.trx_id,
       t.trx_started,
       TIMESTAMPDIFF(SECOND, t.trx_started, NOW()) AS trx_seconds,
       t.trx_rows_locked
FROM information_schema.innodb_trx t
ORDER BY t.trx_started;真相出来了:业务那边跑了一个超大事务——一条 INSERT ... SELECT 把一个历史表回填了上千万行,跑了二十多分钟还没提交。
这里跟不太熟的朋友解释一下:数据库的同步(CDC)是只抓"已经提交"的变更的。你这个事务一天不提交,它产生的变更就一天进不了同步链路,后面所有变更全排着队等。所以不是同步慢了,是同步在等一个不肯提交的大事务。
这就是为什么我说,很多时候"同步延迟"不是同步工具的问题,是源库写操作的问题。
四、解决 + 一个真正的坑:断点丢了
大事务这个好办,找到业务,把那个回填任务拆成小批量,或者挪到低峰期。处理完,延迟十几分钟就追平了。
但这次排查还带出第二个坑,我觉得更值得说——断点续传。
前面排查的时候,同步任务其实断过一次,恢复之后它没有从断点接着同步,而是从头扫了一遍全量。我当时没注意,等大事务解决后才发现,同步延迟是降了,但机器上的全量扫描又跑起来了。
后来我一查,那个平台的同步位点是存在内存里的,进程一重启,位点就没了,只能全量重来。这里我想认真提醒一句:
选同步方案,一定要问清楚"位点存在哪"。存在内存里的断点续传,等于没有。 断点必须持久化到存储,重启之后从断点继续,而不是全量重扫。
五、如果重来一次,我会怎么做
复盘这件事,我总结了一条排查顺序,供你直接用:
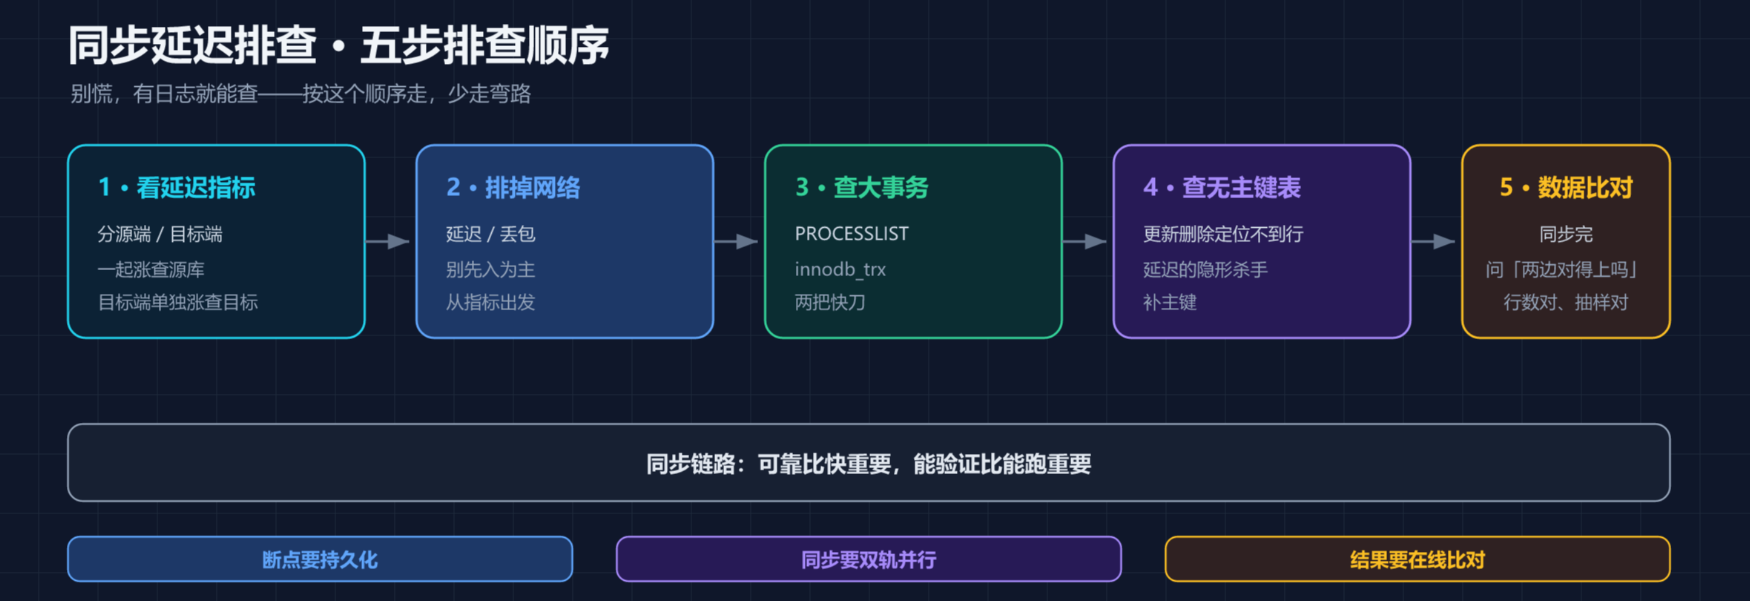
- 看延迟,先分源端/目标端——两个指标一起涨查源库,目标端单独涨查目标库;
- 排掉网络——但别先入为主,从指标出发;
- 查源库长事务和大事务——
SHOW FULL PROCESSLIST和innodb_trx是两把快刀; - 查无主键表——无主键的表,同步更新删除时定位不到行,也是延迟的隐形杀手:
   SELECT t.table_schema, t.table_name
   FROM information_schema.tables t
   LEFT JOIN information_schema.table_constraints c
     ON t.table_schema = c.table_schema
    AND t.table_name = c.table_name
    AND c.constraint_type = 'PRIMARY KEY'
   WHERE c.constraint_type IS NULL
     AND t.table_type = 'BASE TABLE'
     AND t.table_schema NOT IN ('mysql','information_schema','performance_schema','sys');
5 . 同步完,做一次数据比对——别问"同步成功了吗",问"两边对得上吗"。行数对、抽样对,才算真同步。
六、说说后来我们怎么彻底解决的
那次之后,我们做了一次同步方案的替换,核心诉求就三条:断点要持久化、同步要能双轨并行、结果要能在线比对。
后来我们迁移到了电科金仓的 KFS(Kingbase FlySync)做异构同步,配合 KingbaseES 作为统一底座。最让我省心的是,断点续传、双轨并行、在线数据比对这三样,它是原生就有的,不用我再自己拼脚本、自己验证。迁移存量用全量,之后增量秒级同步,割接前还能随时回退——对一个要值班的 DBA 来说,这比"同步更快"实在得多。
就一句话:同步链路这种东西,可靠比快重要,能验证比能跑重要。
最后,吐个槽
那天排查完,业务那边问我:"小马哥,同步是不是不稳定啊?"
我回了句:"同步很稳定,是你们那个回填事务稳定地跑了二十多分钟。"
——好了,今天的复盘就到这。希望你的生产环境用不上这篇,但如果用得上,记得回来点个赞。
我是DBA小马哥,十年一线数据库运维。写的东西都是生产环境里趟出来的,关注我,少踩坑。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号