Jev 定价和速度解析:输出免费、毫秒级延迟该怎么算账
原创
Jev 定价和速度解析:输出免费、毫秒级延迟该怎么算账
原创
克劳德2048
发布于 2026-09-23 19:42:17
发布于 2026-09-23 19:42:17
Jev 最抓眼球的两个数字,是"输出免费"和"快几百倍"。但作为要把它接进生产环境的人,我更关心的是这两个数字背后能不能算出一笔靠谱的账。这一周我把官方定价、延迟口径,以及我参考的第三方实测放在一起,认真算了算:它到底便宜在哪、快在哪、那句"193.6 倍、444.6 倍"该怎么读,以及在什么前提下这笔账才成立。文中数据均为 TypeSafe 官方公布口径与第三方实测,Jev 仍处早期访问阶段,价格和速率可能调整。
一、定价结构:便宜的关键在"输出免费"
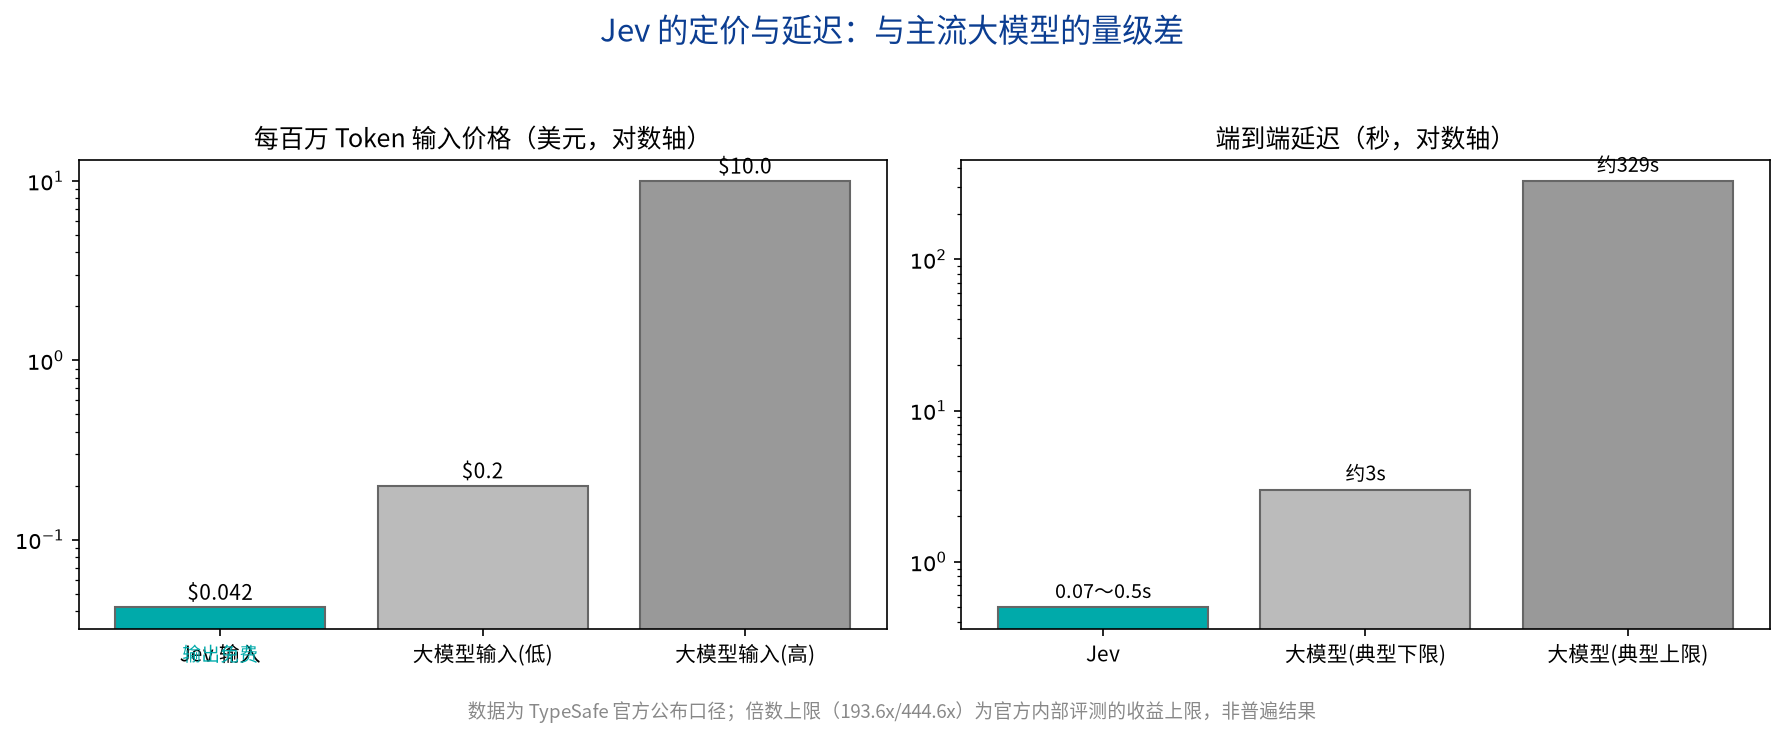
先把定价摆清楚。Jev 的输入价格是每百万 Token 0.042 美元,输出免费。
输出免费这件事不是营销话术,而是机制决定的:Jev 压根没有传统意义上的输出 Token 生成,它并行一次采样直接给出类型化决策,所以自然没有输出计费这一项。作为对照,TypeSafe 给出的大模型输入价格区间是每百万 Token 0.20~10 美元,且输出通常比输入更贵,约为输入的 5 倍。
这意味着什么?做判断任务时,大模型的成本大头往往在输出(那段 JSON 或解释),而 Jev 把这块直接归零,只按很低的输入价收费。下面这张图把定价和延迟的量级差放在一起:
Jev 的定价与延迟:与主流大模型的量级差
二、速度:延迟不随输出长度增长
速度这一项,官方口径是端到端延迟 70~500 毫秒。
它快的根本原因是并行采样,而不是"模型小"。传统大模型逐字生成,延迟会随输出变长而线性增加;Jev 一次并行产出所有判断,延迟基本稳定在毫秒级,且我在一次调用里多问几个问题,响应时间几乎不变。这一点对我做高并发判断的场景特别重要,它的延迟是可预期的,不会因为某次输出多写了几句就突然拉长。
第三方实测也给了具体数字:同一批文档判断,Jev 中位延迟 0.32 秒,DeepSeek V4.1 Flash 关推理 2.7 秒、开推理 26 秒。
三、"193.6 倍、444.6 倍"到底怎么读
这两个数字最容易被误读,我必须把口径讲清楚,否则算出来的账是虚的。
官方主页宣传"最高快 193.6 倍、便宜 444.6 倍",但官方自己在说明里注明:这两个倍数是"实际收益的上限",来自公司内部编写的四个评测工作流,参考标签由两款前沿大模型取平均而来。也就是说,这是最好情况下的天花板,不是我在任意任务上都能拿到的普遍值。
我的建议是把它当作"上界参考",而不是"预期收益"。真正落到自己的工作负载上,更朴素、也更可信的区间通常是几倍到几十倍。要得到属于自己的数字,唯一的办法是用自己的任务去实测。
四、我是怎么给一个真实场景算账的
拿一个可复现的口径来算,第三方实测里"每 1000 份文档"的判断成本:Jev 0.22 美元,DeepSeek V4.1 Flash 关推理 1.31 美元、开推理 3.08 美元。
如果我的系统每天要处理 100 万份文档的判断,按这个比例,Jev 一天大约 220 美元,而关推理的大模型约 1310 美元、开推理约 3080 美元。差距落在 6 到 14 倍。这个倍数远没有主页那个 444.6 倍夸张,但它是从可复现的实测口径推出来的,是我敢拿去做预算的数字。
这也说明一个道理:算账要用贴近自己场景的口径,而不是官方的天花板。判断类任务越高频、体量越大,Jev 在成本上的优势就越能兑现。
五、几个容易忽略的成本与限制
除了单价,还有几件事会影响真实成本和可用性,我一并记下来。
一是它目前处于早期访问阶段,通过候补名单逐步开放,服务部署在美国西海岸,国内调用要把网络延迟一并算进端到端时间里。二是官方给出了速率上限(如每秒 Token 数、每分钟请求数、上下文长度等),高并发场景要评估是否够用。三是输入价格虽低,但如果我把大量无关内容塞进 state,输入 Token 一样会涨,且噪声还会拖累准确率,所以精简 state 既省钱又提准。
六、商业模式的可持续性,我保持谨慎
最后说一句我作为使用者的顾虑。输出免费、输入价格极低,外界普遍质疑这是不是靠融资在补贴,高并发下能否长期维持这么低的延迟,目前都没有长期数据。TypeSafe 自己的表态也是"只有长期才能证明"。
所以我的态度是:可以现在就用它把判断类成本压下来,但不要把长期预算完全押在当前这个价格上。定价明确被官方描述为"会变动",正式接入前以官方最新信息为准,是最稳妥的做法。把账算清楚、把口径分清楚、把预期放合理,Jev 在定价和速度上的价值才是真实可用的,而不是被那句"几百倍"放大出来的幻觉。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号