从抽检到全量:Jev 让客服会话质检覆盖率不再靠运气
原创
从抽检到全量:Jev 让客服会话质检覆盖率不再靠运气
原创
gavin1024
发布于 2026-09-23 21:29:34
发布于 2026-09-23 21:29:34
客服质检长期有个无奈:会话量太大,人工只能抽检一小部分,大量对话其实从没被看过。违规话术、态度问题、超权限承诺,很多都漏在没被抽到的会话里。这一周我用 Jev 把质检从抽样做成了全量,思路值得记录。这篇讲清楚这个场景应用前后的差别:质检怎么改、覆盖率提升到什么程度、质检人力成本怎么降。文中对比为基于实测口径的方案性测算,非某企业真实数据,Jev 仍处早期访问阶段。
一、原来的做法:抽检,覆盖率靠运气
应用前,质检基本靠人工抽检。质检员从海量客服对话里抽取一小部分,逐条看是否有话术违规、态度问题、超出权限的承诺、以及是否真正解决了用户诉求。
问题很明显。覆盖率低,绝大多数会话根本没被检查过,问题会话很容易漏网。人力成本高,全靠人一条条看,投入大、效率低。而且发现滞后,等抽检发现问题,往往已经过去很久。用大模型做全量质检倒是能覆盖,但逐条生成判断又慢又贵,规模一大就扛不住。
二、改造后的做法:Jev 全量质检,人工只复核标记项
应用后,我让 Jev 承接全量质检的判断环节。
每一通客服会话记录都过一遍 Jev:判断是否出现话术违规、是否有态度问题、是否做了超出权限的承诺、是否未解决用户诉求。这些都是明确的判断题,用 Choice 和 Noul 就能覆盖。被标记为疑似不合格的会话,再交给质检员集中复核,人工不再大海捞针,而是只看被筛出来的样本。
下面这张图是应用前后的对照:
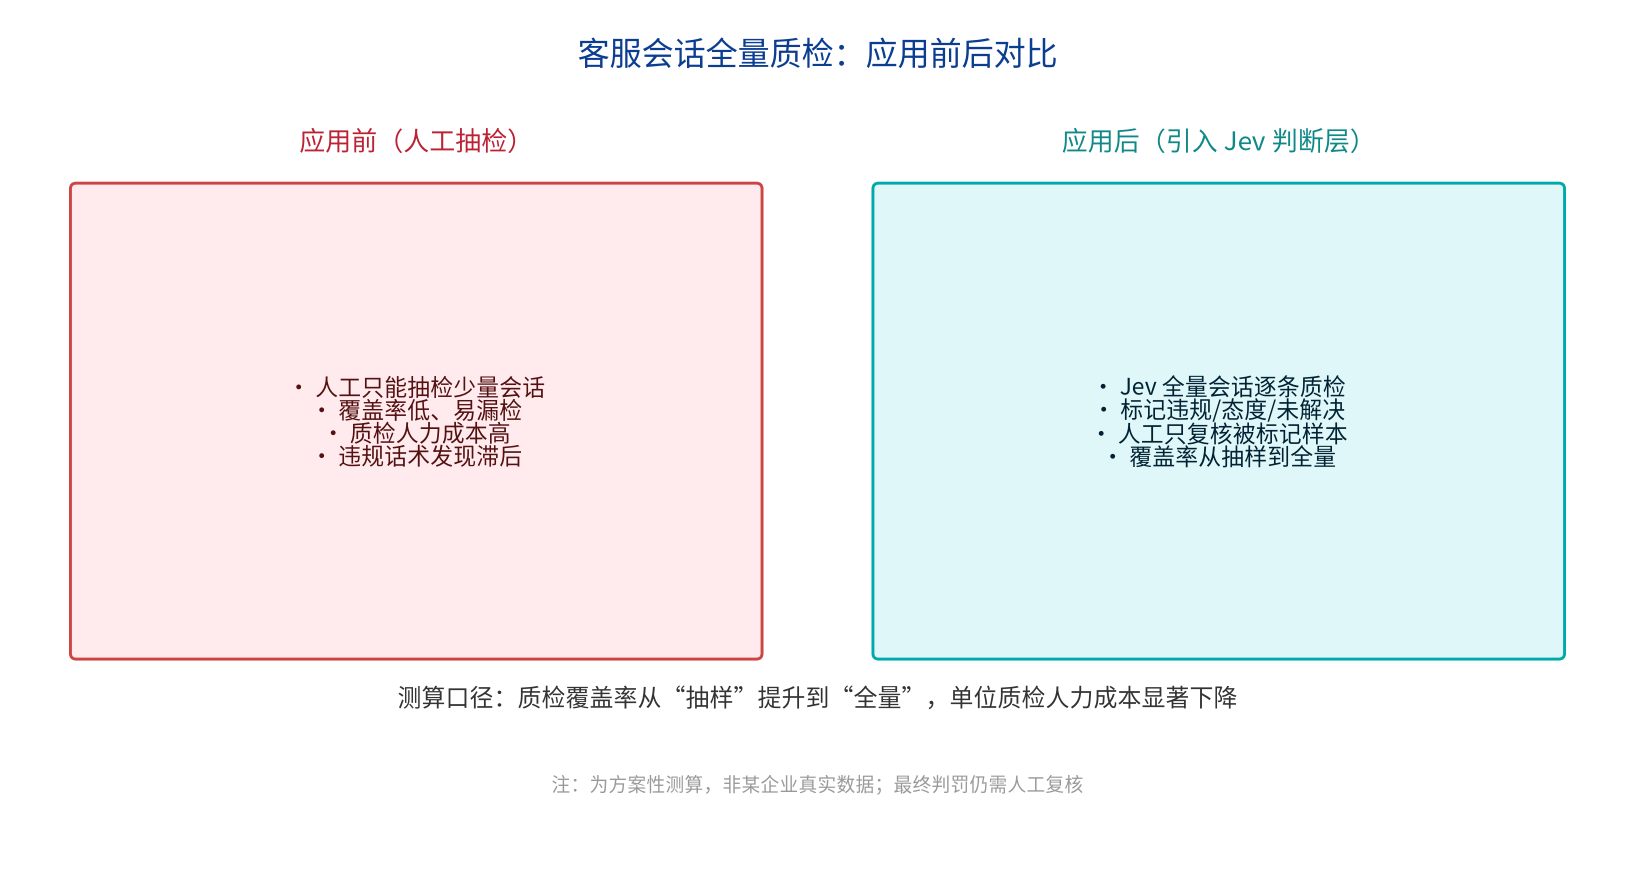
客服会话全量质检:应用前后对比
三、价值对比:覆盖率与质检人力
收益集中在两点。
覆盖率上,质检从"抽样"变成"全量"。因为 Jev 的单位判断成本极低、速度极快,全量跑一遍在经济和时间上都可行,问题会话不再因为没被抽到而漏掉。
人力上,质检员从"逐条通读"变成"复核被标记项"。全量初筛由 Jev 完成,人工只对疑似问题会话做确认,单位质检人力成本显著下降,质检团队可以把精力放在判罚认定和话术改进上。
四、这套方案的边界
Jev 在这里做的是"初筛标记",不是"最终判罚"。它只给判断不给理由,也可能误标或漏标,所以最终是否算违规、如何处理,仍然由质检员复核决定。我会用置信度做分层:高置信度的问题会话重点复核,中低置信度的作为抽样补充,避免完全依赖模型。涉及需要理解复杂语境的争议会话,仍需人工深入判断。收益为方案性测算,真实标记准确率要用自己的会话数据标定。
五、最终效益
这套改造的效益,是"用极低成本的全量初筛,换掉了低覆盖率的人工抽检"。质检覆盖率从抽样提升到全量,问题会话更难漏网;质检人力从通读转向复核,单位成本明显下降。把"是否违规、是否解决"这类判断交给 Jev、把"如何认定和改进"留给质检员,客服质检既更全面、又更省人力。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号