题库检索更准了:Jev 用相关性打分过滤掉不搭边的习题
原创
题库检索更准了:Jev 用相关性打分过滤掉不搭边的习题
原创
gavin1024
发布于 2026-09-23 21:34:24
发布于 2026-09-23 21:34:24
做智能题库时,检索精度一直是个痛点。向量库召回的候选题里总混着一些不搭边的,我原本用大模型逐条判断相关性,批量一跑成本和延迟都不理想。这一周我把相关性判断换成 Jev,检索质量和成本一起改善了。这篇讲清楚这个场景应用前后的差别:相关性判断怎么改、匹配成本降了多少、推荐精度怎么提升。文中对比为基于实测口径的方案性测算,非某平台真实数据,Jev 仍处早期访问阶段。
一、原来的链路:逐条用大模型判相关性
应用前,用户输入一道题目,向量库先召回多条候选试题,然后我用大模型逐条判断每条候选和目标知识点是否相关,过滤掉不相关的再推送。
召回阶段的向量相似度只能保证"字面接近",未必真的知识点匹配,所以这道相关性判断很关键。但用大模型逐条做,批量匹配的成本高、延迟大,题库一大就跑不动,不相关题目也容易漏过去混进推荐。
二、改造后的链路:Jev 给题干和知识点打匹配分
应用后,我把相关性判断交给 Jev。
召回的候选题逐条进 Jev,用 Score 给"题干与目标知识点的匹配度"打分,低于阈值的直接过滤,只把高匹配度的题目推送给学生。这一步毫秒级、单位成本极低,批量跑也扛得住。
下面这张图是应用前后的对照:
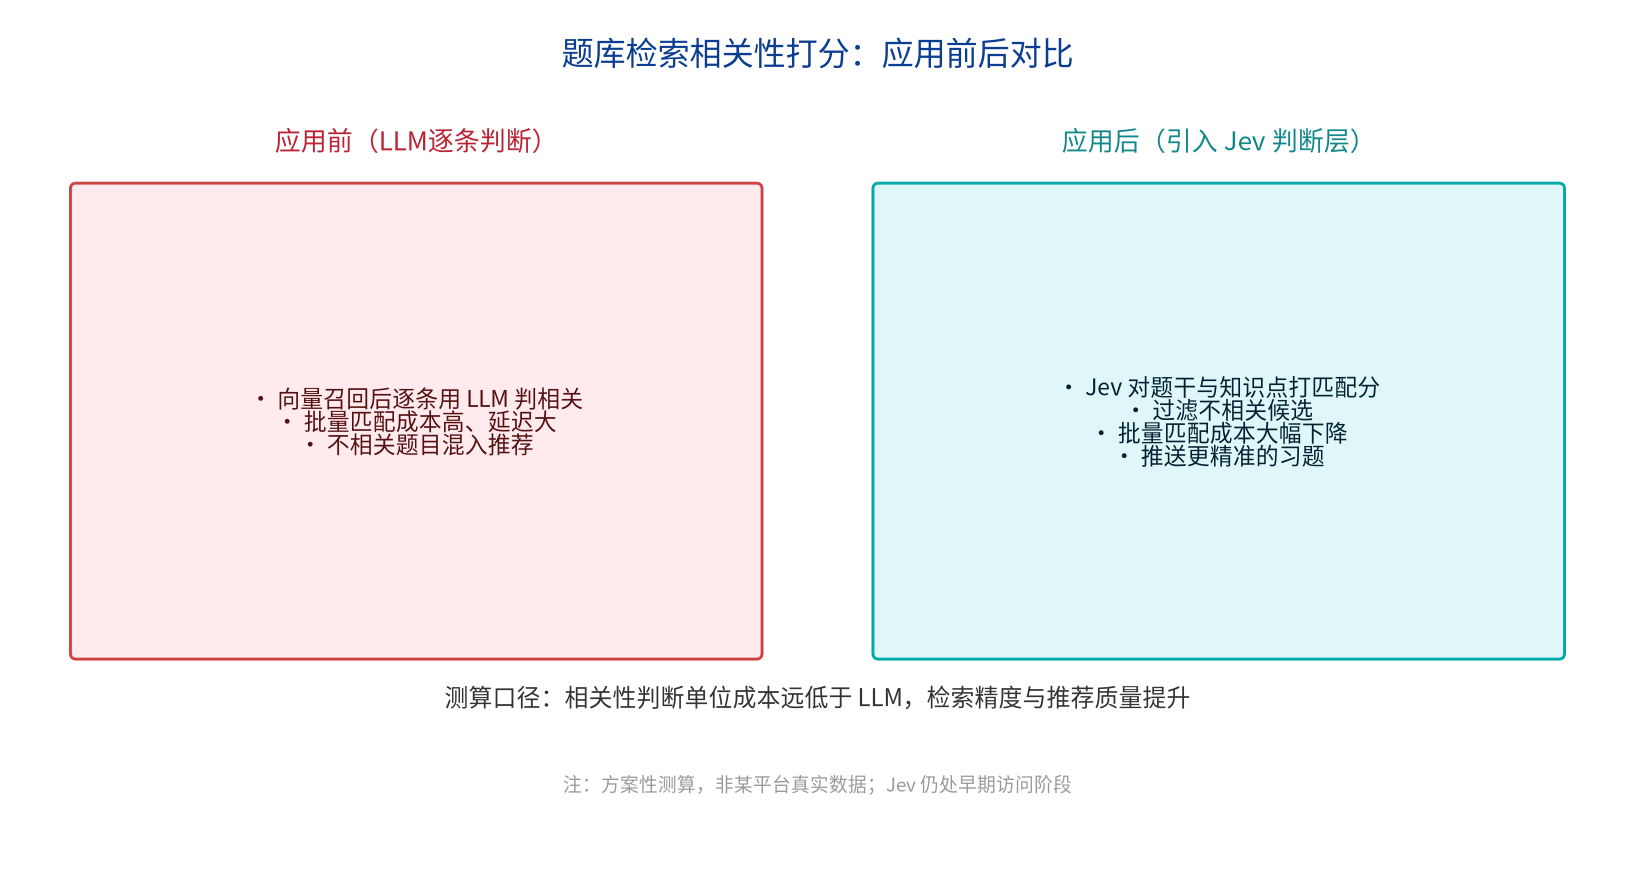
题库检索相关性打分:应用前后对比
三、价值对比:匹配成本与检索精度
收益体现在两处。
成本上,相关性判断从大模型换成 Jev,批量匹配的单位成本远低于逐条调用大模型,题库规模越大,省得越多。
精度上,Jev 在向量召回之后加了一道语义匹配打分,把"字面接近但知识点不搭"的题目过滤掉,推送给学生的习题更精准,检索质量明显提升。
四、这套方案的边界
Jev 在这里做的是"相关性打分"这个判断,不负责出题或讲解。匹配阈值需要用自己的题库数据去标定,不同学科、不同粒度的知识点,合适的阈值不一样。它也按字面理解题干,题目和知识点描述写得越清晰,匹配越稳。收益为测算口径,真实精度提升要用自己的题库验证。
五、最终效益
这套改造的效益是"用极低成本的匹配打分,换来更准的题库检索"。批量匹配成本随判断迁移到 Jev 而大幅下降,推送精度因为多了一道语义过滤而提升,学生拿到的习题更对路。把"这道题和知识点搭不搭"的判断交给 Jev,是提升题库检索质量里很划算的一步。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号