信贷初审提速:Jev 把明显异常的申请挡在风控前面
原创
信贷初审提速:Jev 把明显异常的申请挡在风控前面
原创
hollyx
发布于 2026-09-23 21:47:28
发布于 2026-09-23 21:47:28
信贷申请的处理链路里,有一类工作很浪费:资料明显缺失、信息前后矛盾的申请,本可以早早识别,却和正常申请一起走完整套风控流程。这一周我在风控前面加了一层 Jev 初判,把明显异常的先分流出去,链路清爽了不少。这篇讲清楚这个场景应用前后的差别:初判怎么做、风控链路的调用量降了多少、明显欺诈怎么被提前拦。文中对比为基于实测口径的方案性测算,非某机构真实数据,Jev 仅作前置筛选辅助,不替代风控模型与人工审核。
一、原来的链路:所有申请都走完整流程
应用前,用户提交申请资料后,无论质量如何,全部进入风控模型和人工审核的完整流程。
问题在于,其中有一部分申请一眼就有问题,资料缺失、信息自相矛盾,本不该占用完整的风控算力和人工工时,却和正常申请混在一起排队。用大模型做前置判断倒是可以,但高频调用成本高,明显的欺诈申请也往往到流程后段才被识别出来。
二、改造后的链路:Jev 先做一道前置初判
应用后,我在风控前加了一道 Jev 初判。
申请资料文本进 Jev,做一个粗粒度判断:资料缺失、信息矛盾、正常申请、还是高欺诈风险。判断为高风险的直接转人工介入,正常申请才进入自动化风控流程。这是一道前置分流,用 Choice 就能完成,毫秒级、成本极低。
下面这张图是应用前后的对照:
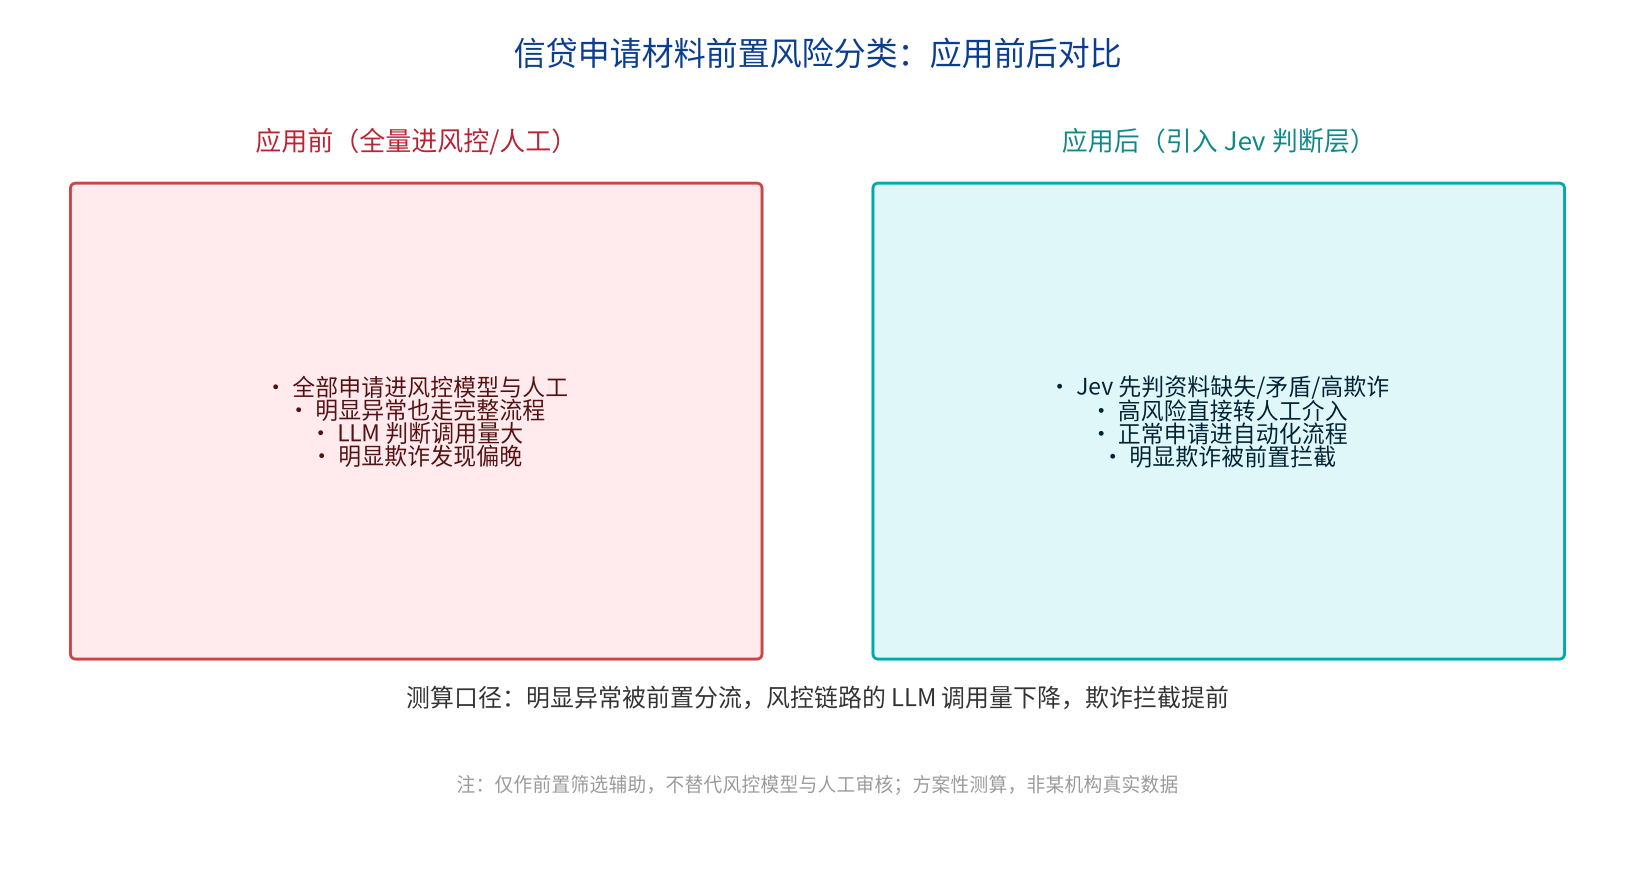
信贷申请材料前置风险分类:应用前后对比
三、价值对比:调用量与拦截时点
收益体现在两处。
调用量上,明显异常的申请被前置分流,不再全部涌入后段的大模型判断环节,风控链路的 LLM 调用量下降,整体成本更可控。
拦截时点上,明显欺诈和资料问题在最前端就被识别,而不是走到流程后段才发现,拦截被提前,也减少了无效流程的资源占用。
四、这套方案的边界
这一条我要特别强调:Jev 在信贷场景只能做"前置筛选辅助",绝不能替代风控模型和人工审核。信贷决策关系到重大权益和合规要求,Jev 只给粗粒度判断、不给理由,也可能误判,因此它的输出只用于分流,不用于放贷或拒贷的最终决定。被判为高风险的转人工,被判为正常的仍要走完整风控。收益为方案性测算,真实效果要以自己的数据和监管要求为准。
五、最终效益
这套前置初判的效益是"用一道极低成本的分流,减少风控链路的无效负载"。风控环节的调用量随明显异常被前置分流而下降,欺诈拦截被提前,人工和风控算力集中到真正需要审慎判断的申请上。把"这份资料是不是明显有问题"的初筛交给 Jev、把"到底批不批"的决定权牢牢留在风控模型和人工手里,信贷初审既提速又守住了底线。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号