告警不再刷屏:Jev 帮运维把真故障从噪声里筛出来
原创
告警不再刷屏:Jev 帮运维把真故障从噪声里筛出来
原创
hollyx
发布于 2026-09-23 22:00:20
发布于 2026-09-23 22:00:20
做运维最怕的不是没有告警,而是告警太多。海量告警不分级全量推送,值班很快就被淹没,告警疲劳一上来,真正的故障反而容易被漏掉。这一周我用 Jev 给告警做分级筛选,只把严重故障推给值班,告警一下清爽了。这篇讲清楚这个场景应用前后的差别:分级怎么做、告警量怎么降、真故障怎么不漏。文中对比为基于实测口径的方案性测算,非某系统真实数据,Jev 仍处早期访问阶段。
一、原来的做法:告警全量推送
应用前,应用服务的日志告警不分级别,全量推送给值班人员。
问题很典型:告警里绝大多数是普通日志或偶发噪声,真正的严重故障被淹没其中。值班被海量无效告警刷屏,产生告警疲劳,久而久之对告警麻木,真故障反而容易被漏掉。
二、改造后的做法:Jev 判告警级别再决定推不推
应用后,我在告警推送前加一道 Jev 判断。
日志告警文本进 Jev,判断告警级别:普通日志、业务异常、严重故障,并区分它是偶发的噪声告警还是真实故障。只有被判为严重故障的才推送给值班人员,其余的汇总或降级处理。
下面这张图是应用前后的对照:
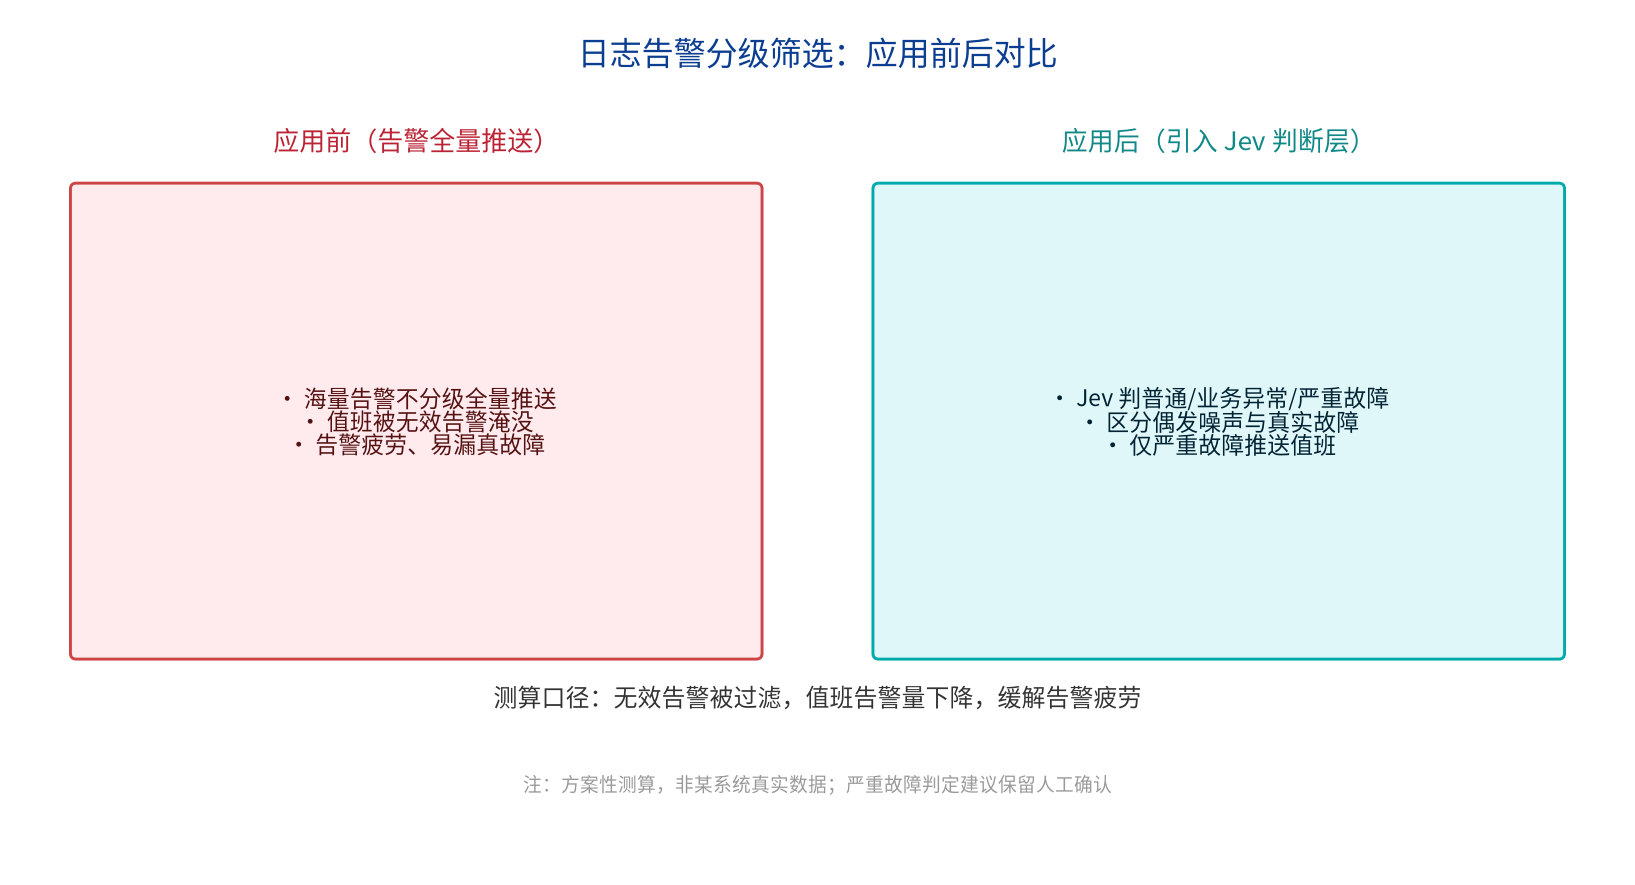
日志告警分级筛选:应用前后对比
三、价值对比:告警量与告警疲劳
收益体现在两处。
告警量上,海量无效告警被过滤,推送到值班手里的告警量大幅下降,噪声不再刷屏。
疲劳上,值班只面对真正需要处理的严重故障,告警疲劳缓解,对真故障的响应反而更及时、更认真。
四、这套方案的边界
Jev 在这里做的是"告警分级判断",不做故障的诊断和修复。它可能误判,把真故障降级、或把噪声升级,所以严重故障的判定建议保留人工确认,被降级的告警也要留存可追溯,避免漏掉真问题。它不擅长处理纯数字阈值类的判断,那类仍应交给规则引擎。收益为测算口径,真实准确率要以自己的告警数据标定。
五、最终效益
这套改造的效益是"把真故障从噪声里筛出来,让值班不再被刷屏"。推送告警量随无效告警被过滤而大幅下降,告警疲劳缓解,真故障的响应更及时。把"这条告警严不严重、是不是噪声"的初筛交给 Jev、把"故障怎么处理"留给运维,告警系统既清爽又不漏关键问题。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号