低代码大屏的数据源层怎么设计?多数据库兼容的一次工程复盘
原创
低代码大屏的数据源层怎么设计?多数据库兼容的一次工程复盘
原创
小小码农爱奋斗
发布于 2026-09-24 11:33:39
发布于 2026-09-24 11:33:39
一、拖拽好做,接数据难做
做大屏的人容易把注意力放在画布上,觉得拖拽顺滑、图表好看就是产品好,真到了项目现场才发现,最耗时间的环节是数据接入。去年我们接手一套县域数字乡村的可视化平台,十四个页面,数据躺在四种不同的库里,有 MySQL 的村民台账,有达梦的政务公开表,还有两个外部接口要给天气和农产品行情。
这四种数据源的脾气完全不一样,关系库要写 SQL,接口返回的是 JSON,有的接口还限流,一分钟只给二十次。如果在页面上一个个写死,后面每加一个村就要改一遍代码,平台也就不叫低代码了。所以我们花了不小力气,只做一件事,把数据源这一层抽出来。
二、数据源层要切三层,不能只切一层
最早我们的设计只有一层,叫数据源,页面上选一个数据源,然后直接写查询。跑了两个月发现不对,因为同一份数据在不同页面上要的口径不一样,一个页面看当天,另一个看近三十天,如果每次都改数据源,等于没有复用。
后来我们切成三层,数据源、数据集、组件绑定。数据源只回答一个问题,怎么连上,它存的是类型、地址、账号、连接池参数。数据集回答第二个问题,取什么,它把一段查询或者一次接口调用固化下来,带上参数定义。组件绑定回答第三个问题,给谁用,图表组件只认数据集的名字和字段。
数据集还有个容易被忽略的能力,参数化。我们一开始把查询写死,后来发现同一张各村产量对比的图,换个时间范围、换个作物种类就成了另一张,于是给数据集加了参数声明,前端把参数当普通表单字段传进来,取数层负责把它拼进查询。同一份定义能支持几十个页面,维护成本一下降下来。
参数化之后紧接着要解决缓存。同一份数据,一张大屏上可能被三个组件同时用,如果每次都去查库,既浪费也慢。我们的做法是在数据集这一层挂一个缓存开关,按参数组合做键,设一个秒级的有效期。政务数据的时效要求不高,一分钟的缓存完全够用,库的压力却少了一大截。
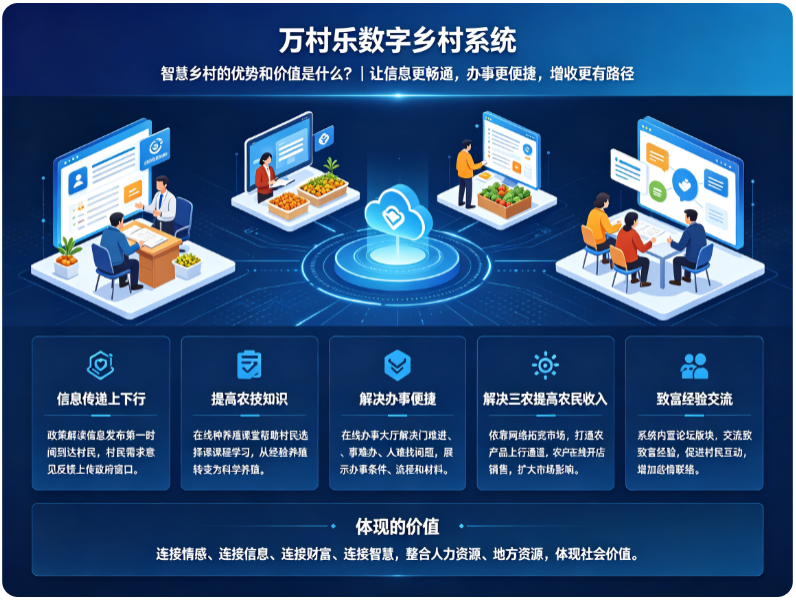
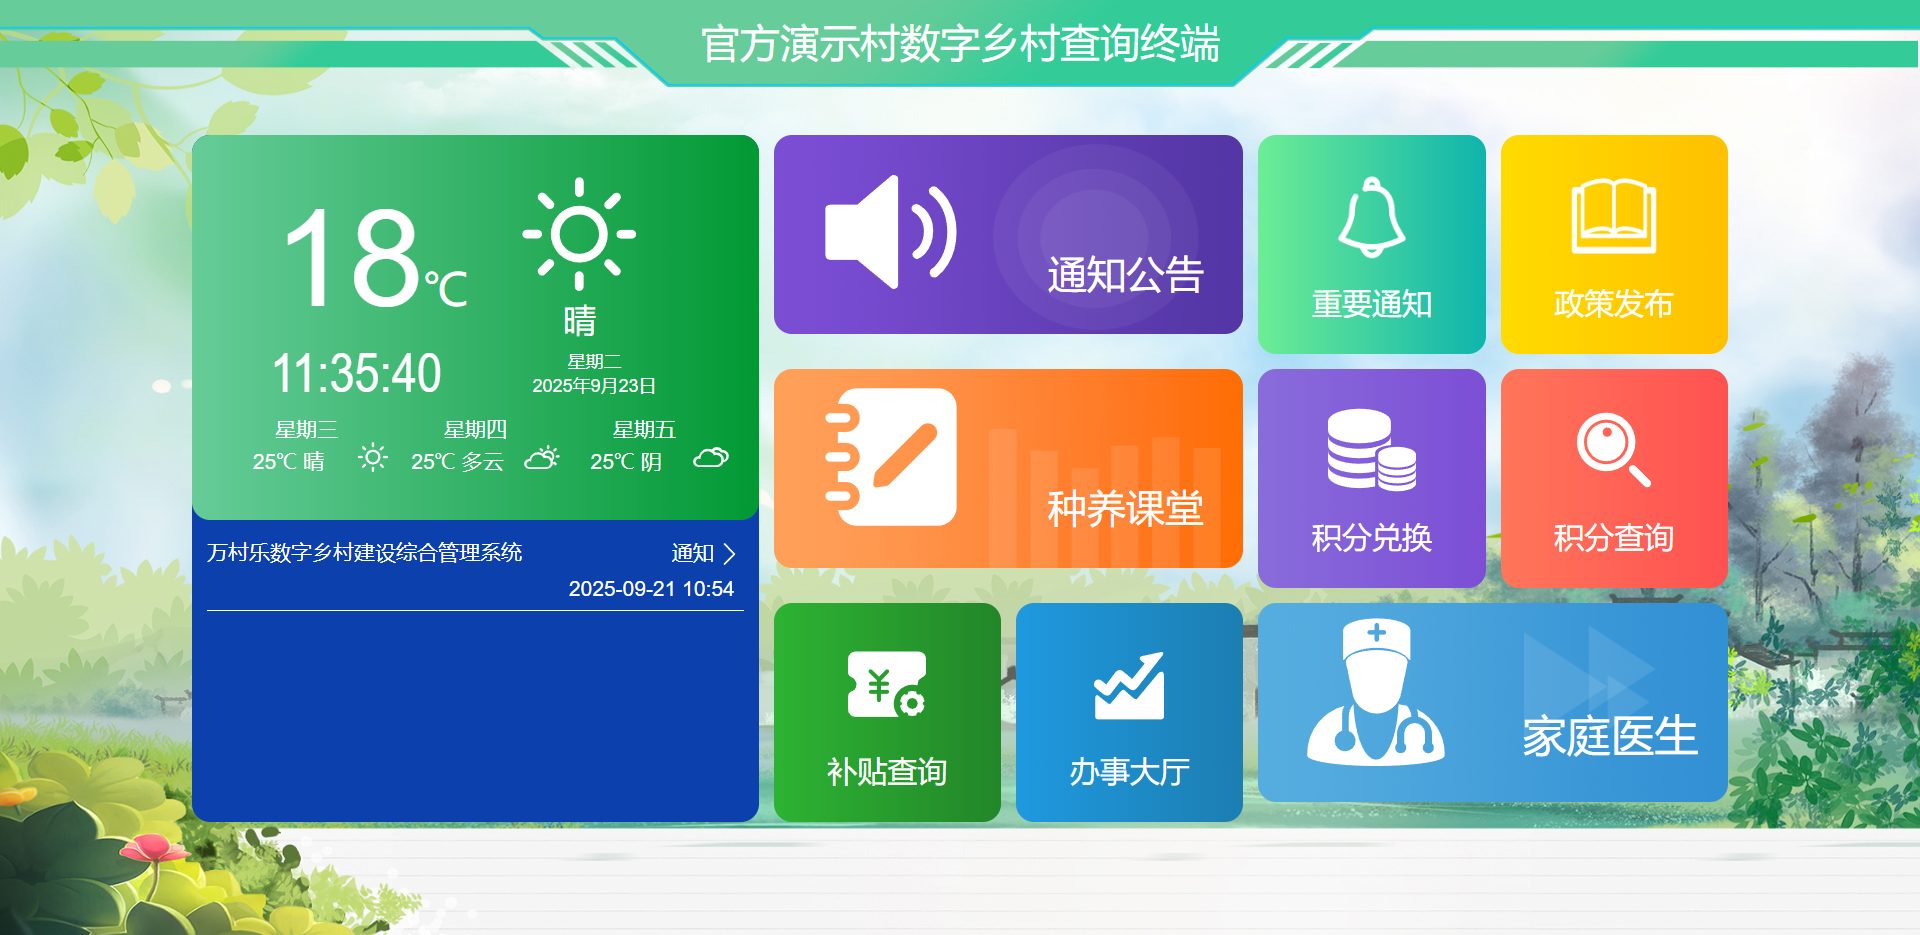
这样切的好处是边界清楚,改口径只动数据集,换库只动数据源,换图表只动绑定,三件事互不牵连。做这套平台的时候,我们把它落在一个叫万村乐数字乡村的系统里,后来发现这个分层思路比大屏本身更通用。
三、多数据库兼容,三条路各有代价
第一种做法是上 ORM,让框架去翻译。MySQL 和 PostgreSQL 这条路走得通,达梦和 Oracle 也能跑,但大屏的查询大多是聚合,字段多、分组多,ORM 拼出来的 SQL 往往比手写慢一截,几十万行的表一扫就超时。
第二种做法是统一成一种库,比如全量同步到 MySQL。这条路初期最省事,代价是同步链路要自己维护,政务数据又有不出域的要求,跨库同步本身过不了合规这一关。
第三种是我们最后选的,方言适配层。上层只写一套查询描述,落到具体库时再翻译。听着抽象,其实就三件事,分页怎么写,时间函数怎么调,字符串拼接用什么符号。
翻译层按数据源类型挂不同的方言实现,MySQL 用 LIMIT,达梦和 Oracle 用 ROW_NUMBER 包一层。这东西写起来不复杂,真正花时间的是补测试,五种库乘以四类聚合语句,二十个用例一个都不能少,少一个后面就等着在生产环境上现场排错。
四、前端组件化,靠注册表而不是靠 if
图表组件的管理方式我们踩过一次坑。最早的写法是页面里写判断,类型是折线就用折线组件,是柱状就换柱状组件,代码里全是条件分支,加一种图表要改五处地方,改完还得担心有没有漏。
后来改成注册表,每个组件在加载时把自己登记进去,声明三件事,它的名字、它能接哪些数据集字段类型、它的默认配置。页面渲染时按名字去表里取,取不到就报一个明确的错,而不是直接白屏。
这套做法还有个额外好处,第三方组件能热插拔。我们做数字乡村项目时,地图组件是后来才补进去的,走的就是注册表,没动一行原有代码。技术选型上,三维场景用 Three.js,地理底图用 Mars3D,二维图表用 ECharts,三者各管一段,靠注册表统一收口。
五、多级权限不只是菜单,是数据行
政务类大屏有个绕不开的要求,同一张页面,省里看全省,市里看全市,村里只看本村。很多人第一反应是前端控制,不同角色给不同菜单,这么做能过演示,过不了验收。
真正要做的是数据行级过滤。我们在数据集这一层挂了一个区域参数,查询发出前自动拼上区域条件,前端角色只决定它拿到哪个区域的标识。这样即便有人绕过前端直接调接口,也只能拿到自己那一段数据。
区域标识我们用的是行政区划码,省、市、县、镇、村五级,前缀匹配。判断一个村属不属于某个市,比的不是复杂的关联表,而是字符串前缀,成本低,查错也容易。
口径统一是另一个隐性成本。同一个村民总数,在人口页面、积分页面、党建页面上可能算出三个不同的数,原因往往是各自写了一版查询。我们的应对是把指标固化在数据集里,页面只能引用,不能自己拼。这样数字对不上的时候,只有一个地方要查,不用在十几个页面之间来回翻。
六、独立部署,配置必须外置
低代码平台有个天然诉求,设计出来的应用能单独拿走。我们的做法是把页面配置、数据集定义、数据源连接信息全部序列化成一份配置文件,导出时打成独立包,换一台服务器解压就能跑起来。
这里有个容易忽略的点,连接信息里带密码,不能明文写在配置里。我们改成运行时注入,配置只存参数名,真实值从环境变量读,导出包里永远不含凭据。这一条在交付给甲方的时候格外重要,包在谁手上都不会泄露库的口令。
七、三个真实的坑
第一个坑是连接池。大屏有个特点,页面一打开会并发发起十几个查询,如果每个数据集各建一个池,数据库连接数一下就满了。改法是同一个数据源共用一个池,再把并发查询数量做个上限,超出的排队等。
第二个坑是时间字段。Oracle 的 DATE 精度只到秒,MySQL 的 DATETIME 可以到微秒,两边对同一份数据排序时结果不一致,导致图表数字对不上。改法是取出后统一转成时间戳再参与计算,不依赖数据库自己的排序。
第三个坑是空数据。线上跑了一年才遇到,某个村搬迁之后台账为空,图表没数据就整体报错,把整页拖黑了。改法是聚合结果做兜底,空的时候返回一条全零的记录,图表照常渲染,用户看到的是零而不是错误。
八、小结
回头看,这套数据源层的价值不在技术含量,在边界清楚。数据源管连接,数据集管取数,组件绑管呈现,权限管过滤,四层的职责谁都不越界。做县域项目最怕需求一直变,分层做得干净,改一处就是一处,不至于牵一发而动全身。
这套结构我们在万村乐数字乡村的可视化平台里跑了两年多,页面从十四个长到六十多个,数据源从四种加到七种,后面陆续调整过几轮,其中有几回只碰了方言适配层的一个文件,其余全是配置。如果你的大屏也在接第三、第四种库,建议先停下来把这一层切开,后面会省很多事。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号