7 秒跑完一次航班查询:用 Jev 重构网页自动化的判断层
原创
7 秒跑完一次航班查询:用 Jev 重构网页自动化的判断层
原创
gavin1024
发布于 2026-09-24 12:39:23
发布于 2026-09-24 12:39:23
做网页自动化这件事,真正卡脖子的从来不是"怎么点击",而是"该点哪个"。传统做法里,我把每一步的页面状态丢给大模型,让它生成"下一步操作"的 JSON,结果一个多步流程被拖成几十秒,token 账单也不小。这一周我用 Jev 把这层判断重构了一遍:一次网页任务(比如查一趟航班)从原来的"等模型逐字蹦"变成"毫秒级拍板",整体体感是 7 秒级完成。这篇就把这个工程实践讲透,痛点在哪、Jev 为什么适配、怎么落地、效果怎么对比。文中官方口径数据可核实,整体降本提速幅度为方案性测算,非某项目真实业绩,Jev 仍处早期访问阶段。
Jev 是 TypeSafe AI 推出的高速低成本 AI 判断器,区别于 ChatGPT、Claude 这类生成式大模型,它不做自由问答、文案创作和代码编写,核心定位是软件或 AI 系统中的专用判断组件:输入当前状态加上固定候选选项或评判标准,输出确定性选择(Choice)、量化打分(Score)或真伪概率(Noul)。它的四个卖点是,决策耗时 70~500ms、输入 0.042 美元每百万 token 且输出免费、专注封闭式判断规避幻觉、以及承接大模型的琐碎判断从而显著降本增效。
一、行业痛点拆解:慢在判断,贵在判断
先把传统网页自动化的痛点讲具体。一个"查航班"的任务,链路上有大量判断步骤:现在该点搜索框还是日期选择器?这个弹窗是 Cookie 提示还是登录框?该选哪个航班卡片?每一步我都在调大模型。
问题有三。第一是慢:大模型逐字自回归生成,每一步操作决策都要等它把 JSON 蹦完,延迟以秒计,几十步叠下来,一个本该几秒的任务拖成几十秒。第二是贵:这些判断输入输出双向计费,高频、重复地调用大模型,token 成本快速累积。第三是脆:模型偶尔在 JSON 后多写一句解释、或返回一个页面上根本不存在的元素,我的自动化脚本就崩了,得写一堆重试和容错。
二、Jev 适配逻辑:网页操作判断天生是封闭题
网页自动化的每一步判断,恰好符合 Jev 的适配特征:有限固定选项、大批量重复、需要低延迟、需要严控成本。
"该点哪个元素"本质是从当前页面可交互元素这个固定集合里选一个,这是标准的 Choice;"这个弹窗是不是需要关闭的干扰项"是一个 Noul 真伪判断;"多个候选卡片哪个最匹配目标"可以用 Score 打分。这些判断的候选项都由我的代码从页面里提取后给定,Jev 只在边界内选,不会凭空造一个不存在的元素,这正好治好了传统方案"越界"的脆。
下面这张图对照了两种方案在判断层上的差别:
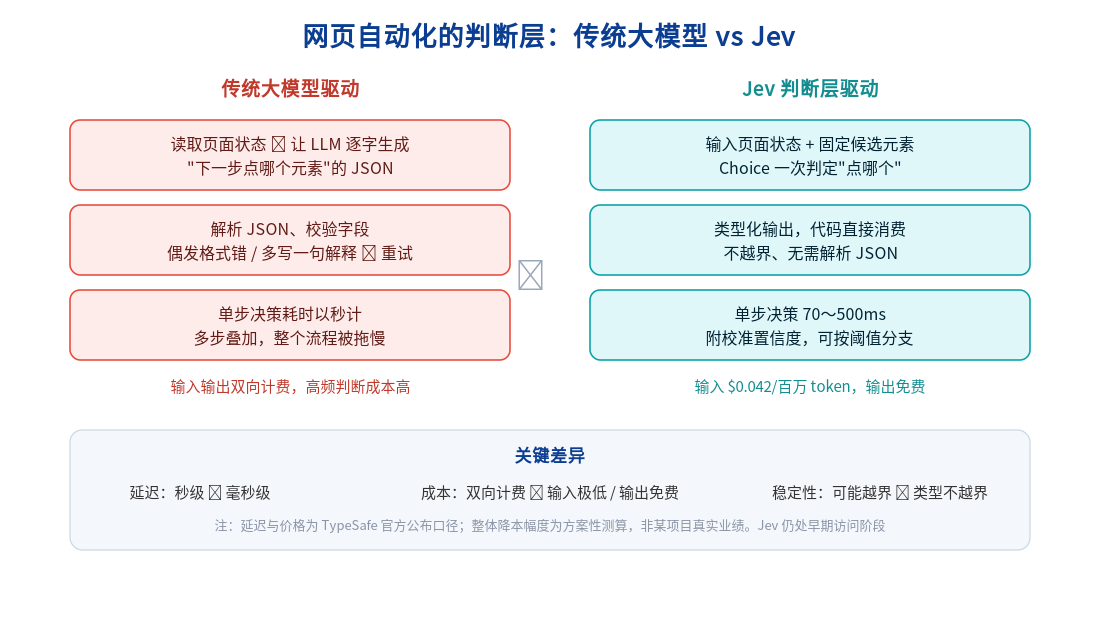
网页自动化的判断层:传统大模型 vs Jev
三、实战落地流程:从状态到动作的一次判断
我把单步决策拆成"输入状态 → 固定候选 → Jev 决策 → 输出结果 → 落地执行"五步,串起来就是完整的自动化循环。
第一步,输入状态。代码侧抓取当前页面的可交互元素列表(按钮、输入框、链接、下拉等),连同任务目标,组织成一段文本作为 state。
第二步,固定候选。把这些可交互元素作为 Choice 的候选项交给 Jev,注意候选是我给的,不是模型编的。
第三步,Jev 决策。一次调用里可以并行问几个问题:用 Choice 判断"下一步点哪个元素",用 Noul 判断"当前是否有需要先关闭的弹窗",必要时用 Score 给多个候选卡片的匹配度打分。
第四步,输出结果。Jev 返回选中项和校准置信度,代码直接读字段,不需要解析 JSON。
第五步,落地执行。高置信度直接执行点击或输入;中等置信度加一道校验;低置信度升级到大模型或转人工确认。整个循环重复推进,直到任务完成。
下面这张图是一次决策的完整数据流:
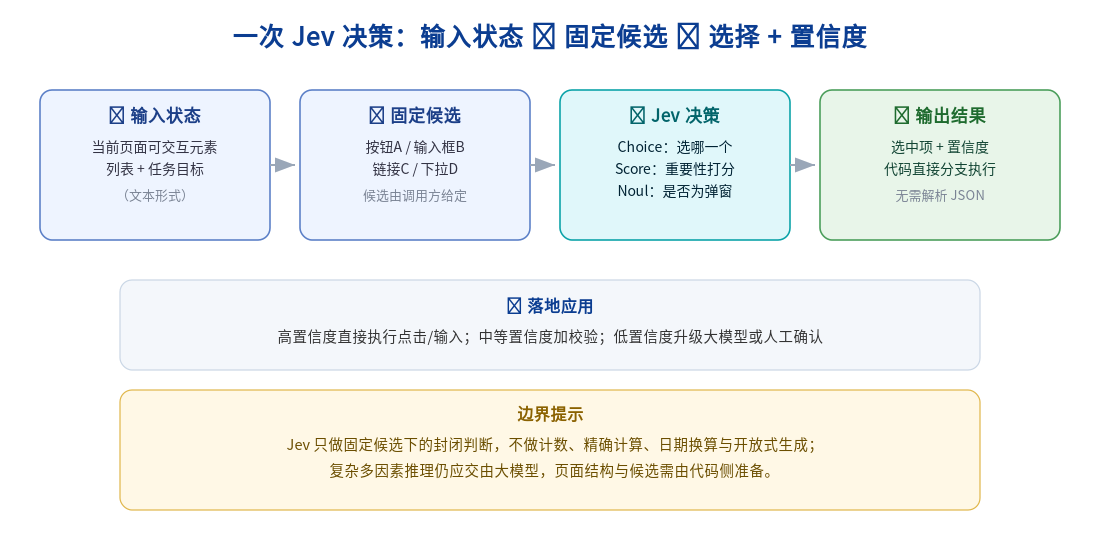
一次 Jev 决策:输入状态、固定候选、选择加置信度
四、效果数据佐证:延迟与成本的量级差
把改造前后放到可核实的口径上对比。
延迟上,Jev 的单步决策官方口径是 70~500ms,而大模型做同类判断通常以秒计。第三方实测(挪威开发者 Emil Lindfors,2026 年 9 月)在文档判断任务上测得 Jev 中位延迟 0.32 秒,同款大模型开启推理时是 26 秒。落到网页自动化上,判断层从秒级压到毫秒级,几十步叠加后,一个航班查询任务从原来的几十秒量级收敛到 7 秒级体感。
成本上,Jev 输入 0.042 美元每百万 token、输出免费;大模型判断则输入输出双向计费。同一份第三方实测里,每千份判断的成本 Jev 约 0.22 美元、同款大模型 1.31~3.08 美元。判断步骤越多、跑得越频繁,节省越明显。
准确率上要诚实:第三方实测显示 Jev 在这类判断上的一致率与前沿大模型大致持平,并没有反超。它换来的不是"更准",而是"用极低成本和延迟拿到够用的准确率"。至于整体链路能省多少,取决于你把多少判断从大模型迁过来,这部分是方案性测算,需要用自己的任务实测。
五、避坑与生产落地建议
先说边界。Jev 只做固定候选下的封闭式判断,不适合计数、精确数学计算、日期换算、无固定标准的开放式创作和无边界逻辑推断。所以网页自动化里"算出还剩几张票""比较两个日期先后"这类,我一律先在代码里算好,再让 Jev 判断结果分档;页面结构的提取和候选准备,也始终由代码侧负责。真正需要复杂多因素推理的步骤,仍然交给大模型。
生产接入建议三条:一是优先影子运行,让 Jev 与现有方案并行跑一段,对比它的判断和实际结果,不直接接管操作;二是基于自己的业务数据校准置信度阈值,0.9 只是示例,绝不代表真实准确率;三是对低置信度决策自动流转人工复核或强推理大模型兜底,兼顾效率与准确率。把判断层交给 Jev、把生成和兜底留给大模型、把逻辑和候选留在代码里,网页自动化才能既快又稳又省。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号