代码规范校验提速:Jev 毫秒级判定主观规范项
原创
代码规范校验提速:Jev 毫秒级判定主观规范项
原创
hollyx
发布于 2026-09-24 13:28:28
发布于 2026-09-24 13:28:28
代码规范校验里,Linter 能管住确定性规则,但一些主观规范项,命名是否清晰、注释是否到位、是否符合团队约定,过去我常交给大模型判断,批量一跑既慢又贵。这一周我用 Jev 承接这类主观判断,和静态检查工具形成互补。这篇讲清楚落地:痛点、适配、实战流程、效果对比。文中官方口径数据可核实,整体效果为方案性测算,非某项目真实业绩,Jev 仍处早期访问阶段。
Jev 是 TypeSafe AI 推出的高速低成本 AI 判断器,区别于 ChatGPT、Claude 这类生成式大模型,它不做自由问答、文案创作和代码编写,核心定位是软件或 AI 系统中的专用判断组件:输入当前状态加上固定候选选项或评判标准,输出确定性选择(Choice)、量化打分(Score)或真伪概率(Noul)。核心优势是决策 70~500ms、输入 0.042 美元每百万 token 且输出免费、专注封闭式判断规避幻觉、承接大模型琐碎判断从而降本增效。
一、行业痛点拆解
确定性规范(缩进、分号、未用变量)Linter 就能搞定,但主观规范项判断不了,比如"这个命名是否表意清晰""这段逻辑是否需要注释"。这类我原来交给大模型,问题是逐字生成慢、高频提交时成本累积,批量校验一个大仓很吃力。
二、Jev 适配逻辑
主观规范项本质是封闭判断:"命名是否清晰"是 Noul,"这段代码属于哪类规范问题"是 Choice,"可读性打几分"是 Score。判定标准由团队预先定义,Jev 毫秒级、低成本地批量判断,正好补上 Linter 管不了、大模型又太贵的那块。固定标准、批量、低延迟、低成本,全部命中。
下面这张图对照了两种方案:
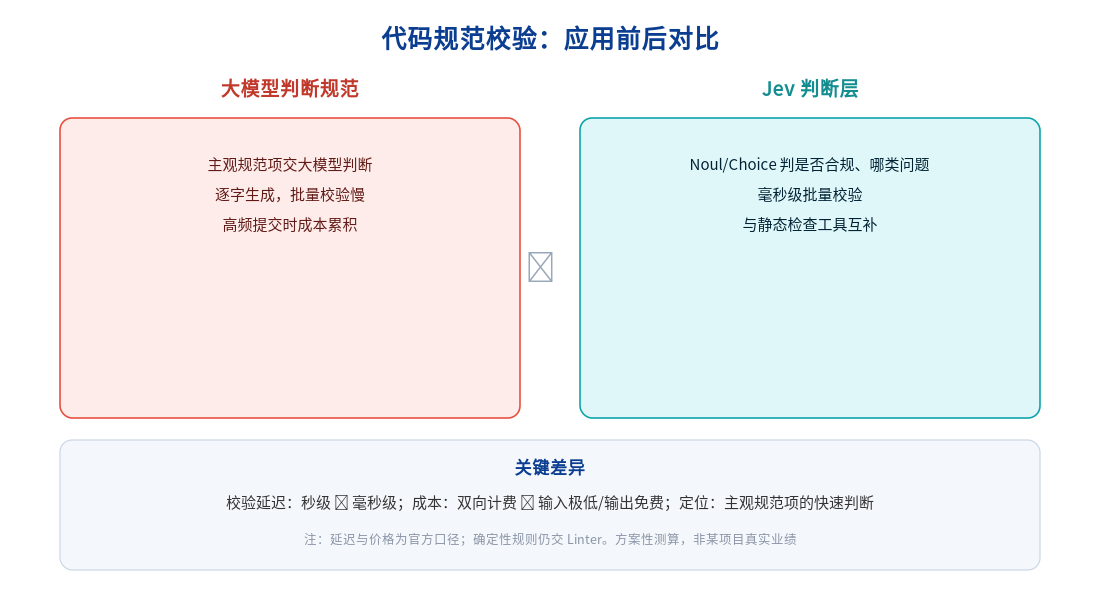
代码规范校验:应用前后对比
三、实战落地流程
五步:输入状态(代码片段加规范要求组成 state)→ 固定候选(规范问题类型集合作为 Choice 候选,或直接用 Noul 判是否合规)→ Jev 决策(Noul 判是否符合某项规范、Choice 归类问题、Score 打可读性分,一次调用并行)→ 输出结果(返回判断加置信度)→ 落地执行(不合规项在 CI 里提示或阻断,与 Linter 结果合并汇报)。
四、效果数据佐证
延迟:Jev 官方口径 70~500ms,批量校验大仓也很快。成本:Jev 输入 0.042 美元每百万 token、输出免费,高频提交场景比大模型便宜得多。定位:它专攻主观规范项,和 Linter 的确定性规则互补,覆盖更完整。准确率上实测与大模型大致持平。整体校验提效属方案性测算,需自测。
五、避坑与生产落地建议
边界:Jev 不做计数、精确计算、日期换算、开放式创作和无边界推理,也不生成修改后的代码,它只判断"符不符合、属哪类问题",改写建议交大模型。确定性规则仍交 Linter,不要用 Jev 替代。生产接入:优先影子运行,先只提示不阻断,比对判断质量;基于自身规范和代码校准阈值(阈值不等于真实准确率);低置信度项转人工评审。主观判断交 Jev、确定性规则交 Linter、改写交大模型,规范校验才既全又省。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号