警务识别不该"停下来操作一次",AR 眼镜把它省掉了
原创
警务识别不该"停下来操作一次",AR 眼镜把它省掉了
原创
阿法龙XR云平台
修改于 2026-09-24 16:01:10
修改于 2026-09-24 16:01:10
当识别不再需要"停下来操作一次",安防才真正进入实时时代
智能眼镜要解决的,就是这最后一米的时差。
一、一线最缺的,从来不是摄像头
• 看见 ≠ 认出——重点人员混在人流里,靠肉眼筛查,漏检是必然。
• 查证慢半拍——"发现可疑 → 呼叫后台 → 等待反馈",几十秒到几分钟,人早走远了。
• 双手被占满——警务通、对讲机、执法记录仪,操作链路越长,关键几秒越容易掉链子。
• 人、车、案是三张皮——分属不同系统,现场无法一次完成联合核验。
• 消费级设备撑不住实战——识别距离 1–3 米、手动触发、响应 2–3 秒。实战里,你不可能先停下来喊一句"开始识别"。
二、四张底牌
底牌一:零操作的 AR 实景追踪
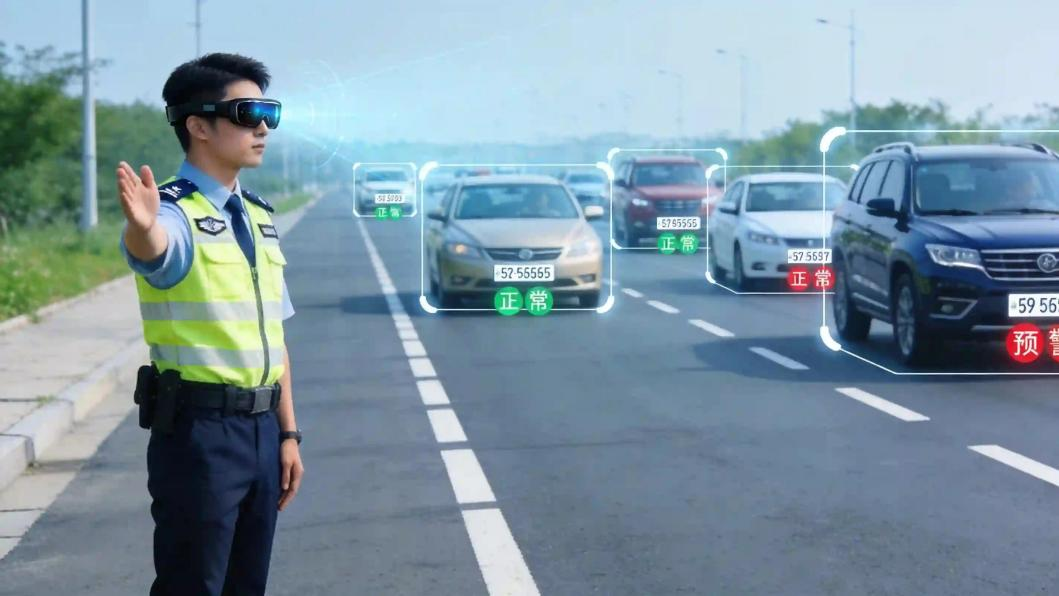
虚像居中、与视线平齐——这是 AR 追踪能否成立的前提。目标进入视野即自动锁定跟踪,不用按键、不用语音指令,目标移动或佩戴者移动都不丢框。
底牌二:10 米识别距离
5000 万像素摄像头 + 79° 专为识别优化的 FOV + PDAF 相位对焦。5 米处人脸像素面积约 120×120,特征点充分;同类大广角方案只有约 30×30,基本无法识别。
实战中的距离分层:10 米可追踪,7–8 米可识别,5 米可拦截或放行。
底牌三:300 毫秒响应
不上传原图。锁定后只抽出一张约 120×120 像素、10KB 的人脸小图,经警务通/执法记录仪比对后直接叠加回镜片。人还没走出视野,答案已经在眼前。
底牌四:人车一体,全流程闭环
• 车牌识别——端侧 OCR,支持蓝牌、绿牌、黄牌、教练车牌,最佳识别距离 ≤10 米。
• 执法记录——第一视角 1080P 录制,自动叠加时间、地点、执法编号、GPS 水印并上传;断网本地缓存,恢复后自动补传。
• 违章取证——按规范连拍 3 张,自动打包时间地点,证据链自动生成。
• 应急指挥——一键呼叫后方专家,第一视角画面实时回传,标注结果直接投到镜片。
两个决定能否落地的细节:54g 整机重量(镜框镁合金、转轴钛合金、镜腿 TR90 记忆材质),配磁吸近视镜片 100–600 度;合规接入—— 不直接联网,通过 USB/蓝牙连接警务通或执法记录仪,由已认证终端作为数据中转访问内网,符合公安安全规范。
三、五个场景,一句话说清
1. 街面巡逻——巡逻节奏不用变,命中重点人员时镜片上直接显示状态标识,看到即知道、知道即处置。
2. 卡口临检——车辆缓行通过即完成车牌 + 驾驶员人脸比对,正常车无感放行,异常车精准拦停。
3. 大型活动安保——每个安保人员都是一个移动筛查点,指挥中心可临时下发布控名单并就近调度。
4. 应急处突——多人持续追踪让目标跑不出视野,指挥中心一键调取现场第一视角。
5. 违章取证——固定套路连拍 3 张,自动打包 GPS 与时间戳,执法人员不写一字。
同一套"端—边—云"能力还可平移到空港、海关、园区与重点场所,覆盖证件查验、多语种实时翻译、远程专家协同等场景。
四、90 秒 vs 5 分钟
同样的路口临检,模式下 90 秒内走完发现、核查、协同、处置:10 米外自动抓拍车牌,视线落到驾驶员即完成人脸比对,一键呼叫指挥中心,执法记录与取证全程自动留痕。
换成传统方式,是拦停、人工录入车牌、呼叫后台、等待反馈、口头请示、事后补台账——全程 5 分钟以上,关键判断还滞后于人员流动。
换成消费级眼镜,是停车、手动触发、等 2–3 秒上传 3–4MB 原图、在单色标记图上凭记忆找人——等结果出来,车已经开走了。
四个变化:响应时延从分钟级到 300 毫秒;有效识别距离从 1–3 米到 10 米;现场操作从 4–6 步减少到 0 步;证据链从人工补录变为自动生成、可追溯。
结尾:从"后台支撑"到"前端智能"
智慧警务的投入大多堆在后台,而真正的决策发生在警员抬眼的那几秒。它做的事很朴素:把识别能力穿戴到一线,让所见即所知,让指挥中心看到的和现场看到的是同一幅画面。
这副 54 克的眼镜,正在把安防的最后一百米,变成最快的那一百米。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号