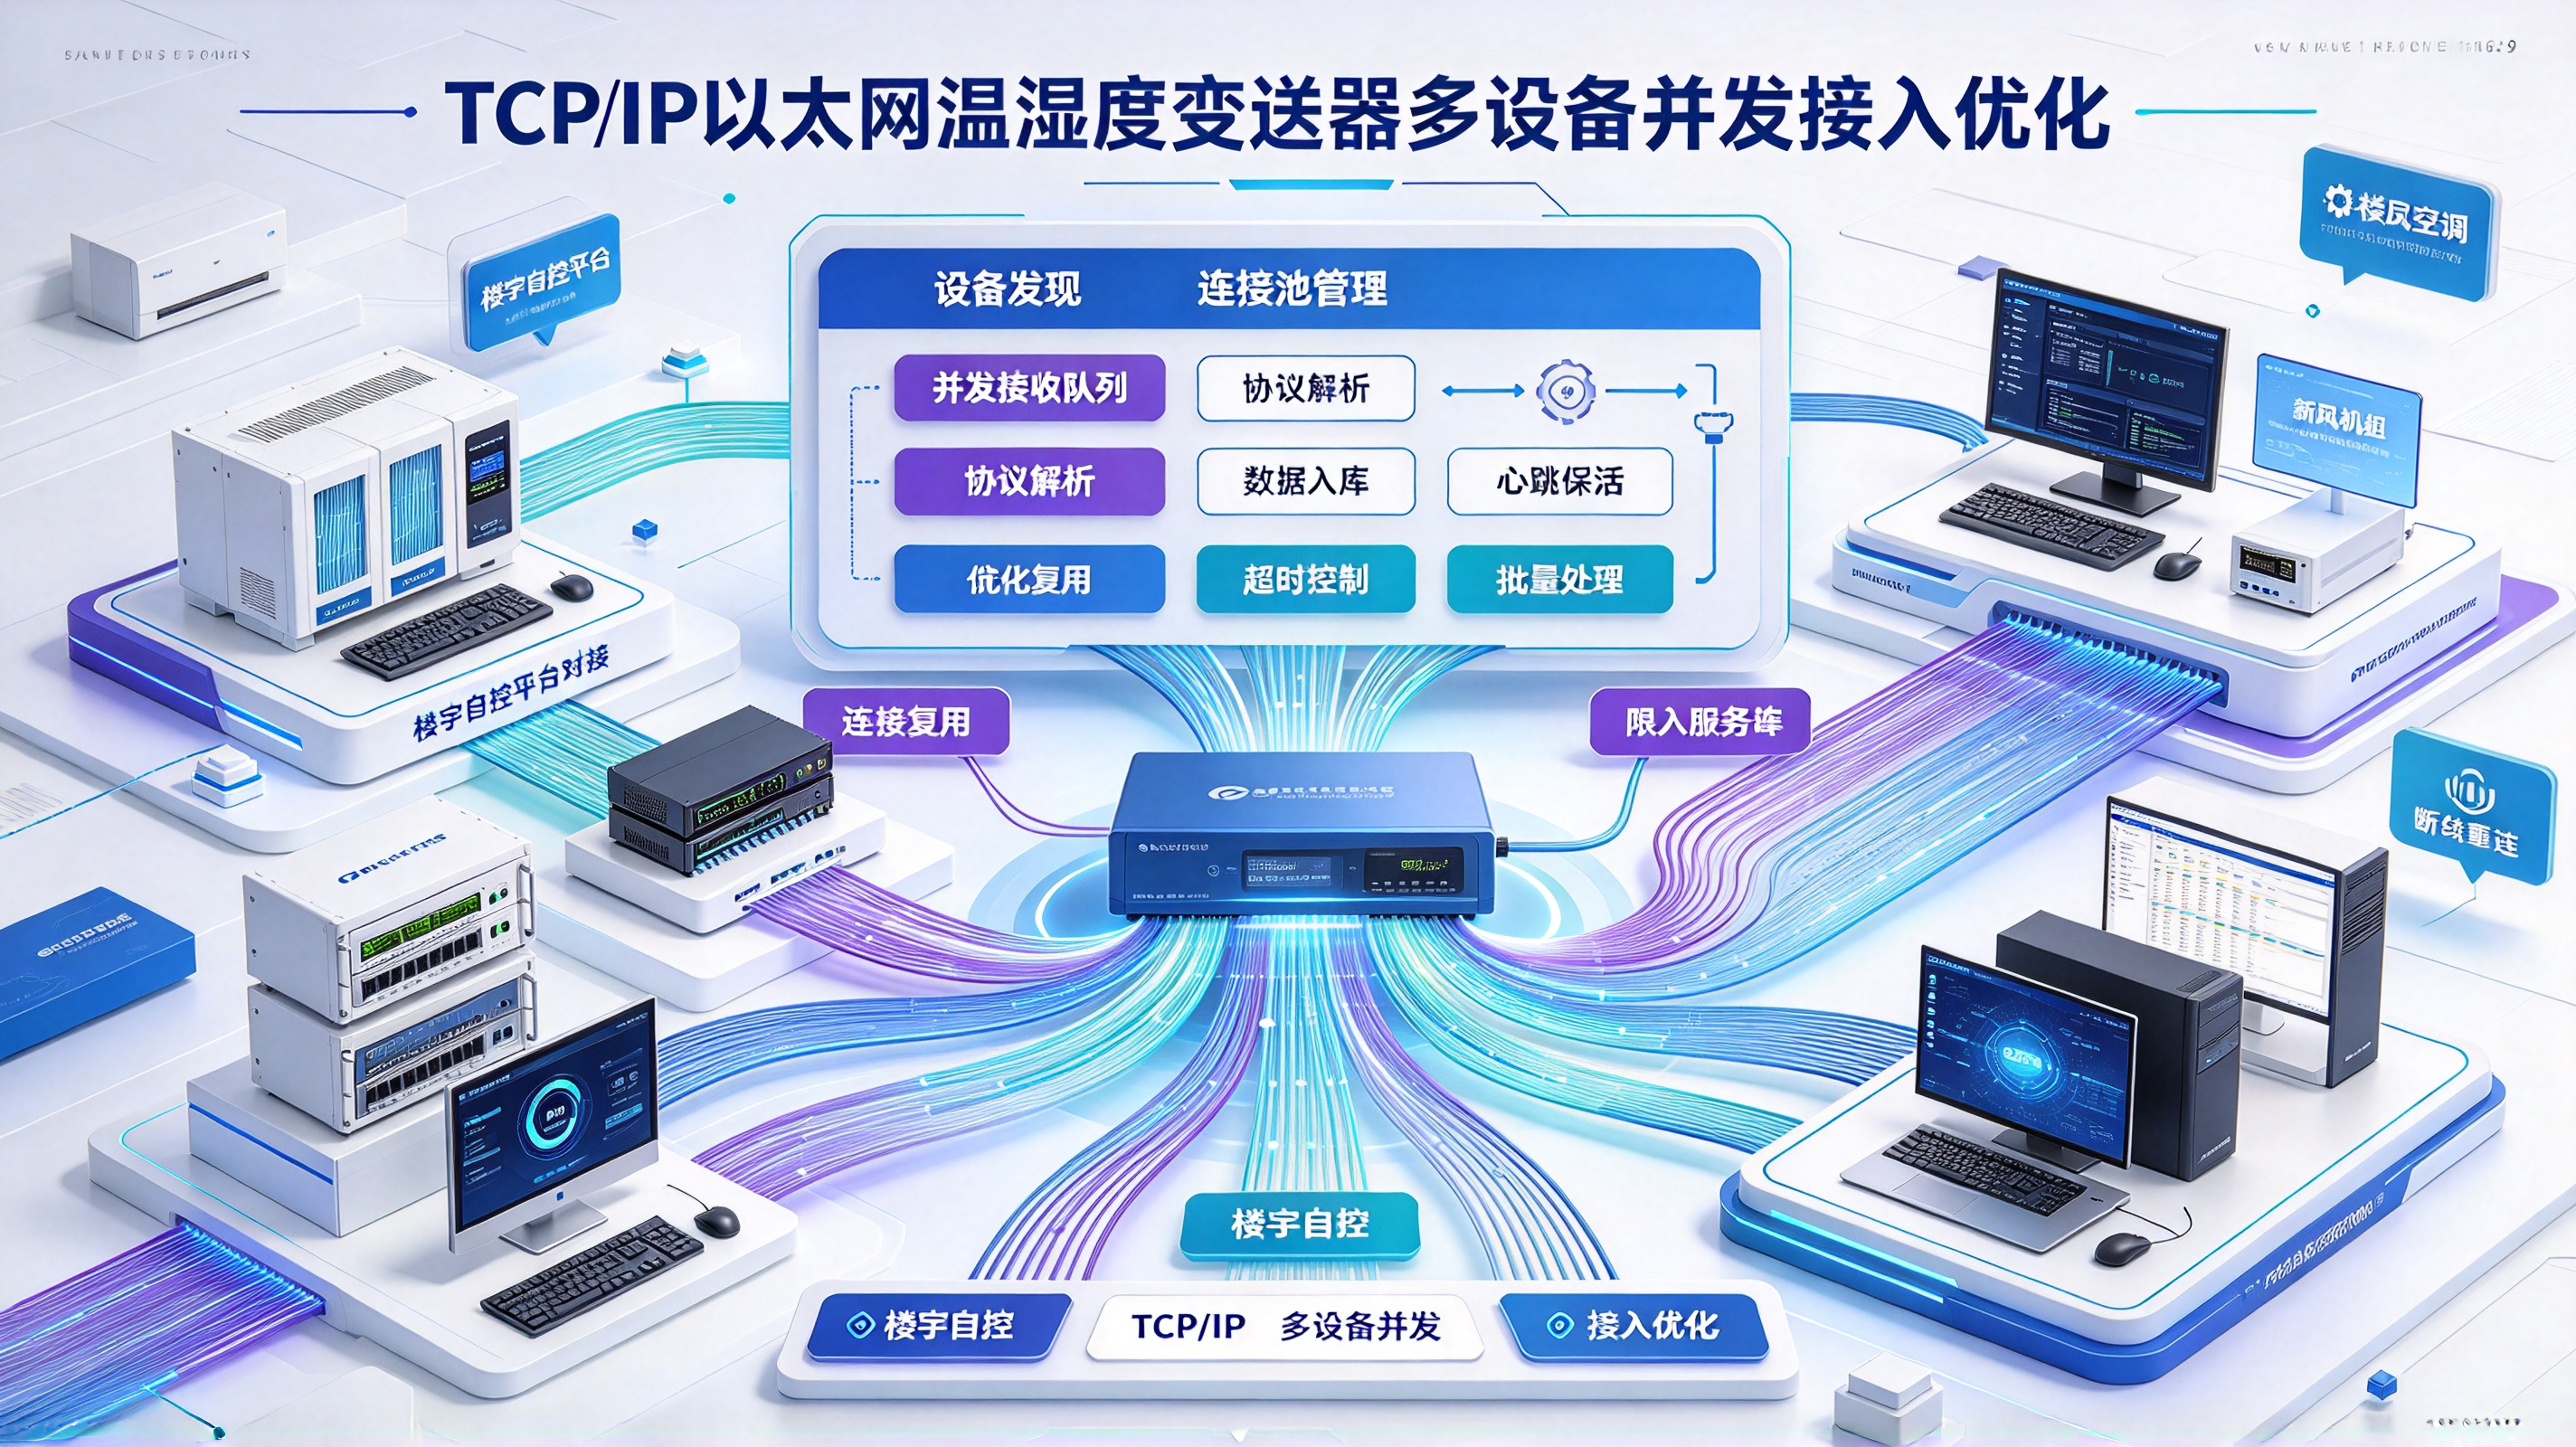
楼宇自控平台对接:TCP/IP以太网温湿度变送器多设备并发接入优化
原创
楼宇自控平台对接:TCP/IP以太网温湿度变送器多设备并发接入优化
原创
盛世宏博小可
发布于 2026-09-24 16:31:34
发布于 2026-09-24 16:31:34
楼宇自控平台对接:TCP/IP以太网温湿度变送器多设备并发接入优化
楼宇自控 #BA平台 #TCP/IP #以太网温湿度变送器 #多设备并发 #连接池 #性能优化 #Niagara #ModbusTCP #SNMP #动环系统
楼宇自控平台(BA)对接以太网温湿度变送器时,最大的痛点往往不是"能不能读到数据",而是"几百台设备同时在线时,平台会不会被拖垮"。很多项目前期调试 10 台、20 台一切正常,等到全量 200 台、500 台上线,就开始出现数据延迟、丢点、甚至平台无响应。根因几乎都指向同一个问题:并发接入没有做分层优化,把 BA 平台当成了无状态的采集代理来用。
先说一个典型的 BA 对接翻车案例:
某商业综合体 BA 平台(Niagara AX)对接 320 台以太网温湿度变送器,分布在 28 层楼的弱电间、机房、新风机房。 初始方案:Niagara 内置 Modbus TCP 驱动,每台设备独立轮询,轮询周期 30s,超时 3s,重试 2 次。 上线后问题:
- 平台 CPU 占用率从 15% 飙到 95%,JVM 频繁 Full GC
- 320 台 × 30s 周期 = 平均每秒 10.7 次连接建立和拆除
- 交换机端口出现大量 TCP TIME_WAIT,连接表耗尽
- 实际数据到达率只有 87%,大量超时 优化后方案:
- 分组轮询:320 台分 8 组,每组 40 台,组内串行、组间并行
- 连接池:每组复用 4 个 TCP 长连接,避免频繁握手
- 轮询周期错峰:每组起始偏移 0/4/8/12... 秒
- 超时缩短为 2s,重试降为 1 次 优化结果:CPU 降到 22%,数据到达率 99.97%,平均响应 180ms。
一、并发瓶颈分析
1. BA 平台对接的三种典型架构
架构 A:BA 平台直连(Niagara / Honeywell EBI / Siemens Desigo)
  BA平台 ──Modbus TCP──► 传感器1
       ──Modbus TCP──► 传感器2
       ──Modbus TCP──► 传感器3
       ...(每台独立连接)

架构 B:BA 平台 + 协议网关
  BA平台 ──BACnet/IP──► 协议网关 ──Modbus TCP──► 传感器群

架构 C:BA 平台 + 采集前置机
  BA平台 ──MQTT/BACnet──► 采集前置机 ──Modbus TCP──► 传感器群
架构 A 最简单,但并发瓶颈最明显——BA 平台的 Modbus 驱动通常是单线程或少量线程池,设备一多就撑不住。
架构 B 把采集压力转移到网关,BA 平台只看到 BACnet 数据点,最省 BA 资源。
架构 C 最灵活,前置机可以用 Python/Go 写高并发采集,BA 平台通过 MQTT 订阅或 BACnet 读取汇总数据。
2. 并发瓶颈来源
瓶颈层 | 具体表现 | 根因 |
|---|---|---|
BA 驱动层 | 轮询线程耗尽、驱动无响应 | 驱动设计未考虑大规模并发 |
TCP 连接层 | TIME_WAIT 堆积、端口耗尽 | 短连接频繁建立/断开 |
网络层 | 交换机 CPU 升高、广播风暴 | 大量并发 SYN/ACK |
传感器端 | 连接数超限(>8)、响应变慢 | LwIP PCB 资源不足 |
数据层 | 数据库写入阻塞、时序数据堆积 | 写入频率超过存储能力 |
二、BA 平台侧优化策略
1. 分组轮询(Grouped Polling)
核心思想:把"所有设备同时轮询"变成"分批错峰轮询"。
320 台设备,分 8 组,每组 40 台:

组1: 设备 001-040, 起始偏移 0s,   轮询周期 30s
组2: 设备 041-080, 起始偏移 4s,   轮询周期 30s
组3: 设备 081-120, 起始偏移 8s,   轮询周期 30s
...
组8: 设备 281-320, 起始偏移 28s,  轮询周期 30s

效果:
  - 同一时刻最多只有 1 组(40 台)在轮询
  - 每台轮询耗时约 200ms × 40 = 8s
  - 组内串行,组间并行,但错峰后实际并发可控
  - 交换机端口压力从"每秒 10.7 次连接"降到"每 4 秒 1 组"
Niagara 配置方式:
Niagara 中创建多个 ModbusNetwork 对象,每个对象对应一组设备:
  ModbusNetwork-Group1:
    - Device Address Range: 192.168.100.1 ~ 192.168.100.40
    - Scan Rate: 30s
    - Offline Poll Rate: 60s
    - Timeout: 2000ms
    - Retry Count: 1
    - Max Concurrent Requests: 4(组内并发)

  通过 Fox 调度器设置每组启动延迟:
    Group1: 0s delay
    Group2: 4000ms delay
    Group3: 8000ms delay
    ...
2. 连接池化(Connection Pooling)
如果 BA 平台支持(或通过前置机实现),用长连接替代短连接:
短连接(默认行为):
  每次轮询:TCP 握手(3次) → Modbus 请求 → 响应 → TCP 挥手(4次)
  开销:每次 7 个包 + 握手延迟(局域网 ~1ms × 7 = 7ms)
  320 台 × 30s = 每秒 10.7 次完整握手/挥手

长连接(连接池):
  首次:TCP 握手 → 保持连接
  后续:直接发送 Modbus 请求 → 响应
  开销:省去握手/挥手
320 台复用 32 个长连接(每连接服务 10 台,轮询切换)关键参数:
参数 | 建议值 | 说明 |
|---|---|---|
连接池大小 | 设备数 / 10(最小 8,最大 64) | 每连接服务 10 台设备 |
连接空闲超时 | 300s | 超过此时间无活动则关闭 |
连接最大生命周期 | 3600s | 定期重建连接,防止僵死 |
最大并发请求/连接 | 1(Modbus TCP 是串行协议) | 同一连接不要并发发请求 |
Keepalive | 开启,30s/5s/3 | TCP 层保活 |
3. 轮询周期分级
不是所有点位都需要 30s 采集一次:
关键机房(UPS 室、核心交换机房):10s 周期
一般机房(楼层弱电间):30s 周期
办公区/走廊:60s 周期
仓储区:120s 周期

效果:
  50 台关键 + 150 台一般 + 80 台办公 + 40 台仓储 = 320 台
  平均每秒请求数从 10.7 降到 5.2(降低 51%)
三、采集前置机方案(高并发场景推荐)
当设备数超过 200 台,强烈建议加一台采集前置机,BA 平台只从前置机订阅汇总数据。
1. 架构
┌──────────────────────────────────────────────────────────────┐
│                    采集前置机(Linux)                        │
│  ┌────────────────────────────────────────────────────────┐  │
│  │            Python asyncio 采集引擎                      │  │
│  │  ┌─────────────┐  ┌─────────────┐  ┌──────────────┐  │  │
│  │  │  连接池管理   │  │  并发采集器   │  │  数据缓冲     │  │  │
│  │  │  32 长连接   │  │  Semaphore   │  │  Ring Buffer  │  │  │
│  │  │  自动重连     │  │  限并发 32   │  │  批量写入     │  │  │
│  │  └─────────────┘  └─────────────┘  └──────────────┘  │  │
│  └────────────────────────────────────────────────────────┘  │
│        │                    │                    │           │
│        ▼                    ▼                    ▼           │
│  ┌─────────────┐  ┌─────────────┐  ┌──────────────┐       │
│  │  MQTT 发布   │  │  InfluxDB   │  │  BACnet IP   │       │
│  │  (可选)      │  │  时序存储   │  │  Server      │       │
│  └─────────────┘  └─────────────┘  └──────────────┘       │
└───────────────────────────┬──────────────────────────────────┘
                            │
                            ▼
┌──────────────────────────────────────────────────────────────┐
│                    BA 平台(Niagara)                         │
│  通过 BACnet IP 驱动读取前置机发布的数据点                     │
│  或 MQTT 客户端订阅实时数据                                   │
│  并发压力:从 320 台降到 1 台(前置机)                       │
└──────────────────────────────────────────────────────────────┘
2. 高并发采集核心代码
import asyncio
import struct
import time
from typing import Dict, Optional, Tuple, List
from dataclasses import dataclass, field
from datetime import datetime
import aiohttp
import aiomqtt
import logging

logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

@dataclass
class SensorPoint:
    """单个传感器数据点"""
    ip: str
    port: int = 502
    slave_id: int = 1
    name: str = ""
    location: str = ""
    temp_reg: int = 0
    hum_reg: int = 1
    scale: float = 0.1
    poll_group: int = 0  # 轮询分组

@dataclass
class PollGroup:
    """轮询分组"""
    group_id: int
    offset: float = 0.0  # 起始偏移(秒)
    period: float = 30.0  # 轮询周期
    devices: List[SensorPoint] = field(default_factory=list)

class ConnectionPool:
    """TCP 连接池(每连接绑定多设备,串行轮询)"""

    def __init__(self, pool_size: int = 32, max_devices_per_conn: int = 10):
        self.pool_size = pool_size
        self.max_devices_per_conn = max_devices_per_conn
        self.connections: Dict[int, Optional[asyncio.StreamReader]] = {}
        self.connection_devices: Dict[int, List[SensorPoint]] = {}
        self.locks: Dict[int, asyncio.Lock] = {}
        self.tid_counter = 0

    def _next_tid(self) -> int:
        self.tid_counter = (self.tid_counter + 1) % 65536
        return self.tid_counter

    def assign_devices(self, devices: List[SensorPoint]):
        """将设备分配到连接"""
        for i, device in enumerate(devices):
            conn_id = i % self.pool_size
            if conn_id not in self.connection_devices:
                self.connection_devices[conn_id] = []
                self.locks[conn_id] = asyncio.Lock()
            self.connection_devices[conn_id].append(device)
        logger.info(f"Assigned {len(devices)} devices to {self.pool_size} connections")

    async def _get_connection(self, conn_id: int) -> Optional[Tuple]:
        """获取或创建连接"""
        try:
            reader, writer = await asyncio.wait_for(
                asyncio.open_connection(
                    self.connection_devices[conn_id][0].ip,
                    self.connection_devices[conn_id][0].port
                ),
                timeout=3.0
            )
            return reader, writer
        except Exception as e:
            logger.error(f"Connection {conn_id} failed: {e}")
            return None

    async def read_device(self, conn_id: int, device: SensorPoint) -> Optional[Tuple[float, float]]:
        """通过连接池读取单个设备"""
        async with self.locks[conn_id]:
            conn = await self._get_connection(conn_id)
            if not conn:
                return None

            reader, writer = conn
            try:
                tid = self._next_tid()
                mbap = struct.pack('>HHHB', tid, 0, 6, device.slave_id)
                pdu = struct.pack('>BHH', 0x03, device.temp_reg, 2)
                request = mbap + pdu

                writer.write(request)
                await writer.drain()

                response = await asyncio.wait_for(
                    reader.read(256), timeout=2.0
                )

                if len(response) < 9 or response[7] == 0x83:
                    return None

                byte_count = response[8]
                if byte_count != 4:
                    return None

                reg1, reg2 = struct.unpack('>HH', response[9:13])
                return reg1 * device.scale, reg2 * device.scale

            except Exception as e:
                logger.error(f"Read {device.ip} failed: {e}")
                return None

class HighConcurrencyCollector:
    """高并发采集器"""

    def __init__(self, devices: List[SensorPoint],
                 pool_size: int = 32,
                 max_devices_per_conn: int = 10,
                 publish_mqtt: bool = False,
                 mqtt_broker: str = "localhost",
                 influxdb_url: str = "http://localhost:8086"):
        self.devices = devices
        self.pool = ConnectionPool(pool_size, max_devices_per_conn)
        self.pool.assign_devices(devices)
        self.publish_mqtt = publish_mqtt
        self.mqtt_broker = mqtt_broker
        self.influxdb_url = influxdb_url
        self.running = False
        self.data_buffer: List[Dict] = []
        self.buffer_lock = asyncio.Lock()
        self.semaphore = asyncio.Semaphore(pool_size)

    async def _collect_device(self, device: SensorPoint) -> Optional[Dict]:
        """采集单个设备数据"""
        async with self.semaphore:
            # 找到设备所属的连接
            conn_id = None
            for cid, devs in self.pool.connection_devices.items():
                if device in devs:
                    conn_id = cid
                    break

            if conn_id is None:
                return None

            result = await self.pool.read_device(conn_id, device)
            if result:
                temp, hum = result
                return {
                    'ip': device.ip,
                    'name': device.name,
                    'location': device.location,
                    'temperature': temp,
                    'humidity': hum,
                    'timestamp': datetime.now().isoformat(),
                    'status': 'OK'
                }
            else:
                return {
                    'ip': device.ip,
                    'name': device.name,
                    'location': device.location,
                    'temperature': None,
                    'humidity': None,
                    'timestamp': datetime.now().isoformat(),
                    'status': 'FAIL'
                }

    async def _publish_data(self, data: Dict):
        """发布数据到 MQTT"""
        if not self.publish_mqtt:
            return
        try:
            async with aiomqtt.Client(self.mqtt_broker) as client:
                topic = f"sensors/{data['location']}/{data['name']}"
                await client.publish(topic, str(data))
        except Exception as e:
            logger.error(f"MQTT publish failed: {e}")

    async def _write_influxdb(self, data_list: List[Dict]):
        """批量写入 InfluxDB"""
        if not data_list:
            return
        # 实现 InfluxDB 批量写入逻辑
        pass

    async def _poll_group(self, group: PollGroup):
        """轮询单个分组"""
        await asyncio.sleep(group.offset)  # 等待起始偏移

        while self.running:
            start_time = time.time()
            tasks = [self._collect_device(device) for device in group.devices]
            results = await asyncio.gather(*tasks, return_exceptions=True)

            # 处理结果
            valid_results = [r for r in results if isinstance(r, dict)]
            for data in valid_results:
                if data['status'] == 'OK':
                    logger.info(f"{data['name']}: T={data['temperature']}℃ "
                               f"H={data['humidity']}%RH")
                    await self._publish_data(data)

            # 批量写入缓冲
            async with self.buffer_lock:
                self.data_buffer.extend(valid_results)
                if len(self.data_buffer) >= 500:
                    await self._write_influxdb(self.data_buffer[:500])
                    self.data_buffer = self.data_buffer[500:]

            # 等待下一个周期
            elapsed = time.time() - start_time
            sleep_time = max(0, group.period - elapsed)
            await asyncio.sleep(sleep_time)

    async def start(self, poll_groups: List[PollGroup]):
        """启动所有分组轮询"""
        self.running = True
        logger.info(f"Starting collector with {len(self.devices)} devices "
                   f"in {len(poll_groups)} groups")

        tasks = [self._poll_group(group) for group in poll_groups]
        await asyncio.gather(*tasks)

    async def stop(self):
        """停止采集"""
        self.running = False
        logger.info("Collector stopped")

# 配置示例
def create_poll_groups(devices: List[SensorPoint]) -> List[PollGroup]:
    """创建轮询分组"""
    groups = []
    group_size = 40
    for i in range(0, len(devices), group_size):
        group_devices = devices[i:i+group_size]
        group = PollGroup(
            group_id=i // group_size + 1,
            offset=(i // group_size) * 4.0,  # 每组偏移 4s
            period=30.0,
            devices=group_devices
        )
        groups.append(group)
    return groups

# 主程序
async def main():
    # 加载设备配置
    devices = [
        SensorPoint(ip=f"192.168.100.{i}", name=f"Sensor-{i}",
                   location="Floor-1" if i <= 80 else "Floor-2" if i <= 160 else "Floor-3")
        for i in range(1, 321)
    ]

    # 创建轮询分组
    groups = create_poll_groups(devices)

    # 创建采集器
    collector = HighConcurrencyCollector(
        devices=devices,
        pool_size=32,
        max_devices_per_conn=10,
        publish_mqtt=True,
        mqtt_broker="192.168.50.10"
    )

    try:
        await collector.start(groups)
    except KeyboardInterrupt:
        await collector.stop()

if __name__ == "__main__":
    asyncio.run(main())
四、传感器端并发优化
1. LwIP 参数调优
MEMP_NUM_TCP_PCB:    5 → 16        # 最大 TCP 连接数
MEM_SIZE:            16KB → 64KB    # 堆内存
MEMP_NUM_PBUF:       16 → 32        # pbuf 数量
TCP_SND_BUF:         2KB → 4KB      # 发送缓冲区
TCP_RCV_BUF:         2KB → 4KB      # 接收缓冲区
TCP_MSS:             1460           # 最大报文段长度
TCP_SND_QUEUELEN:    8 → 16         # 发送队列长度
2. 任务优先级
FreeRTOS 任务优先级:
  tcpip_thread    (最高)  → LwIP 协议栈主线程
  modbus_task     (中高)  → Modbus TCP 请求处理
  snmp_task       (中)    → SNMP 响应
  udp_push_task   (中低)  → UDP 告警推送
  sample_task     (低)    → 温湿度采样
3. 连接管理
传感器端连接策略:
  → 最大连接数限制:8(防止 BA 平台开太多连接)
  → 空闲超时:300s(无活动自动断开)
  → 半开连接检测:TCP Keepalive
  → 连接队列:backlog = 3(等待 accept 的队列)
五、网络层优化
1. 交换机配置
端口配置:
  → 端口安全:MAC 地址限制 1 个(防止非法设备接入)
  → BPDU Guard:启用(防止环路)
  → Storm Control:广播/组播抑制 10%
  → Flow Control:关闭(半双工才需要,全双工反而引入延迟)
  → EEE(节能以太网):关闭(增加延迟抖动)
  → PoE 优先级:Critical(传感器不断电)

VLAN 规划:
  VLAN 100: 传感器接入(独立监测 VLAN)
  VLAN 200: BA 平台
  VLAN 300: 动环平台

  路由策略:
    VLAN 200 → VLAN 100: 允许 Modbus TCP (502)
    VLAN 300 → VLAN 100: 允许 SNMP (161), UDP (8888)
2. 带宽计算
单台传感器带宽占用:
  Modbus TCP 请求:约 12 字节(MBAP 7 + PDU 5)
  Modbus TCP 响应:约 13 字节(MBAP 7 + 功能码 1 + 字节数 1 + 数据 4 + CRC 0)
  加上 TCP/IP 头部:约 54 字节
  单次请求+响应:约 133 字节

  30s 周期:133 × 2 / 30 = 8.9 bps(几乎可忽略)

  320 台同时轮询(假设 1 秒内完成):
  133 × 320 = 42,560 字节 ≈ 340 Kbps

  结论:带宽不是瓶颈,连接数和并发处理才是。
六、BA 平台对接实战
1. Niagara 对接优化
Niagara 4 (AX/N4) 对接要点:

1. 使用 ModbusTcpNetwork 而非逐个 ModbusTcpDevice
   → 共享连接池,减少握手开销

2. 配置 Network 级别的 Scan Rate 和 Timeout
   → 避免每个 Device 单独配置

3. 启用 Device Level Binding
   → 数据点绑定到 Device,而非直接轮询

4. 使用 Proxy Points
   → 创建 Proxy Ext 代理点,缓存数据
   → BA 逻辑读 Proxy 点,不直接读设备

5. 配置 Offline Poll Rate
   → 离线设备降低轮询频率(如 300s),减少无效请求

6. 使用 History 记录
   → 配置 History Ext 记录历史数据
   → 避免 BA 平台频繁查询历史
2. 数据点批量读取
Modbus TCP 支持批量读寄存器(功能码 0x03,读多个连续寄存器)

优化前:每个数据点单独请求
  温度请求 → 响应
  湿度请求 → 响应
  状态请求 → 响应
  (3 次请求/响应 = 6 个包)

优化后:一次读取多个寄存器
  读寄存器 0-9(温度+湿度+状态+其他)
  (1 次请求/响应 = 2 个包)

效果:减少 67% 的网络包数量
七、性能测试与验收
1. 测试指标
指标 | 目标值 | 测试方法 |
|---|---|---|
并发连接数 | ≥200 | 模拟 200 台设备同时连接 |
数据到达率 | ≥99.9% | 持续 24h 采集,统计成功/失败 |
平均响应时间 | <200ms | 统计 P50/P99 响应时间 |
CPU 占用率 | <50% | BA 平台/前置机 CPU 监控 |
内存占用 | 稳定无泄漏 | 持续 72h 监控 |
网络带宽 | <10Mbps | 交换机端口统计 |
连接数 | <1000(TIME_WAIT) | netstat 统计 |
2. 压力测试脚本
import asyncio
import time
from datetime import datetime

async def pressure_test(devices: List[str], duration: int = 3600):
    """压力测试:模拟 BA 平台并发采集"""
    start_time = time.time()
    results = {'success': 0, 'fail': 0, 'total_time': 0}

    async def test_device(ip: str):
        try:
            reader, writer = await asyncio.wait_for(
                asyncio.open_connection(ip, 502), timeout=3.0
            )
            # 发送 Modbus TCP 请求
            request = struct.pack('>HHHBBHH',
                                 1, 0, 6, 1, 0x03, 0, 2)
            writer.write(request)
            await writer.drain()
            response = await asyncio.wait_for(
                reader.read(256), timeout=2.0
            )
            writer.close()
            await writer.wait_closed()
            results['success'] += 1
        except Exception:
            results['fail'] += 1

    while time.time() - start_time < duration:
        tasks = [test_device(ip) for ip in devices]
        await asyncio.gather(*tasks)
        results['total_time'] = time.time() - start_time
        await asyncio.sleep(1)

    print(f"Test Results:")
    print(f"  Duration: {results['total_time']:.1f}s")
    print(f"  Success: {results['success']}")
    print(f"  Fail: {results['fail']}")
    print(f"  Success Rate: {results['success']/(results['success']+results['fail'])*100:.2f}%")

# 运行测试
devices = [f"192.168.100.{i}" for i in range(1, 201)]
asyncio.run(pressure_test(devices, duration=3600))
八、常见问题与解决方案
问题 | 原因 | 解决方案 |
|---|---|---|
BA 平台卡顿 | 轮询线程耗尽 | 分组轮询 + 连接池 |
数据延迟大 | 轮询周期太短 | 分级轮询,关键设备短周期 |
连接数过多 | 短连接未复用 | 长连接 + Keepalive |
交换机 CPU 高 | 广播风暴 | Storm Control + VLAN 隔离 |
传感器响应慢 | 并发连接超限 | 限制连接数 + 优化 LwIP |
数据丢失 | 采集端超时 | 增加超时时间 + 重试 |
内存泄漏 | 连接未正确关闭 | 空闲超时自动断开 |
九、一句话总结
楼宇自控平台对接数百台以太网温湿度变送器,核心不是"能不能读到",而是"怎么读才不把平台搞垮"。 分组轮询解决"别一起冲"的问题,连接池解决"别反复握手"的问题,前置机解决"BA 平台算力不够"的问题。 传感器端也要配合:LwIP 参数调优、连接数限制、任务优先级划分,确保被大量并发访问时不会死机。 最终交付的是一套从传感器到 BA 平台全链路的并发优化方案,让 500 台设备和 50 台设备一样流畅。
关键词:楼宇自控、BA平台、TCP/IP、以太网温湿度变送器、多设备并发、连接池、分组轮询、性能优化、Niagara、Modbus TCP、SNMP、前置机、asyncio、LwIP、连接管理、负载均衡
标签:#楼宇自控 #BA平台 #TCP/IP #以太网温湿度变送器 #多设备并发 #连接池 #性能优化 #Niagara #ModbusTCP #SNMP #前置机 #asyncio #LwIP #动环系统 #智能建筑
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号