#WorkBuddy# 我把 70 亿参数模型塞进旧笔记本跑了一周:踩了 3 个坑,也看清了它到底值不值
原创
#WorkBuddy# 我把 70 亿参数模型塞进旧笔记本跑了一周:踩了 3 个坑,也看清了它到底值不值
原创
GavinGeng
发布于 2026-09-24 17:59:32
发布于 2026-09-24 17:59:32
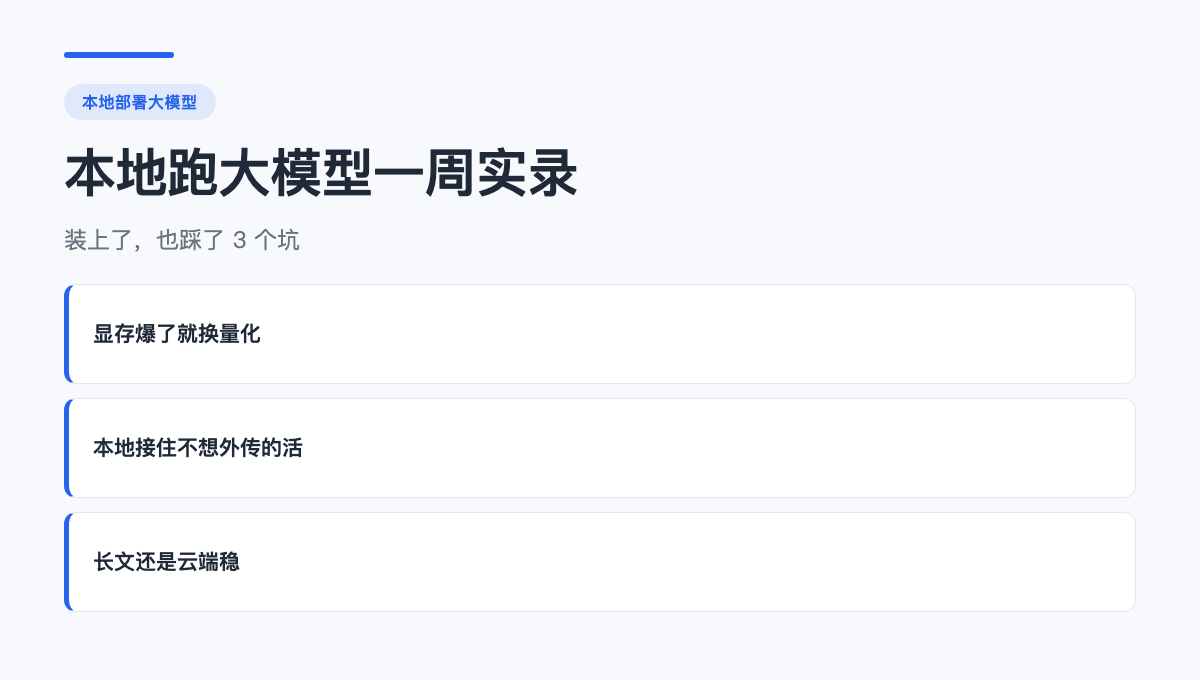
上周我把一个 70 亿参数的模型硬塞进了自己那台用了三年的笔记本,本想着能每个月省下一笔 API 账单。结果第一天就卡在显存上,风扇转得跟要起飞一样,浏览器还跟着一起卡死。
后来我换了条路:先用 Ollama 一行命令装好,发现还是卡,就换成 llama.cpp 的量化版;最后用 WorkBuddy 把「读本地文档 + 问答」串成一个固定流程,每天要查的旧资料直接问它,不用再开网页翻。中间查了不少教程,主要踩了三个坑:驱动版本对不上、贪精度下了原版爆显存、上下文开太长直接崩。
踩坑最狠的那次,是图省事下了 FP16 原版,16G 显存当场爆掉,啥也跑不了。后来老老实实换成 Q4_K_M 量化,体积砍到原来的四分之一,速度反而能看了。这一周用下来,写代码补全和本地知识库问答最顺手——尤其是一些不想往外传的内部资料,放本地问比丢给云端踏实。但真要写长文、做复杂推理,还是云端大模型更稳,本地那个容易啰嗦还跑偏。
这几条坑建议先收藏,下次装环境能少走两小时弯路。
我的判断是:本地模型不是来替代云端的,它是来接住那类「不想出域、不想花钱、想随时能跑」的活儿的。把它当云端备胎和隐私兜底层,比硬刚性能现实得多。你最想用本地模型干哪件事?评论区说一个,我帮你挑具体型号再给到能直接跑的命令。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号