数据脱敏规则版本化与灰度发布:改错如何秒级回滚不误伤业务
原创
数据脱敏规则版本化与灰度发布:改错如何秒级回滚不误伤业务
原创
用户12597027
发布于 2026-09-26 15:39:05
发布于 2026-09-26 15:39:05
摘要:围绕数据脱敏规则的版本化存储、灰度发布、影子校验、一键回滚与误报回收,系统梳理动态脱敏策略在变更过程中的工程化治理方法,帮助团队在规则改错时既能快速恢复又不误伤业务。 正在上传图片...
关键词:数据脱敏,动态脱敏,静态脱敏,脱敏规则,灰度发布,回滚,敏感字段,影子模式,误报回收,数据库脱敏
一、为什么脱敏规则也需要版本管理
在数据库动态脱敏的落地过程中,技术团队往往把重心放在"能不能脱敏"上,而忽略了"规则改错了怎么办"。但事实上,脱敏规则本身是一份会持续演进的策略文件:新业务上线要补充字段映射,合规口径调整要收紧手机号展示,某次误判导致报表崩了又要紧急撤销。把脱敏当成一次性配置,是生产环境里最容易被低估的风险点。
一份看似简单的脱敏规则,背后至少关联着三类风险:
- 误伤业务:把本该明文返回给客服系统的字段脱成了掩码,前端列表一片星号,工单无法处理。
- 脱敏不足:新接入一张表忘记登记敏感字段,数据在运维查询、报表导出时以明文流出,形成内部数据泄露。
- 难以追责:规则是谁改的、改之前是什么样、为什么回滚,如果只有"最新一份"文件,事后复盘几乎不可能。
脱敏规则的变更不是改一个配置文件那么简单,它本质上是一个策略发布过程,应当具备和代码发布同等的工程纪律:可版本化、可灰度、可回滚、可验证。本文围绕脱敏规则版本管理、灰度发布、一键回滚、影子模式验证、误报回收机制五个主题展开,结合一个典型落地架构,给出可操作的实现细节。
二、脱敏规则版本化存储的设计
所谓版本化,核心是把"当前生效的规则"和"历史上每一版规则"都结构化地保存下来,并且能精确追溯到任意时间点的快照。静态脱敏与动态脱敏共用同一套敏感字段清单,但只有动态脱敏需要在返回链路上实时选规则,因此版本化对动态脱敏更关键。
2.1 数据结构设计
不要把规则写成散落的 SQL 或 JSON 文本,而是抽象成统一的结构化对象。一个可行的 schema 如下:
# 脱敏规则集的版本化数据结构(示意)
class RuleSet:
    rule_set_id: str          # 规则集唯一标识
    version: int              # 单调递增版本号
    parent_version: int       # 上一版版本号,构成版本链
    status: str               # DRAFT / GRAY / ACTIVE / ROLLEDBACK
    created_by: str           # 变更人
    created_at: int           # 变更时间
    change_note: str          # 变更说明
    rules: list               # 本版全部规则


class Rule:
    rule_id: str
    table: str                # 库.表
    column: str               # 敏感字段
    data_type: str            # PHONE / ID_CARD / BANK_CARD / NAME / CUSTOM
    algorithm: str            # MASK / FPE / HASH / REDACT
    condition: str            # 命中条件(角色/来源/时间)
    priority: int             # 同字段多规则时的优先级
关键点在于 parent_version 字段。它通过单向指针把每一次变更串成一条链,使得回滚不是"猜着改回去",而是"把指针切到上一节点"。同时,status 让运维一眼看出当前到底哪版在生产、哪版在灰度、哪版已被废弃。
2.2 存储与不可变性
版本化存储有几个工程约束必须守住:
约束 | 做法 | 目的 |
|---|---|---|
已发布版本不可变 | 发布后只读,修改必须新建版本 | 保证审计链条完整 |
全量快照而非 diff | 每版保存完整规则集 | 回滚时无需重放增量 |
写入即留痕 | 每次变更落审计表 | 满足合规举证 |
双存储 | 内存热表 + 持久化库 | 网关重启不丢版本链 |
透明代理把规则集以版本快照加载进内存热表,对每条 SQL 的字段解析结果直接命中当前 ACTIVE 版本,避免每次请求都远程拉取配置,这也是脱敏损耗可控的工程前提之一。
三、灰度发布:让新规则先跑一部分流量
规则上线最怕"全量一把梭"。灰度发布的思路是:新规则先对一小部分流量生效,观察脱敏结果是否符合预期,再逐步放大比例。动态脱敏网关处于应用与数据库之间,应用发来的仍是原始 SQL,版本切换对应用完全透明。
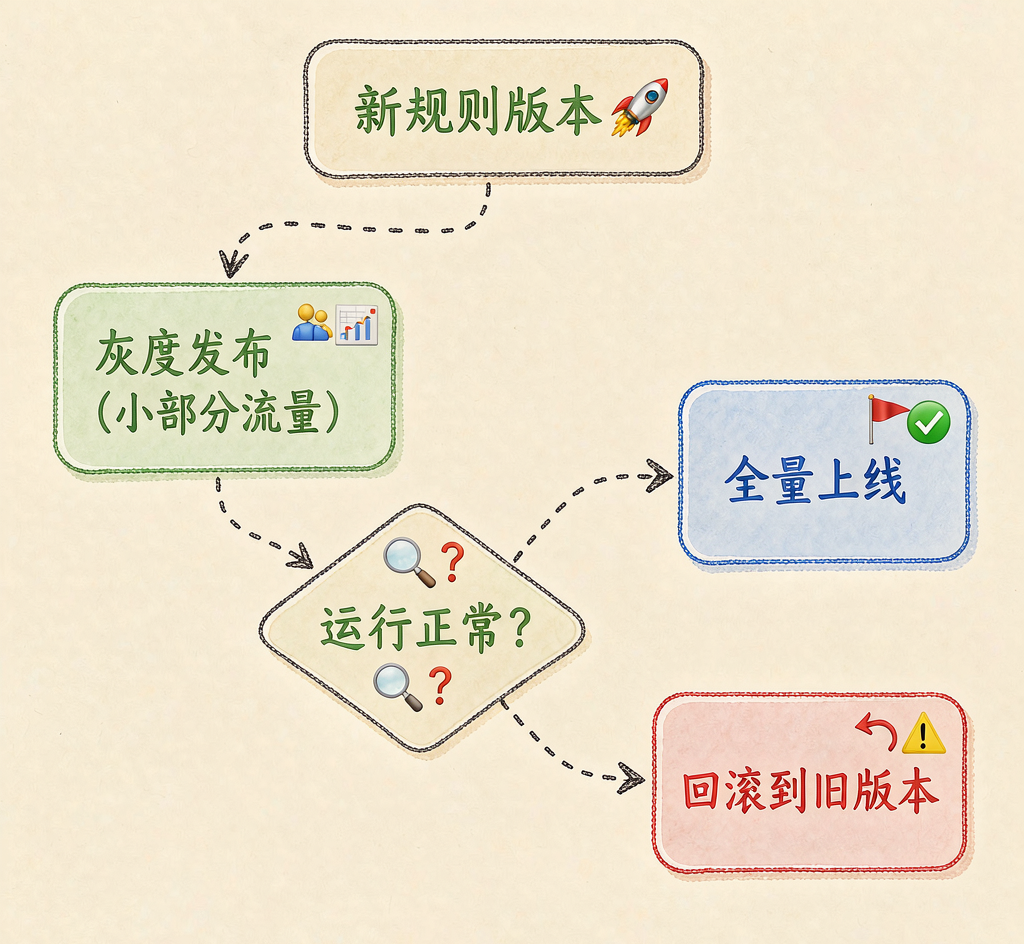
脱敏规则版本与灰度发布流程示意
3.1 灰度维度
脱敏规则的灰度,通常可以按以下维度切分:
- 按来源 IP / 应用标识:先放内部测试系统的流量,再放真实业务。
- 按数据库用户 / 角色:先对只读报表账号生效,再对交易账号生效。
- 按表 / 字段范围:先灰度一张低风险表,验证无误再铺开。
- 按流量比例:随机取 1%、5%、20% 的会话走新规则。
3.2 灰度路由伪代码
def pick_rule_set(session, gray_policy, active_set, gray_set):
    cfg = gray_policy.get(session.db_user)
    if cfg is None or not cfg.enable:
        return active_set
    # 按比例命中灰度版本,同一会话稳定命中同一版本
    if hash(session.session_id) % 100 < cfg.percent:
        return gray_set
    return active_set
这里的核心是 session_id 的哈希取模,保证同一个会话在灰度期间稳定命中同一版本,不会出现"同一条查询时而脱敏时而不脱敏"的抖动。
四、影子模式验证:不改业务先验证逻辑
灰度虽然降低了风险,但它毕竟已经影响了一部分真实流量。在规则改动较大(比如重构了敏感字段识别逻辑)时,更稳妥的做法是先进入影子模式。
4.1 影子模式的运行机制
影子模式下,网关同时加载 ACTIVE 版本和 SHADOW 版本两套规则:
- 真实请求仍由 ACTIVE 版本处理,返回给应用的是旧逻辑结果,业务零影响。
- 网关内部用 SHADOW 版本对同一份查询结果再做一次脱敏计算。
- 两套结果做 diff,把"不一致"的字段记录下来,但不下发给应用。
def on_result(rows, active_set, shadow_set):
    for row in rows:
        a = apply_mask(row, active_set)
        s = apply_mask(row, shadow_set)
        if a != s:
            log_shadow_mismatch(row.id, row.column, a, s)
    return a   # 仅返回 ACTIVE 结果
4.2 影子模式能发现什么
通过影子 diff,团队可以在不影响任何业务的情况下,提前暴露三类问题:
- 新规则把原本明文展示的字段脱掉了(潜在误伤)。
- 新规则漏掉了某张新表的敏感字段(潜在脱敏不足)。
- 新旧规则在边界值上表现不一致(如身份证末位 X 的处理)。
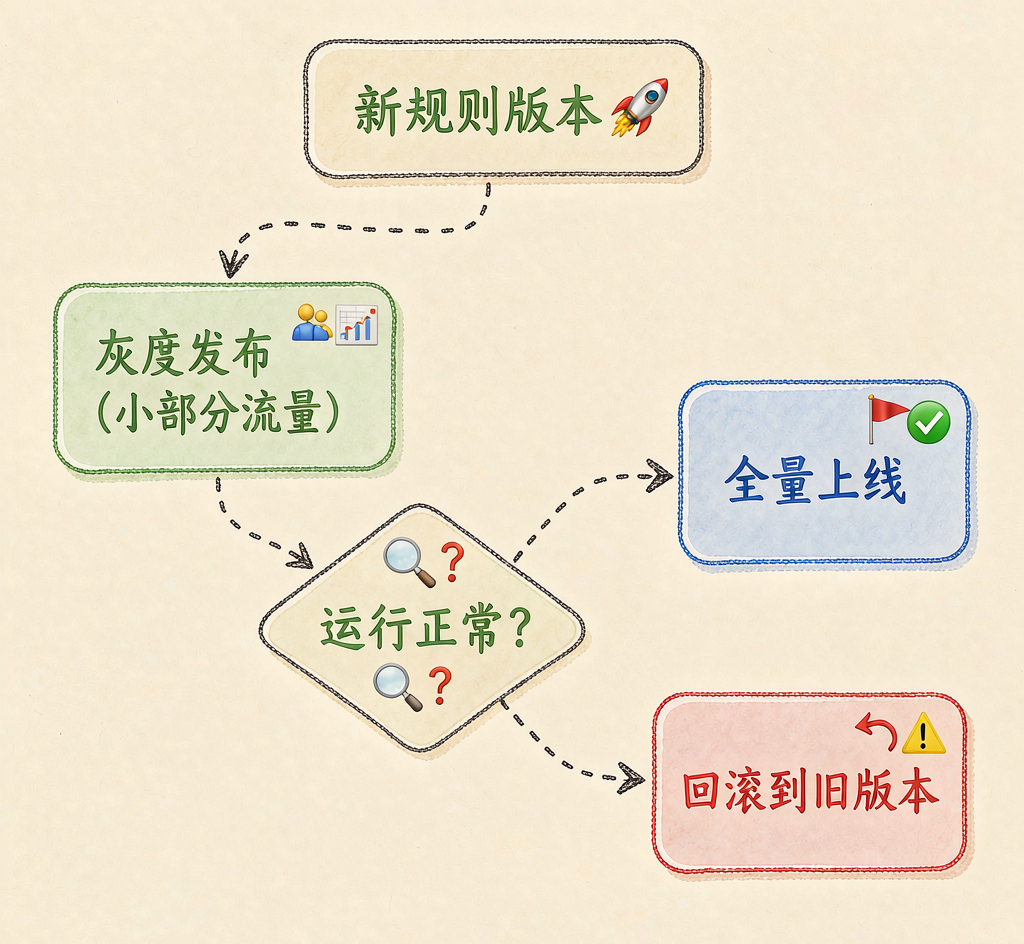
影子模式与误报回收机制示意
五、一键回滚:出事了怎么秒级退回
无论灰度多充分,生产环境总有意外。回滚能力的核心指标只有一个:从发现异常到业务恢复,能不能在秒级完成,且不丢历史。
5.1 回滚不是"反向修改"
很多团队回滚靠的是"把刚才那行配置改回去"。这有两个致命问题:第一,改回去的动作本身又是一份未被充分验证的变更;第二,你很难精确还原到"出问题之前那一刻"的状态。
版本化存储让回滚变成一次指针切换:
def rollback(target_version, current, hot_table, audit):
    if not version_exists(target_version):
        raise ValueError("版本不存在")
    if is_child_of(target_version, current):
        raise ValueError("不能回滚到未来版本")
    current.status = "ROLLEDBACK"
    target_version.status = "ACTIVE"
    hot_table.reload(target_version)   # 热表原子切换
    audit.log("ROLLBACK", current.version, target_version.version)
注意 hot_table.reload 必须是原子操作——要么全用新版本,要么全用旧版本,绝不能出现请求一半命中新版、一半命中旧版的窗口期。原子切换配合持久化版本链,回滚后应用侧无感知,数据库侧也无任何改动,因为脱敏发生在返回链路上而非存储层。
5.2 回滚边界
需要明确:一键回滚只回退脱敏规则版本,不回退底层数据;若存储层字段已被新密钥重写,属数据迁移范畴,不在规则回滚责任区。实施时应区分"规则变更"与"数据变更"两条流水线。
六、误报回收机制:把误杀的数据救回来
比回滚更细的问题是"误报"。所谓误报,是指某条规则把不该脱敏的数据脱了,或者脱错了格式,导致业务侧拿到不可用的值。回滚是全局动作,误报往往只需要局部回收。
6.1 误报的几种形态
误报形态 | 现象 | 回收方式 |
|---|---|---|
整字段误脱 | 字段本应明文,被全掩码 | 对该字段规则做版本回退 |
格式错乱 | 手机号脱成长度不符 | 切换更稳妥的算法(如 FPE 保留格式) |
条件误判 | 白名单角色也被脱敏 | 修正 condition 表达式后灰度 |
关联错列 | A 列规则套到了 B 列 | 更正字段映射并热更新 |
6.2 影子回收:先验证再下发
误报回收同样建议借助影子模式。把"修正后的候选规则"作为 SHADOW 版本运行,对比当前 ACTIVE 下发的真实结果,确认候选版本能正确还原业务所需的数据形态后,再做小比例灰度,最后全量。
def recycle_misreport(field):
    candidate = build_candidate(field)        # 基于历史版本修正
    enable_shadow(candidate)                  # 影子跑,不直接生效
    wait(diff_stable_for="2h")                # 观察 2 小时
    if shadow_mismatch_count() == 0:
        promote_to_gray(candidate, percent=5)
        if gray_healthy():
            promote_to_active(candidate)
    else:
        keep_shadow()                         # 继续观察,不晋级
这种"先影子、后灰度、再全量"的回收节奏,比直接全量替换候选规则安全得多,也避免了一次修复动作引入第二次误报。
七、灰度发布的指标观测与自动熔断
灰度不是把比例调上去就完事,真正决定灰度成败的是"有没有足够的观测手段在出问题前踩刹车"。脱敏规则灰度期间,至少要盯住四类指标。
7.1 业务侧指标
- 可用率:被灰度命中的接口返回成功率是否持平基线。脱敏把字段脱错,常表现为下游解析失败、空值异常、格式校验报错。
- 时延:脱敏改写与双算会引入额外 CPU,灰度放大时若时延曲线抬升超过阈值应警觉。
- 报错聚类:把灰度流量的异常堆栈按类型聚合,若某类"字段格式非法""空指针"突增,多半是脱敏规则误伤。
7.2 脱敏侧指标
- 命中分布:各算法(掩码、FPE、哈希)的实际命中次数,验证新规则是否按预期作用到目标敏感字段。
- 漏脱计数:影子或审计中发现本应脱敏却未脱敏的次数,这是比误伤更危险的信号。
- 误脱计数:不该脱敏却被脱敏的次数,对应误报回收的触发源。
7.3 自动熔断伪代码
当观测指标突破阈值,应当能自动把灰度比例降回零,而不是等人工发现:
def watch_gray(version, metric):
    while True:
        sleep(30)
        err_rate = metric.err_rate(version)
        miss_rate = metric.miss_mask(version)
        if err_rate > 0.01 or miss_rate > 0:
            set_gray_percent(version, 0)      # 熔断,流量回退 ACTIVE
            alert(f"灰度熔断: 版本 {version}")
            break
        if healthy_for("30m"):
            auto_promote(version)             # 健康则自动晋级
需要强调:"漏脱"熔断阈值应设为 0,一次该脱敏却未脱敏即须立即熔断排查,因一次漏脱足以构成泄露;"误脱"可容忍极低比例观察窗口,因其只影响可用性、不直接泄露。
八、规则冲突与优先级仲裁
当同一字段同时存在多条规则(例如全局默认规则与某角色专属规则、旧版本残留规则与新版本规则),必须有一套确定性的仲裁机制,否则"同字段两种结果"会让灰度 diff 永远对不齐。
8.1 仲裁三原则
- 显式优先于隐式:带明确
condition(如指定角色、指定来源)的规则,优先于默认全局规则。 - 高优先级优先:
priority字段数值大的胜出,用于解决同粒度冲突。 - 新版本优先:在灰度/影子并存时,以
version较新者作为候选,旧版本仅作回退基准。
仲裁结果必须可解释:网关在命中某条规则后应能输出"为何选它",这对事后审计和误报定位极为关键。一个实用的做法是把仲裁链路随每条查询结果一起记录到审计流,出问题时直接回看"这条数据最终被哪条规则、以什么优先级处理"。
8.2 冲突检测的发布前置校验
在版本发布前,除了语法校验,还应做一次冲突静态分析:扫描新规则集,找出同字段多规则组合,预判是否存在优先级模糊、条件重叠导致的非确定性。把这类问题挡在发布门外,比在灰度期靠 diff 去捞要高效得多。
九、工程落地中的几个权衡
把以上机制拼起来,还要注意几个现实问题。版本号建议单调递增且全局唯一,配合发布审批流,涉及高敏感字段(如银行卡、身份证)的变更应保留"提交 → 评审 → 灰度 → 全量"关卡。每次版本创建、灰度、回滚、误报回收都应写入不可篡改的审计表,字段含操作人、时间、源版本、目标版本、变更说明,作为复盘与合规举证基础。版本热表切换与影子双算带来额外开销,影子模式建议只在变更评估窗口开启;灰度比例从低到高,给网关与下游渐进适应。动态脱敏负责"查看时"呈现,字段级加密负责"存储时"保护,版本管理只管呈现策略层,勿与密钥轮换、存储重写混谈,否则回滚边界模糊。
十、一次完整的规则变更推演
把前面的机制串成一个具体场景,能更直观地看到流水线如何运转。假设某电商要把"收货人手机号"的脱敏策略从"中间四位打星"升级为"保留格式加密(FPE),使客服系统仍能做后四位核对"。
- 建版:基于当前 ACTIVE(版本 12)新建版本 13,仅改动手机号字段的
algorithm由 MASK 改为 FPE,并写好change_note与parent_version=12。 - 影子:开启影子模式,版本 13 作为 SHADOW 与版本 12 同时计算。两天内影子 diff 显示:旧逻辑输出
138****1234,新逻辑输出1386721**34(保留后四位),业务可读;漏脱计数为 0,误脱计数 0。 - 灰度:将版本 13 按 5% 比例放量给内部客服测试账号。观测指标显示可用率持平,时延无抬升,自动熔断未触发。
- 晋级:健康 30 分钟后自动晋级到 20%、50%,最终全量切为 ACTIVE,版本 12 标记 ROLLEDBACK 留作回退基准。
- 突发:上线第三天,某报表系统反馈导出的手机号无法被下游 ETL 识别。经查是 FPE 密文含特殊字符触发解析异常。
- 回滚:运维一键将 ACTIVE 切回版本 12,热表原子切换,业务在秒级恢复明文打星格式,报表恢复正常。
- 回收:针对报表来源账号,在版本 13 基础上新建版本 14,把该来源的手机号改回 MASK,再次走影子 → 灰度 → 全量,最终实现"客服用 FPE、报表用 MASK"的差异化策略。
这个推演里,真正救命的不是某一项技术,而是"任何变更都留版本、任何上线都先影子、任何异常都能秒回"的纪律。技术只是把纪律变成了可执行、可审计、可重复的动作。
方案参考
在规则治理落地中,可参考安当DBG(数据库动态脱敏网关)这类支持脱敏规则版本化、灰度发布与一键回滚、并提供影子模式与误报回收能力的产品形态作为对照,结合业务敏感度分级推进脱敏策略的平滑演进。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号