档案库房传感网络可靠性设计:温湿度节点掉线排查与容错机制实现
原创
档案库房传感网络可靠性设计:温湿度节点掉线排查与容错机制实现
原创
BJ盛世宏博小程
发布于 2026-09-28 13:30:56
发布于 2026-09-28 13:30:56
档案库房传感网络可靠性设计:温湿度节点掉线排查与容错机制实现
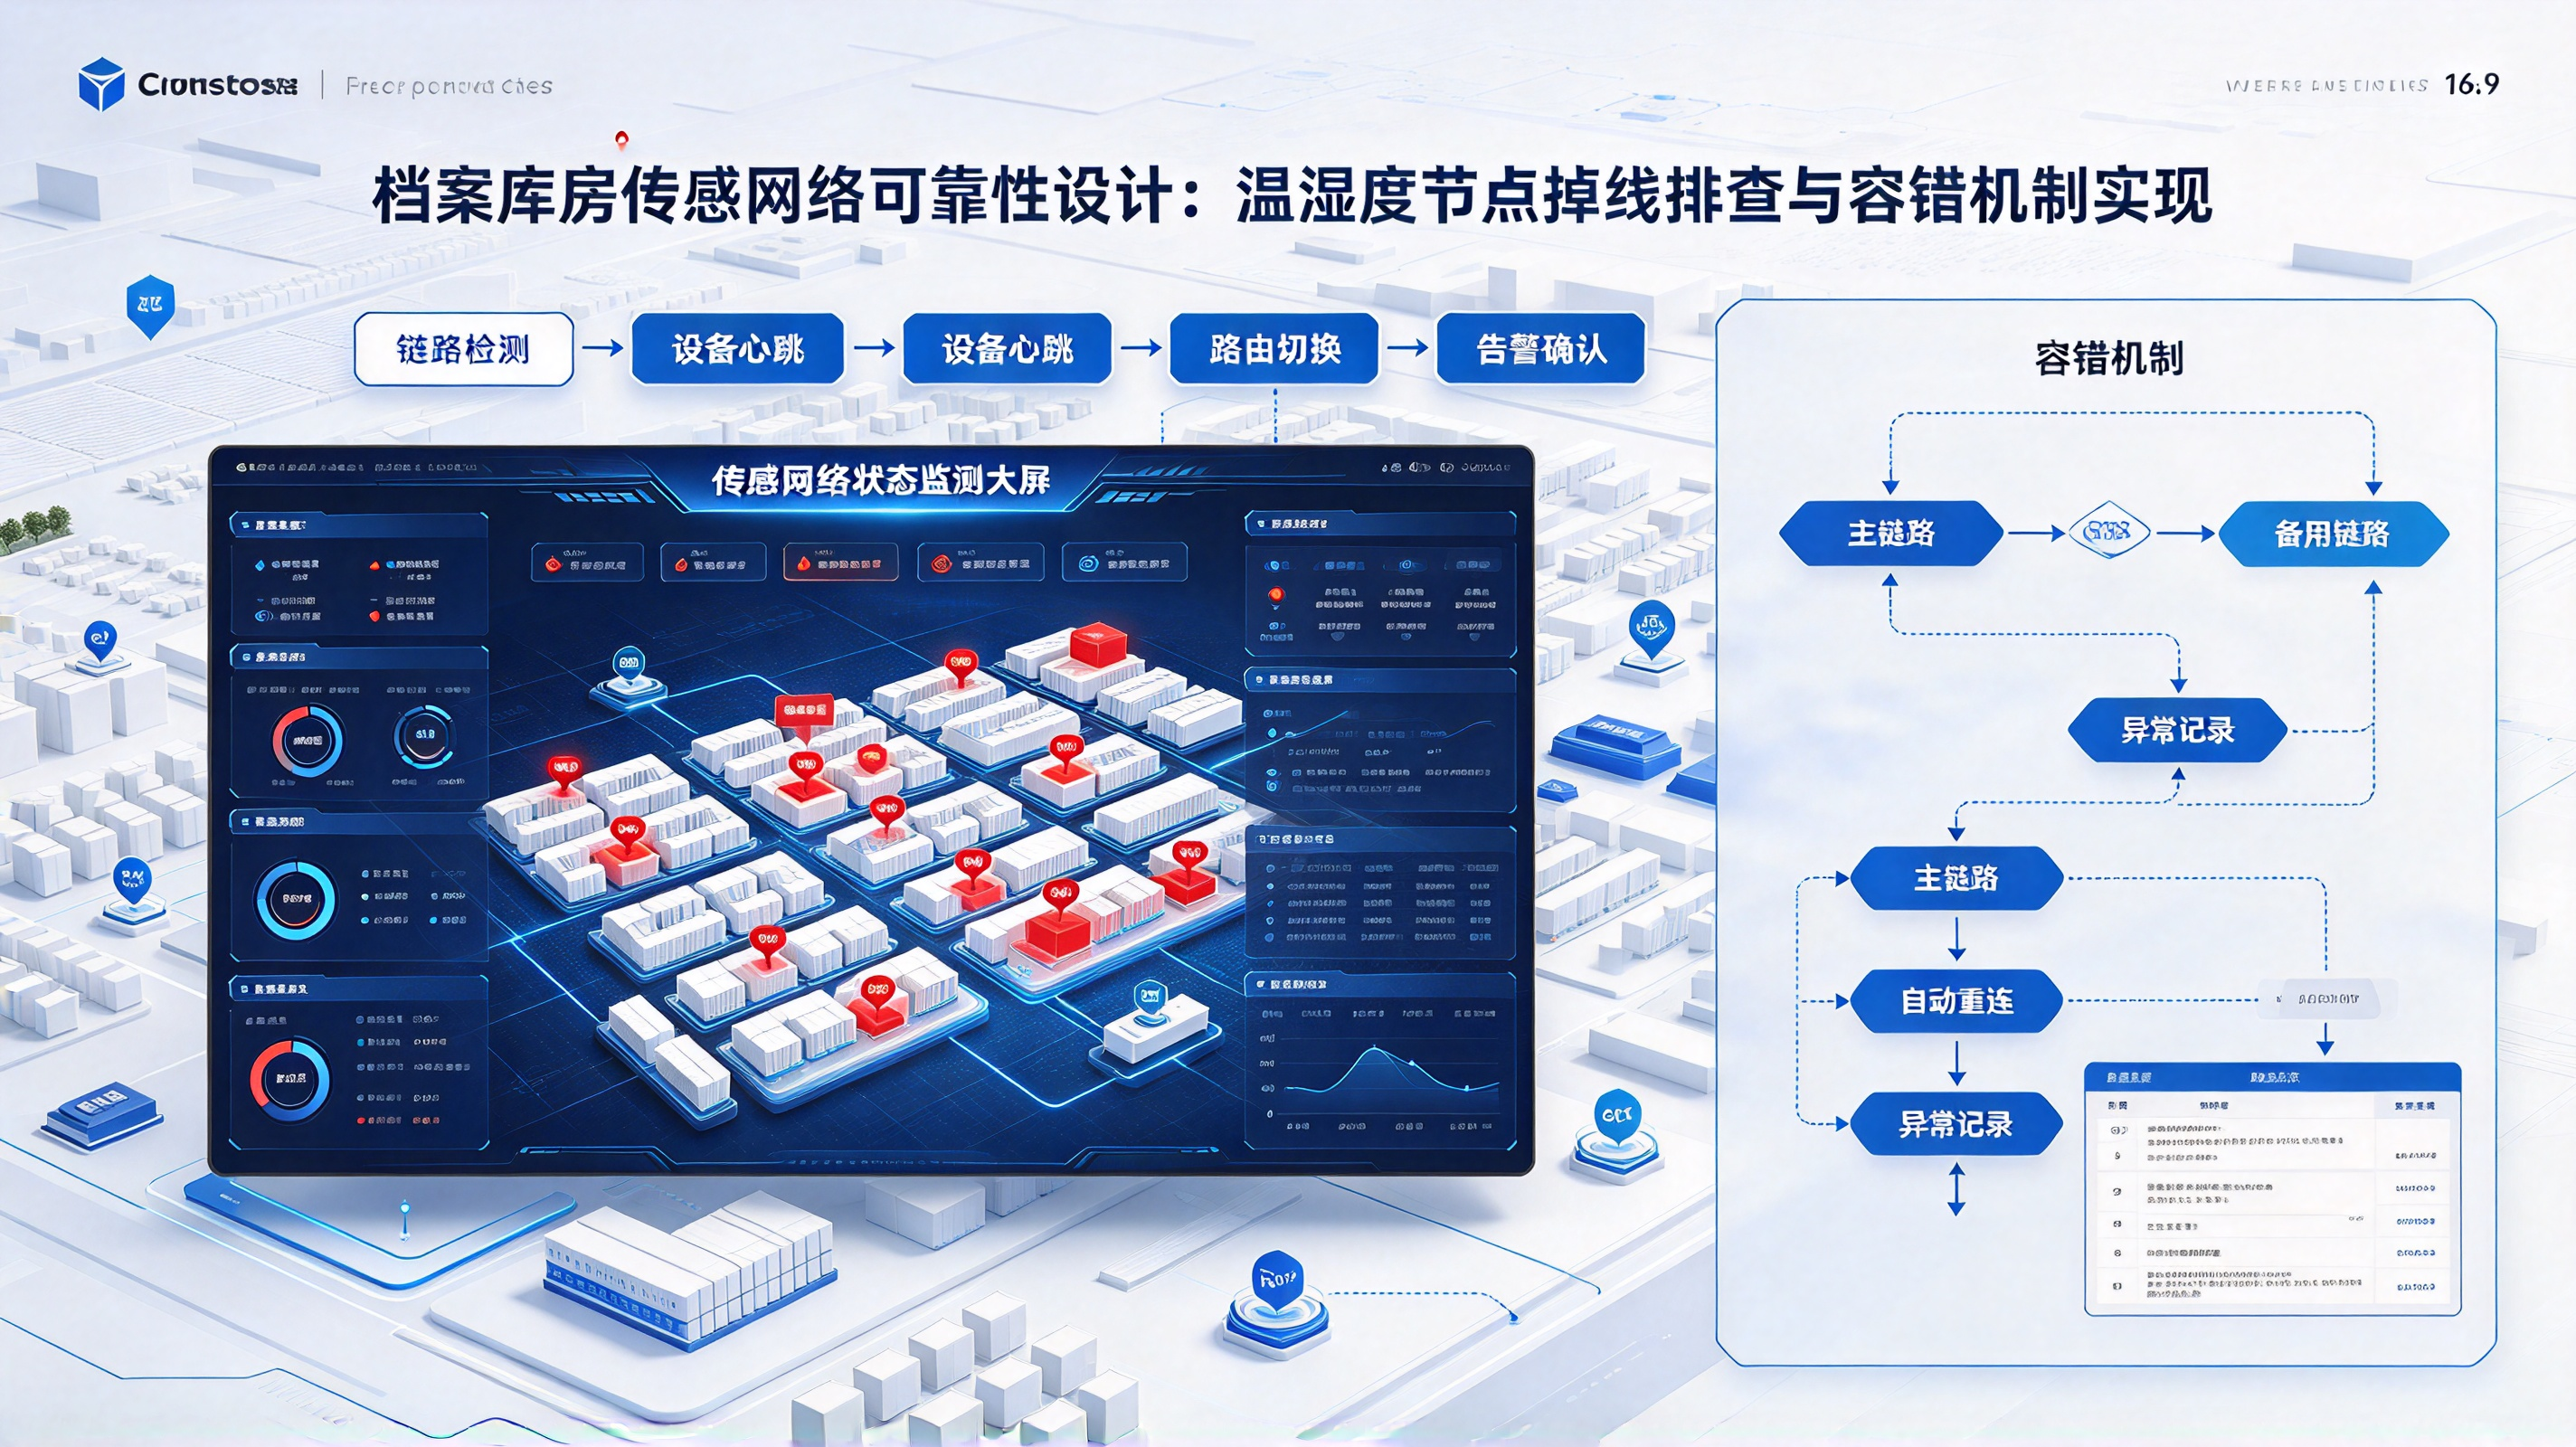
一、档案库房的"隐形"可靠性要求
档案库房的环境监测有一个容易被忽视的特点:它不需要实时性,但需要绝对连续性。
与机房动环(秒级告警)、实验室工位(实验周期内连续)不同,档案库房的环境数据要求24小时×365天不间断记录,因为任何一次数据中断都可能导致:
- 无法证明某段时间内温湿度是否合规(影响档案验收、审计)
- 温湿度超限时未能及时发现(纸质档案、胶片、磁介质的不可逆损伤)
- 历史趋势分析出现断层(无法判断是偶发波动还是系统性漂移)
档案库房传感网络的典型拓扑:
┌─────────────────────────────────────────────────────────────────────┐
│ 档案库房(密集架区,约2000㎡)                                      │
│                                                                     │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐               │
│  │ 温湿度节点#1 │  │ 温湿度节点#2 │  │ 温湿度节点#3 │  ... × 40   │
│  │ (密集架A1)  │  │ (密集架A2)  │  │ (密集架A3)  │               │
│  │ RS485/无线  │  │ RS485/无线  │  │ RS485/无线  │               │
│  └──────┬──────┘  └──────┬──────┘  └──────┬──────┘               │
│         └──────────────────┼──────────────────┘                    │
│                            │                                       │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐               │
│  │ 温湿度节点#21│  │ 温湿度节点#22│  │ 温湿度节点#23│  ... × 40   │
│  │ (密集架B1)  │  │ (密集架B2)  │  │ (密集架B3)  │               │
│  └──────┬──────┘  └──────┬──────┘  └──────┬──────┘               │
│         └──────────────────┼──────────────────┘                    │
│                            │                                       │
│                     ┌──────▼───────┐                               │
│                     │ 区域采集器    │ × 4台(每500㎡一台)         │
│                     │ (RS485主站)  │                               │
│                     └──────┬───────┘                               │
│                            │ TCP/IP                                 │
└────────────────────────────┼────────────────────────────────────────┘
                             │
┌────────────────────────────┼────────────────────────────────────────┐
│ 监控中心                    │                                      │
│                            │                                      │
│  ┌─────────────────────────▼───────────────────────────────────┐  │
│  │ 监控服务器(主)                                          │  │
│  │  - 节点状态心跳检测                                       │  │
│  │  - 掉线检测与告警                                         │  │
│  │  - 容错数据补偿(插值/邻近推算)                           │  │
│  │  - 本地数据库(SQLite/MySQL)                             │  │
│  └─────────────────────────────────────────────────────────────┘  │
│                            │                                       │
│  ┌─────────────────────────▼───────────────────────────────────┐  │
│  │ 监控服务器(备)                                          │  │
│  │  - 主备心跳同步                                           │  │
│  │  - 自动接管                                               │  │
│  └─────────────────────────────────────────────────────────────┘  │
│                            │                                       │
│  ┌─────────────────────────▼───────────────────────────────────┐  │
│  │ 展示层:Web + 大屏 + 短信/邮件告警                         │  │
│  └─────────────────────────────────────────────────────────────┘  │
└─────────────────────────────────────────────────────────────────────┘核心设计矛盾:
矛盾 | 表现 | 后果 |
|---|---|---|
节点数量多 vs 维护人力少 | 80个节点,1名管理员 | 单个节点掉线可能数小时才发现 |
有线可靠 vs 无线灵活 | RS485布线难、Wi-Fi覆盖不均 | 部分区域信号弱,间歇性掉线 |
连续记录 vs 节点故障 | 节点坏了,数据就断了 | 合规审计无法通过 |
实时告警 vs 误报疲劳 | 网络抖动导致短暂掉线 | 频繁误报导致管理员麻木 |
二、节点掉线的根因分类
2.1 掉线类型矩阵
┌──────────────────────────────────────────────┐
                    │           掉线持续时间                       │
                    ├──────────────┬───────────────┬──────────────┤
                    │  短暂 (<30s) │  间歇 (30s~1h) │  持续 (>1h) │
┌──────────┬────────┼──────────────┼───────────────┼──────────────┤
│          │ 物理层 │ 接头松动     │ 网线被压       │ 网线断裂    │
│          │        │ 水晶头氧化   │ 电源适配器发热 │ 交换机断电  │
│ 故障     ├────────┼──────────────┼───────────────┼──────────────┤
│ 层次     │ 链路层 │ 交换机端口   │ 交换机端口     │ 交换机端口  │
│          │        │ 瞬间阻塞     │ 频繁up/down   │ 永久关闭    │
│          ├────────┼──────────────┼───────────────┼──────────────┤
│          │ 网络层 │ DHCP租约续订 │ IP冲突         │ 路由黑洞    │
│          │        │ ARP缓存刷新  │ 子网隔离       │ VLAN配置丢失│
├──────────┼────────┼──────────────┼───────────────┼──────────────┤
│          │ 节点   │ 看门狗复位   │ 传感器死机     │ Flash损坏  │
│          │ 自身   │ 采样任务阻塞 │ 内存泄漏累积   │ 硬件烧毁   │
└──────────┴────────┴──────────────┴───────────────┴──────────────┘
2.2 档案库房特有的掉线原因
原因 | 机理 | 发生频率 |
|---|---|---|
密集架移动拉扯网线 | 密集架轨道移动时,架体间的网线被拉伸、挤压 | 中 |
除湿机频繁启停导致电压波动 | 除湿机大功率压缩机启停产生电压跌落 | 高 |
档案搬运碰撞节点 | 搬运档案箱时碰撞壁挂式节点 | 低 |
金属密集架屏蔽无线信号 | 密集架合拢时形成法拉第笼,无线节点失联 | 高(无线方案) |
灰尘覆盖散热孔 | 长期未清洁,节点过热死机 | 低 |
三、心跳检测与掉线判定机制
3.1 心跳协议设计
节点与采集器之间采用双向心跳:
节点 → 采集器:数据报文(每30秒)
节点 ← 采集器:心跳查询(每60秒)
心跳报文格式(紧凑二进制,16字节):
┌──────────┬──────────┬────────────┬──────────────────────────────────┐
│ 偏移     │ 长度     │ 字段       │ 说明                             │
├──────────┼──────────┼────────────┼──────────────────────────────────┤
│ 0        │ 2        │ 魔数       │ 0x5AA5                          │
│ 2        │ 1        │ 消息类型   │ 0x01=数据, 0x02=心跳请求       │
│          │          │            │ 0x03=心跳响应, 0x04=告警        │
│ 3        │ 1        │ 节点状态   │ Bit0=在线, Bit1=低电量...       │
│ 4        │ 4        │ 节点ID     │ 唯一标识                        │
│ 8        │ 4        │ 序列号     │ 递增计数器                      │
│ 12       │ 2        │ 运行时间   │ 节点上电后秒数(高位)          │
│ 14       │ 2        │ CRC16      │ 校验                            │
│ 总计     │ 16字节   │            │                                  │
└──────────┴──────────┴────────────┴──────────────────────────────────┘
3.2 掉线判定状态机
┌──────────────────────────────────────┐
                    │                                      │
                    ▼                                      │
┌───────────┐    ┌───────────┐    ┌───────────┐    ┌───────────┐
│  UNKNOWN  │───▶│   ONLINE  │───▶│  DEGRADED │───▶│   OFFLINE │
│  (未知)   │    │  (在线)   │    │  (降级)   │    │  (离线)   │
└───────────┘    └───────────┘    └───────────┘    └───────────┘
     ▲                │                  │                  │
     │                │                  │                  │
     │                ▼                  ▼                  ▼
     │        连续3次心跳      连续1~3次心跳       连续>3次心跳
     │        正常响应          丢失/超时          丢失/超时
     │                                                  │
     │        自动恢复 ───────────────────────────────────┘
     │        (节点重新上线)
     │
└── 系统启动初始化判定参数:
参数 | 值 | 说明 |
|---|---|---|
心跳间隔 | 60秒 | 采集器→节点 |
数据间隔 | 30秒 | 节点→采集器 |
单次超时 | 5秒 | 心跳请求后5秒无响应即判定超时 |
降级阈值 | 连续1~3次超时 | 进入DEGRADED状态,触发预警 |
离线阈值 | 连续>3次超时 | 进入OFFLINE状态,触发告警 |
自动恢复 | 连续3次正常 | 从OFFLINE回到ONLINE |
3.3 心跳检测代码实现
# heartbeat_monitor.py
import time
import threading
from enum import Enum
from dataclasses import dataclass, field
from typing import Dict, List, Callable

class NodeState(Enum):
    UNKNOWN = 0
    ONLINE = 1
    DEGRADED = 2
    OFFLINE = 3

@dataclass
class NodeStatus:
    node_id: int
    state: NodeState = NodeState.UNKNOWN
    consecutive_timeouts: int = 0
    consecutive_successes: int = 0
    last_seen: float = 0.0
    last_data_time: float = 0.0
    total_packets: int = 0
    lost_packets: int = 0
    latency_ms: float = 0.0

@dataclass
class HeartbeatConfig:
    heartbeat_interval: float = 60.0    # 心跳间隔(秒)
    data_interval: float = 30.0         # 数据上报间隔(秒)
    timeout: float = 5.0                # 单次超时(秒)
    degraded_threshold: int = 1          # 降级阈值(连续超时次数)
    offline_threshold: int = 3           # 离线阈值(连续超时次数)
    recovery_threshold: int = 3           # 恢复阈值(连续成功次数)
    max_data_age: float = 120.0          # 数据最大允许间隔(秒)

class HeartbeatMonitor:
    def __init__(self, config: HeartbeatConfig):
        self.config = config
        self.nodes: Dict[int, NodeStatus] = {}
        self.lock = threading.RLock()
        self.running = False
        self._thread = None
        # 回调函数
        self.on_state_change: Callable[[int, NodeState, NodeState], None] = None
        self.on_data_timeout: Callable[[int], None] = None

    def register_node(self, node_id: int):
        with self.lock:
            if node_id not in self.nodes:
                self.nodes[node_id] = NodeStatus(node_id=node_id)
                print(f"Node {node_id} registered")

    def record_data_received(self, node_id: int, latency_ms: float = 0.0):
        """记录节点数据到达"""
        with self.lock:
            if node_id not in self.nodes:
                self.register_node(node_id)
            node = self.nodes[node_id]
            node.last_data_time = time.time()
            node.total_packets += 1
            node.latency_ms = latency_ms
            # 数据到达说明节点在线
            if node.state != NodeState.ONLINE:
                old_state = node.state
                node.state = NodeState.ONLINE
                node.consecutive_timeouts = 0
                node.consecutive_successes = 0
                if self.on_state_change:
                    self.on_state_change(node_id, old_state, NodeState.ONLINE)

    def record_heartbeat_response(self, node_id: int, latency_ms: float = 0.0):
        """记录心跳响应"""
        with self.lock:
            if node_id not in self.nodes:
                return
            node = self.nodes[node_id]
            node.last_seen = time.time()
            node.latency_ms = latency_ms
            node.consecutive_timeouts = 0
            node.consecutive_successes += 1

            # 检查是否需要恢复
            if node.state in (NodeState.DEGRADED, NodeState.OFFLINE):
                if node.consecutive_successes >= self.config.recovery_threshold:
                    old_state = node.state
                    node.state = NodeState.ONLINE
                    if self.on_state_change:
                        self.on_state_change(node_id, old_state, NodeState.ONLINE)

    def record_heartbeat_timeout(self, node_id: int):
        """记录心跳超时"""
        with self.lock:
            if node_id not in self.nodes:
                return
            node = self.nodes[node_id]
            node.consecutive_timeouts += 1
            node.consecutive_successes = 0
            node.lost_packets += 1

            # 状态迁移
            new_state = node.state
            if node.consecutive_timeouts >= self.config.offline_threshold:
                new_state = NodeState.OFFLINE
            elif node.consecutive_timeouts >= self.config.degraded_threshold:
                new_state = NodeState.DEGRADED

            if new_state != node.state:
                old_state = node.state
                node.state = new_state
                if self.on_state_change:
                    self.on_state_change(node_id, old_state, new_state)

    def check_data_freshness(self):
        """检查数据新鲜度(节点可能在线但未上报数据)"""
        now = time.time()
        with self.lock:
            for node in self.nodes.values():
                if node.state == NodeState.OFFLINE:
                    continue
                data_age = now - node.last_data_time
                if data_age > self.config.max_data_age:
                    # 数据超时,即使心跳正常也标记为降级
                    if node.state == NodeState.ONLINE:
                        old_state = node.state
                        node.state = NodeState.DEGRADED
                        if self.on_state_change:
                            self.on_state_change(node_id, old_state, NodeState.DEGRADED)

    def get_node_status(self, node_id: int) -> NodeStatus:
        with self.lock:
            return self.nodes.get(node_id)

    def get_all_status(self) -> Dict[int, NodeStatus]:
        with self.lock:
            return {k: v for k, v in self.nodes.items()}

    def start(self):
        self.running = True
        self._thread = threading.Thread(target=self._monitor_loop, daemon=True)
        self._thread.start()

    def stop(self):
        self.running = False
        if self._thread:
            self._thread.join()

    def _monitor_loop(self):
        while self.running:
            time.sleep(10)  # 每10秒检查一次
            self.check_data_freshness()
四、容错机制设计
4.1 三层容错架构
┌─────────────────────────────────────────────────────────────────────┐
│ 第一层:节点级容错(边缘侧)                                       │
│  - 本地缓存:节点内置Flash,网络中断时缓存最近1000条记录           │
│  - 断网续传:网络恢复后自动补传缓存数据                            │
│  - 看门狗:硬件看门狗自动复位死机节点                              │
├─────────────────────────────────────────────────────────────────────┤
│ 第二层:采集器级容错(网关侧)                                     │
│  - 数据缓存:采集器本地存储最近24小时数据                          │
│  - 多路径上报:主服务器不可达时,切换到备用服务器                   │
│  - 离线存储:写入本地SQLite,网络恢复后批量同步                    │
├─────────────────────────────────────────────────────────────────────┤
│ 第三层:服务器级容错(中心侧)                                     │
│  - 数据插值:节点掉线期间,基于前后数据和邻近节点推算               │
│  - 主备切换:主服务器故障时,备用服务器自动接管                    │
│  - 数据完整性校验:定期校验数据连续性,发现缺口自动补采            │
└─────────────────────────────────────────────────────────────────────┘
4.2 数据插值补偿算法
当节点掉线时,系统自动启动插值补偿,确保数据连续性:
# data_interpolation.py
import numpy as np
from datetime import datetime, timedelta
from typing import List, Optional, Tuple

class DataInterpolator:
    """档案库房温湿度数据插值补偿"""

    def __init__(self, max_gap_minutes: int = 30):
        """
        max_gap_minutes: 最大可插值的时间间隔(分钟)
        超过此间隔的数据缺口不插值,标记为"未知"
        """
        self.max_gap_minutes = max_gap_minutes

    def interpolate_single_node(self, timestamps: List[float],
                                 values: List[float],
                                 gap_start: float,
                                 gap_end: float) -> List[Tuple[float, float]]:
        """
        对单个节点的数据缺口进行插值
        使用线性插值 + 异常值检测
        """
        gap_duration = (gap_end - gap_start) / 60.0  # 分钟
        if gap_duration > self.max_gap_minutes:
            return []  # 缺口太大,不插值

        # 找到缺口前后的数据点
        before = None
        after = None
        for ts, val in zip(timestamps, values):
            if ts <= gap_start:
                before = (ts, val)
            elif ts >= gap_end and after is None:
                after = (ts, val)
                break

        if not before or not after:
            return []

        # 线性插值
        interpolated = []
        gap_points = int((gap_end - gap_start) / 30)  # 每30秒一个点
        for i in range(1, gap_points):
            t = gap_start + i * 30
            ratio = (t - before[0]) / (after[0] - before[0])
            val = before[1] + ratio * (after[1] - before[1])
            interpolated.append((t, val))

        return interpolated

    def interpolate_from_neighbors(self, target_node: int,
                                    neighbor_data: Dict[int, List[Tuple[float, float]]],
                                    gap_start: float,
                                    gap_end: float) -> List[Tuple[float, float]]:
        """
        基于邻近节点的数据进行插值
        适用于目标节点长时间离线的情况
        """
        # 收集所有邻近节点在缺口期间的数据
        neighbor_values = {}
        for node_id, data in neighbor_data.items():
            if node_id == target_node:
                continue
            values_in_gap = [(ts, val) for ts, val in data
                            if gap_start <= ts <= gap_end]
            if values_in_gap:
                neighbor_values[node_id] = values_in_gap

        if not neighbor_values:
            return []

        # 计算邻近节点的平均值
        interpolated = []
        gap_points = int((gap_end - gap_start) / 30)
        for i in range(gap_points):
            t = gap_start + i * 30
            vals_at_t = []
            for node_id, data in neighbor_values.items():
                # 找到最接近的时间点
                closest = min(data, key=lambda x: abs(x[0] - t))
                if abs(closest[0] - t) <= 15:  # 15秒容差
                    vals_at_t.append(closest[1])

            if vals_at_t:
                avg_val = sum(vals_at_t) / len(vals_at_t)
                interpolated.append((t, avg_val))

        return interpolated

    def mark_data_integrity(self, timestamps: List[float],
                             values: List[float]) -> List[Dict]:
        """
        标记数据完整性,用于审计报告
        """
        result = []
        for i in range(len(timestamps)):
            integrity = "original"
            if i > 0:
                interval = timestamps[i] - timestamps[i-1]
                if interval > 35:  # 超过35秒,说明有插值或丢失
                    integrity = "interpolated" if interval < self.max_gap_minutes * 60 else "missing"
            result.append({
                'timestamp': timestamps[i],
                'value': values[i],
                'integrity': integrity
            })
        return result
4.3 主备切换机制
# ha_manager.py
import socket
import threading
import time
from enum import Enum
from typing import Callable

class ServerRole(Enum):
    PRIMARY = 1
    SECONDARY = 2

class HAManager:
    """主备服务器高可用管理"""

    def __init__(self, role: ServerRole, peer_ip: str, peer_port: int = 9999):
        self.role = role
        self.peer_ip = peer_ip
        self.peer_port = peer_port
        self.running = False
        self._thread = None
        self._sock = None
        self.last_heartbeat = 0
        self.peer_alive = True
        # 回调函数
        self.on_role_change: Callable[[ServerRole], None] = None

    def start(self):
        self.running = True
        self._sock = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
        self._sock.bind(('0.0.0.0', self.peer_port))
        self._sock.settimeout(2.0)
        self._thread = threading.Thread(target=self._ha_loop, daemon=True)
        self._thread.start()

    def stop(self):
        self.running = False
        if self._sock:
            self._sock.close()
        if self._thread:
            self._thread.join()

    def _ha_loop(self):
        """主备心跳检测循环"""
        while self.running:
            try:
                if self.role == ServerRole.PRIMARY:
                    # 主服务器:发送心跳,检测备服务器是否存活
                    self._send_heartbeat()
                    self._check_peer_alive()
                else:
                    # 备服务器:接收心跳,检测主服务器是否存活
                    self._recv_heartbeat()
                    self._check_primary_alive()
            except Exception as e:
                print(f"HA loop error: {e}")
            time.sleep(1)

    def _send_heartbeat(self):
        """发送心跳包"""
        msg = b'HA_HEARTBEAT'
        self._sock.sendto(msg, (self.peer_ip, self.peer_port))

    def _recv_heartbeat(self):
        """接收心跳包"""
        try:
            data, addr = self._sock.recvfrom(1024)
            if data == b'HA_HEARTBEAT':
                self.last_heartbeat = time.time()
        except socket.timeout:
            pass

    def _check_peer_alive(self):
        """主服务器检查备服务器存活"""
        if self.last_heartbeat > 0:
            elapsed = time.time() - self.last_heartbeat
            if elapsed > 10:  # 10秒无心跳
                self.peer_alive = False
                print("Secondary server is DOWN")
            else:
                self.peer_alive = True

    def _check_primary_alive(self):
        """备服务器检查主服务器存活"""
        if self.last_heartbeat > 0:
            elapsed = time.time() - self.last_heartbeat
            if elapsed > 10:  # 10秒无心跳
                if self.role == ServerRole.SECONDARY:
                    print("Primary server is DOWN, promoting to PRIMARY")
                    self.role = ServerRole.PRIMARY
                    if self.on_role_change:
                        self.on_role_change(self.role)
五、掉线排查工具箱
5.1 自动诊断流程
# diagnostic.py
import subprocess
import socket
import time
from dataclasses import dataclass
from typing import List

@dataclass
class DiagnosticResult:
    node_id: int
    step: str
    status: str
    detail: str
    timestamp: float

class NodeDiagnostic:
    """节点掉线自动诊断"""

    def __init__(self, node_ip: str, node_id: int):
        self.node_ip = node_ip
        self.node_id = node_id
        self.results: List[DiagnosticResult] = []

    def run_full_diagnostic(self) -> List[DiagnosticResult]:
        """执行完整诊断流程"""
        self.results.clear()
        self._check_ping()
        self._check_tcp_port(502)
        self._check_tcp_port(80)
        self._check_modbus_response()
        self._check_power_voltage()
        self._check_signal_strength()
        return self.results

    def _add_result(self, step: str, status: str, detail: str):
        self.results.append(DiagnosticResult(
            node_id=self.node_id,
            step=step,
            status=status,
            detail=detail,
            timestamp=time.time()
        ))

    def _check_ping(self):
        """ICMP Ping测试"""
        try:
            result = subprocess.run(
                ['ping', '-c', '3', '-W', '2', self.node_ip],
                capture_output=True, text=True, timeout=10
            )
            if result.returncode == 0:
                # 提取丢包率
                output = result.stdout
                if 'packet loss' in output:
                    loss = output.split('packet loss')[0].split()[-1]
                    self._add_result('PING', 'OK', f'丢包率: {loss}')
                else:
                    self._add_result('PING', 'OK', '可达')
            else:
                self._add_result('PING', 'FAIL', '节点不可达')
        except Exception as e:
            self._add_result('PING', 'ERROR', str(e))

    def _check_tcp_port(self, port: int):
        """TCP端口连通性测试"""
        try:
            sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
            sock.settimeout(3)
            result = sock.connect_ex((self.node_ip, port))
            if result == 0:
                self._add_result(f'TCP_{port}', 'OK', f'端口{port}可达')
            else:
                self._add_result(f'TCP_{port}', 'FAIL', f'端口{port}不可达')
            sock.close()
        except Exception as e:
            self._add_result(f'TCP_{port}', 'ERROR', str(e))

    def _check_modbus_response(self):
        """Modbus TCP响应测试"""
        try:
            sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
            sock.settimeout(5)
            sock.connect((self.node_ip, 502))
            # 发送读取请求
            req = bytes([0x00, 0x01, 0x00, 0x00, 0x00, 0x06, 0x01, 0x04, 0x00, 0x00, 0x00, 0x02])
            sock.send(req)
            resp = sock.recv(1024)
            if len(resp) >= 9:
                self._add_result('MODBUS', 'OK', f'响应长度: {len(resp)}字节')
            else:
                self._add_result('MODBUS', 'FAIL', '响应数据异常')
            sock.close()
        except Exception as e:
            self._add_result('MODBUS', 'ERROR', str(e))

    def _check_power_voltage(self):
        """检查节点供电电压(通过Modbus读取)"""
        # 实现略:读取节点内部电压寄存器
        pass

    def _check_signal_strength(self):
        """检查无线信号强度(仅无线节点)"""
        # 实现略:读取节点RSSI值
        pass

    def generate_report(self) -> str:
        """生成诊断报告"""
        report = f"=== 节点 {self.node_id} ({self.node_ip}) 诊断报告 ===\n"
        report += f"生成时间: {time.strftime('%Y-%m-%d %H:%M:%S')}\n\n"

        for r in self.results:
            status_icon = "✓" if r.status == "OK" else "✗"
            report += f"{status_icon} {r.step}: {r.status} - {r.detail}\n"

        # 给出建议
        report += "\n=== 建议 ===\n"
        if any(r.step == 'PING' and r.status == 'FAIL' for r in self.results):
            report += "- 检查网线连接、交换机端口状态\n"
        if any('TCP_502' in r.step and r.status == 'FAIL' for r in self.results):
            report += "- 检查节点Modbus TCP服务是否正常\n"
        if any(r.step == 'MODBUS' and r.status == 'FAIL' for r in self.results):
            report += "- 节点可能死机,建议现场重启\n"

        return report
5.2 诊断报告示例
=== 节点 15 (10.100.5.15) 诊断报告 ===
生成时间: 2025-01-20 14:30:00

✓ PING: OK - 丢包率: 0%
✓ TCP_502: OK - 端口502可达
✓ TCP_80: OK - 端口80可达
✗ MODBUS: FAIL - 响应数据异常

=== 建议 ===
- 节点可能死机,建议现场重启
- 检查节点供电电压是否稳定
六、告警策略与防误报
6.1 告警分级
级别 | 条件 | 通知方式 | 响应时限 |
|---|---|---|---|
INFO | 节点进入DEGRADED状态 | 系统日志 | 不通知 |
WARNING | 节点进入OFFLINE状态 | 邮件/APP推送 | 2小时内 |
CRITICAL | 同一区域≥3个节点同时离线 | 短信/电话 | 15分钟内 |
EMERGENCY | 温湿度超限+节点离线 | 短信/电话+升级 | 立即 |
6.2 防误报机制
# alarm_deduplication.py
import time
from collections import defaultdict
from typing import Dict, Set

class AlarmDeduplicator:
    """告警去重与抑制"""

    def __init__(self):
        self._alarm_history: Dict[str, float] = {}  # 告警ID -> 最后触发时间
        self._suppressed_alarms: Set[str] = set()   # 被抑制的告警
        self._node_offline_count: Dict[str, int] = defaultdict(int)  # 区域离线节点数

    def should_trigger(self, alarm_id: str, node_id: int,
                       area: str, alarm_type: str) -> bool:
        """判断是否应该触发告警"""
        now = time.time()

        # 1. 同一节点同一类型告警,5分钟内不重复触发
        key = f"{node_id}_{alarm_type}"
        if key in self._alarm_history:
            if now - self._alarm_history[key] < 300:  # 5分钟
                return False

        # 2. 网络抖动抑制:节点离线后30秒内恢复,不触发告警
        if alarm_type == "OFFLINE":
            # 检查是否在抖动窗口内
            if self._is_flapping(node_id):
                return False

        # 3. 区域级告警抑制:同一区域已有≥3个节点告警,不再逐个触发
        if alarm_type == "OFFLINE":
            self._node_offline_count[area] += 1
            if self._node_offline_count[area] > 3:
                return False

        self._alarm_history[key] = now
        return True

    def _is_flapping(self, node_id: int) -> bool:
        """检测节点是否处于抖动状态(频繁上下线)"""
        # 实现略:基于历史状态变化频率判断
        return False

    def clear_area_alarm(self, area: str):
        """区域恢复,清除计数"""
        self._node_offline_count[area] = 0
七、经验总结
- 档案库房传感网络的核心不是"不丢数据",而是"丢数据后能证明丢了多少、怎么补"。容错机制的设计目标应该是数据可追溯,而非绝对不中断。
- 心跳检测需要区分"节点掉线"和"数据延迟"。节点可能在线但未上报数据(传感器故障、采样任务阻塞),这种"假在线"比真掉线更危险,因为系统不会触发告警。
- 插值补偿是最后一道防线,但不是万能的。对于审计要求严格的场景,插值数据必须明确标记为"推算值",不能冒充原始测量值。
- 主备切换的触发条件要保守。网络抖动可能导致主备之间短暂失联,如果备机立即接管,可能造成"双主"冲突。建议采用仲裁节点或共享存储锁来避免脑裂。
- 告警去重和防误报比告警本身更重要。频繁误报会导致管理员对告警系统失去信任,真正的问题反而被忽略。
关键词:档案库房,传感网络,可靠性设计,温湿度节点,掉线排查,容错机制,心跳检测,数据插值,主备切换,告警防误报
标签:#档案库房 #传感网络 #可靠性设计 #温湿度节点 #掉线排查 #容错机制 #心跳检测 #数据插值 #主备切换 #告警防误报
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号