一文读懂 5565 反射内存卡,微秒级实时数据同步如何实现
原创
一文读懂 5565 反射内存卡,微秒级实时数据同步如何实现
原创
盛世宏博科技
发布于 2026-09-28 17:52:48
发布于 2026-09-28 17:52:48
一文读懂 5565 反射内存卡,微秒级实时数据同步如何实现
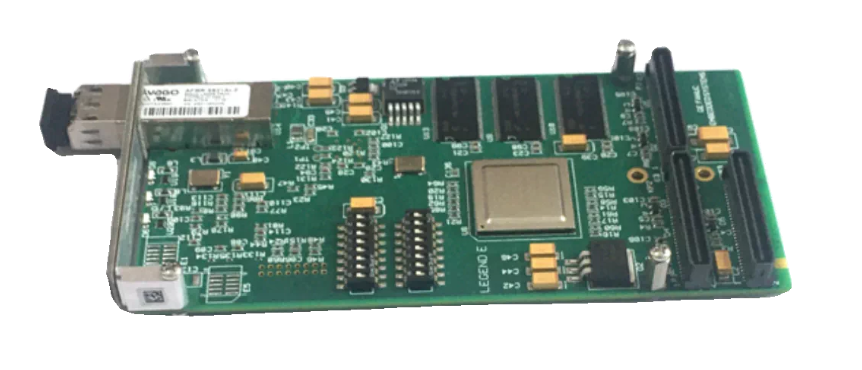
反射内存卡
引言
在半实物仿真、工业测控、变电站测试、高速运动控制等场景里,普通以太网、TCP/IP网络总会遇到延迟抖动、数据丢包、时间不同步问题。当多台设备需要在微秒级别完成数据交互,传统网络协议栈带来的开销就成了瓶颈。
5565反射内存卡(Reflective Memory),就是面向强实时多节点数据共享场景的专用硬件通讯方案。它可以让网络内所有节点,共享同一块内存区域,任意一台主机写入数据,其余节点在微秒级自动同步更新,不需要复杂握手、协议解析。本文从原理、硬件结构、工作流程、应用场景、优势对比几个方面,带你看懂5565反射内存卡。
一、什么是反射内存卡?
反射内存(RFM,Reflective Memory)是一种硬件级共享内存通讯技术,5565是应用最广泛的一代反射内存芯片/板卡型号。
简单理解:在环网内的每一台计算机,都插上一块5565反射内存卡,每张卡自带一块本地内存。所有板卡的内存构成一个全局统一的共享内存空间。
- 节点A往本地反射内存地址写入数据
- 硬件自动捕获写入动作,通过光纤环网广播数据
- 环网内其余所有节点的反射内存硬件自动更新本地对应内存
- 上层软件直接读取本地内存,就能拿到其他节点最新数据
整个数据转发过程由板卡硬件独立完成,不占用主机CPU,绕过操作系统网络协议栈,这就是它能做到微秒级同步的根本原因。
核心特点:写即同步。软件只需要读写本地内存地址,不需要调用send/receive这类网络接口。
二、5565反射内存卡微秒级同步,底层怎么实现?
1. 硬件环网传输,无操作系统协议栈开销
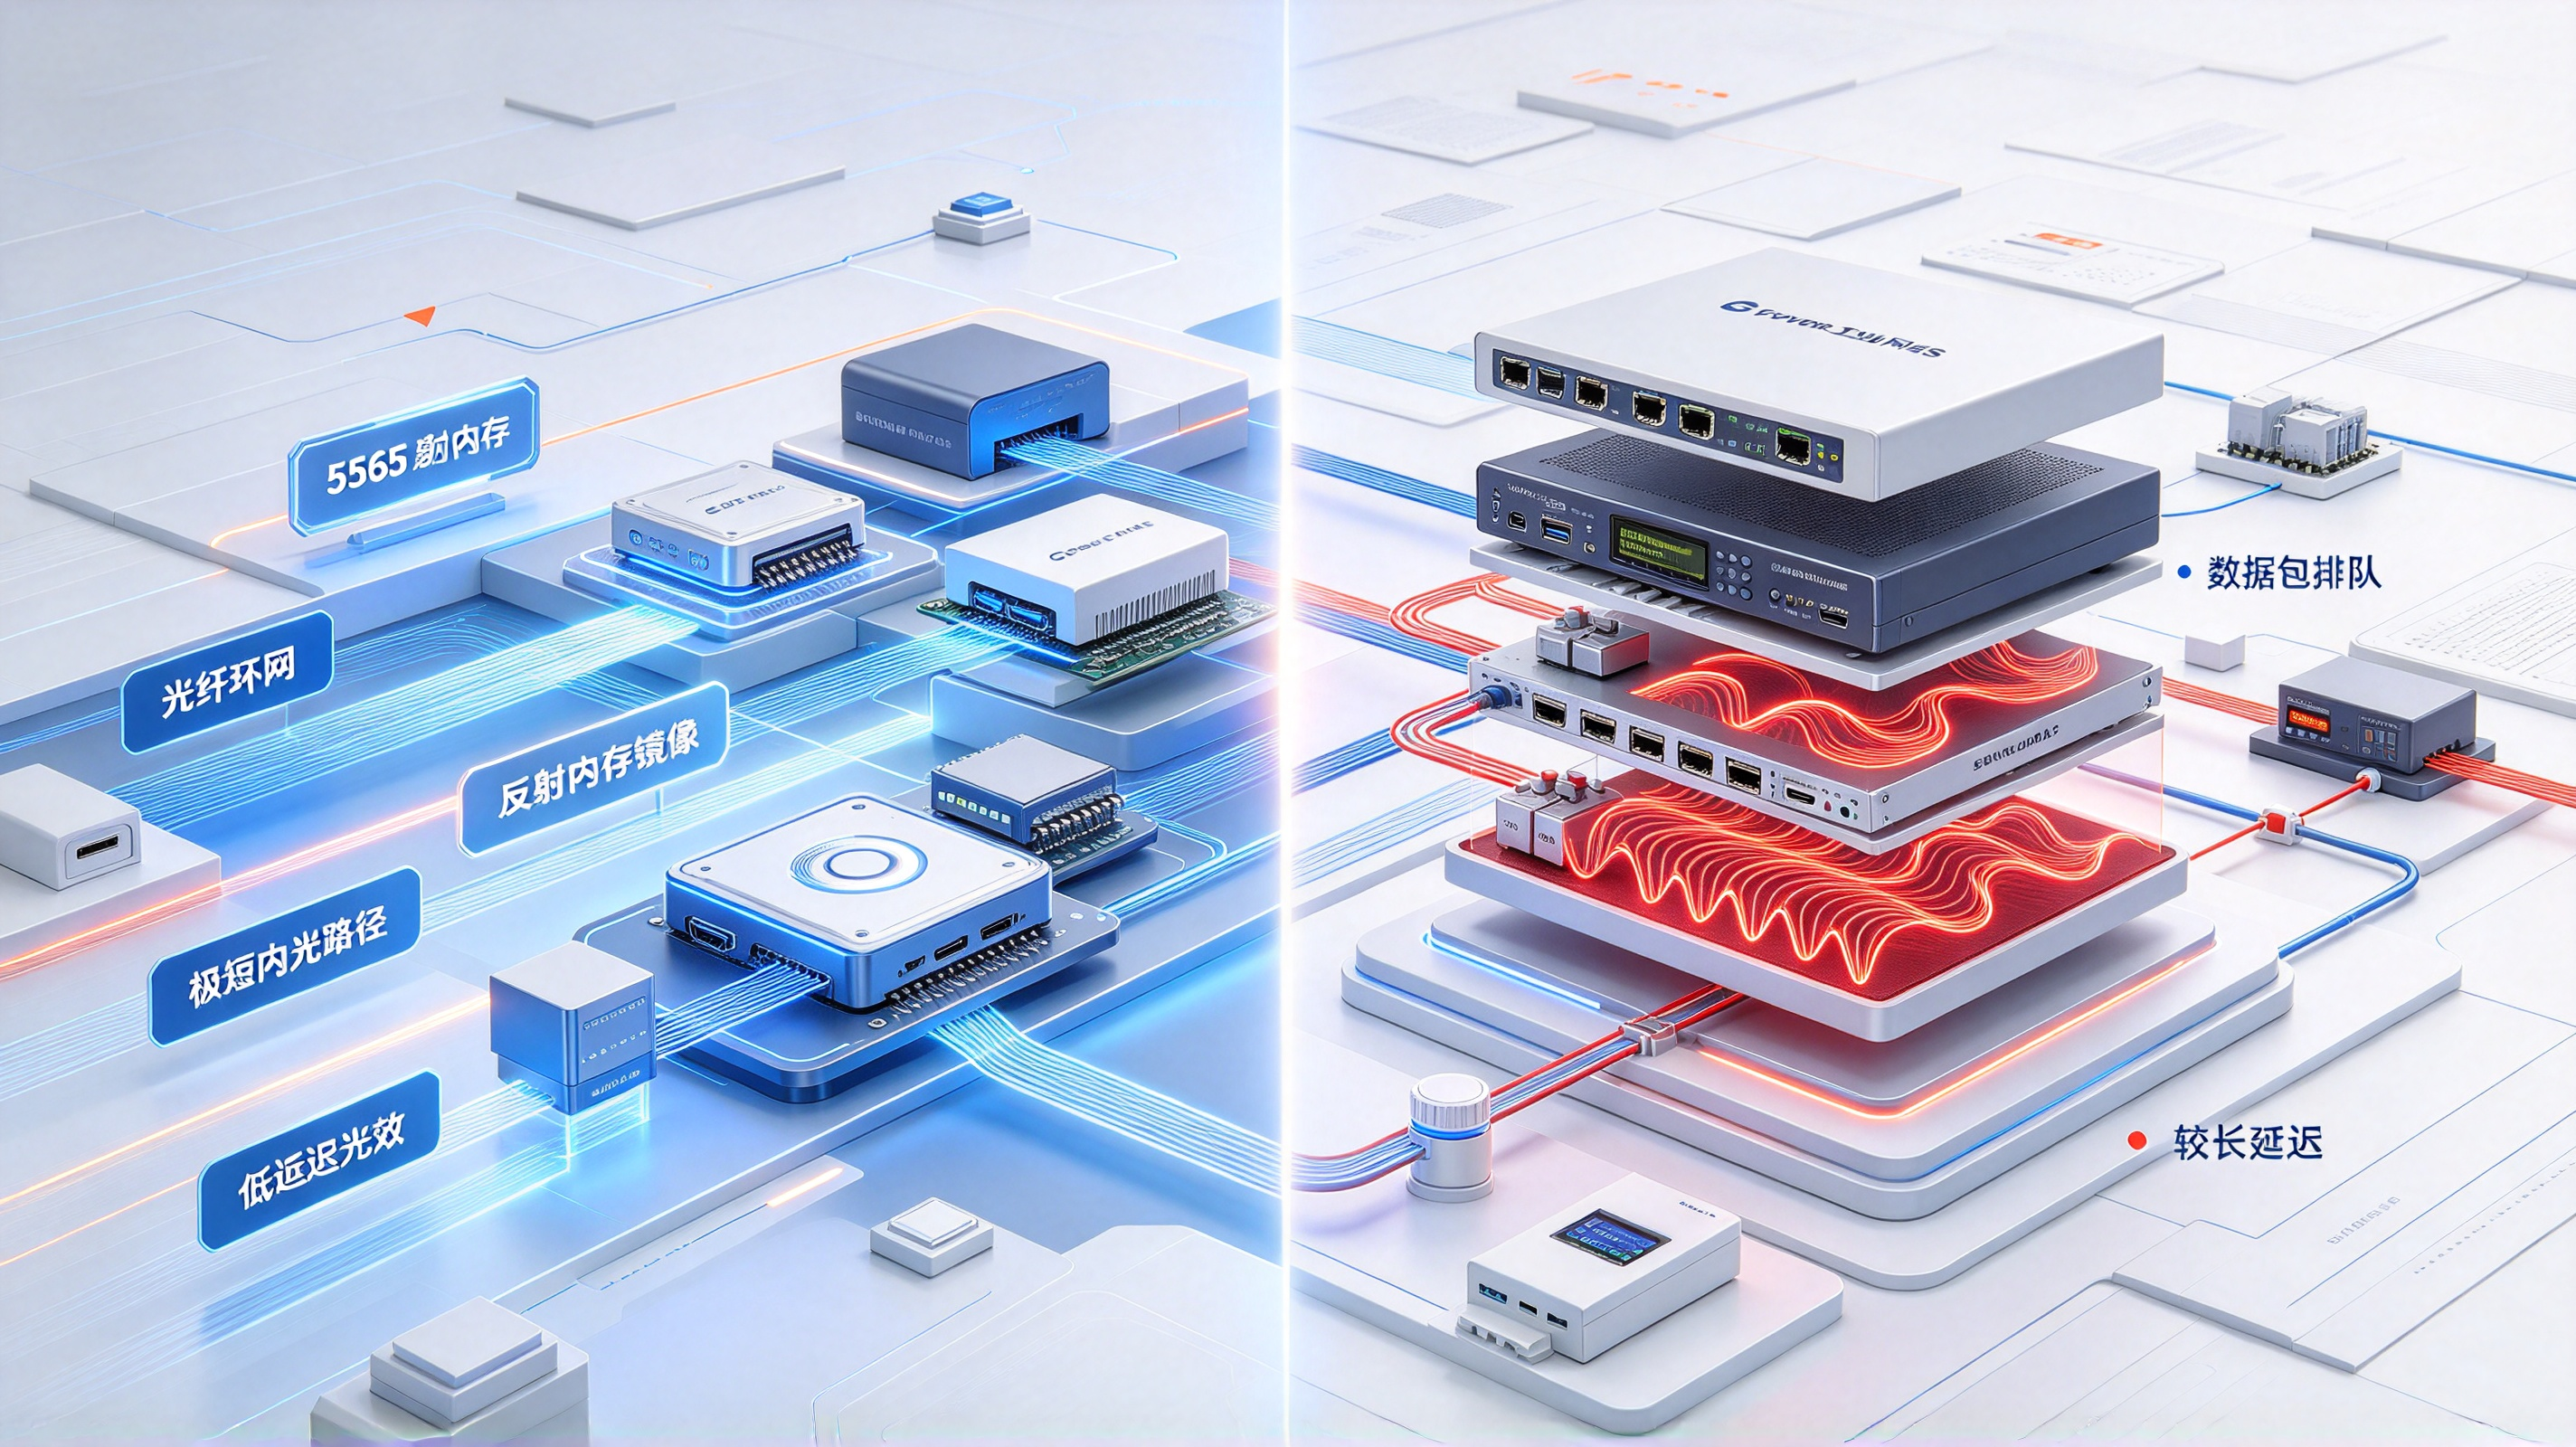
普通以太网数据流程:应用层→TCP/IP协议栈→网卡驱动→网卡→网线→对端网卡→协议栈→应用。多层软件拷贝、校验、握手,带来毫秒级抖动。
5565完全不同:CPU写本地反射内存,板卡硬件直接截获内存写操作,打包后通过光纤环转发。全程不需要操作系统参与数据打包解析,CPU只负责读写内存,通讯工作交给板卡硬件。
2. 光纤环形拓扑,低延迟确定性传输
5565默认光纤环网架构,信号沿环路单向传输。
- 支持多节点串联成环,节点数量可扩展
- 光纤介质抗电磁干扰,适合工业、测控强电磁环境
- 传输延迟固定,确定性时延,抖动极小,延迟只和光纤物理长度、节点数量相关,不存在以太网拥塞带来的随机延迟。
3. 内存镜像机制
每个节点的反射内存,是全局共享内存的完整镜像。 节点写入数据 → 硬件广播 → 所有节点硬件自动刷新本地镜像内存。 软件读取时,读的就是本机板卡上的本地内存,读取速度等同于内存访问速度。
典型指标参考: 数据同步延迟:亚微秒~几微秒级别 支持节点数:最多256个节点 传输介质:光纤,抗干扰强 内存容量:板载内存可选配置
【配图3|16:9 对比框图:左侧5565反射内存数据链路,右侧传统以太网TCP/IP链路,直观对比链路层数与延迟差异】
三、5565反射内存关键能力
- 强实时确定性 时延可预测,不会出现网络拥堵造成的突发延迟,是半实物仿真最重要指标。仿真模型必须在固定时间步长运算,一旦延迟抖动,仿真结果失效。
- CPU占用极低 数据收发由板卡硬件处理,主机CPU只负责业务运算,不用处理通讯事务,适合高负载实时仿真主机。
- 强抗干扰 采用光纤通讯,电气隔离,不怕高压、电磁干扰,广泛用于电力、军工、车载测试等恶劣工业环境。
- 开发简单 API简单,没有socket、报文打包、拆包逻辑。开发人员只需要读写指定内存地址,和普通变量读写类似,大幅降低多机协同软件开发工作量。
- 支持多操作系统 支持Windows、Linux、VxWorks、实时操作系统RTOS,适配各类工控机、仿真机。
四、典型应用场景
- 半实物仿真HIL 电力仿真、飞行器、车辆动力系统硬件在环测试,多仿真节点之间需要严格同步,微秒级数据交互。
- 变电站/电力实时测控 电力继电保护测试,多装置同步采集、同步输出,对时间一致性要求极高。
- 高速运动控制、机器人集群控制 多控制器协同,实时交换位置、力矩状态。
- 分布式实时数据采集 多台采集设备同步采样,数据全局共享,保证采样时序一致性。
- 航空、船舶测试系统 多节点分布式测试,高可靠强实时数据交互场景。
五、5565反射内存 vs 普通以太网、EtherCAT
通讯方式 | 同步延迟 | 时延抖动 | CPU开销 | 适用场景 |
|---|---|---|---|---|
5565反射内存卡 | 微秒级 | 极低,确定性 | 低 | 半实物仿真、电力HIL、分布式实时测控 |
普通千兆以太网(TCP/IP) | 几十~几百微秒 | 抖动大 | 高 | 普通业务、文件传输、非实时数据 |
EtherCAT | 微秒级 | 较小 | 中等 | 运动控制,固定周期总线 |
简单总结:EtherCAT偏向运动控制总线;反射内存优势在于多节点对等全局内存共享,多台主机可以自由读写同一片共享空间,非常适合分布式仿真场景。
【配图4|16:9 场景应用图:工控机房,多台工控机组成半实物仿真测试机柜,光纤布线连接,标注5565反射内存实时仿真系统】
六、5565反射内存使用注意事项
- 采用环形拓扑,如果环上一处光纤断线,整个环网通讯中断;部分方案支持冗余双环提升可靠性。
- 光纤布线需要注意弯折半径,避免光纤损伤。
- 节点数量越多,总传输延迟会小幅增加,项目前期需要评估节点数量与光纤长度带来的时延。
- 软件需要做好共享内存读写互斥,多节点同时写同一个地址时,需要业务层做数据锁保护,防止数据覆盖。
结尾
5565反射内存卡的核心本质,就是用硬件实现分布式共享内存,绕开操作系统网络协议栈,依靠光纤环网完成微秒级确定性数据同步。
它不是通用网络,不适合普通文件传输、上网业务。但在半实物仿真、电力测试这类对实时性、时序一致性有极致要求的场景,反射内存依然是成熟可靠的经典方案。随着分布式仿真项目越来越多,5565反射内存方案依旧在工业测控、仿真测试领域持续发挥价值。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号