从一句话需求到上线 App:WorkBuddy FDE 实战手册(含 90 天路径)
原创
从一句话需求到上线 App:WorkBuddy FDE 实战手册(含 90 天路径)
原创
用户12783788
发布于 2026-10-02 18:09:19
发布于 2026-10-02 18:09:19
本文是《AI 个人级 APP 实战手册》的精编实战版,聚焦三块:核心框架(7 条观点)→ 错题智库实战走查 → 90 天成长路径。全文基于我用 WorkBuddy 真实把一个需求做成上线 App 的踩坑经验,欢迎对照实操。
WorkBuddy 官网:腾讯出品的全场景 AI 办公台,本手册所有实操都基于它完成
先读:贯穿全篇的 7 条核心观点
这篇手册不是一堆知识点堆在一起,而是被 7 条核心观点 串成一根线。每章开头会点出它对应的观点,结尾回扣主线。先记住这 7 条,后面你就不会迷路:
核心观点 | 它回答的问题 | |
|---|---|---|
CV0(总纲) | FDE = 把"模糊需求"编译成"可上线、可负责的产品"的人 | FDE 到底是什么、交付什么 |
CV1 | 模型强 ≠ 落地强,最后一公里才是 FDE 的主场 | 为什么需要 FDE |
CV2 | 写代码只占 25%,"让东西跑起来"才是主食 | 时间花在哪、功夫练在哪 |
CV3 | 先搭骨架再填血肉:一句话需求 → 五层展开 + 四段式 | 怎么从需求起步 |
CV4 | 平台 / 模型 / 云没有"最好",只有"和此刻任务最配" | 怎么选型 |
CV5 | 你是驾驶员,模型是副驾;双阶段变更 + 评分门是安全带 | 怎么和大模型协作 |
CV6 | 上线是起点不是终点;eval / 隐私 / 成本 / 监控是分水岭 | 怎么算"真会了" |
CV7 | 可复用能力 > 一次交付;90 天练出"可迁移骨架" | 怎么成长 |
flowchart LR
    CV0[FDE=需求编译器] --> CV1[模型强≠落地强]
    CV1 --> CV2[写码只占25%]
    CV2 --> CV3[先骨架:五层+四段式]
    CV3 --> CV4[选型看匹配]
    CV4 --> CV5[你是驾驶员]
    CV5 --> CV6[上线是起点]
    CV6 --> CV7[可复用>一次交付]
    CV7 -.沉淀骨架.-> CV0
一句话记住:下面所有内容,都是在论证 CV0——你交付的不是代码,是"跑起来、能负责、可复用"的结果。对一个人做个人 App 而言,这句话更直白:你交付的是"我自己和几个朋友真在用"的东西。
4. 实战手册:以「高中错题本(错题智库)」为主轴走查
▶ 核心观点 CV3:先搭骨架再填血肉——一句话需求 → 五层展开 + 四段式,是后面一切的地基。 主线案例一句话:老师/学生要一个"拍照→识别错题→归类→推送相似题+讲解"的工具。它从网页 Demo 走到安卓 App,迭代到 v1.13.5(versionCode 28),真实踩过的坑就是下面每一节的素材。
4.0 主线案例档案(先认产品)
项 | 内容 |
|---|---|
产品 | 高中错题本 / 错题智库(doc3) |
核心动作 | 拍照/粘贴错题 → AI 识别 → 归类 → 推相似题+语音讲解 |
真实轨迹 | v1.0 → v1.13.5(versionCode 28) |
平台演进 | 网页先跑通 → 套安卓壳 → 接 Supabase 边缘函数 |
后端 | Supabase Edge Functions(Deno),Management API 部署 |
模型 | DeepSeek(默认)+ SiliconFlow CosyVoice2(语音讲解) |
标志性坑 | 卡红按钮连修 4 版;模型 ID 写死静默雷;空输入/权限中间态 |
迭代成效 | 28 个版本(v1.0→v1.13.5,versionCode 28);卡红按钮单点连修 4 版;沉淀 71KB 交接文档 + 16 条踩坑归档 |
验证方式 | 一手来源:资料库 doc3《用 WorkBuddy 搭一个能上线的 App(完整版)》原文;跨行业成效对比见第 1 章「案例成效对照表」 |
下面每一节,先讲主线案例怎么做,再标补充案例(主线没覆盖的技术)。
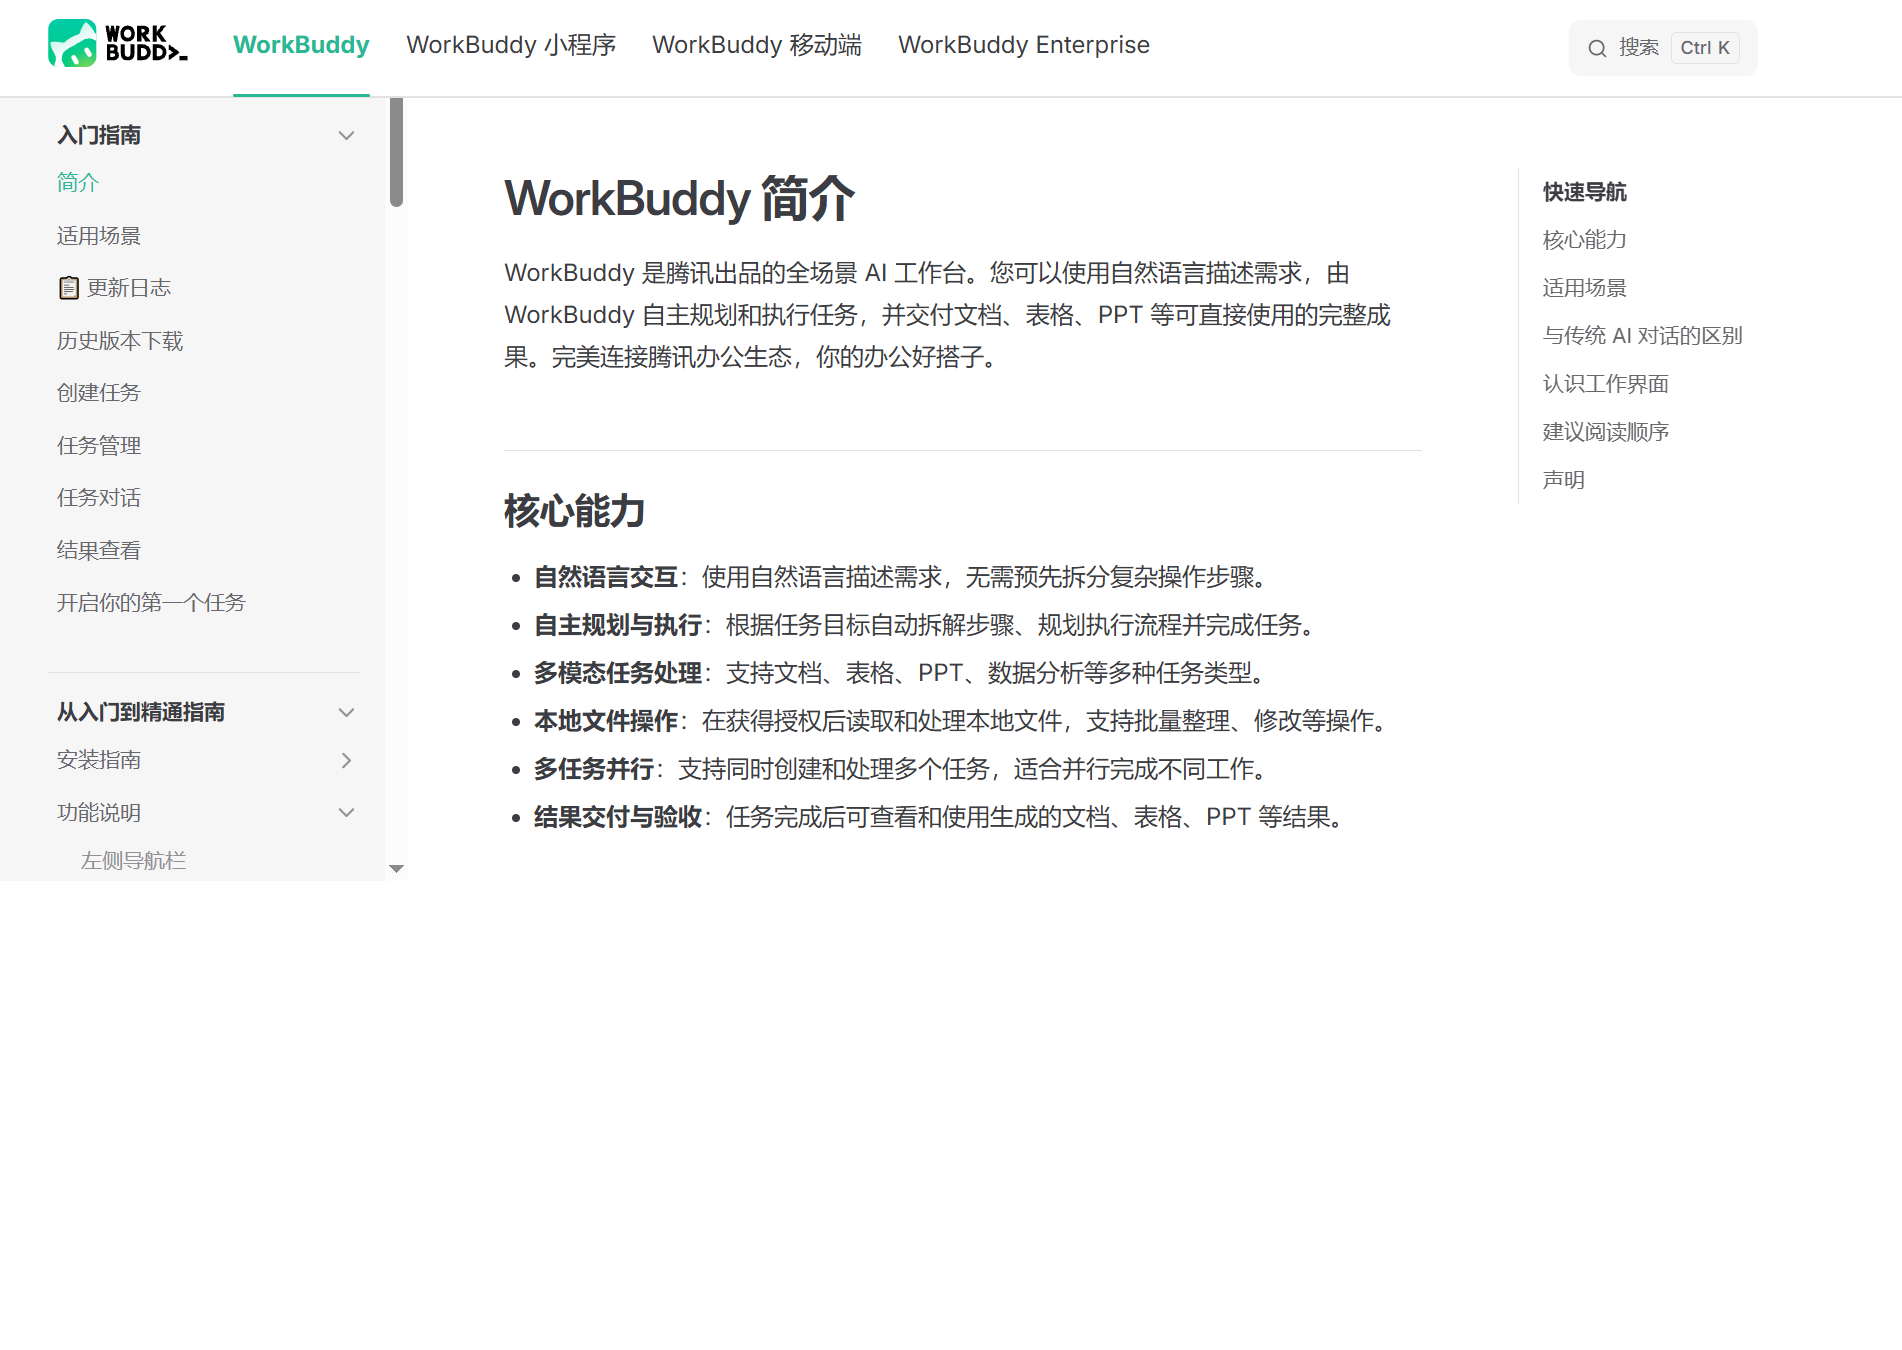
WorkBuddy 官方文档:核心能力一览——自然语言交互、自主规划与执行、多模态任务处理、本地文件操作、多任务并行、结果交付与验收
4.1 从一句话需求到完整开发框架【主线·错题智库】
方法 A:五层展开法(doc3,错题智库复盘)
层 | 名字 | 要回答 | 先后 |
|---|---|---|---|
L1 | 核心动作 | 第一件要做的事(6 行内) | 先钉死 |
L2 | 输入输出 | 吃啥、吐啥 | 先钉死 |
L3 | 数据与状态 | 存在哪、怎么变 | 先钉死 |
L4 | 流程闭环 | 一件事从进入走到结束 | 先钉死 |
L5 | 增值层 | 锦上添花 | 后补 |
错题智库的 L1–L4:拍照/粘贴 → 识别文本 → 归类标签 → 推相似题+语音。L5(社区、错题本分享、导出 PDF)后补。
方法 B:文档四段式(doc3 / doc7)。每份需求文档必须含:功能清单 + 数据结构 + 验收标准 + 已知约束。doc3 原话:"缺任何一段,都会在后期以『返工』的形式补回来,而且是带利息的。"
错题智库能迭代到 v1.13.5,靠一份约 71KB / 7 章 / 16 条踩坑的交接文档,它做对了三件事:① 写清 What(功能/结构/接口);② 写清 How to verify(测语音写"真机能出文字",不是"按钮颜色正常");③ 写清 Constraints(平台只支持 Android、localStorage 单机、模型锁某版本)——边界写死,AI 才不会替你"发挥"。
可直接抄的四段式样板(错题智库第一版)——注意,这是文档模板,不是代码,你照着填空白就行:
# 错题智库 · 需求文档(四段式)

## 一、功能清单
1. 用户粘贴/拍照错题文本,点击「识别」→ 返回结构化错题(科目/知识点/错因)
2. 每条错题可一键生成语音讲解(TTS)
3. 按知识点归类,支持检索

## 二、数据结构
- WrongItem { id, subject, point, reason, text, createdAt }
- 存储:localStorage(MVP)/ Supabase(见 4.4)

## 三、验收标准
- AC1:粘贴一道错题,3 秒内返回科目+知识点+错因
- AC2:点语音讲解能出声(真机播放,非空文件)
- AC3:空输入提示「请先粘贴」,不调模型

## 四、已知约束
- MVP 仅安卓 + 网页;单题 ≤ 2000 字
- 模型锁 DeepSeek,不自动升级
- 学生错题含个人信息 → 默认不传公网(见第 7 节隐私)
操作清单 4.1
- 用五层展开法把需求拆成 L1–L5,L1–L4 不超过一屏
- 写四段式文档:功能 / 结构 / 验收 / 约束,四块缺一不可
- 每条功能配一条可执行验收标准("点 X 应出现 Y",不是"体验流畅")
- 把文档当接口存好,新会话先读它再动手↩ 回主线(CV3 → CV4):骨架钉死后,才轮到"用什么工具把骨架填满"。这就是选型——但记住 CV4:没有最好,只有最配。
4.2 选择合适的 AI Coding 平台【主线·错题智库 + 补充·创意本】
▶ 核心观点 CV4:平台 / 模型 / 云没有"最好",只有"和此刻任务最配"。
WorkBuddy 的 AI 场景入口:研究 / 文档 / 设计 / 开发,任务交出去后自主规划、调用工具、生成文件
错题智库的选型原则:Web 优先,原生 / 后端补差。
- 网页先跑通 → 再套安卓壳 → 再接边缘函数,把平台差异爆发点后置但必须早验。
- 平台差异爆发点(如卡红按钮的 WebView 权限)列进"已知约束",提前写验收。 平台怎么选(按场景,不是按热度) | 平台 | 强项 | 软肋 | 适合个人场景 | 成本 | | --- | --- | --- | --- | --- | | WorkBuddy | 个人 AI 工作台:资料库/技能链/本地文件/多步任务自动化 | 重度任务需理清上下文 | 个人把知识接进自己的小工具、做自动化 | 订阅制 | | Cursor | 代码库级编辑、Agent 成熟 | 偏写码,弱跨系统编排 | 已有代码库快速改功能 | 订阅制 | | Claude Code | 终端 Agent、长任务自主 | 需命令行、成本自管 | 后端/部署脚本批量 | 按量 | | v0 | 前端 UI 快 | 后端弱 | 纯前端原型 | 积分制 | | Copilot | IDE 补全、便宜 | 规划弱 | 日常提速 | 订阅制 |个人开发者的现实:先用你最熟的一个,别换来换去。换平台的隐性成本 > 平台之间的差异。
怎么操作(界面步骤):
- 打开你选的平台的官网,注册/登录账号。
- 新建一个空白项目/对话,命名(如
cuotiku-mvp)。 - 把 4.1 的四段式文档整段粘进第一条消息,附一句:"按这份文档做 MVP,先只做 Web 版。"
- 让它先输出技术方案(页面结构 + 文件清单),你确认后再让它写代码——这就是 4.5 的双阶段变更。
- 跑通 Web 版后,再发起新对话:"现在给这个 Web 应用套一个安卓 WebView 壳",把平台差异爆发点(权限/缓存)提前写进需求。 【补充·创意本】 同一原则的另一个样本:网页版 PWA 先发布,安卓用 WebView 壳离线跑,无网也能用。两条产品线印证同一句话——先出 Web 版,验证过再碰原生。 操作清单 4.2
- 新项目一律先出 Web 版(单页 hash 路由,零构建优先)
- 只在 Web 版验证通过后再考虑原生壳 / 桌面端
- 平台选一个用得熟的,别中途换(换平台隐性成本 > 平台差异)
- 把"平台差异爆发点"列进已知约束,提前写验收↩ 回主线(CV4):平台定了,下一步是"喂它什么大脑"——选模型。同样:看匹配,不追新。
4.3 大模型的选择与连接【主线·错题智库】
▶ 核心观点 CV4(续):模型也没有"最好",按任务分级路由最划算。 模型怎么选(相对排序,价格/能力以官网实时为准)
模型 | 中文 | 代码 | 长上下文 | 价格(相对) | 个人典型用法 |
|---|---|---|---|---|---|
DeepSeek V3/R1 | 强 | 强 | 中 | 低 | 批量/默认路由 |
Qwen(通义) | 强 | 强 | 强 | 低 | 中文业务/长文 |
GLM(智谱) | 强 | 中 | 中 | 低 | 国内合规部署 |
Kimi(月之暗面) | 强 | 中 | 很强 | 中 | 长文档/合同 |
Claude | 中 | 很强 | 强 | 高 | 复杂 Agent |
GPT(OpenAI) | 中 | 强 | 强 | 高 | 通用/生态 |
实战:DeepSeek API Key 怎么申请和使用(界面步骤)
这是主线案例真实用到的模型。按下面 7 步走,10 分钟能跑通:
- 打开官网:浏览器访问
platform.deepseek.com,右上角点「登录/注册」(支持手机号或邮箱,国内直接手机号最省事)。 - 进密钥页:登录后,点左上角头像 → API Keys(有的版本在左侧「接口文档」里找"API Keys"入口)。
- 创建密钥:点「创建 API Key」(Create Key),给个名字如
cuotiku-prod,方便日后区分环境。 - 复制并保存:系统生成一串
sk-xxxx……,只显示这一次!立刻点复制。 - 充值余额:同页找「充值」(余额界面),DeepSeek 按量计费、门槛极低,先充 ¥5 试跑足够。
- 在配置里引用(不写进代码):在你的项目根目录建一个
.env文件(这个文件绝不提交 git),只写一行:
DEEPSEEK_API_KEY=sk-你的密钥- 跑通第一个调用:让 AI Coding 平台写一段「调用 DeepSeek 问好」的最小脚本,运行后看到正常返回,说明 Key 通了。后续接错题识别时,只改
messages里的内容,不动 Key 和地址。静默雷(doc3 真案例,错题智库 v1.13.5):模型名写死成deepseek-v4-flash/deepseek-v4-flash-vision-exp,今天已退役——请求仍"能用",但被隐式路由到新 Flash 模型,按新模型计费、输出风格变了,你完全不知道。"不报错、不警告,只是悄悄换了个模型替你算。" → 模型 ID 绝不硬编码,做可配置项(在.env里加一行DEEPSEEK_MODEL=deepseek-chat即可改)。
语音讲解(TTS)怎么接(SiliconFlow CosyVoice2,界面步骤):
- 注册
siliconflow.cn账号 → 左侧「API 密钥」→「新建密钥」复制sk-xxxx。 - 同样存进
.env:SILICONFLOW_API_KEY=sk-你的密钥,base_url 固定https://api.siliconflow.cn/v1。 - 调用时指定模型
FunAudioLLM/CosyVoice2-0.5B和音色,输入讲解文案,输出 mp3。 分级路由(思路,不是代码):把任务分两档——"难"的(复杂抽取/长文)走强模型(Claude/GPT),"易"的(批量默认)走便宜模型(DeepSeek)。差价约 3 倍。实现上只要一个配置表,按 tier 选 base_url + model + key,并且对三种错误分别处理: 401= Key 失效,换 Key;429= 限流,退避后重试;- 报
insufficient= 余额耗尽,去充值。 操作清单 4.3 - 模型 ID 写成
.env里的可配置项,绝不硬编码版本号 - base_url 与协议写进配置,密钥与环境分离
- Key 只在创建时复制一次,存密钥管理,不进代码仓库
- 对 401 / 429 / 余额耗尽分别有处理分支
- 多模型分级路由(差价约 3 倍),贵任务走强模型↩ 回主线(CV4 → CV5):模型和平台都就位了,接下来是"你的产品怎么连上云、存数据"——选云也是同一逻辑:看匹配。但更重要的是,接下来要讲"你和模型怎么配合才不会翻车"。
4.4 云服务器 / 数据库 选择与连接【主线·错题智库 + 补充·创意本 IMA 桥接】
▶ 核心观点 CV4(终):云也没有"最好";错题智库选 Supabase 是因为它把"数据库+鉴权+边缘函数"打包,省掉一堆集成。
WorkBuddy 可无缝连接腾讯生态:IM、文档、邮箱、会议、知识库等常用办公工具
真实做法(doc3,错题智库):后端优先 Supabase Edge Functions(Deno),走 Management API + 零依赖工具包,明确排斥 CLI / Docker。doc3 原话:"CLI 要装、Docker 要起、网络还得通,每一环都是一个新的失败点。用 Management API 把『部署』压缩成一个纯 HTTP 调用——这是成本结构的考虑,不是技术偏好的考虑。"
实战:Supabase 怎么连(界面步骤,分两段:建库 + 部署函数)
第一段:建项目 + 建表 + 拿密钥
- 注册/登录:访问
supabase.com,用 GitHub 授权登录最快(没有就邮箱注册)。 - 新建项目:点 Dashboard 的「New Project」→ 填项目名称(如
cuotiku)→ 设一个数据库密码(这密码只显示一次,截图或记进密钥管理)→ 选离用户近的区域(国内用户选「Singapore」或「Tokyo」延迟较低)→ 创建。 - 等初始化:项目创建约 1–2 分钟,完成后进入项目主页。
- 拿连接密钥:左侧「Project Settings → API」页面,你会看到三样东西:
- 建数据表:左侧「Table Editor → New Table」→ 表名
wrong_items→ 图形化加列: - 验证连接:让平台写一段"查一条记录"的最小脚本,用 anon key + URL 跑通,看到返回空数组(表是空的)即说明连上了。 第二段:部署边缘函数(两种路,按熟练度选)
- 路 A(图形界面,新手):Supabase 左侧「Edge Functions → New Function」→ 填函数名(如
video-search)→ 在网页编辑器里贴代码 → 点「Deploy」。适合第一次试水。 - 路 B(Management API,零 CLI,主线案例用的):按 doc3 思路,把"部署"压成一个 HTTP 调用——
PUT /v1/projects/{ref}/functions/{slug}/body推源码、POST .../secrets设密钥。文档原话强调排斥 CLI/Docker,就是为了让"部署"变成一次纯网络请求,少一堆本地失败点。 服务端代理(doc3 逐字,错题智库的 B 站相似题搜索)——它解决了什么:前端想直连 B 站搜相似题,但 B 站接口有 CORS 限制 + 要登录态 Cookie,浏览器直接调会被拦。标准解法是在 Supabase 上放一个服务端代理函数,由它持凭证去调 B 站、再返回干净数据给前端。这个函数做了 5 件事:① 动态取签名密钥;② 给参数加签名;③ 带上 Cookie 和浏览器指纹去请求;④ 把 B 站字段重命名成你自己的结构;⑤ 响应头加Access-Control-Allow-Origin: *(漏了这步前端照样白干)。代码实现大模型能写,你只要把上面的"5 件事清单"喂给平台即可。重点记住:代理三件套 = 服务端持凭证 + 前端只 fetch + 失败有降级兜底。
【补充·创意本】IMA 桥接代理:纯静态 App 没有 IMA 凭证,且 IMA 接口无 access-control-allow-origin → 浏览器拦截前端直连 → 同样必须有持有凭证的服务端代理(Supabase Edge Function)。思路同源:前端只发"标题+内容",代理函数持 IMA_TOKEN 去调 IMA 接口、轮询解析状态,再回传 mediaId。
密钥边界铁律:ANON_KEY 可进浏览器;SERVICE_ROLE_KEY 永远只在服务端。
数据库怎么选
选型 | 适合 | 案例 |
|---|---|---|
SQLite(WAL 模式) | 单文件随包分发、Skill 内嵌、离线可用 | 知识抽取工作台(doc5) |
Supabase Postgres | 托管/鉴权/实时/边缘函数 | 错题智库 / 创意本 |
腾讯云 / 自建 | 国内合规/私有化(商业化延伸) | 企业级 FDE |
个人 App 起步,能 SQLite 就别上云;要多人用、要实时、要鉴权,再上 Supabase。别为了"显得专业"一上来就搭全套。 操作清单 4.4
- 轻量/单机优先 SQLite(WAL),要托管/多人再上 Supabase
- Supabase 用 Management API 部署,别碰 CLI/Docker
- 密钥分 ANON / SERVICE_ROLE,后者只在服务端
- 前端直连第三方前先问 CORS;不能就加服务端代理
- 代理三件套:持凭证服务端 + 前端 fetch + 失败降级兜底↩ 回主线(CV4 → CV5):工具链齐了。但工具不会自己干活——下一章讲"你和大模型怎么配合,既不翻车也不返工",这是 CV5 的地带。
4.5 产品开发过程中,人与大模型怎么互动【主线·错题智库 + 补充·阿平档案 / 创意本】
▶ 核心观点 CV5:你是驾驶员,模型是副驾;双阶段变更 + 评分门是你的安全带。 你是驾驶员,模型是副驾。
- 【主线·错题智库】验收前置 + 真实调用先于部署:错题智库的 71KB 交接文档把"怎么算成功"写死(AC1/AC2/AC3),新会话直接续上;发版前用真实凭证跑通关键链路,不靠"应该没问题"。
- 【补充·阿平协作档案 doc7】双阶段变更:"先评审建议 → 确认 → 再执行""不要直接落地变更——先给建议/评审结果,确认后再执行。" 改动前先确认,避免返工。错题智库这类长迭代项目尤其该用。
- 【补充·创意本 doc8】评分门:"每轮生长前先评估一次、生长后再评估一次,整体价值不提升就整轮丢弃、不并入——宁可空转,不让想法被低质情报污染。""重写整合,不是追加罗列。"
flowchart LR
    A[提需求/改需求] --> B[双阶段: 先出方案评审]
    B --> C{你确认?}
    C -->|否| B
    C -->|是| D[真实调用验证, 非假设]
    D --> E[盯末端结果, 防静默失败]
    E --> F[评分门: 价值提升?]
    F -->|否| G[整轮丢弃/重写]
    F -->|是| H[闭环交付+沉淀文档]
H --> A落到界面上怎么操作:
- 每次让模型改东西前,先命令它:"先只给方案和不改代码的评审意见,等我确认。"
- 你看方案(重点看它有没有超出四段式约束)→ 说"可以,动手"或"改这三点"。
- 它改完后,别只看它说"完成了"——自己按 AC1/AC2/AC3 实操一遍(点按钮、看真机、查返回)。
- 每轮迭代问一句:"这轮比上一轮价值提升了吗?" 没提升就丢弃这轮、回到上一个稳定版重写。
- 把结论写回四段式文档,下次新会话直接读,不在对话里反复问同一件事。 操作清单 4.5
- 改代码前先给方案评审,确认再落(双阶段变更)
- 发版前用真实凭证跑通关键链路
- 验收看末端结果(用户看到的那一屏),不只看日志"已执行"
- 每轮迭代设评分门:价值不提升就丢弃
- 把结论沉淀成文档,别在对话里反复问同一件事↩ 回主线(CV5 → CV6):人和模型配合顺了,产品能跑起来。但 CV6 提醒——跑起来不等于交差,上线才是生产级考验的开始。
4.6 产品功能划分及 UI 设计核心原则【主线·错题智库 + 补充·移动端五查 / 模板蒸馏 / @layer】
- Web 优先,原生补差(4.2)。功能划分用单页 hash 路由,存储层 / 状态机一开始定稳(碎片化开发的"地基不能碎"原则,doc3)。
- 【补充·阿平档案 doc7】移动端五查清单(错题智库是安卓 App,这条直接适用,界面检查法):
- 【补充·创意本 doc8】可被程序匹配的设计语言:"大模型内容计划 白名单: home[] 六模块 只写文案, 绝不写 HTML""生成链路是 本地选型 → 大模型只写内容 → 本地渲染 三段式。" 蒸馏方法:"14 品类 × 12 样本 = 168 个真实 App 流程,抽 56 张截图做视觉蒸馏,沉淀 32 模板库 + 两级打分匹配引擎。模型放『建库期』离线蒸馏,不放『运行时』实时搜索——建库时费一次人工,运行时零成本。"
- 【补充·HTML 模板库 doc4】@layer 失效:见第 2 节——改主色没反应,根因是无层级样式压过了 @layer 内样式。正确做法是所有样式都收进层。 操作清单 4.6
- 功能先划成"骨架(数据/状态)+ 增值",骨架先定稳
- 移动端逐条过五查:触控区/按钮层级/长文防溢/状态阈值/留白断点
- 把设计语言离线沉淀成"可被程序匹配"的模板/DSL,别让模型现编 HTML
- UI 评审拿高保真参考样例对照
4.7 从 MVP 到完整产品:版本规划与管理【主线·错题智库 + 补充·创意本 / 知识抽取】
- 版本三件套(doc3 / doc6):① 版本号参数(APK 直链带 `?v=
- 规划阶梯:MVP 只验证一条核心链路,每版只加一类能力。
flowchart TD
    V0[MVP: 跑通一条核心链路] --> V1[V1: 补数据/状态闭环]
    V1 --> V2[V2: 加一个增值层 L5]
    V2 --> V3[V3: 接后端/原生壳]
    V3 --> V4[V4: 真实环境攻坚+评分门]
    V4 --> VN[完整产品: 文档+降级+监控]
真实版本轨迹(都标注来源)
- 【主线·错题智库 doc3】 v1.0 → v1.13.5(versionCode 28):卡红按钮连修 4 版,真根因 WebView 双层权限不一致。教训:仿真环境复现不出真机中间态,让真机自己记现场。
- 【补充·创意本 doc8】 v28 → v98(versionCode 99 / 1.4.59):六道坎——功能框架收敛 / IMA 归档 / 网络检索驱动成长 / 模板库蒸馏 / AI 选型失效 / 空壳 APK(最贵学费)。
- 【补充·知识抽取 Skill doc5】 v1.0 → v1.2 四轮:先跑通端到端 → 补格式覆盖 → 做度量可视化 → 攻坚核心算法质量。 操作清单 4.7
- 每个版本带三件套:版本号 + cache-busting + MD5 指纹
- MVP 只验证一条核心链路,增值层(L5)后置
- 每版只加一类能力,写清"这版加了什么、修了什么"
- 真机/真构建产物优先于仿真:构建后断言产物内容(防空壳)
- 留"未闭环清单",下版开头先清账↩ 回主线(CV3~CV5 收束):第 4 节把"一句需求 → 框架 → 选型 → 云 → 人机 → UI → 版本"全跑了一遍,这条链就是错题智库从 0 到 v1.13.5 的真实路径。下一章用它去套第二个产品,证明骨架可复用(CV7 foreshadow)。
11. 90 天成长路径:把「7 步」走成一条能交付的流水线
▶ 核心观点 CV7(收口):可复用能力 > 一次交付;90 天练出"可迁移骨架"。 前面 10 章把该讲的都讲了,但"知道"和"会"之间隔着一条河。这一章就是那座桥:不按"技能点"打卡,按"一条真产品的流水线"练——90 天里,你把一个点子推成自己和 3 个朋友真在用的 App。
为什么不按技能、按流水线?因为 CV0 说得直白:FDE 交付的是结果,不是知识点。没人会因为你"会调 API"付你钱,只会因为你"把一个需求变成了能用的东西"。
整条流水线 7 步,每步都挂一个核心观点、都带"交付物 + 验收门",过不了门不许进下一步——这就是把 CV5 的"评分门"用在你自己身上:
flowchart LR
    S1["1 选场景<br/>CV4"] --> S2["2 点子→概念<br/>CV3"]
    S2 --> S3["3 原型+用户+MVP<br/>CV5"]
    S3 --> S4["4 AI coding 开发<br/>CV2·CV5"]
    S4 --> S5["5 UI 设计(专家)<br/>CV4·CV7"]
    S5 --> S6["6 部署与测试(含封装)<br/>CV6"]
    S6 --> S7["7 持续优化与发布<br/>CV6·CV7"]
S7 -.沉淀骨架.-> S1一句话:这 7 步走第二遍时会快一倍——因为第 2~5 步沉淀的骨架能直接复用,这就是 CV7 兑现的样子。
第 1 步(W1)· 选场景:先定"要解决谁的什么痛"
不写一行代码,先把"打哪只怪"选对。选错场景,后面 89 天全白费。
动作
- 打开第 1 章方向地图,从 8 条赛道里挑 1 个你自己每天都会痛的方向。铁律:第一个产品的用户永远是你自己。
- 写一张场景卡(就一句话):
谁 + 什么痛 + 他现在怎么凑合。 - 做一次技术预判——先别定选型,只圈范围:这个场景大概率要碰哪些技术? 技术预判对照(照这个圈,别贪多) | 你的场景长这样 | 大概率要用到 | | --- | --- | | 要"读懂"用户给的东西(错题 / 合同 / 论文) | 大模型(文本理解)+ OCR | | 要存下来、下次还能查 | 数据库(Supabase) | | 要听 / 要说 / 要看图 | 音频 · 视频 · 多模态模型 | | 要给人看、还要好看 | UI 设计(第 5 步找 UI 专家) | | 要装进手机 | App 封装(第 6 步) | 交付物:场景卡 1 张 + 技术预判清单 验收门:能不能举出 3 个真实的人和他们的原话?举不出 = 需求是假的。▶ 回扣 CV4:选型没有"最好",只有"和这个场景最配"。所以先定场景,再谈技术。 案例锚点:错题智库的场景卡就是老师一句话——"学生错题都抄在本子上,抄完再也不看"。大米AI科研·课题选题助手(方向 4,资料库 PROJECT_NOTES)同理:高校教师选课题靠拍脑袋、靠运气,但这个案例把选题做成了可量化、可优化的线上系统——和错题智库一样,都是"把一个人脑里反复做的事,变成可复制的产品"。
第 2 步(W2)· 点子 → 完整产品概念
一句话要先长成"骨架",这就是 CV3 的"先搭骨架"。
动作
- 五层展开(接 4.1):一句话 → 用户是谁 → 什么场景用 → 需要哪几个功能 → 每个功能存哪些数据。
- 把展开结果写成四段式文档:功能清单 / 数据结构 / 验收标准 / 已知约束。
- 技术预判落地,明确回答三个 yes/no:要不要大模型?要不要数据库?要不要多模态? 交付物:一页产品概念卡 + 四段式文档 v0 验收门:把这一页纸给一个不懂技术的朋友,他能用自己的话复述你的产品干嘛。▶ 回扣 CV3 + CV0:骨架不对,后面填再多血肉都是返工。 案例锚点:错题智库那份 71KB 交接文档就是四段式的放大版——功能、数据、验收、约束四段齐活,三天后接手的自己还能续上。 常见坑:概念阶段就想"我要做全功能"。90 天很短,这一步要敢在纸上砍。
第 3 步(W3–4)· 原型 + 用户沟通 + 锁定 MVP
先画鬼,再找人看,最后才决定第一次到底做多少。
动作
- 低保真原型:纸面、白板、或线框工具画三五屏——一行代码都别写。
- 找 3 个真实用户聊:把原型递过去,让他们走一遍流程。别问"你觉得好不好"(都会说好),要问"你上次做这件事是什么时候、卡在哪"。
- 砍出 MVP:只留"删掉它产品就不成立"的功能,通常砍到 ≤5 条主功能。
- 每条主功能写验收标准:一句话说清"怎么算做完了"。 交付物:MVP 功能清单 + 每条带验收标准 验收门:主功能 ≤ 5 条;每条能一句话验收(例:"上传一张错题照片,10 秒内出讲解")。▶ 回扣 CV5 + CV1:你是驾驶员,需求取舍由你拍板,别被模型或用户牵着走;产品成不成,不取决于模型多强,取决于主流程是否真的通。 案例锚点:错题智库那个"卡红按钮"连修 4 版,本质就是验收标准没前置——先写清"按钮要能点、点了有反应",就不用返工。
第 4 步(W5–8)· 用 AI coding 把 MVP 造出来
这是"写代码只占 25%"(CV2)真正落地的地方:你的时间主要花在选型、连接、验收、改稿,而不是敲字。
动作(按这个顺序,别乱)
- 选 AI coding 平台:照 4.2 的对比矩阵(WorkBuddy / Cursor / …),按你的场景和习惯选,不追新。
- 连模型:照 4.3 的界面七步先走通一次调用。别把模型 ID 写死——静默换模型是经典雷。
- 连数据库 / 云:照 4.4 的 Supabase 界面步骤——建项目、拿三把 Key、图形化建表、跑通连接。(service_role 打死不进前端。)
- 人机协作:用 4.5 的双阶段变更(先给方案 → 你确认 → 再改)+ 评分门(每轮改完打分,不升就回退)。
- 开发顺序:数据结构 → 后端逻辑 → 页面 → 串起来。一次只让模型干一件事,方便你验收。 交付物:能端到端跑通 1 条主流程的 MVP(v0.3) 验收门:亲自走完主流程,盯末端结果 + 复核产物,确认没有"看起来成功、其实没做"的静默失败。▶ 回扣 CV2 + CV5 + CV1 案例锚点:错题智库的 DeepSeek 连接、B 站搜索代理、Supabase 部署——全是"连接与验收",几乎没手写算法。
第 5 步(W9–10)· UI 设计:调用 UI 设计专家
到了"面子工程",但它是能被程序读懂的工程,不是画得好看就行。
动作
- 先定设计语言:配色、字号、间距、圆角、状态色(涨红跌绿那种),写成一张规范表——让 AI coding 能直接照着生成页面。
- 调用 UI 设计专家 / 技能(WorkBuddy 专家中心里有 UI 设计类专家):把你的产品概念 + 设计语言交给它,产出规范与关键页高保真。
- 过移动端五查(接 4.6):触控区 ≥44px、按钮层级、长文/公式防溢出、状态标签阈值、留白断点。
- 把规范回写成 AI 可执行的约束(提示词或 CSS 变量),让后续页面不跑版。 交付物:UI 规范表 + 3–5 张关键页高保真 验收门:拿规范让 AI 生成一个新页面,不跑版;真机上手指能点中每个按钮。▶ 回扣 CV4 + CV7:组件与风格也是"看匹配";规范一旦沉淀,就是下个产品直接复用的资产。 案例锚点:HTML 模板库"可被程序匹配的设计语言"(含 @layer 静默失效的坑,4.6);创意本的设计 DSL(只写文案、绝不写 HTML);阿平协作档案的移动端五查。
第 6 步(W11–12)· 在线化部署与测试(含 App 封装)
上线不是终点,是"真人开始用"的起点(CV6)。这一步把东西从"我电脑上能跑"变成"别人手机上能用"。
动作
- 前端托管 + 后端 Supabase:图形界面走一遍(New Function → Deploy),或用 Management API 脚本(4.4 的两条路)。
- App 封装:用 WebView 壳 / 打包工具把网页包成 APK / iOS。警惕"空壳包"——打包成功但内容是空的(创意本踩过:
-bootclasspath屏蔽了 JDK 核心库,dex 打成 0 字节)。 - 测试四件套:功能回归(主流程走 N 遍)+ eval 门禁(第 6 章)+ 隐私检查(第 7 章,PII 别外泄)+ 成本看板(第 8 章)。
- 可观测(第 9 章):日志 + 关键错误告警,至少知道"模型是不是在抽风"。
- 版本三件套:版本号 + cache-busting + 产物指纹,保证用户拿到的是新版本。 交付物:线上 URL + 封装包 + eval 报告 验收门:一个没用过的人从拿到链接到走完主流程全程无卡点;eval 达标;单次成本在预算内。
上线前过一遍安全线:全链路数据加密、精细权限管控、权威合规认证,让每一次协作都低风险
▶ 回扣 CV6 + CV1 案例锚点:错题智库的 Supabase 部署 + 版本三件套;创意本的空壳 APK 血泪。
第 7 步(W13+)· 持续优化与发布
上线后才是 FDE 真正的主场(CV6)。别做完就跑——真实使用会把所有没想清楚的地方打回原形。
动作
- 接真实用户:把链接 / 安装包发出去,盯用量和骂声。
- 反馈排序:按"用得多 + 骂得狠"排优先级,别按"我觉得酷"。
- 可观测驱动优化:看日志找模型抽风,看成本找浪费。
- 版本规划:每次迭代只加 1–2 条主功能,加完再上线、再看数据。
- 正式发布:分享链接或上架;写一次复盘(哪些骨架可复用)。 交付物:v1.0 发布 + 迭代看板 + 1 份复盘 验收门:连续 2 周有真实用户在用;你能一句话说清下一版做什么、为什么。
发布后多端触达:WorkBuddy 支持多端下载,用户在哪都能用
▶ 回扣 CV6 + CV7 + CV0:你交的不是"一次产品",是"一套能反复用的做法"。 案例锚点:创意本从 v28 一路迭代到 v98,"评分门 + 整轮重写(而非追加)"就是它的持续优化机制。
90 天日历总表
周次 | 这一步 | 关键动作 | 交付物 | 验收门 |
|---|---|---|---|---|
W1 | 1 选场景 | 定方向、写场景卡 | 场景卡 | 3 个真实的人 + 原话 |
W2 | 2 产品概念 | 五层展开 + 四段式 | 概念卡 + 四段式 v0 | 朋友能复述产品 |
W3–4 | 3 原型 / MVP | 画原型、聊用户、砍 MVP | MVP 清单 + 验收标准 | 主功能 ≤5、可一句话验收 |
W5–8 | 4 AI coding | 选型 / 连模型 / 连库 / 协作 | MVP v0.3 | 主流程端到端跑通 |
W9–10 | 5 UI 设计 | 定规范、调 UI 专家、五查 | UI 规范 + 高保真 | 生成页不跑版、真机可点 |
W11–12 | 6 部署测试 | 部署 / 封装 / eval / 监控 | 线上 URL + 包 + eval 报告 | 新用户全程无卡点 |
W13+ | 7 优化发布 | 收反馈、迭代、发布 | v1.0 + 复盘 | 连续 2 周有人在用 |
毕业考(用错题智库当标尺)
- 7 步全走完,做出一个自己和 3 个朋友真在用的 App(CV0)
- 能说清你选的模型/平台/云"为什么是它不是别的"(CV4,第 4 节矩阵)
- 抓过一次静默失败(盯末端结果 + 产物复核,第 2 节:卡红 / @layer / 空壳 APK)
- UI 规范能让 AI 不再跑版(CV7,可复用资产)
- 上线的东西有 eval 门禁 + 成本看板 + 监控(CV6)
- 有一份 71KB 级别的交接文档,三天后的你能直接续上(CV3) 做不到这些,你还是"会用 AI 写代码"的人,不是 FDE。
FDE 判断原则 10 条(从 8 个案例 + 跨行业案例抽象)
走完 90 天,把这 10 条刻进肌肉记忆——它们是从错题智库、创意本、PROJECT_NOTES、知识抽取、以及第 1 章跨行业案例里反复出现的"可复用判断",比任何工具教程都值钱(接 CV7:可复用 > 一次交付):
- 先找"替代行为"再谈 AI:别人已经在用笨办法做这件事(如小红书纯色图补光),你用 AI 做得更好,就有人用;没有替代行为,说明需求可能是假需求。
- 第一个用户是你自己:别一上来想做平台。错题智库、PROJECT_NOTES、Crash Out Diary 都从"自己痛"起家。
- 先骨架后血肉:一句话需求先过五层展开 + 四段式,骨架不对后面全是带息返工(CV3)。
- 选型看匹配不看新:平台/模型/云没有最好,只有最配此刻任务;换来换去的隐性成本 > 平台差异(CV4)。
- 你是驾驶员,模型是副驾:双阶段变更(先评审后执行)+ 评分门(价值不升就丢弃),安全带一个都不能少(CV5)。
- 盯末端结果,别盯中间状态:产物要复核内容别只复核存在——卡红按钮、@layer 失效、空壳 APK 全是"看起来成功其实没做"(CV1)。
- 上线即开始运营,不是发完就完:小猫补光灯上线 2 天更 3 次靠评论迭代;你的产品每轮也要问"更值得用吗"(市场层翻车)。
- 没有受众就先养:Alex Finn 的 $300k 靠已有大受众;你如果没有,就先发内容、先做社群,别裸奔上架(模式选择器)。
- 可复用 > 一次交付:每个产品沉淀骨架(规范/模板/文档),第二遍快一倍;四段式文档是给"三天后的你"的礼物(CV7)。
- AI 做快,人做黏:模型负责生成,你负责"非你不可"的领域判断、信任和持续运营——这是个人 FDE 真正的护城河(第 0 章跨行业定性)。起步建议:从第 1 章方向地图里挑一个你自己的痛点,别挑"看起来能火"的。第一个产品的用户,永远是你自己。等你按这 7 步走第二遍时,会发现自己快了一倍——那就是 CV7 兑现的时候。
原创声明:本文由作者用 WorkBuddy(AI 编程平台)实操沉淀,属个人真实经验,非水文。关注我,持续分享「个人级 AI App 从 0 到上线」的实战方法。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号