用餐厅和盘子理解栈和堆
原创
用餐厅和盘子理解栈和堆
原创
leikooo
修改于 2026-10-06 16:24:52
修改于 2026-10-06 16:24:52
最近在学 Rust。其实之前就学过一段时间,但学到所有权这里就卡住了,概念一多加上当时在专升本,后面就放弃了🥲。趁着国庆假期有整块时间,决定重新捡起来,这次争取把它啃下来。
本文的内容来源于 Rust 官方教程 What Is Ownership?,在学习所有权(Rust 独有的机制)之前,官方先花了一段篇幅介绍栈(Stack)和堆(Heap)。很多从 Java、Python、Go 这类有 GC 的语言转过来的同学(包括我自己)平时很少关心数据到底放在哪里,所以这一段读起来有点抽象,我让 AI 翻译了一下并且加上了一些内容,方便我理解,我感觉写的挺好的,就分享一下。
栈 Stack
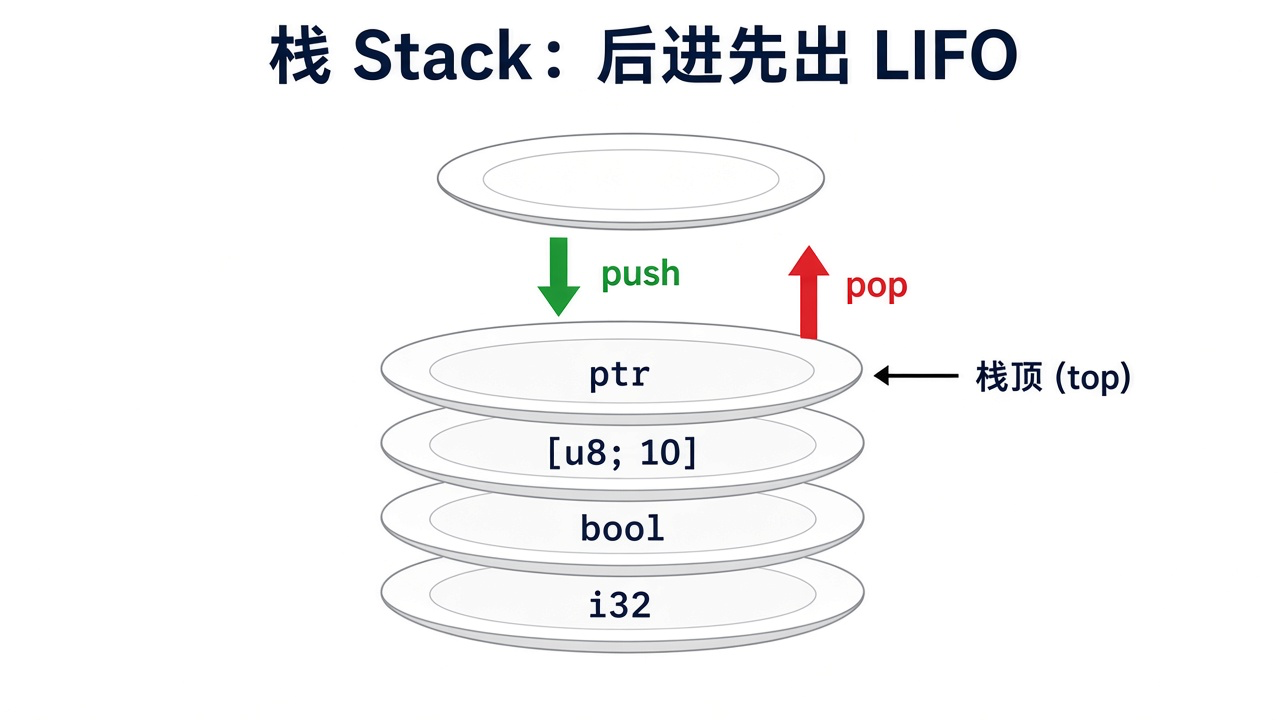
栈的规则只有一条,叫后进先出(LIFO):最后放上去的盘子,最先被拿走。
   放入(push)     取出(pop)
       ↓             ↑
    ┌───────┐
    │ 盘子 3 │  ← 栈顶:只能在这里操作
    ├───────┤
    │ 盘子 2 │
    ├───────┤
    │ 盘子 1 │  ← 最先放的,最后才拿走
└───────┘栈有一个硬性要求:每个数据的大小必须在编译时就确定,而且不能变。
就像每个盘子尺寸都一样,才能整整齐齐摞起来。i32(4 字节)、bool(1 字节)、[u8; 10](10 字节)这类类型都可以放在栈上。
栈为什么快? 因为根本不用找位置,新数据永远放在栈顶。分配内存只是把栈顶指针挪一下,几乎不花时间。
堆 Heap
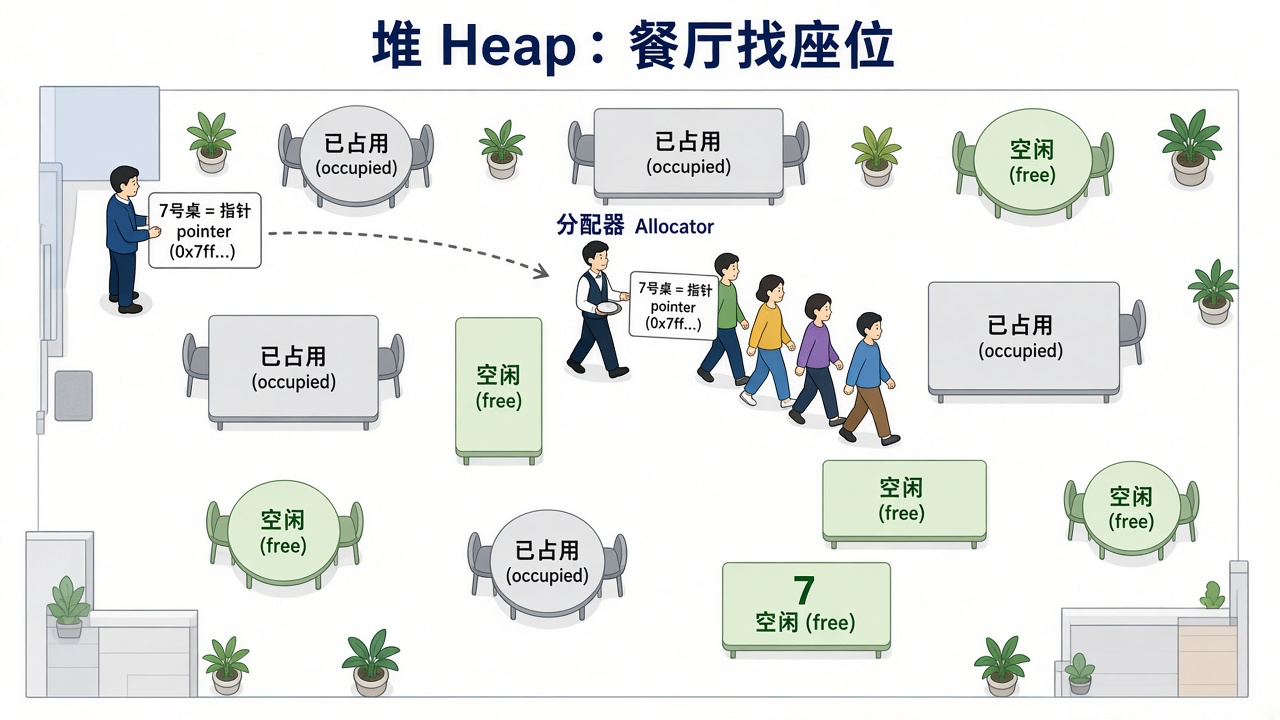
堆:餐厅找座位
如果数据大小在编译时不知道,或者运行中会变化(比如用户输入的字符串、一个会不断 push 的 Vec),就没法放在栈上,只能放到堆里。
堆就像一家餐厅:
- 你进门告诉服务员:"我们 4 个人。"(申请 4 个单位的空间)
- 服务员在店里找一张够大的空桌。(分配器搜索空闲内存)
- 把桌子标记为"已占用",并告诉你:"你们坐 7 号桌。"(返回一个指针,也就是内存地址)
- 朋友晚到了,只要问"7 号桌在哪"就能找到你们。(通过指针访问数据)
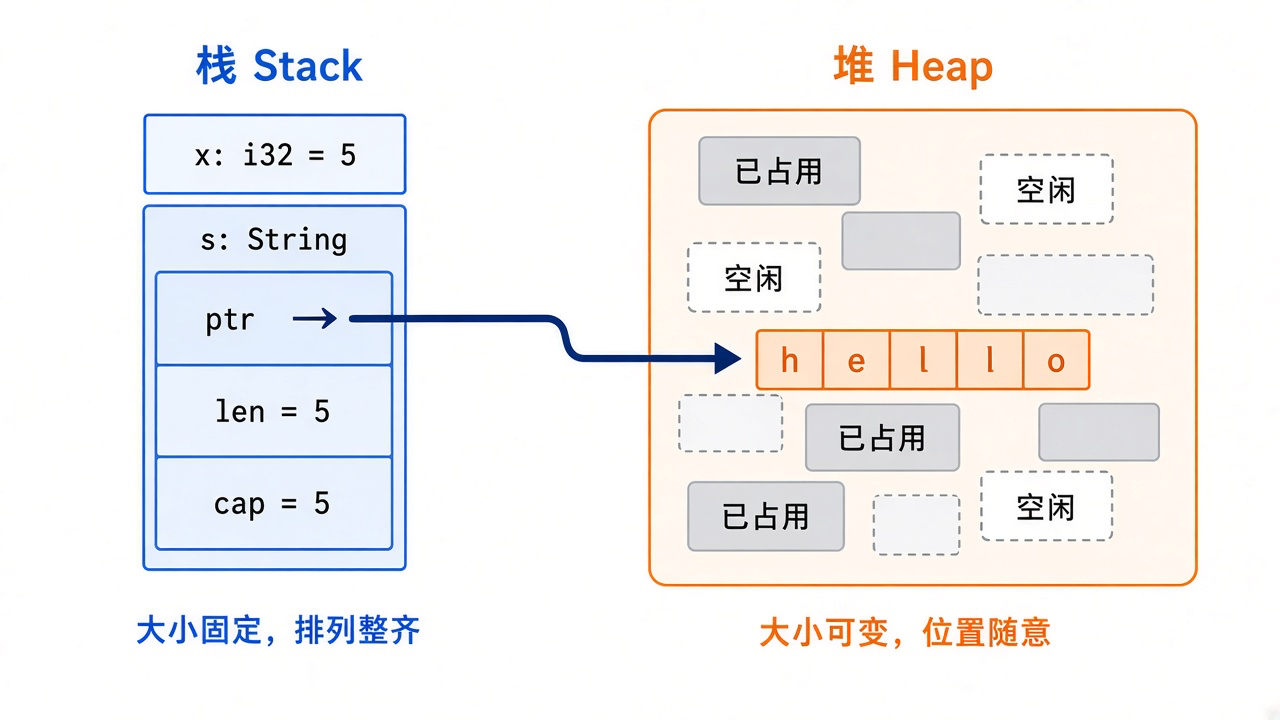
栈和堆的内存结构
        栈(Stack)                         堆(Heap)
   ┌──────────────────┐            ┌─────────────────────────┐
   │ x: i32 = 5       │            │ ░░░░  [已占用]  ░░░░░░░  │
   ├──────────────────┤            │                         │
   │ s: String        │            │   ┌───┬───┬───┬───┬───┐ │
   │  ├ ptr ──────────┼───────────►│   │ h │ e │ l │ l │ o │ │
   │  ├ len = 5       │            │   └───┴───┴───┴───┴───┘ │
   │  └ cap = 5       │            │ ░░░  [空闲]  ░░░░░░░░░░  │
   └──────────────────┘            └─────────────────────────┘
大小固定,排列整齐 大小可变,位置随意关键点:指针本身大小是固定的(64 位系统上是 8 字节),所以指针可以放在栈上,它指向的真实数据放在堆上。String 就是这样:栈上存"指针 + 长度 + 容量"三个字段,字符内容存在堆上。
栈和堆的区别
先用一张表把两者放在一起对比:
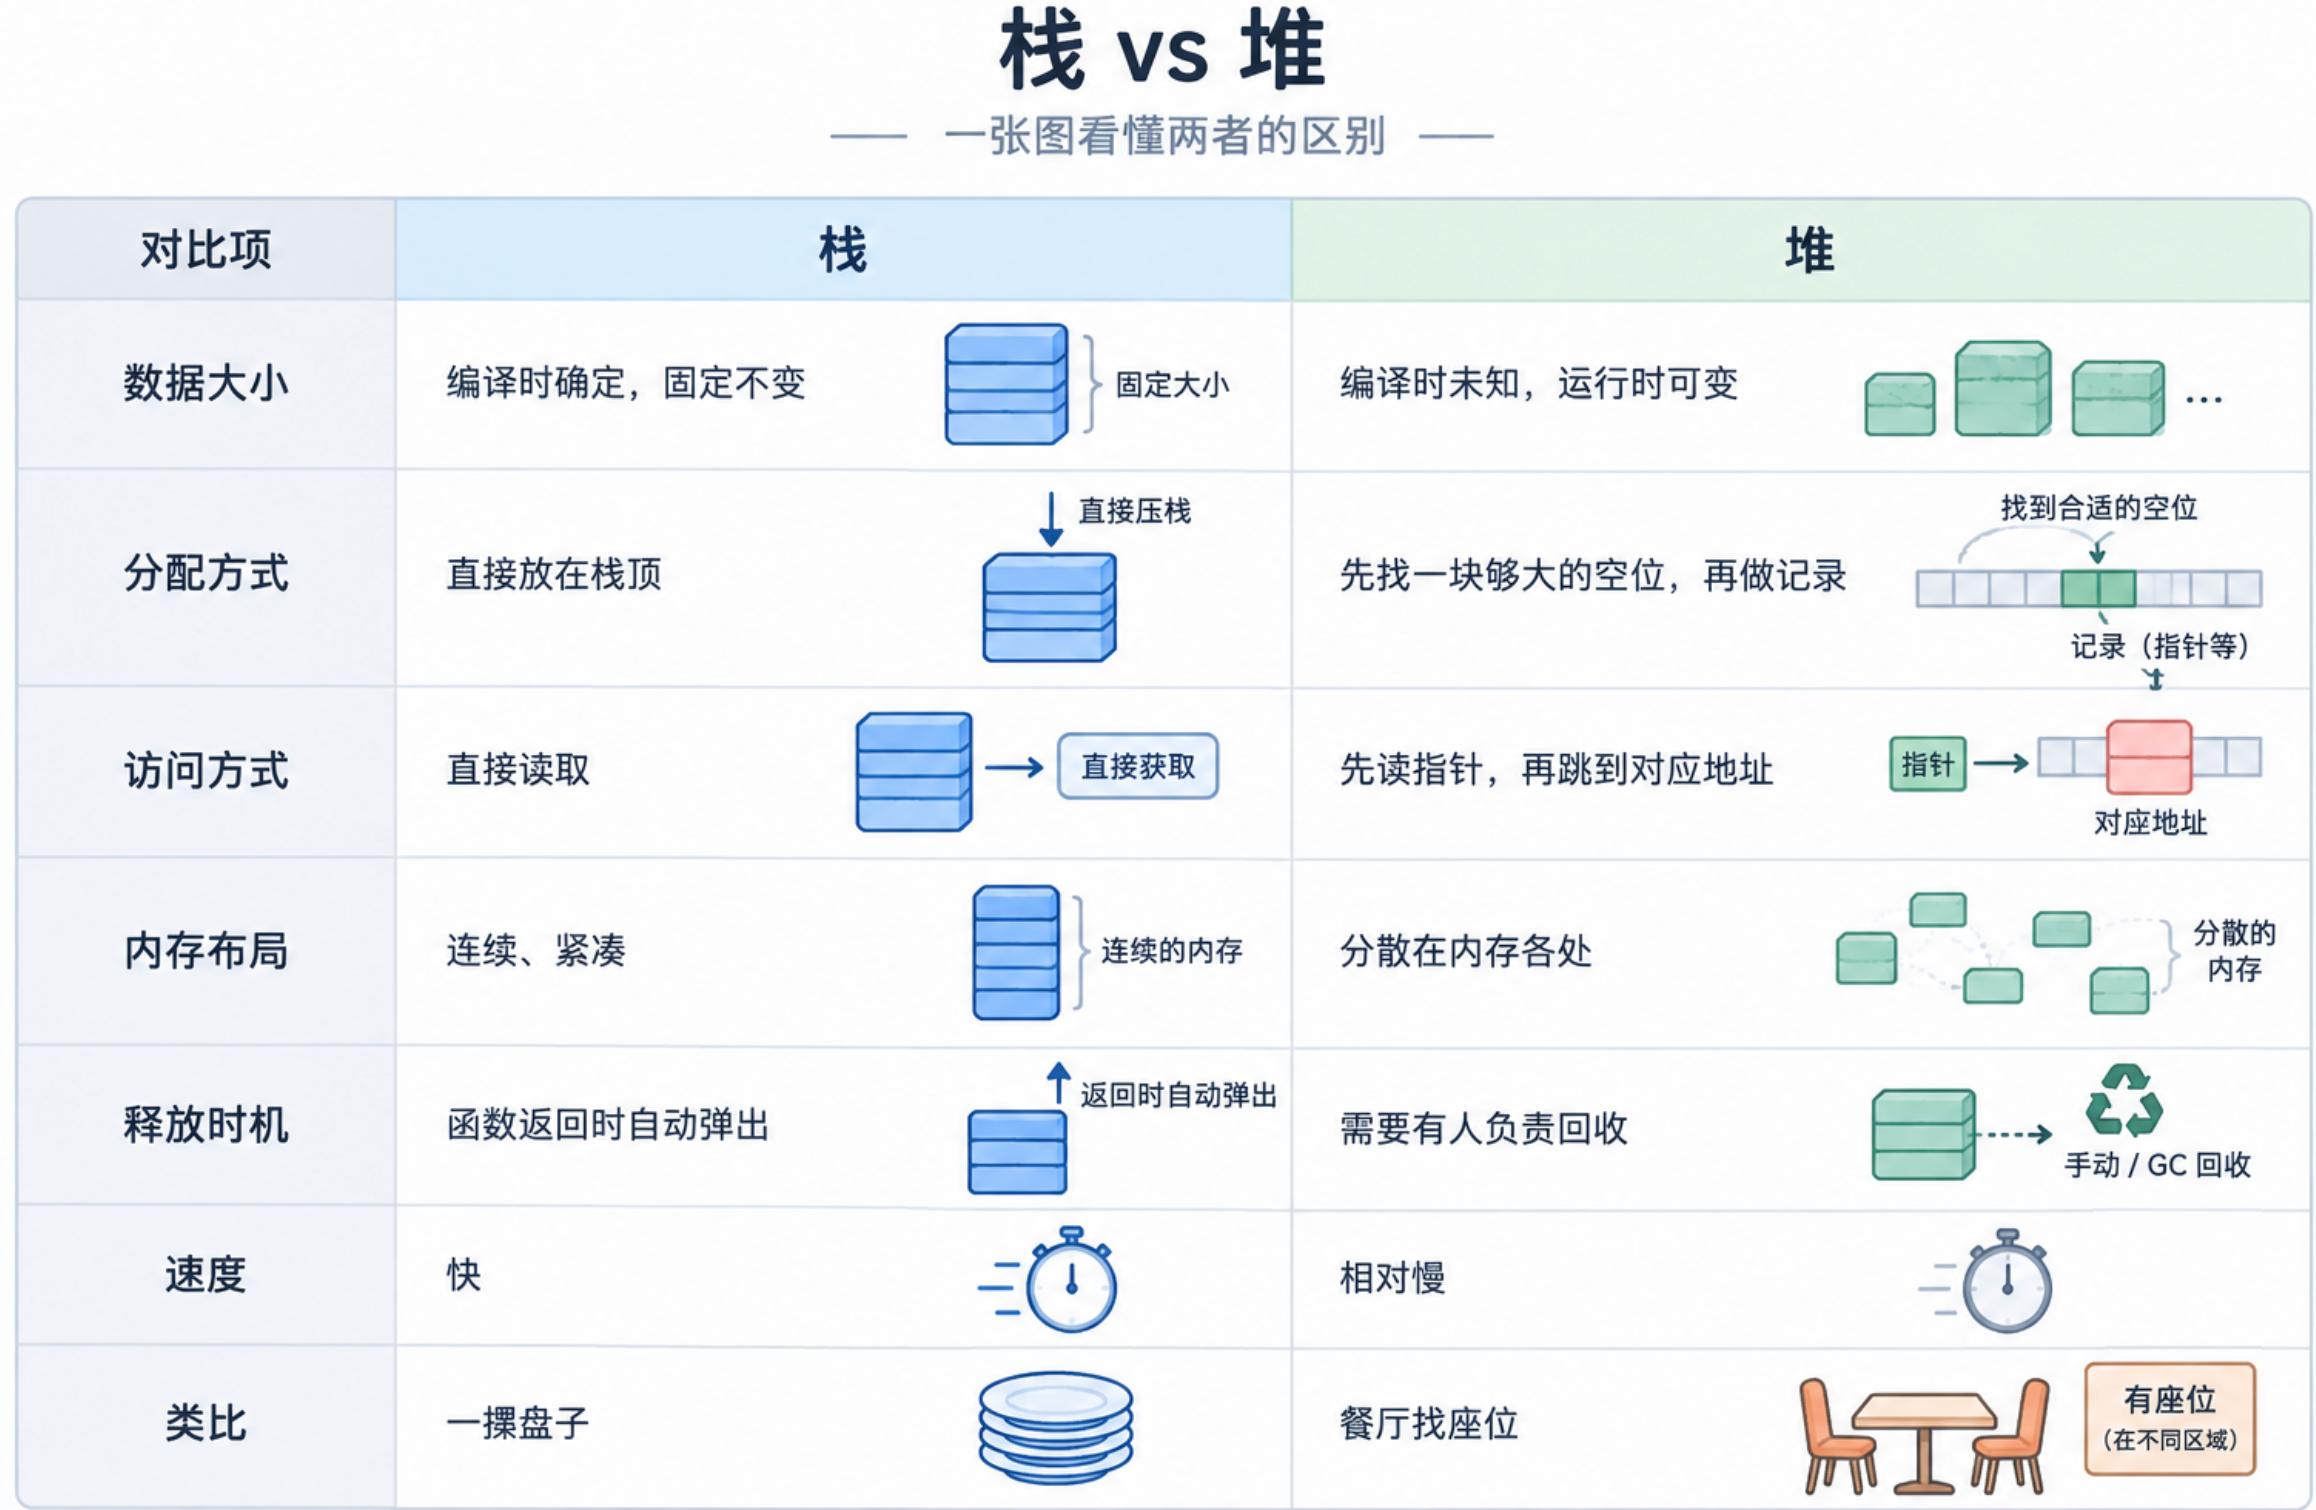
其中最直观的差别是速度,堆比栈慢主要体现在两个环节。
1. 分配:栈不用找位置,堆要找
往栈上放数据,就像往盘子堆上再放一个,位置永远是栈顶,挪一下栈顶指针就完事了。
往堆上放数据,就像服务员要满店找一张够大的空桌,找到后还要登记"这张桌有人了",步骤多得多。
2. 访问:栈直接拿,堆要跳一下
访问栈上的数据可以直接读;访问堆上的数据要先读指针,再跳到指针指向的地址,多了一步。更重要的是,堆上的数据可能散落在内存各处。
还是用餐厅打比方,一个服务员负责点单:
高效(类似栈):A桌 → A桌 → A桌 → B桌 → B桌 → B桌
低效(类似堆):A桌 → B桌 → A桌 → B桌 → A桌 → B桌
                  ↑ 来回跑,大部分时间花在路上
CPU 也一样:数据在内存里挨得越近,CPU 缓存命中率越高,处理就越快;在内存里跳来跳去就会变慢。
至于"释放时机"这一行的差别,正是后面要讲的重点:栈上的数据随函数调用自动清理,而堆上的数据需要有人管,这也是所有权要解决的问题。
函数调用的实现
调用函数时,参数和局部变量会被压入栈;函数返回时,这些数据被弹出,自动清理,不用操心。
fn main() {
    let a = 1;
    foo(a);
}

fn foo(x: i32) {
    let y = 2;
} main开始 调用foo foo结束 main结束
┌────────┐ ┌────────┐ ┌────────┐
│ │ │ y = 2 │ │ │
│ │ │ x = 1 │ foo │ │ (空)
│ a = 1 │ │ a = 1 │ main │ a = 1 │
└────────┘ └────────┘ └────────┘栈上的数据根本不需要人管理,因为它的生命周期和函数调用严格绑定。
麻烦的是堆的分配
堆上的数据不会随函数结束自动消失。这就带来了几个问题,继续用餐厅类比:
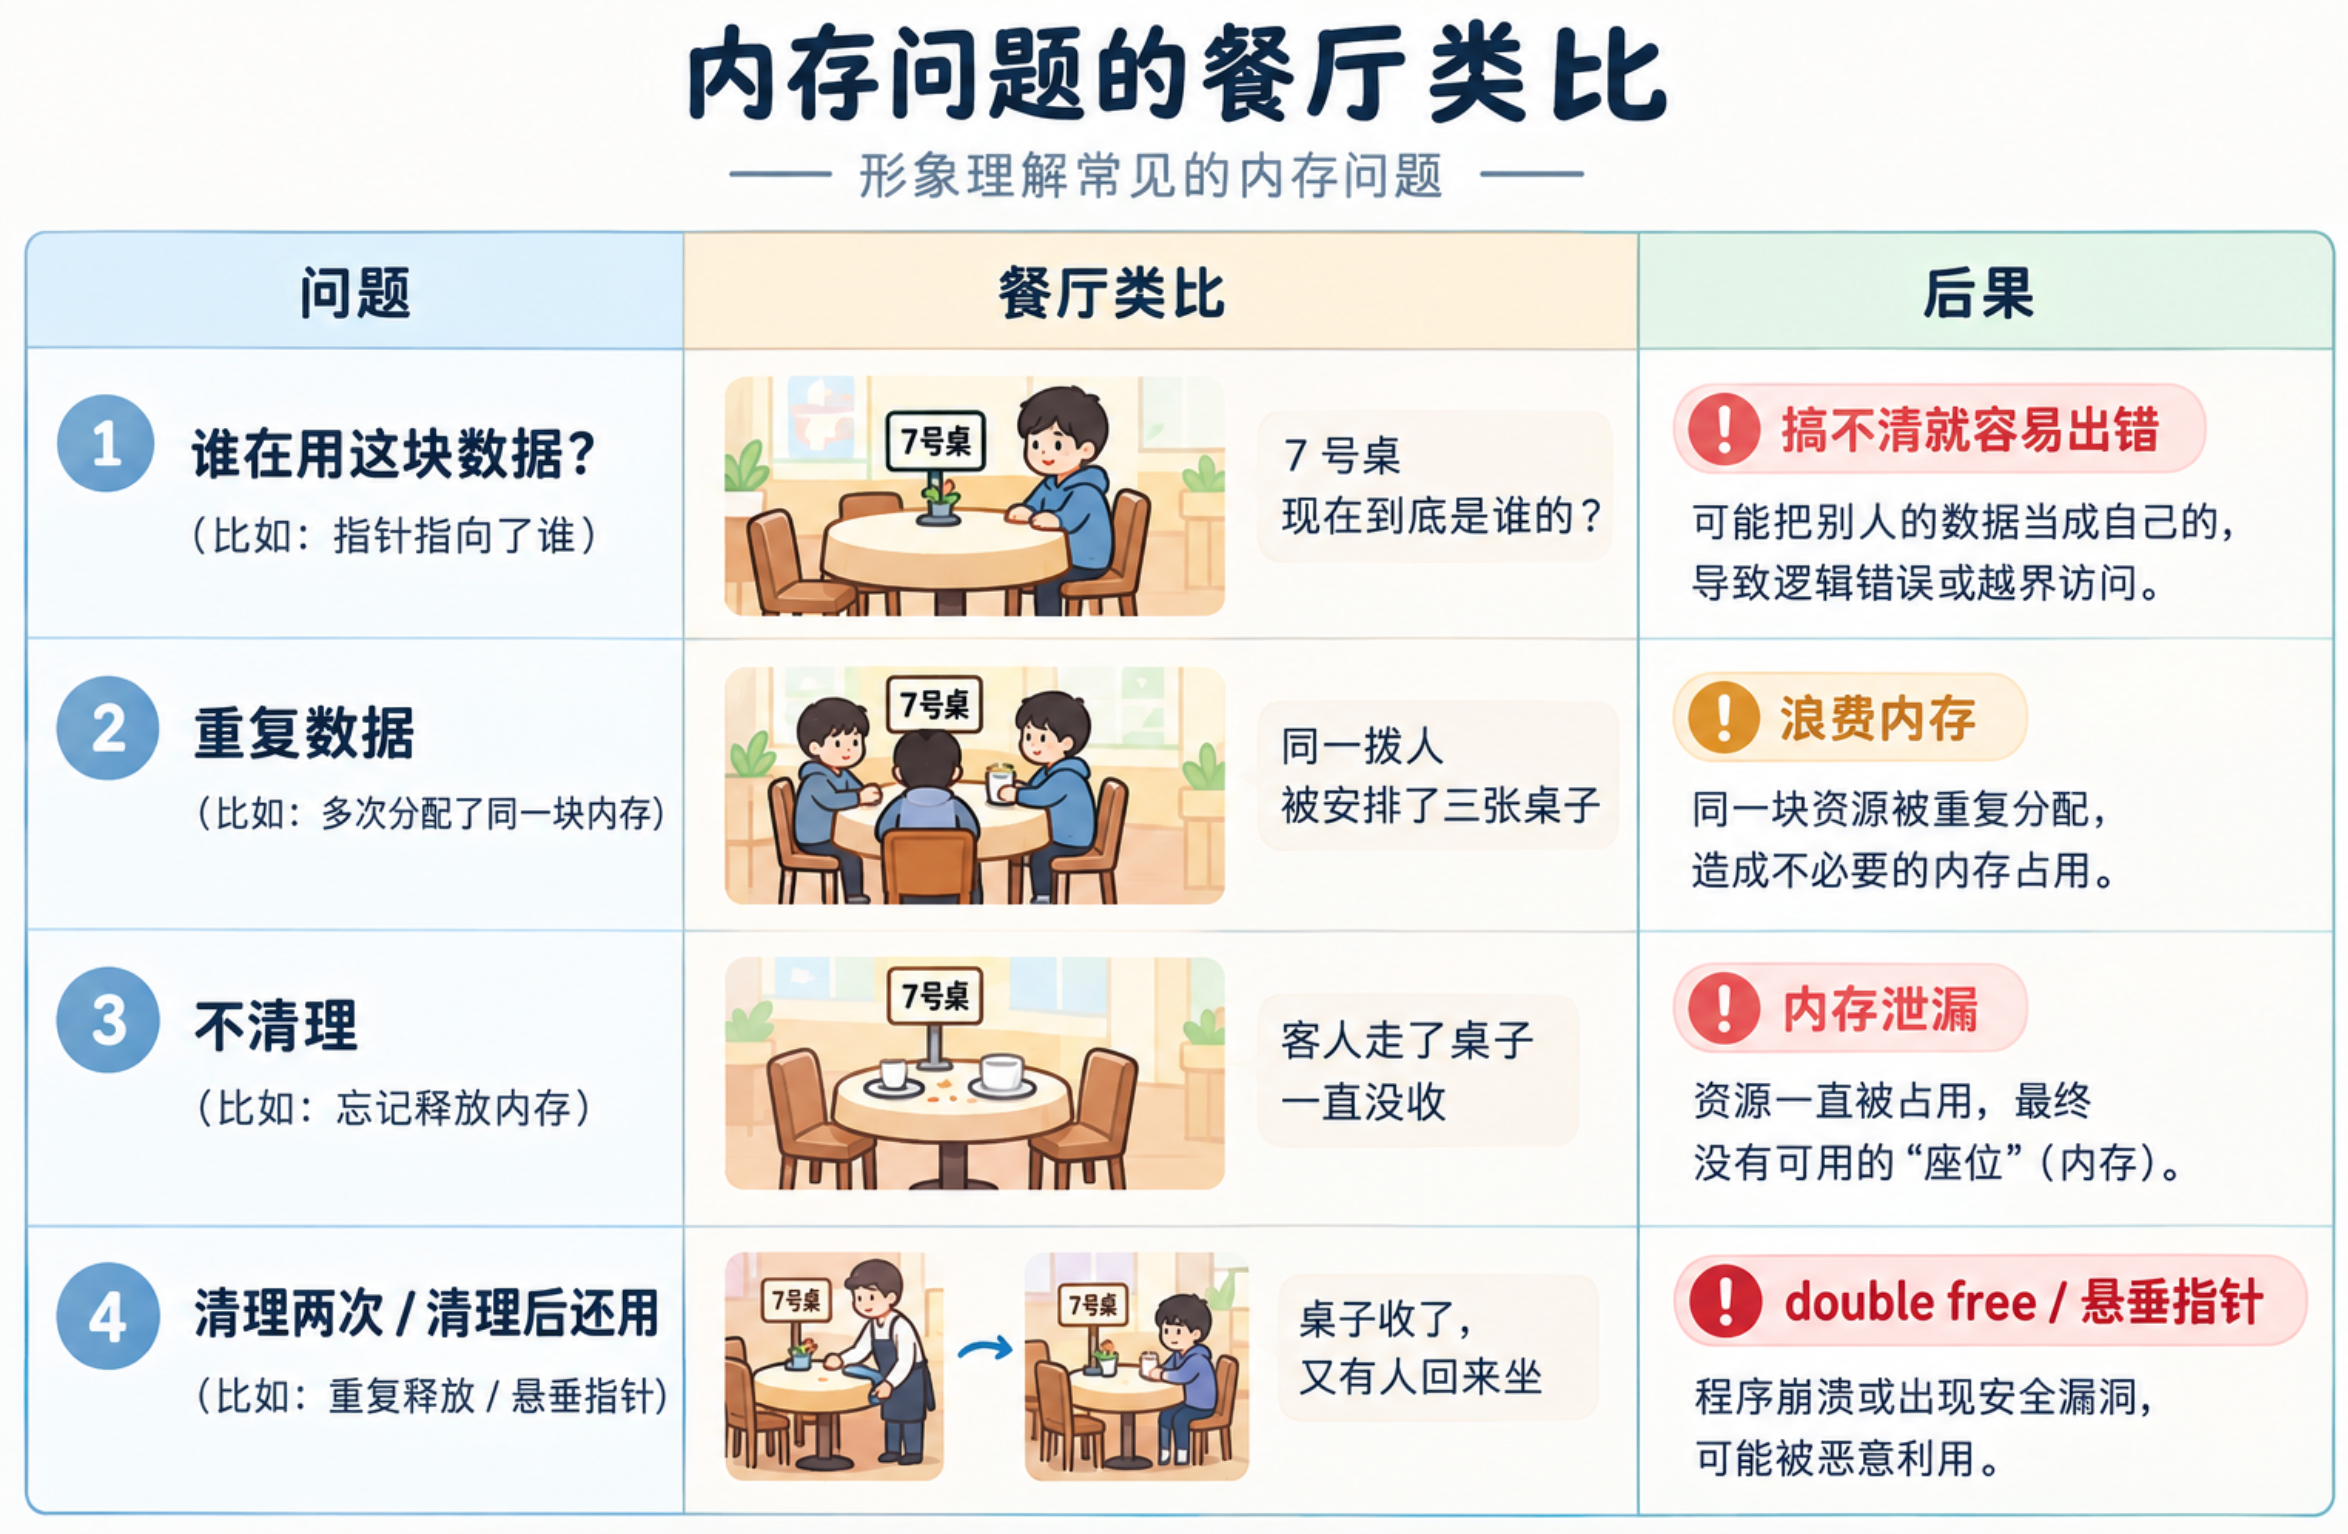
各语言处理这些问题的方式不同:
- C/C++:靠程序员手动
malloc/free,容易出错。 - Java/Go/Python:用垃圾回收器(GC)定期巡视、回收,省心但有运行时开销,还有需要单独学习垃圾回收机制😭。
- Rust:用所有权规则在编译期就保证安全。每块堆内存都有唯一的"主人"(owner),主人离开作用域时内存自动释放,没有 GC 开销,也不会忘记释放。
{
    let s = String::from("hello"); // 在堆上分配,s 是主人
    // 使用 s ...
}   // s 离开作用域 → Rust 自动调用 drop → 堆内存被释放
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号