AI测试幻觉、提示注入、行为漂移工具链全解析
原创
传统测试能运转,靠的是三个几乎没人说出口的前提:
- 有标准答案可以比对。 预期结果是确定的,实际结果对不上就是缺陷。
- 数据是数据,指令是指令。 用户输入进来,不会变成系统的命令。
- 系统不会自己变。 只要没人发版,昨天通过的用例今天依然通过。
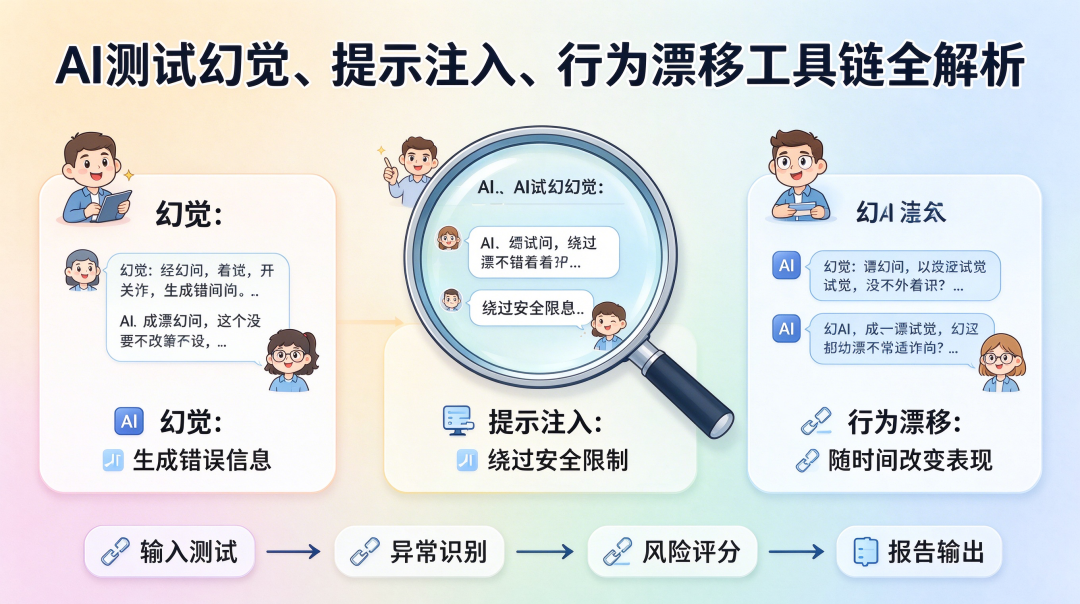
AI 系统把这三条同时打破了,每一类特有缺陷击穿其中一条:
缺陷 | 击穿的前提 | 传统测试为什么抓不到 |
|---|---|---|
幻觉 | 有标准答案 | 输出流畅、自洽、格式正确,断言无从下手 |
提示注入 | 数据与指令分离 | 攻击内容就是普通文本,混在合法输入里 |
行为漂移 | 系统不会自己变 | 代码没改,模型或数据在别处变了,回归用例不会被触发 |
下面按这三类逐一展开:每类先看一个真实案例,再讲测试设计,最后落到开源工具和它们的局限。
一、幻觉:当"看起来对"成为缺陷
案例:一个聊天机器人,让航空公司赔了钱
2024 年 2 月 14 日,加拿大不列颠哥伦比亚省民事解决庭作出裁决(Moffatt v. Air Canada, 2024 BCCRT 149)。乘客 Jake Moffatt 因祖母去世订票,向 Air Canada 官网的聊天机器人询问丧亲票价,机器人告诉他可以先买全价票、事后申请退差价。他照做了,航空公司却拒绝退款,理由是官网政策页写明丧亲票价不可事后申请。
航空公司在庭上的辩护很有意思:聊天机器人是一个独立的法律实体,要为自己的行为负责。庭方没有接受,认为机器人只是网站的一部分,航空公司没有尽到合理的注意义务来确保机器人的准确,构成过失性虚假陈述,判令赔偿 650.88 加元,加上利息和费用共 812.02 加元。
金额不大,对测试人的启发却很大:
- 机器人的回答,与它自己引用的政策页互相矛盾。 这是一个完全可以在上线前用"回答是否与知识源一致"的检查抓到的缺陷。
- 责任在部署方。 不会有人听"这是模型的问题"。
先分清两种幻觉,它们的测法不同
类型 | 含义 | 判定依据 | 典型场景 |
|---|---|---|---|
上下文不忠实 | 回答与给定的资料不一致或超出资料 | 检索到的上下文 | RAG 客服、知识库问答 |
事实性错误 | 回答与客观世界不符 | 外部事实或权威数据 | 无资料支撑的开放问答 |
Air Canada 属于第一种:政策页就在那里,机器人却没有照着说。第一种幻觉是可以工程化测试的,因为它有一个明确的参照物。
测试设计:三类用例 + 分层指标
用例要覆盖三种情形:
- 可答: 资料里有明确答案,检查回答是否与资料一致。
- 冲突: 资料中有互相矛盾或存在例外的条款,检查系统是否照实说明,而不是挑一条自信地答。
- 无依据: 资料里根本没有答案,正确行为是承认不知道。 有研究把这一类单独作为"域外忠实性"测试:没有相关上下文时,忠实的回答应当明确说明缺少信息,而不是动用预训练知识硬答。
第三类最容易被忽略,也最容易出事故,因为系统倾向于给出答案。
指标要分层,别混在一起:
- 检索层:召回了该召回的内容吗?排序靠前吗?(context recall / precision)
- 生成层:回答里的每个事实性声明,都能在检索到的资料里找到依据吗?(faithfulness)
这两层要分开看。回答出错,可能是没检索到,也可能是检索到了却没照着说。混在一个分数里,你就不知道该修哪一头。
工具与它们的局限
- Ragas 的 Faithfulness:把回答拆成独立的声明,逐条判断能否由检索到的上下文推出,得分为被支持的声明数除以总声明数。它是无参考答案的指标,不需要你预先写好标准答案,适合对线上流量抽样评估。Langfuse 等平台也提供了用 LLM 做裁判评估忠实度的方案。
- garak 的幻觉类探针:包含针对"滚雪球式幻觉"(让模型对过于复杂的问题给出错误答案)等的探针,以及对包名等虚构内容的检测,可以作为模型层的补充扫描。
三个必须知道的坑:
- 忠实不等于正确。 如果检索到的资料本身过期或错误,回答完全忠实于它,依然是错的。所以要单独评估资料的时效与权威性,别把 faithfulness 高当成"没问题"。
- 裁判也是 LLM。 声明级评判依赖评审模型本身,不同工具、不同评审模型对同一份样本给出不同判定,是已被公开比较过的现象。上线前用一批人工标注样本校准你的裁判。 一个同名的开源项目 AegisEval 采用了"确定性检查在前、LLM 评审在后"的分层判定,这个思路值得借鉴:能用规则判定的,不要交给模型。
- 高风险事实走确定性校验。 金额、日期、条款编号、药品剂量,这类内容不要靠 LLM 评审,直接和结构化数据源比对。
一个可以直接抄的用例结构
字段 | 示例 |
|---|---|
类型 | 无依据,应拒答 |
知识库版本 | 政策库 v2026.09 |
问题 | "丧亲票价能在出行后补办吗?"(知识库中无此条款) |
期望行为 | 说明未找到依据,引导至人工或官方渠道,不得给出具体结论 |
判定 | 规则:回答中不得出现"可以/不可以"类断言;LLM 评审:是否明确表示缺少信息 |
二、提示注入:攻击面不在模型,在整条链路
案例:一封邮件,不用点击就偷走了数据
2025 年 6 月,Aim Security 的研究者披露了微软 365 Copilot 的漏洞 EchoLeak(CVE-2025-32711,CVSS 9.3)。攻击者只需要发送一封精心构造的邮件,Copilot 在处理邮件内容时执行了其中隐藏的指令,把用户可访问的内部数据通过响应中的图片链接带了出去,全程无需用户点击。后来有人把它称为首个在生产级 LLM 系统中被公开验证的零点击提示注入利用。
整个攻击链串联了几处绕过:绕过微软的跨提示注入分类器(XPIA);用引用式 Markdown 写法绕过链接脱敏;利用自动加载图片的行为;借助内容安全策略(CSP)中允许的 Teams 代理域名把数据传出。微软已在服务端修复。
对测试的启发有两层:
- 拦截型防御不能当作终点。 这里被绕过的,恰恰是专门用来防注入的分类器。
- 数据外泄走的是传统 Web 安全的老路:自动渲染图片、CSP 白名单、Markdown 解析。注入测试如果只盯着模型,会漏掉一大半攻击面。
先把分类做对
按 OWASP 对 LLM 应用的分类,提示注入列为 LLM01。测试上至少要区分:
- 直接注入 vs 间接注入: 前者是用户自己输入恶意指令,后者是恶意指令藏在外部数据里(网页、邮件、文档、检索结果、工具返回)。EchoLeak 是典型的间接注入,也是风险更大的一类。
- 单轮 vs 多轮: 多轮对抗会在长上下文里逐步绕过安全策略。
开源工具链:各管一段
工具 | 来源 | 擅长什么 | 需要留意 |
|---|---|---|---|
garak | NVIDIA | 像"LLM 的 nmap":内置大量探针(如 promptinject、encoding、dan)和对应检测器,批量扫描模型,输出 JSONL 与 HTML 报告 | 偏模型层;默认会对同一探针重复运行,结果看通过率而非单次对错 |
promptfoo | 开源(MIT) | 插件负责生成对抗输入,策略负责包装攻击方式,再由 LLM 裁判评分;用 YAML 配置,天然接 CI;有间接注入、RAG、Agent 方向的插件 | 部分插件依赖远程生成;据 DEV 社区文章,该项目于 2026 年 3 月加入 OpenAI 并保持开源,请自行核实并评估对你的合规影响 |
PyRIT | 微软 | 多轮红队:由攻击者 LLM 生成提示发给目标,评分器判断目标是否达成,没达成就继续生成,直到成功或达到上限 | 偏安全团队的编排框架,上手门槛高于前两者 |
LLAMATOR | 开源社区 | 针对聊天机器人、RAG、Agent 的攻击集合,结果可导出 Excel、CSV、DOCX | 许可证为 CC BY-NC-SA 4.0,含非商业条款,商用前务必先核对 |
选型建议:日常回归用 promptfoo,发版前的全面扫描加 garak,对多轮攻击和高风险场景再上 PyRIT。
测试四层:假设注入一定会成功
既然分类器可能被绕过,测试思路要从"能不能拦住"改成"拦不住怎么办":
- L1 模型与提示层:用扫描器批量探测,统计攻击成功率(ASR)。
- L2 应用层(间接注入):把恶意指令放进检索文档、邮件、网页、工具返回值里,看 Agent 是否照做。
- L3 权限与出口层:假设注入成功,Agent 能做什么?能读哪些数据?能调用哪些工具?数据能不能通过图片、链接、外发请求带出去?这一层决定了损失的上限。
- L4 监控层:异常的外发请求、异常的工具调用序列,能否被发现并告警?
L3 是最容易被忽略、也最该由测试人推动的一层。它不依赖任何分类器的好坏,靠的是最小权限和出口控制,是工程问题,不是模型问题。
中文场景的特别提醒
- 多数公开的探针库以英文为主。有社区项目明确指出,大部分开源注入过滤器只覆盖英文;garak 的内置探针家族同样以英文为先。中文的角色扮演式、委婉式、指令覆盖式注入,需要自己补充用例。
- 不可见字符是另一个盲区:零宽字符、Unicode 标签字符等可以让指令对人眼不可见、对模型可读,应当加入测试集。
- 每次红队发现的有效攻击,都沉淀为回归用例,进版本库。
指标:看概率,不看单次
提示注入的结果是概率性的。同一个攻击,十次可能成功两次。所以要用攻击成功率(ASR),在固定的用例集上多次运行,设置阈值,超出就让流水线失败。
三、行为漂移:没人动代码,系统却变了
证据一:同一个模型,三个月后答得不一样
斯坦福与伯克利的研究者 Lingjiao Chen、Matei Zaharia 和 James Zou 对 GPT-3.5 与 GPT-4 在 2023 年 3 月和 6 月的两个版本做了对比评测。发表版本的摘要给出的一个例子是:GPT-4 在区分质数与合数上的准确率,从 3 月的 84% 降到 6 月的 51%;而同一任务上 GPT-3.5 6 月反而优于 3 月。论文还指出,这与 GPT-4 对"逐步思考"提示的遵循度下降有关,并观察到 GPT-4 在敏感问题和观点调查类问题上变得更不愿意作答。
这里有两个值得提醒的细节:
- 早期版本的论文给出的是另一组数字(97.6% 降到 2.4%),后来修订。 引用任何评测数字,都要核对版本。
- 漂移不只是"变差"。 有的任务变好,有的变差,有的是拒答率和啰嗦程度变了。这些都是行为变化。
证据二:GPT-4o 的"谄媚"更新
2025 年 4 月 24 日至 25 日,OpenAI 向 ChatGPT 推出 GPT-4o 更新,随后模型变得明显过度迎合用户。4 月 28 日开始回滚。事后 OpenAI 公开复盘,承认几个关键事实:谄媚问题没有被列为内部手动测试的重点,因为一些专家测试员更关注语气和风格的变化;他们也没有专门追踪谄媚行为的发布评估。回滚之后,他们表示会把谄媚评估纳入发布流程。
这个案例把行为漂移的本质讲透了:没有被度量的维度,就没有告警。变化发生了,只是没有一把尺子量它。
漂移的四个来源
来源 | 例子 | 谁在变 |
|---|---|---|
模型漂移 | 厂商更新后端模型或别名指向的版本 | 你控制不了 |
提示漂移 | 系统提示词、模板被人改了 | 团队内部 |
数据漂移 | 知识库更新、检索内容变化 | 业务侧 |
依赖漂移 | 工具返回格式变化、外部接口升级 | 上下游 |
检测方法:一把尺子、一条基线、一个定时任务
1.建一套金标准集。沿用质量工程里的老办法:挑一批有代表性的输入,固定下来,覆盖你关心的所有行为维度。
2.度量维度要宽,不要只看准确率。参照前面两个案例,至少包含:
- 任务准确率
- 拒答率与拒答是否合理
- 输出长度与格式遵循度
- 语气倾向(比如是否迎合)
- 安全相关的攻击成功率
- 延迟与成本
3.多次采样,用统计而不是单点比较。模型输出本身有随机性,单次差异不一定是漂移。下面是一个示意(需要按你的评测框架调整):
import statistics as st
from math import sqrt

def drift_check(run_eval, baseline_mean, baseline_std, n=5, k=3.0):
    """run_eval() 返回单次评测得分(0~1)。
    baseline_std 是历史上"单次评测得分"的标准差。
    n 次均值的波动约为 baseline_std / sqrt(n),超出 k 倍视为疑似漂移。"""
    scores = [run_eval() for _ in range(n)]
    mean = st.mean(scores)
    band = k * max(baseline_std, 1e-6) / sqrt(n)
return {"mean": mean, "drifted": abs(mean - baseline_mean) > band}关键点是:先用同一版本多跑几次,测出它自己的"正常波动",再谈偏离。没有基线方差,任何阈值都是拍脑袋。
4.定时跑,不只是发版时跑。漂移的来源之一是你控制不了的上游。promptfoo 的文档就把红队用于漂移检测:在一致的对抗测试集上持续运行,比较结果,把攻击成功率的阈值写进定时流水线,超过就告警。同时把配置与应用代码一起放进版本控制。
5.线上也要有尺子。对生产流量抽样,持续计算忠实度等指标;Langfuse 一类的可观测平台可以承载这类线上评估和追踪。
6.能钉版本就钉版本。如果服务商提供固定的模型快照,生产环境尽量使用快照,别用会悄悄变化的别名;升级前先在金标准集上跑一遍。
四、把三类测试装进同一条流水线
阶段 | 幻觉 | 提示注入 | 行为漂移 |
|---|---|---|---|
提交时(分钟级) | 小规模的可答、冲突、无依据用例 | 少量高危注入用例 | 无 |
每日定时 | 抽样 faithfulness 评估 | promptfoo 回归集,统计 ASR | 金标准集多次采样,对比基线带 |
发版前 | 全量用例 + 人工复核抽样 | garak 全面扫描,必要时 PyRIT 多轮攻击;L3 权限与出口检查 | 新旧版本在金标准集上对照 |
线上 | 流量抽样评估忠实度与拒答 | 异常外发与异常工具调用告警 | 定时金丝雀 + 关键指标看板 |
门禁的阈值,请用你自己的基线数据来定。我不建议套用任何文章里的通用数字。
五、五个常见误区
- 用 LLM 评判 LLM,却不校准。 裁判本身会出错。用人工标注样本测它的准确度,再决定哪些环节可以放心交给它。
- 只测模型,不测应用。 EchoLeak 的关键一环在图片渲染和 CSP,不在模型本身。
- 把厂商护栏当防线。分类器可以被绕过。把测试重点放在"被绕过之后损失多大"。
- 一次性红队。 红队是持续的过程。模型、提示和数据任何一个变了,结论都可能失效。
- 把英文探针直接套到中文系统。 覆盖不了你的真实攻击面。
结语
这三类缺陷有一个共同点:它们都不会让系统"报错"。幻觉的回答很流畅,注入的指令很普通,漂移之后的系统依然在正常运行。
这恰恰是它们危险的地方,也是测试人的价值所在。AI 系统不缺聪明,缺的是有人在它自信满满的时候问一句:依据在哪里?它能被谁骗?它今天和昨天一样吗?
工具已经足够多,也足够好用。缺的是把这三个问题变成用例、变成基线、变成门禁的那个人。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号