我用 WorkBuddy 做了一套「角色参考表」流水线:4 面板一次成型,放大零漂移
原创
我用 WorkBuddy 做了一套「角色参考表」流水线:4 面板一次成型,放大零漂移
原创
用户6882326
修改于 2026-10-08 15:26:18
修改于 2026-10-08 15:26:18
前面两篇讲了怎么出图、怎么编长视频。但这两件事中间还夹着一个更硬的问题:凭什么七段视频里的她是同一个人? 答案不在 prompt 里,在一张你提前做好的资产图上。
一、一致性是 AI 创作里最贵的问题
用 AI 做系列内容的人,早晚会撞上这堵墙:
第一张图很好看,第二张换了角度就开始像另一个人,第三张干脆换了个脸型。你以为是 prompt 不够细,于是把五官描述写到两百字——没用。因为模型每次采样都是重新"抽签",你写的字只影响概率分布,保证不了同一张脸。
行业里通用的三条路:训 LoRA、参考图驱动、资产图(角色参考表)。
- 训 LoRA:成本高、要数据集,而且一次只能锁一个人;
- 参考图驱动:效果最好,但前提是你得先有一张合格的身份参考图;
- 资产图:一次做好、全场复用,是前两者的共同起点。
这篇讲的就是第三条——怎么用一张整版图,一次把角色的特写 + 三个视角全部定下来。
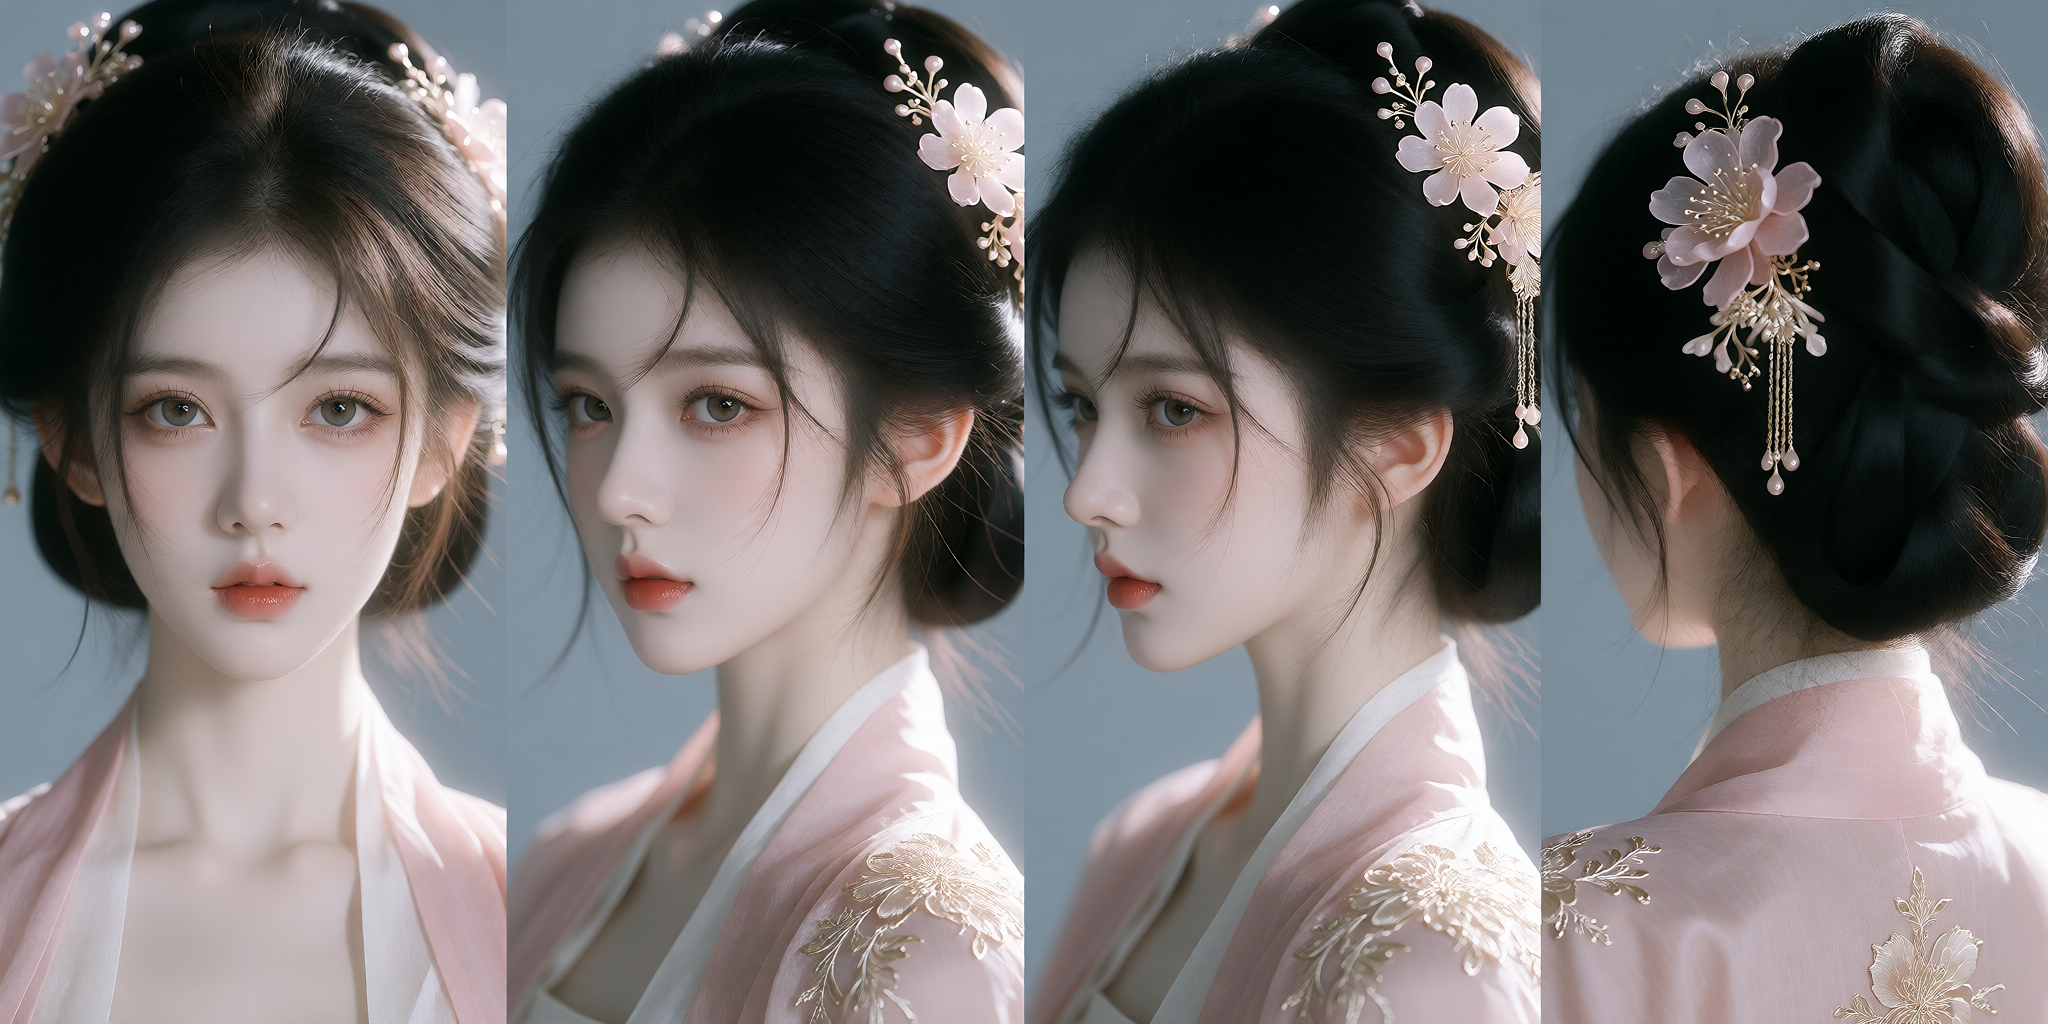
同一张图里的四格:正面 / 四分之三侧 / 九十度侧面 / 背面
二、先否掉一个思路:"多出几张挑一张"
这是新手最自然、也最贵的做法:同一个 prompt 出一组图,挑一张最好看的当参考。
为什么不行:那样出来的每张图,人物、服装、光照都在各自漂。你今天挑一张当参考,明天挑另一张——剪在一起就是跳切。更糟的是,它们之间没有共同的锚,你无从判断哪张"更对"。
正解是反过来:一张画布里同时出现同一个角色的多个视角,用一次采样、一套光照、一套服装描述,把四个视图锁在同一次生成里。它在构图上是"一整幅",天然共享全部身份信息。
三、四步流水线(命令级)
整条链路只有四步,关键在于每一步的产物都必须是下一步的输入,中间不许人工"再画一遍":
步骤 | 做什么 | 耗时参考 | 产物 |
|---|---|---|---|
① 整版 | 一次出 2048×1024 的 4 面板参考表 | 约 150–160 秒 | 整版 PNG |
② 量缝位 | 扫描前景密度,找到四条视图之间的净空缝位 | 秒级(纯读图) | 缝位坐标 |
③ 裁切 | 按缝位切出 4 张分图,纯裁切零漂移 | 秒级 | 4 张分图 |
④ 超分 | RealESRGAN 纯超分,4x 后降到净 2x | 6–12 秒/张 | 4 张高清分图 |
命令行长这样(占位符按本机展开):
S="{SKILL_ROOT}/scripts"; PY="{PY_EMBED}"

# ① 整版一次出(2048×1024,约 150~160 秒)
CS_OUT_DIR="<角色目录>" CS_OUT_NAME="<角色>-头部4格" CS_SEED=<seed> \
CS_PROMPT_FILE="<prompt txt 绝对路径>" "$PY" "$S/make_sheet.py"

# ② 量缝位(纯读图,秒出)
CS_CROP_SRC="<整版图路径>" "$PY" "$S/crop_sheet.py" scan

# ③ 裁 4 张分图(纯裁切,零漂移)
CS_CROP_SRC="<整版图路径>" CS_X=890,1295,1642 \
CS_CROP_OUT="<...>/04面板分图" "$PY" "$S/crop_sheet.py" cut

# ④ 纯超分放大 2x(约 6~12 秒/张)
CS_UP_SRC="<...>/04面板分图" CS_UP_DST="<...>/05分图_超分2x" \
"$PY" "$S/upscale_sheet.py" all每一步之间必须读图核对,不是形式:
- ① 出完核布局服从度 + 人物一致性;
- ③ 裁完逐张看,重点看相邻视图之间有没有带进隔壁的衣角、发丝;
- ④ 先跑单张(最大那张)验显存,再跑全部,然后抽 1~2 张核超分有没有崩。
这一步是整条流水线最容易被省掉、也最容易翻车的地方。一次一张,出一张验一张——批量盲跑的结果,往往是四张全废。
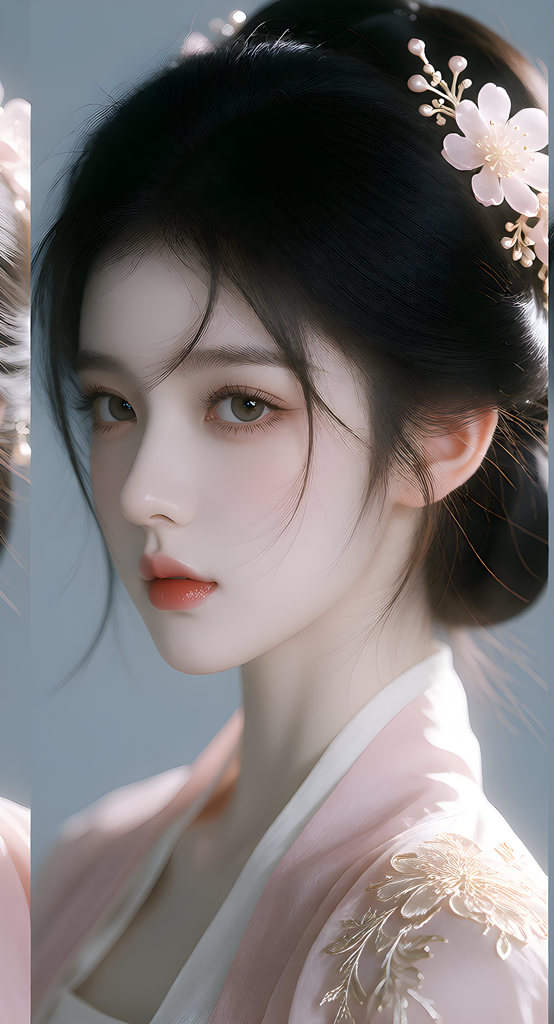
量缝位后裁出的单格分图(554×1024,零重绘)
四、写词:骨架里哪几句一个字都不能改
参考表的 prompt 有固定骨架,其中几句是布局锚,逐字不动:
角色设定参考图,左侧为正脸特写,右侧并列展示正面、90度侧面、背面三张等高全身视图,
特写与全身视图都是同一角色,全身入镜,中性A字站姿,三张全身视图等高并排、头顶脚底对齐,
[年龄感+性别感],[身材比例],[五官],[发型],[服装+配饰],
正脸特写与三张全身视图的脸、发型和服装完全一致,
[背景],[光线],[气质收尾],电影质感
四个锚点句各管一件事:
左侧为正脸特写,右侧并列展示正面、90度侧面、背面三张等高全身视图→ 管面板排布;特写与全身视图都是同一角色和正脸特写与三张全身视图的脸、发型和服装完全一致→ 管跨面板一致性。这句是命门,删了就出四个不同的人;三张全身视图等高并排、头顶脚底对齐→ 管三视图对齐;全身入镜→ 尽量做到,但宽幅下脚仍常被切。
背景一定要走纯色影棚(浅灰、浅灰蓝之类)+柔和均匀棚拍光。原图的氛围——月光夜、影院暗调、樱雾——不要搬进来,氛围会混进身份锚。把原图的气质收到人物身上(神情、发型、面料质感),而不是环境里。
五、cfg=1.0 的连锁反应:prompt 里不能出现否定词
这是整套流程里最反直觉、也最烧钱的一条。
当采样配置把分类器引导压到 1.0 时,负向提示词通道等于不存在。这时候 prompt 里任何一个否定词都会变成反向激活——你想"不要混血脸"写个 no,结果模型反而往那个方向跑。
所以规矩是:全文零否定。英文的 no / not / never / without / nothing,中文的 不 / 无 / 没有 / 别 / 不要 / 非,一个都不能有,全部改写成肯定式。
最容易踩的是子串匹配:门禁按子串查,nose 里面就藏着 no。
想表达 | ✗ 踩门禁 | ✓ 改写 |
|---|---|---|
鼻梁 |
|
|
似笑非笑 | 似笑非笑(含"非") | 唇角微微翘起带笑意 |
别着钢笔 | 胸前口袋别着一支钢笔 | 胸前口袋插着一支钢笔 |
门禁脚本在提交前自动跑,命中即拒发——这省下的是一次 155 秒的白跑。写词的时候就把这一步前移,比事后重跑划算得多。
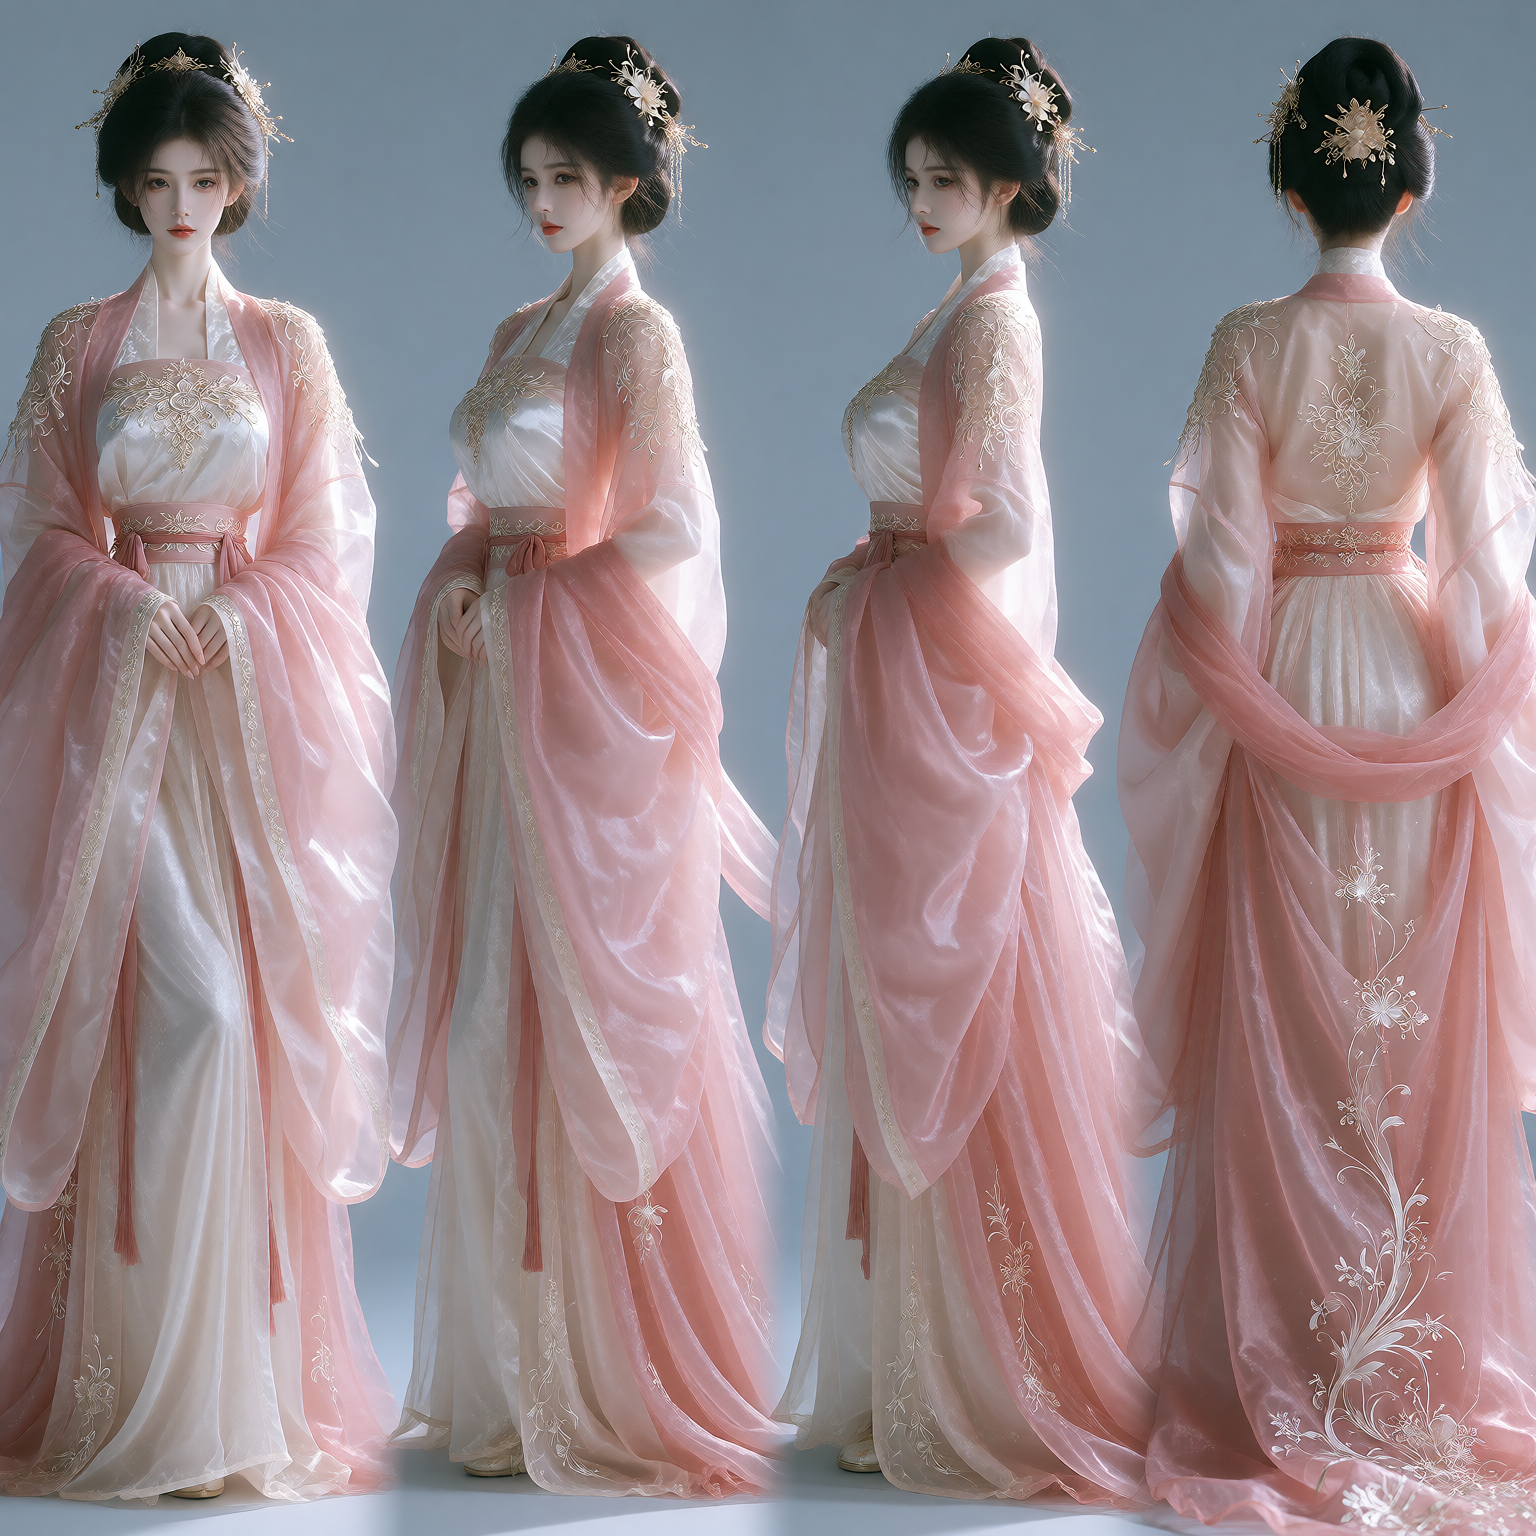
身体四格整版:四格各说一遍布局锚与身份锚
六、布局锚和身份锚:必须逐格各说一遍
cfg=1.0 下,"说布局"和"说长相"这两类描述会互相拉锯:只强化布局 → 发型漂;只强化发型 → 漏视图。
唯一稳的写法是两类都在每一格里各说一遍:
画面横向均分为四格、四格并排铺满整幅画面,
第一格是正脸特写,第二格是全身正面视图、人物面朝镜头,
第三格是全身90度侧面视图、人物侧身站立、画面里能清楚看到她的侧脸轮廓与鼻梁线,
第四格是全身背面视图、人物背对镜头,
[……服装 / 五官……]
第一格特写里她是一头披肩空气刘海长直发,
第二格正面视图里她也是一头披肩空气刘海长直发、长发垂在胸前与背后,
第三格侧面视图里她同样披散着一头空气刘海长直发、长发顺着肩背垂到腰际,
第四格背面视图里她的长直发全部披散在背后、一路垂到腰际,笼统写"右侧三格依次是正面、侧面、背面"会漏格或错序——实测出过"只画了 3 格",也出过"第 3 格画成了背面"。生成后必须读整版核四格:数格数、核格序、核每格发型是否一致,三项都过才算布局合格。
七、四个容易被漏掉的写词坑
- "背头"必须写全:
鬓角推剪干净、后颈头发剪短推净、露出后颈与双耳。只写"背头",背面格照样给你盘个低发髻。 - 长发角色的背面格:全局第一句加总锚"四格里她都是同一头长发、自然披散垂落、发梢到腰际",背面格再写"垂落的长发从左右两肩披下来、肩前能看到垂落的发梢"——双管齐下才压得住。
- 头部图的服装会缩水:只写"锁骨处露出某件上衣的领口",短袖会被画成细带背心,而且肩带元素会顺着参考图渗进后面的剧情画面。解法是四格逐格点名服装,并保留"四格里她穿的都是同一件"的总锚。
- "从颈部下缘开始"只是意愿不是保证:模型仍可能自带全头。全头全身照样能当全身锚用,属可用不算废。
八、裁切:别用"判定纯白背景"
裁切这一步有个反直觉的坑:不要用"判定纯白"来找视图边界。整版出来的底色多是浅灰蓝渐变影棚,判白会一个都不命中。
正确做法是扫描前景密度,找四条视图之间的净空缝位。两个经验值:
- 残留密度 ≤20 算干净背景;突然飙到几百,说明两个视图已经粘在一起了;
- ⚠️ 扫描会被飘散的长发带偏(谷底会报在衰减斜坡上)。缝位附近一律逐列精细打印(步长 10px),取残留真正落到 0~10 的平台段中心。
还有一个原则:裁框一律压进缝里——宁可切掉自己那侧一点点衣角,也绝不带进隔壁视图的人。边缘出现可疑的淡竖条先放大核实,大多是绒边 / 纱边,属正常。
九、放大只能插值,绝不能"重绘放大"
这条是血账:分图裁完,只能用纯超分放大,不能走图生图。
- 纯超分(RealESRGAN):只做插值,零漂移,四张放完还是同一个人;
- 图生图重绘放大:四张会各自漂成四个人——因为重绘是重新采样,每张的采样结果都不一样。
所以任何"裁完再用图生图放大"的想法,都应当场否掉。放大用 RealESRGAN_x4plus,4 倍超分后再用 LANCZOS 降到净 2 倍。
十、几个如实告知的边界
这些东西不算达标,只是已知边界,写出来是免得后来人重复踩:
- 脚被切不是画幅的锅,是"人物被画得太大"——元凶是 prompt 里的"铺满"类描述,写词时直接禁用;
- 四面板的左侧特写常顶到画面左边缘,不算完整头肩像,这是布局常态,裁第一格时可以保留到 x=0;
- 七面板未验证:模型对 7 格布局的服从度未知,要做先出一次验证版;
- 资产图 PNG 不内嵌 prompt:所以"读内嵌元数据拿 prompt"这条通用技巧在这套资产图上失效,要溯源只能回生成脚本。
十一、交付结构:这一步决定下游能不能用
资产图不是"存起来就完事",它是下游(视频参考图、图生图、系列套图)的输入。所以目录和命名必须固定:
D:\资产图\<系列>_<角色>_角色参考表\
├── <角色>-头部4格_1536x1536.png   ← 整版,必须在第一层,点开目录第一眼就看见
├── 04面板分图\                     ← 切出来的 4 张原图
└── 05头像_超分2x\ ← 4 张超分版三条层级规则:整版必须在角色目录第一层、分图必须进子目录分类放、子目录只许一层。命名统一用 角色-内容 的连字符格式,同系列共用一个前缀,资源管理器里才排得齐。
还有一条交接即清:新版交付后旧版当场删干净,不留"回收 / 暂存 / backup"目录,也不靠 _v2、_old 这类后缀留对比——当前有效版本的文件名里不许带版本号。
最后是给下游用的顺序。四张分图喂给视频模型的参考图通道时,顺序固定:
image_0 = 特写 → image_1 = 正面 → image_2 = 侧面 → image_3 = 背面参考图本身不吃帧位、可以各用各的分辨率,但顺序会影响结果,别乱调。
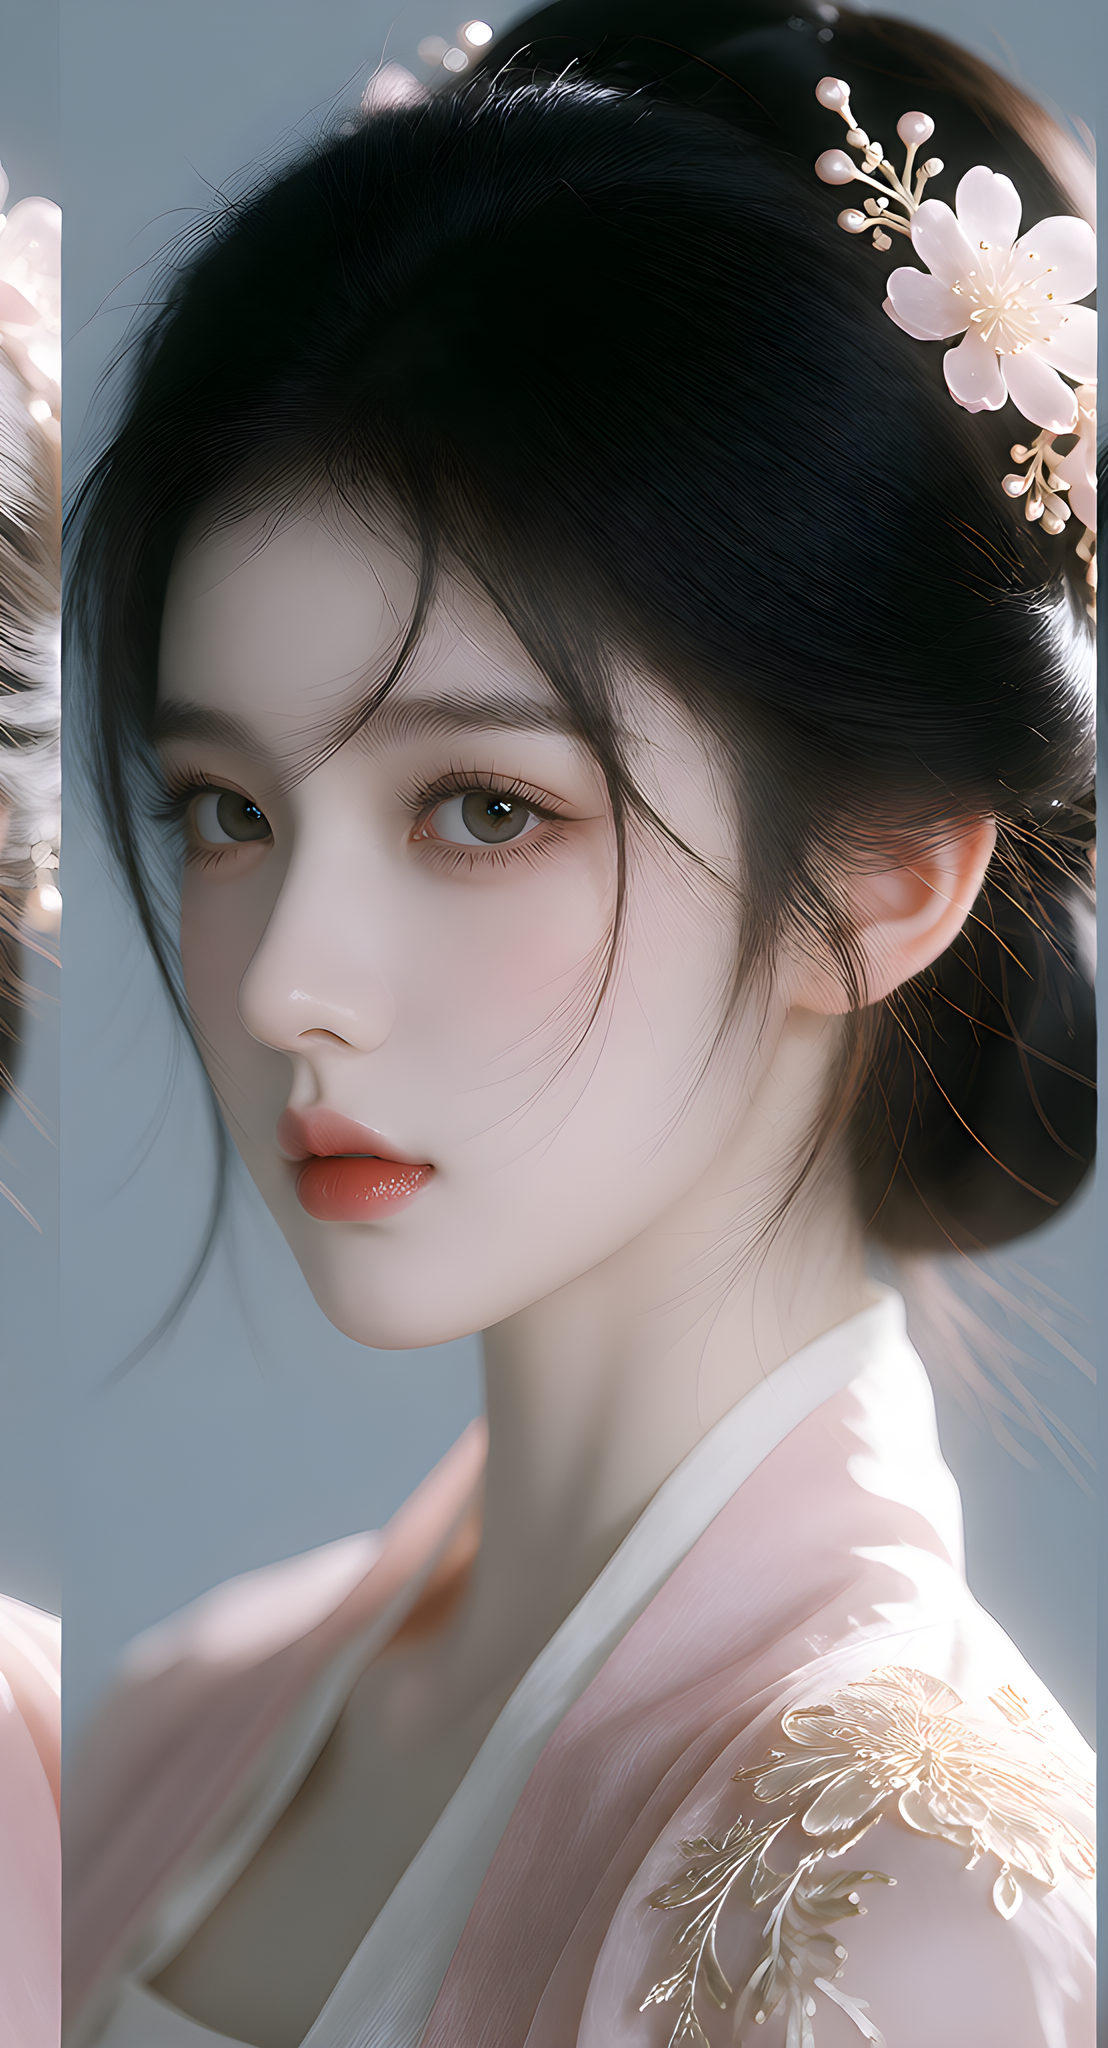
纯超分 2x 的同一格(1108×2048,放大不重绘)
十二、WorkBuddy 在这套流程里的位置
和前面几篇一样,模型只负责"把这一版画对",编排层负责保证它可复用:
- 把四步流水线固化成脚本,参数(seed、画幅、缝位坐标)全部落成可追溯的变量,而不是靠手输;
- 出图前自动跑否定词门禁,把"155 秒白跑"消灭在提交之前;
- 每步之间强制"读图核对"这个动作,把"我觉得应该没问题"换成"我看过了";
- 产物按系列 / 角色 / 视角固定归档,下游直接按约定路径取用。
十三、踩坑速查表
症状 | 根因 | 解法 |
|---|---|---|
四个格子变成四种发色 / 脸型 | 命门句被删或写得太笼统 | 保留"完全一致"总锚 + 逐格重复发型描述 |
只有 3 格 / 第 3 格画成背面 | 布局只说一遍 | 布局锚逐格各说一遍,出图后数格数、核格序 |
提交直接失败 / 出图方向反了 | prompt 里含否定词(含 | 全改肯定式;提交前跑门禁 |
裁切找不到边界 | 用"判纯白"找缝位 | 改用前景密度扫描;缝位逐列打印取平台中心 |
裁出来的图带了隔壁衣角 | 裁框没压进缝里 | 宁可切掉自己那侧一点,也别带进隔壁 |
放大后四张脸各不相同 | 走了图生图重绘 | 只做纯超分插值,RealESRGAN 4x → 降采样 2x |
脚被切掉 | prompt 里写了"铺满"类描述 | 删掉铺满类词;人物画小一点比换画幅管用 |
追踪不到 prompt | 资产图 PNG 不嵌 prompt | 回生成脚本查;prompt 单独落 txt 存档 |
结语
一个系列能不能做长、做稳,分水岭不在模型,而在你有没有把"她是谁"这件事固化下来。
一张四面板参考表,四步流水线,三个验收动作——把这三样固定成纪律,你就从"每次都在赌运气"变成了"每次都在复用同一个人"。
而这一切仍然是零积分的:整版 150 秒,裁切秒级,超分每张十秒内,全部在本地跑完。
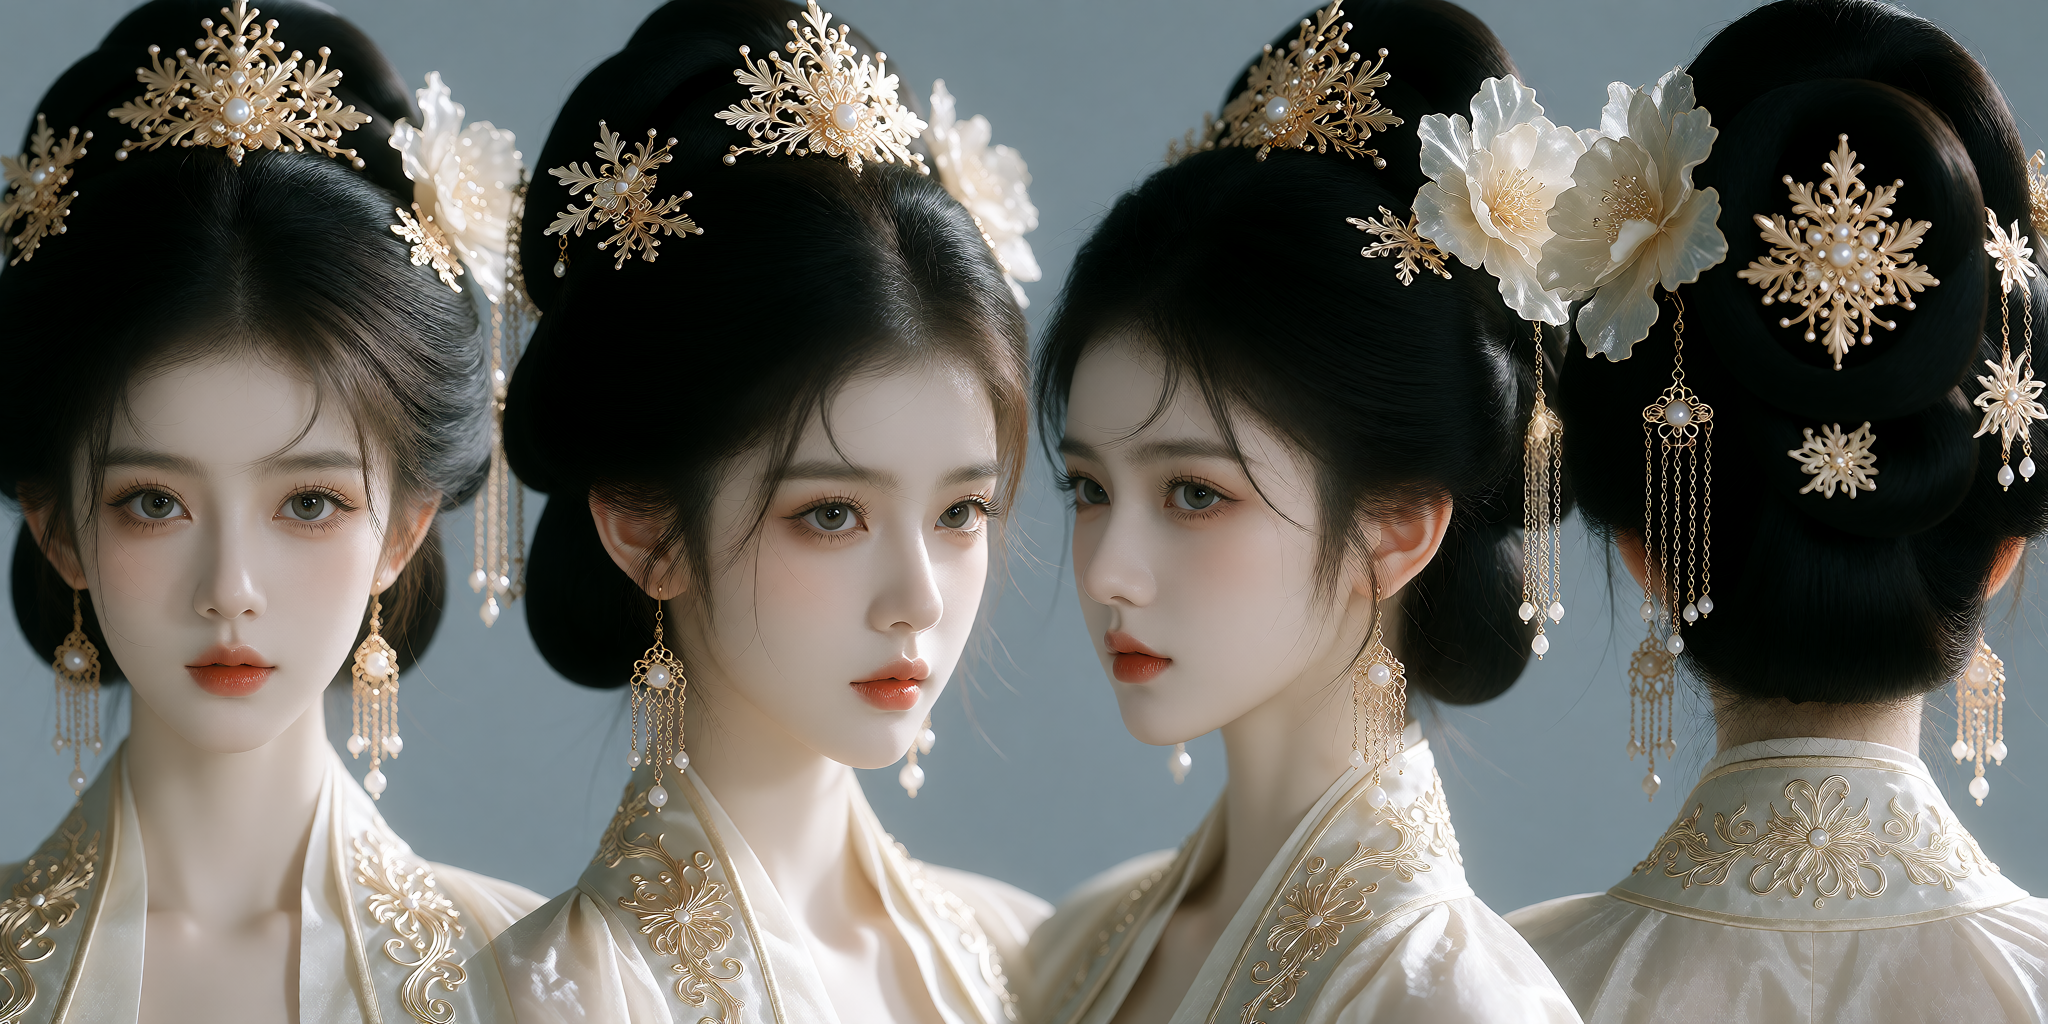
换一个角色、换一套配色,同一套骨架照样成立
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号