我用 WorkBuddy 把 AI 短视频串成了一条接力流水线:锁人 → 接力 → 无缝拼接
原创
我用 WorkBuddy 把 AI 短视频串成了一条接力流水线:锁人 → 接力 → 无缝拼接
原创
用户6882326
发布于 2026-10-08 15:35:03
发布于 2026-10-08 15:35:03
我用 WorkBuddy 把 AI 短视频串成了一条接力流水线:锁人 → 接力 → 无缝拼接
前三篇分别讲了出图、编长视频、做角色参考表。这一篇讲最后一块拼图:怎么让「第 2 段视频」里的她,还是「第 1 段」里的那个人。 我把整条链在本机跑通并做了量化验收,下面每一个数字都是实测的,不是估的。
一、为什么"接着上一段拍"会越接越不像同一个人
用 AI 做连续镜头的人,一定会撞上这个坑:第一段 5 秒很漂亮,把它的最后一帧拿来当第二段的起点,出来的却像换了个人。到第三段,基本等于重开。
不是你 prompt 写得不够细。根因有五条,而且它们会叠加:
根因 | 说明 | |
|---|---|---|
1 | 串行重采样误差累积 | 每段输出自带偏差,拿"上一棒的输出"当"下一棒的输入",偏差单向增长,系统不会自我修正 |
2 | 用末帧接力是放大器 | 末帧是整段里离锚点最远的一帧。拿最差的帧起步,误差增长率最高 |
3 | 有损往返 | 从压缩成片里抽末帧再喂回去,每段叠一次编解码损失,先磨掉的就是脸部锐度和布料纹理 |
4 | 没有跨段身份约束 | 首帧只是一次性起始条件,采样一开始模型就没有 identity 约束了。prompt 里的"少女、圆脸"只能给粗略语义——文字锁不住脸型 |
5 | 分辨率不足是硬伤 | H3 的 native canvas 是 768 短边 / 1344×768 ≈ 0.98 MP;常跑的 832×480 只有 0.4 MP,约为 native 的 41%。全身构图下脸只有几十像素,这个尺度模型本来就保不住面部结构 |
所以正确做法不是"把 prompt 写得更细",而是给整条链装三道闸:锁人、选接力点、拼接。缺一道,前面省的功夫后面全要还回去。
二、第一道闸:用 Ref2VA 原生锁人
H3 自带一个专门为锁角色设计的模式:Ref2VA(R2V)。它不需要 IP-Adapter、不需要 PuLID、更不需要为了一个角色训一份 LoRA。
项 | 值 |
|---|---|
节点 |
|
底模 |
|
参考容量 | 最多 9 张参考图 + 3 段参考视频(可各带音轨)+ 3 段参考音频 |
用法 | prompt 里按连接顺序用 |
关键能力 | 支持 |
prompt 里必须写明用途,否则模型不知道该继承什么:
the woman in <ref1> is the identity reference;
match her face, hairstyle and costume exactly一个必接项:vae 与 audio_vae 虽然标 optional,但不接就没有参考的 latent block,identity 约束会大幅削弱。别为了省显存跳过。
三、R2V 最贵的坑:传参形式
这是整条链上我交过最贵的一笔学费。三种写法,只有一种生效:
"inputs": {
  "ref_images.ref_image_0": ["11", 0],
  "ref_images.ref_image_1": ["12", 0]
}
传参形式 | 结果 |
|---|---|
列表 | 被静默丢弃(逐像素等于没带参考图) |
嵌套字典 | 被静默丢弃 |
点号展平键 | ✅ 生效 |
症状是最恶心的一种:提交零报错、正常出片、队列正常,就是人不对。
根因在 execution.py:校验期用 get_finalized_class_inputs() 把 AUTOGROW 展开成点号展平键,执行前再由 build_nested_inputs() 还原成 {"ref_images": {...}}。key 对不上就被当无关输入扔掉,不报错。
还有一种会报错的写法:把参考图写成顶层裸名 "ref_image_0": ["20", 0] —— 提交通过、正常排队,执行到该节点才炸:
MiniMaxH3ReferenceToVideo.execute() got an unexpected keyword argument
'ref_image_0'. Did you mean 'ref_images'?规避很简单:参考图永远裹在 ref_images 下面,API JSON 里直接写点号,不要转义成 __。
判断"参考图到底有没有进去"的唯一可靠方法
A/B 对照:同 prompt、同 seed、同尺寸,唯一变量=参考图(或参考图尺寸档)。画面逐像素相同,就说明参考图根本没进去。
有个曾被我当判据、后来作废的信号:日志里 MiniMaxH3VideoVAE prepared 出现次数。实测参考图被完全丢弃时该计数照样 +1;在 w4a8 + 新版 ComfyUI 上 3 张参考图只出现 1 次。次数对不上 ≠ 没接,对上 ≠ 生效。
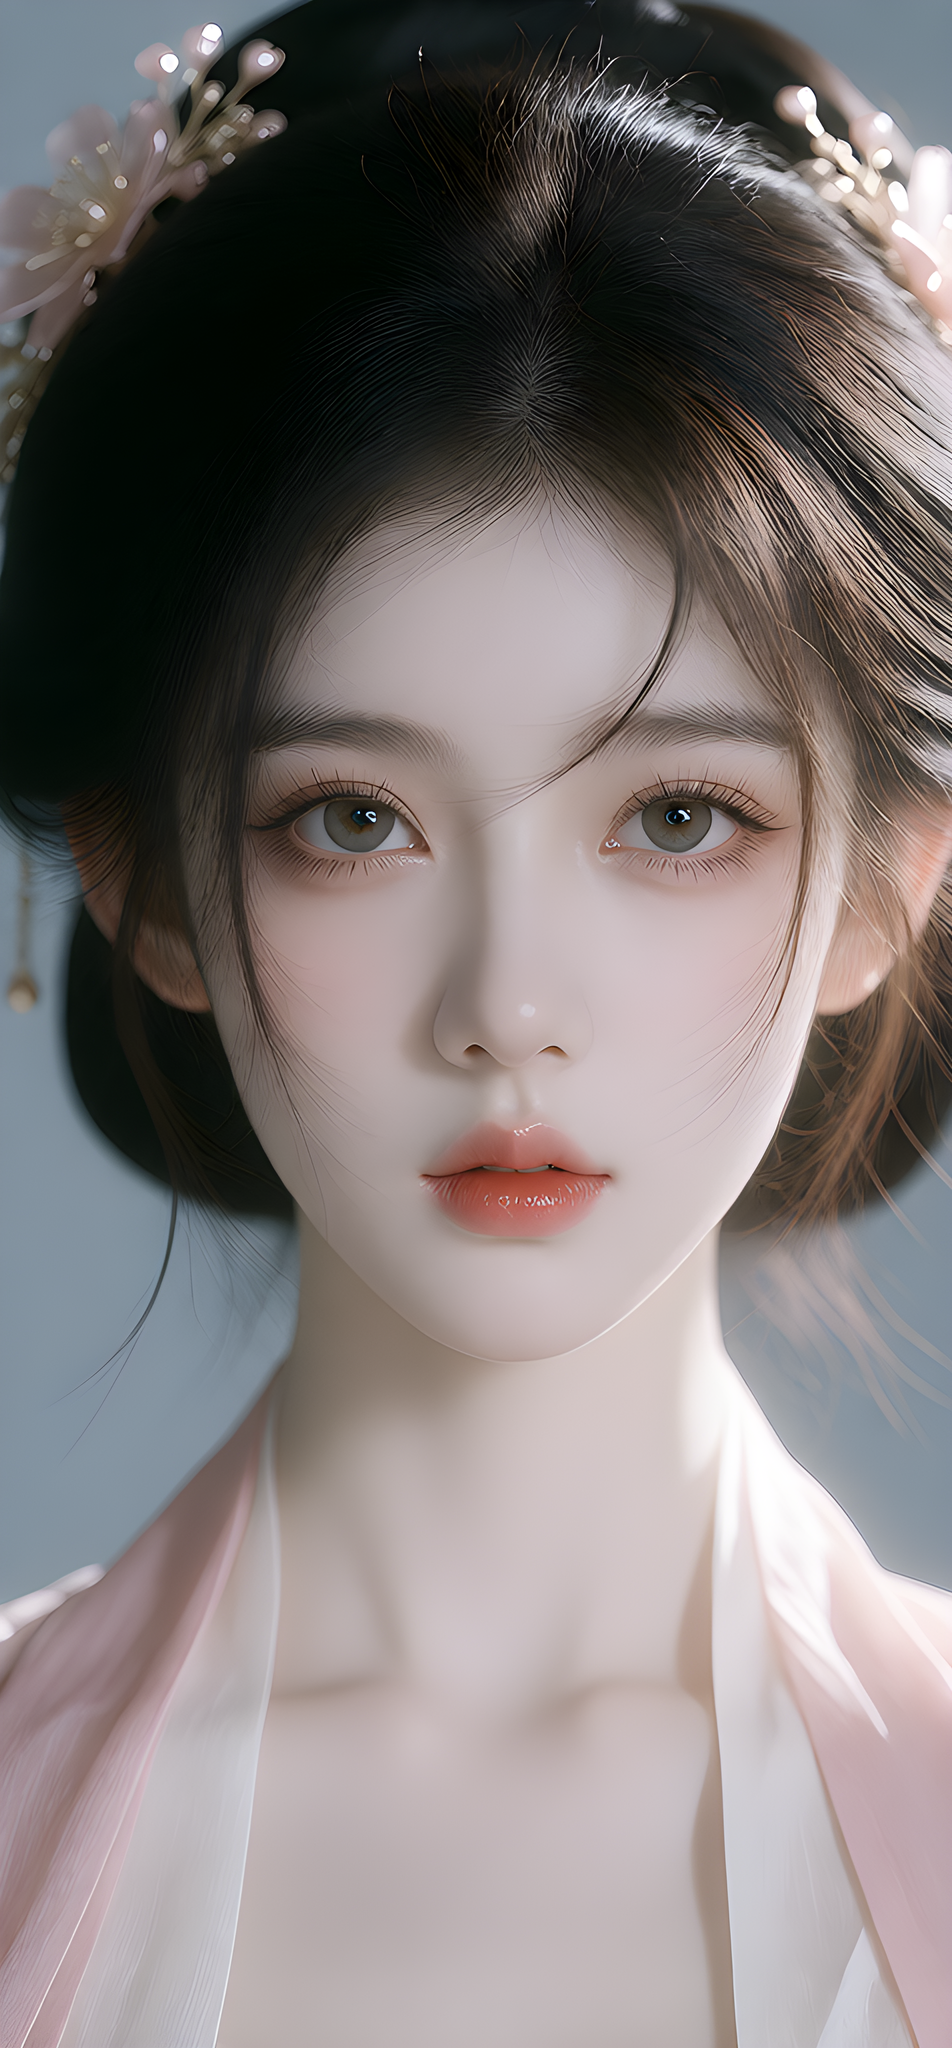
identity 主锚:正脸特写(裁切 + 纯超分 2x 后)
四、弹药:参考图分辨率 = identity 的天花板
R2V 源码里的缩放是:
scale = min(1.0, REF_IMAGE_SHORT_EDGE / min(w, h)) # 只缩小,不放大模型不会替你补像素。参考图自身的像素量,就是 identity 保真度的上限。
实测一组很能说明问题的数字:
- 一张 1024×576 的构图锚图里,她的脸只占约 80×90 px;就算从构图里裁出脸部特写,也只有 180×220。
- 换成单独出的正脸特写参考图(裁切 + 超分 2x 后),脸区约 43 万 px —— 是前者的约 60 倍。
面板 | 超分后尺寸 | 承载内容 | R2V 用途 |
|---|---|---|---|
P1 正脸特写 | 1778×2048(脸区约 43 万 px) | 发髻 / 脸型 / 眼型 / 唇形 |
|
P2 全身正面 | 806×2048 | 服装正面 + 身形比例 | 锁服装款式 / 材质 |
P3 侧后回眸 | 682×2048 | 侧脸 + 后颈发髻结构 | 补侧面角度 |
P4 正背面 | 812×2048 | 发型背面 + 裙背中线 | 补背面角度 |
结论:要锁脸,不要从成片或构图里裁脸;专门出一套「正脸特写 + 三视图」参考表再超分,这才是 R2V 的正确弹药。
两条容易踩烂弹药的坑
① 喂整张参考表 ≠ 喂单张参考图。 ref_image_N 的语义是"这一个参考主体"。拿多面板拼版当输入,模型很可能理解成"一张画着好几个人的图"。正确做法是喂分图:ref_image_0 = 正脸特写,后续槽位再补全身 / 服装 / 体态。拿拼版直接喂,是"锁脸失败"的第一嫌疑。
② 8GB 显存的参考图红线:短边压在 1024。 ref token 数随参考图像素面积涨。喂 2048 短边的超分图,节点按原尺寸编码,CUDA OOM——而且是采样跑完才炸在解码,白跑一整轮。
已验证的最佳配置:ref_image_size=max + 参考图 1024 短边。
| 行为 | 代价 |
|---|---|---|
| 保持比例只缩小到本次生成像素面积 | 快 |
| 用参考管线的 2048px 短边 | identity 保真度最高,但约 1.5 倍耗时(实测 300s vs 195s) |
另外,脸部特写裁切优于整张头像分图:从大尺寸头像里裁出"脸 + 颈",脸区像素远高于一张小尺寸整图,identity 明显更准;而且裁完短边变小,顺带绕开"超分图直喂会 OOM"的问题。
快速稿 vs 高清稿的取舍:快速稿只要 1 张正脸验构图;出片稿至少 3 张(正脸特写主锚 + 四分之三侧 + 身体正面),上限 9 张。
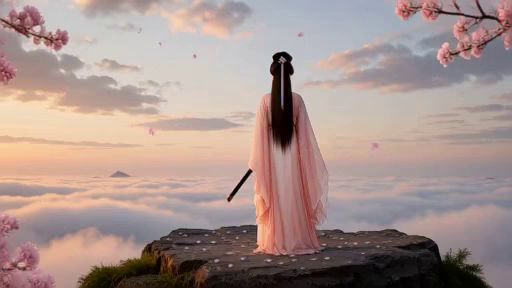
第 1 段首帧:链的起点(512×288,背影站姿)
五、第二道闸:接力点怎么选
R2V 解决了"长得像",接力点决定了"接得住"。三条路线,按项目规模递进:
路线 | 做法 | 适用 |
|---|---|---|
A 尾帧接续链 | 段 N 抽最后一帧 → 放进 | 短链、手动可控 |
B R2V + | 把上一段视频当参考喂进去,新段同时继承 identity 与 motion | 漂移严重时的正解 |
C 导演台 TimelineDirector | 时间线 UI 出 Segment Plan,节点内自动续接 | 多段、要遮罩/去重 |
三条硬纪律:
① 接力点必须落在"叙事闭合状态"上。 人物位置、道具状态、情绪都要到达一个可暂停的稳态。这是防漂移的第一道闸,比 prompt 层的防漂移句更靠前。判断方法:看这段尾帧的帧间差——如果尾帧附近帧间差还在全片最高位(实测 2.5~3.7 就是"还在动就被切"),说明切早了。
② 别从压缩成片里抽末帧。 从原始输出帧取。每经过一次编解码,先掉的就是脸的锐度和布料纹理。
③ 每段 prompt 都要全量重复人设 / 服装 / 发型。 尾帧接续只锁画面,锁不住语义——它不会帮你记住"她穿的是粉色薄纱"。
顺手记一个反直觉的实测:首帧和末帧传同一张图,模型不会真的回到起始姿。last_frame 只是弱条件、不是硬约束。想让结尾定格在指定姿势,必须另出一张收势图当 last_frame。
反过来用:动作幅度 ≈ 首尾两帧的姿势差。首帧=尾帧时,模型没有"距离"要跑,动作会自动缩水成原地抬手级别。
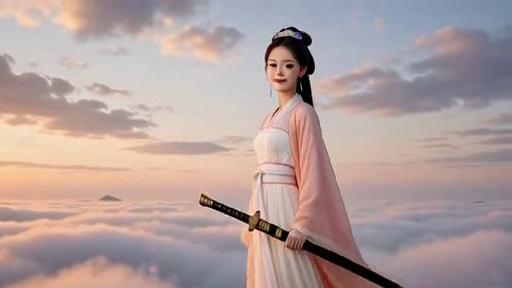
第 1 段末帧:接力点(转身持剑,画面停在闭合状态)
六、实测:接力点到底有多"无缝"
我把这条链跑了一遍并逐帧量化。片子规格:512×288 / 24fps / 124 帧一段(5.17s),两段接力后拼接。
接力点本身(段 1 的第 123 帧 vs 段 2 的第 0 帧):
对比 | 平均像素差 |
|---|---|
段 1 末帧 ↔ 段 2 首帧(接力点) | 3.24 |
段 1 末帧 ↔ 段 2 第 2 帧 | 3.43 |
段 1 首帧 ↔ 段 1 末帧(段内首尾差=动作幅度) | 35.65 |
拼接后,接缝处的帧间差 vs 段内正常帧间差(成片 248 帧 = 124 + 124):
位置 | 平均像素差 | 含义 |
|---|---|---|
段内 121 → 122 | 3.00 | 正常帧间变化 |
段内 122 → 123 | 1.89 | 正常帧间变化 |
接缝 123 → 124(跨段) | 3.33 | 与段内正常帧间差同量级 |
段内 124 → 125 | 0.74 | 正常帧间变化 |
这就是"视觉无缝"的硬证据:跨段的帧间差(3.33)和段内正常帧间差(3.00 / 1.89 / 0.74)处在同一量级,观众分辨不出哪里换了段。
经验判据:段 N+1 首帧与段 N 末帧的平均像素差 < 8,即视为视觉无缝。
再给一个量级参照:同机器上另一条 10.12s / 243 帧的单段片,首帧与末帧的平均像素差是 59.39 —— 也就是段内自身的画面变化(59.39)远大于接缝处的跳变(3.33)。这句话是整篇文章的核心:接缝的跳变,比这段视频自己内部的画面变化小 17 倍。
拼接成片第 123 帧(属于第 1 段)
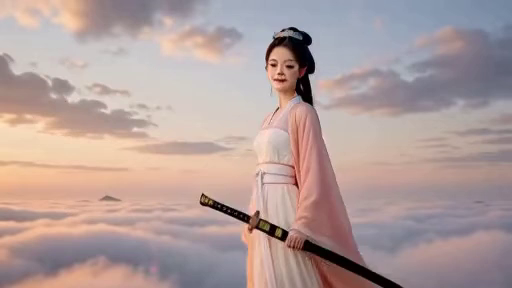
拼接成片第 124 帧(属于第 2 段)
七、第三道闸:拼接(PyAV 六连坑)
两段视频合成一条带声 mp4,我踩了六个坑,每个都是"跑完了才发现不对":
① 双源顺序 mux 直接报 EINVAL。 两个源的 pts 各自从 0 起,dts 回卷,x264 的 B 帧 dts 还会取负值。
② 唯一可靠解法是 ffmpeg concat demuxer:
open(lst, 'w').write("file 'a.webm'\nfile 'b.webm'\n")
inv = av.open(lst, format='concat', options={'safe': '0'})清单里写绝对路径时必须带 options={'safe':'0'},报 PermissionError: Operation not permitted 就是缺它;相对路径则不需要。
③ B 帧必须 flush,否则尾部的帧会静默丢失:
for pkt in vstream.encode(None):
    ov.mux(pkt)
实测 486 帧不 flush 只出 445 帧,丢 41 帧 / 1.7 秒。校验方法:用 cv2.VideoCapture 数出来的帧数,必须等于送进编码器的帧数。
④ demux 流是顺序消费的。 inv.decode(video=0) 迭代到 EOF 之后,再 inv.decode(audio=0) 拿到的是空。必须一次 inv.decode() 全流解出,再按帧类型分流(注意 Frame 对象没有 .type 属性)。
⑤ 视频包和音频包必须按 dts 交错 mux。 先把全部视频包写完再写音频,movenc 的交错缓冲会把落后一整条片长的音频流整个丢弃——不报错、没有音频流、容器时长也算错。正确做法:两边分别 encode 成包列表,按 pkt.dts * time_base 换成秒归并排序后逐个 mux,输出加 options={'movflags': '+faststart'}。
⑥ 跨段 mux 报 Invalid argument ... returned 22。 webm 解码帧带着自己的时间戳,跨文件后 pts 不连续,mp4 muxer 直接拒收。修法是 reformat 后显式写全局单调递增的 pts:
fr = fr.reformat(width=W, height=H, format="yuv420p")
fr.pts = total_frames + n              # 全局帧序号,不是段内序号
fr.time_base = fractions.Fraction(1, FPS)音频同理(af.pts = i、af.time_base = Fraction(1, SR))。
另外两条小的:os.replace 不能跨盘移动(D:→C:),用 shutil.move;便携包里的 PyAV stream 对象没有 .close(),收尾只能靠 ov.close()。
八、验收:三个数字定生死
成片不能靠"看起来还行"。三个数字能立刻证明它是对的:
① 总时长对账
总时长 = 段数 × 段长 − (段数 − 1) × 重叠例:3 × 10.125 − 2 × 1.625 = 27.125s。和规划值一致,就说明段间承接正常。
② 帧数用 cv2 数,不要信容器元数据
av 打开 vp9/webm 时 streams.video[0].frames 返回 0,拿 0 当分母会永远误报丢帧。帧数一律 cv2.VideoCapture(webm).get(cv2.CAP_PROP_FRAME_COUNT),av 只负责取 fps。
③ 音轨时长只能靠实际解码累加
AAC 流的 stream.duration 会报出极小值——实测一条完整 15.10s 的音轨只报 0.48s,而容器 duration 15.08s 是对的。唯一可信的是解码累加:
na, sr = 0, None
for fr in av.open(path).decode(audio=0):
    na += fr.samples
    sr = fr.sample_rate
print('audio_sec = %.2f' % (na / sr))最后一个工程细节:中文路径读图必须绕。cv2.imread 读不了中文文件名(返回 None),要用 cv2.imdecode(np.fromfile(path, np.uint8), cv2.IMREAD_COLOR) 读、cv2.imencode('.png', img)[1].tofile(out) 写。抽帧验证图一律用 ASCII 文件名。
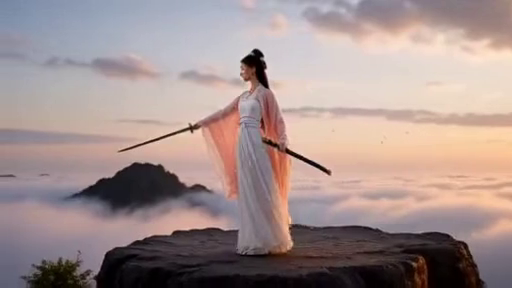
拼接成片尾帧(10.33s / 248 帧)
九、超分收尾(可选)
拼接完如果分辨率还不到发布标准,最后一步是纯超分(RealESRGAN 2x),而不是"重绘放大"。区别很关键:
- 纯超分:只做插值/重建,不重新采样画面 → 身份与构图零漂移
- 重绘放大(图生图放大):等于又跑了一次生成 → 四张分图会漂成四个人
这条在上一篇讲参考表时也踩过:放大只能插值,绝不能重绘。
十、WorkBuddy 在这条链里的位置
三段流水线的活是 ComfyUI 干的,"把三段串起来"的活是 WorkBuddy 干的。具体分工:
- 算账:段长、帧数、总时长、接缝像素差——每次出片后自动算一遍,对不上就不交付。上面那张"接缝 3.33 vs 段内 0.74~3.00"的表,就是脚本逐帧算出来的,不是我目测的。
- 守接线:R2V 的点号展平键、
ref_image_size、参考图短边,这些参数一次性写进工作流 JSON,避免每次手改漏项。 - 守住纪律:接力点必须落在闭合状态、必须在原始输出帧上抽帧、中文路径必须绕——这些都固化在脚本里,而不是靠人记。
- 批量与归档:多段批跑、按段号命名落盘、失败重跑单段(不用从头再来)。
- 验收闸门:帧数、音轨时长、总时长三项全过,才把成片交出去。
十一、踩坑速查表
症状 | 根因 | 解法 |
|---|---|---|
提交零报错、出片正常,但人不对 | 参考图用了列表/嵌套字典,被静默丢弃 | 改点号展平键 |
提交通过、执行才报 | 参考图写成顶层裸名 | 参考图永远裹在 |
日志 | 这不是判据 | 用 A/B 对照:逐像素相同=参考图没进去 |
参考图用了仍不像 | 参考图像素太少 | 单独出正脸特写(1024×1024 起),裁切 + 超分 2x |
锁脸失败、参考图"没反应" | 喂的是多面板拼版 | 喂分图, |
采样跑完才 CUDA OOM | 8GB 显存喂了 2048 短边参考图 | 参考图短边压到 1024,配 |
第二段像换了个人 | 拿末帧接力且无身份约束 | 换 R2V + |
末帧附近画面还在动 | 接力点没落在闭合状态 | 看尾帧帧间差,别在最高位切 |
成片尾部少几十帧 | B 帧没 flush | 编码循环后 |
成片没有音轨、时长也算错 | 音视频没按 dts 交错 mux | 按 |
跨段 mux 报 | pts 跨文件不连续 | reformat 后显式写全局递增 pts |
音轨时长读出来只有零点几秒 | 错信 | 用实际解码累加 |
帧数校验永远报丢帧 | 错信 | 用 |
| 中文文件名 |
|
结语
这条链上真正值钱的不是任何单点技术,而是三道闸的顺序:
- 锁人——用 Ref2VA 把身份钉在参考图上,而不是写在 prompt 里;
- 接力——接力点落在叙事闭合状态,从原始帧抽,别从成片抽;
- 拼接——按 dts 交错、flush B 帧、全局递增 pts。
三道闸装齐之后,"7 段视频里是同一个人"就不是运气,而是可复现的工程结果。
而且整条链仍然是零积分的:出图、出视频、拼接、超分全部在本机跑完,没有任何一步需要调用云端接口。
接缝的跳变(3.33)比这段视频自己内部的画面变化(59.39)小 17 倍——这句话,就是这条流水线的意义。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号