我用 WorkBuddy 做分镜构思层:一条 10 秒「一镜到底」,模型自己切了三刀
原创
我用 WorkBuddy 做分镜构思层:一条 10 秒「一镜到底」,模型自己切了三刀
原创
用户6882326
发布于 2026-10-08 15:43:48
发布于 2026-10-08 15:43:48
前四篇把出图、长视频、角色一致性、视频接力都走了一遍,但一直缺最上游的那一环:一段剧本,到底怎么变成一张能落地的镜头清单?
这篇就补它。而且我先不写方法,先摆一个我自己跑出来的实测——它能解释为什么大部分人写的分镜一喂进模型就碎。
一、先摆一个实测:你以为的「单镜头」,其实是三条
我拿本机生成的一条 H3 视频逐帧量了一遍。先说清参数,这很重要:
项 | 值 |
|---|---|
分辨率 | 512 × 288 |
总帧数 | 243 帧 |
帧率 | 24 fps |
时长 | 10.125 s |
生成方式 | 单次提交、单张首帧驱动、提示词里写的就是「一镜到底」 |
然后把相邻帧逐一做灰度绝对差,取全图均值,得到整段的帧间差曲线:
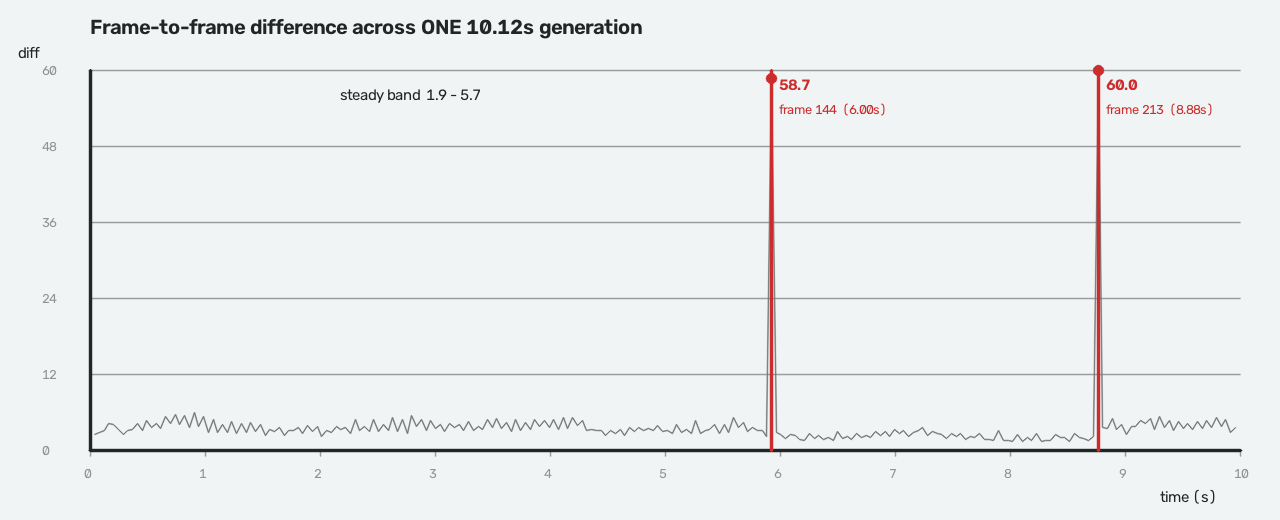
整段 10.125 秒的逐帧帧间差曲线
看这两根柱子。整段 243 帧里,帧间差只有两处断崖:
位置 | 帧号 | 帧间差 | 邻域基准 | 倍数 |
|---|---|---|---|---|
6.00 s | f144 | 58.68 | 2.77 | 21.2 × |
8.88 s | f213 | 60.03 | 2.84 | 21.1 × |
其余时间的帧间差全部落在 1.94 ~ 5.70 这个平稳带里(全段均值 3.69、中位 3.10)。
也就是说:这一段 10.125 秒被切成了三段(0 → 6.00s、6.00s → 8.88s、8.88s → 10.125s),而且第二段只有 2.88 秒、最后一段只有 1.24 秒。这不是渐变的运镜,是硬切。
把切点两侧的帧并排看,一眼就明白了:
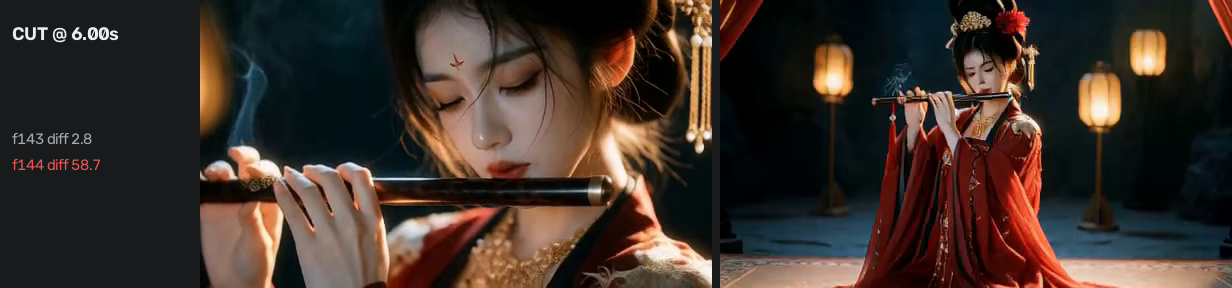
6.00 秒切点前后两帧
左帧 f143:近景特写,人在画面里占满,手和笛子在唇前。右帧 f144:直接跳到灯笼庭院里的全景,人物坐姿、画面全是红袍与灯笼。
再看第二个切点:
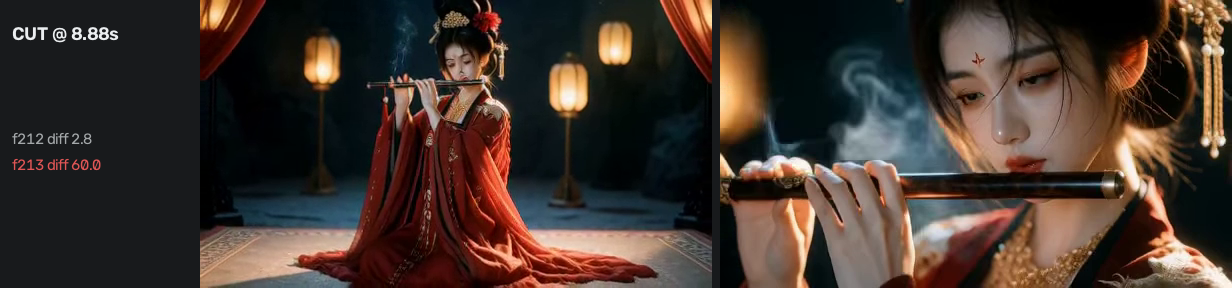
8.88 秒切点前后两帧
这次方向反过来——从全景切回近景特写。
结论:我在提示词里写的是"一条 10 秒的一镜到底",模型交回来的成片里有三条镜头,剪辑点是 6.00s 和 8.88s。它跟我的分镜边界毫无关系。
这个结果和量到的另一组数字对得上:成片的突变间隔落在 1.7 ~ 7.3 秒之间(我这里两段分别是 6.00s 和 2.88s),并且与段边界无关——模型在段内自己就切了 3 ~ 4 次。
二、所以「先写一张标准分镜表」这条路是错的
大部分人从剧本走向视频,第一步是写分镜表:镜号、景别、时长、内容。这张表本身没问题,问题是它的用途被搞错了。
标准分镜表是给人看的——给摄影、剪辑、美术看,人知道"这一镜 3 秒"是拍摄与剪辑的规划。但直接把它当生成单元交给模型,结果就是上面那样:你写 4 秒一镜,模型在段内自己切四次,成片碎成一地。
所以中间必须插一层。我的做法是拆成三层:
层 | 管什么 | 产物 |
|---|---|---|
构思层 | 为什么拍、拍多久、和谁成组、哪条锁生效 | 镜头清单 |
生成层 | 切成模型能一次吃下的段、每段的首帧从哪来 | 段清单 + 提交参数 |
描写层 | 这一镜的画面怎么落成可生成的动作 | 段正文 |
三层里,构思层是唯一"用一个小时换后面十个小时"的地方。下面五步就是它的全部工作。
三、步骤 0(强制):逐镜展开表,五格缺一格就出事
这是整套流程里最反直觉的一条:写任何一条提示词之前,先把这张表逐镜填满。表没填满,不许动笔。
五格,每格都对应一个实测过的翻车症状:
格 | 必答内容 | 缺了这一格会怎样 |
|---|---|---|
① 手的所有权 | 这一镜哪只手做动作;另一只手在哪、手里有什么(写 "free hand" 等于没写) | 多画一条手臂 / 凭空多一只手 |
② 道具接触关系 | 道具被谁、用哪只手、以什么方式持有;本镜内它的位置如何变化(含落点) | 道具先消失再凭空出现;道具浮空 |
③ 衣物物理路径 | 凡「移物 / 移衣」动作,必写 物件坐标 → 手与物件接触点 → 逐节中间站点 → 脱离点 | 裙子直接缩上去 / 直接消失,而不是被撩起、被手指捏住、堆成褶 |
④ 本镜结束状态 | 这一镜结束时:人、手、道具、布料各在哪(=下一镜的起点) | 镜间 / 段间跳变,承接链断裂 |
⑤ 物件动作数 | 本镜与整段的物件动作数(不是子镜数) | 超过 3 立刻拆段;超载会让模型在起拍点直接跳到结果,中间过程不存在 |
第 ⑤ 格是最容易被忽略的。注意它数的是物件动作数,不是子镜数——三个子镜如果只动一个物件,那还是 1 个动作;一个子镜里挪了两样东西,那就算 2 个。
镜面 / 镜像构图要额外加一条:必须显式声明"画面里只有两只手臂,镜中映像是同一对手臂的倒影"。模型分不清镜内和镜外的手臂对应关系,会多画一条。
写完每段必过的两条硬自检:
1. 数物件动作数(不是子镜数),> 3 立刻拆段。
2. 每个「从身体上移走某物」的动作,逐条查有没有四段式路径链,缺的当场补。提交之后还有一道:抽 首 / 25% / 50% / 75% / 尾 五帧,逐帧核对手数、道具位置、布料状态,主动报出结果,不等别人发现。
这条自检不是形式主义。看这张真实的五帧核对条——同一段 10 秒,0% / 25% / 50% / 100% 四个采样点都是近景特写(手、笛、面部的位置都稳定),但 75% 那一帧(f182)景别突然拉成全景:
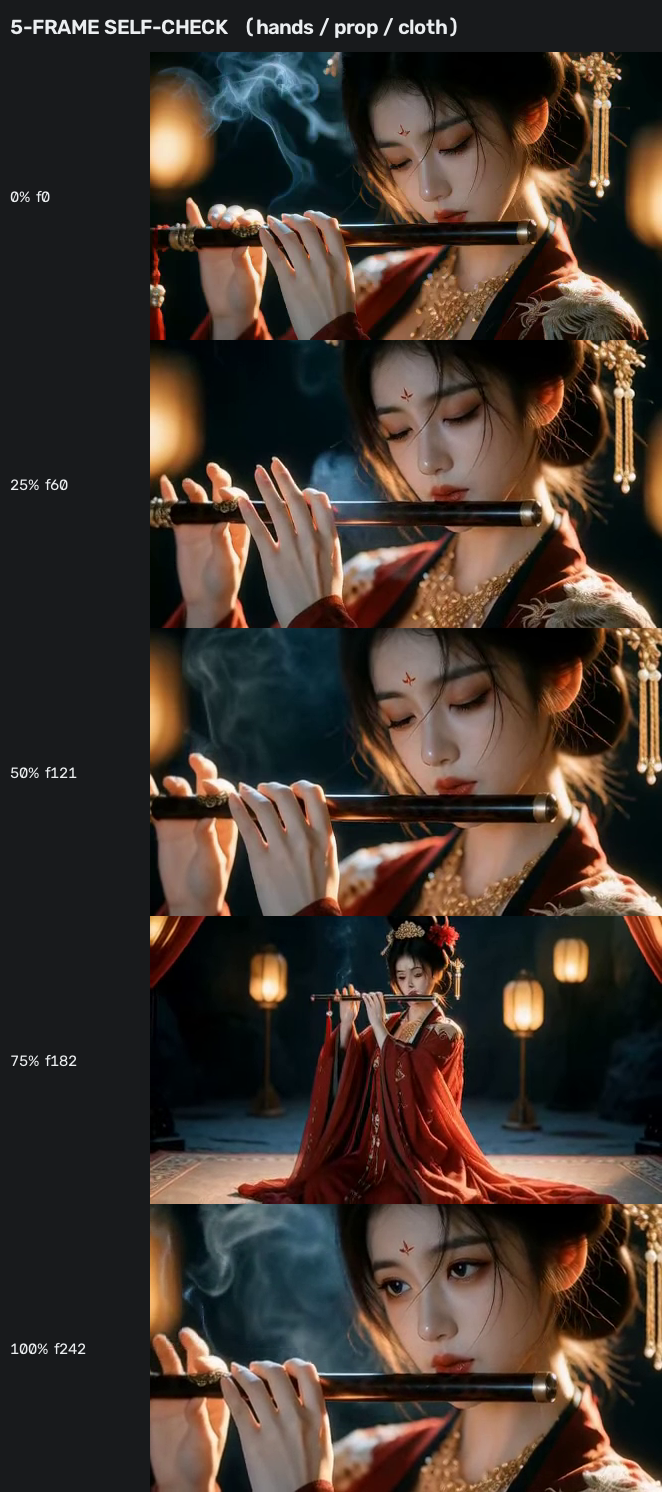
五帧自检条:0% / 25% / 50% / 75% / 100%
如果不抽这五帧,这个"段内自切"就被漏过去了——而它正好解释了一、二两节的结论。
四、第一步:叙事目的双层标注(每镜必答两个问题)
镜头清单里每一镜都要写一句话,这句话必须同时盖住两层:
结构层(这镜为什么存在——删掉它全片缺什么):
- 交代信息 / 建立·强化角色 / 推进情节 / 埋设·回扣伏笔 / 情绪转场·节奏调节(呼吸镜)
执行层(要在观众身上制造什么效果):
- 制造氛围 / 引导注意力 / 制造时间感(压缩·拉伸·停滞)/ 建立·打破预期
写法示例(一句话覆盖两层):
镜 3:交代角色在樱树下抚琴的空间关系(结构层);用中景加花瓣缓落让观众先安静下来,为后镜情绪转折蓄力(执行层)
四条自检:
- 找不到叙事目的的镜 → 删掉或合并
- 连续三镜高强度叙事后,必须有呼吸镜
- 伏笔 / 回扣必须成对出现
- 台词不能是叙事目的的主体——大量依赖"角色说出某某"就说明视听化不足,改画面或动作来承载
第四条是最值钱的。很多分镜看起来"讲清楚了",其实全靠台词在推,画面什么也没干。
五、第二步:时长判定——先定叙事目的类型,再取基准
硬约束先记牢:H3 的 duration 必填 4–15 的整数秒,估算完向上取整到合法值。写进提示词里的秒数不能替代生成设置,这是两回事。
按叙事目的类型取基准(551 镜统计得出):
叙事目的 | 基准时长 |
|---|---|
推进 / 升级 | 2.5–3.5 s(最快——事件加速,镜头也加速) |
交代 / 建立 / 展现 / 情绪 / 呼应 | 4–5 s |
转折 / 翻转 | 5–7 s(重量要落地) |
升华 / 主旨 | 6–10 s(终极意象需要沉淀) |
按信息表达量(一镜要观众读几层信息,一层约 2–3 秒):
信息量 | 基准 | 典型 |
|---|---|---|
单一 | 2–3 s | 物件特写、简单动作 |
双重 | 4–5 s | 动作 + 环境关系、一句台词 + 反应 |
多层 | 6–8 s | 复杂场面、多人互动 |
综合段落 | 10–15 s | 长镜调度、景别转换、情绪留白 |
按景别:特写 2–4 s / 中景 3–5 s / 全景 4–5 s / 远景 5–7 s / 景别转换(推拉)8–12 s。
对白镜要单独排:先排声音事件,再定镜长,禁止先选个短镜长再往里塞台词。
- 中文参考 4.1 个可发声字/秒——这只是估值,生成后必须核听,不能当成铁律算式
- 台词语速要按角色情境在脑子里"演"一遍:急躁角色 10 个字可能 1.5 秒,沉稳的老人可能 5 秒(含停顿和呼吸)
- 镜长下限 = 台词时间 + 开口前 0.5 秒 + 听者反应 1 秒
- 超过 15 秒 → 回构思层按语义闭合点拆镜,不偷改秒数、不删词、不改快读
最后那条是纪律问题。时长装不下,正确动作是回去拆,而不是把台词删两个字。
六、第三步:镜头组划分
一组镜头共同完成一个叙事目的。四种组型:
组型 | 镜间关系 | 用途 | 组内每镜 |
|---|---|---|---|
蒙太奇组 | 并列 | 建氛围 / 展规模 / 压时间 | 1–3 s |
递进组 | 层层加信息 | 角色介绍 / 设定展示 / 情绪升级 | 2–3 s |
因果组 | 动作 → 反应 | 对话正反打 / 动作攻防 | 3–5 s |
对比组 | 成对照 | 前后呼应 / 并行叙事 / 反讽 | — |
长片语境下有一条更要紧的规则:尾帧接续链的每一段,等于一个镜头组级单元。接续点必须落在叙事闭合状态上——人物位置、道具状态、情绪都到达一个可以暂停的稳态。
这是防漂移的第一道闸,比提示词层面的防漂移句更靠前。
七、第四步:镜头清单(构思层的最终产物)
每镜一行,七要素:
镜号 | 叙事目的(双层一句话) | 时长(含依据) | 景别 | 起点可见状态 | 终点可见状态 | 生效锁四条纪律:
① 起终状态只写可见事实——站 / 坐 / 手持何物 / 门开关 / 衣物状态,不写心理。
这两张就是"起点"和"终点"该长什么样:
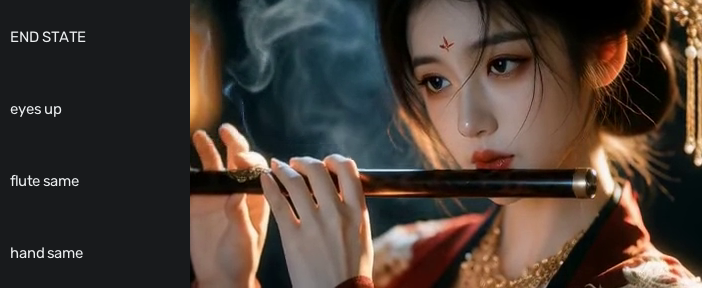
段末帧:终点可见状态
终点状态写"抬眼平视、笛仍在唇前、双手位置不变"是可核对的;写"她心情平静下来"没人能核对。
② 动作落实铁律:每个剧本动作只有一个主要落实镜;其他镜再现该动作,必须新增反应 / 细节 / 新理解,否则就是重复拍。复杂场面可以另附动作落实表(来源动作 / 主要落实镜 / 动作前事实 / 动作后事实 / 他镜作用)。
③ 相邻两镜同景别、同角度、同人物关系 → 切了等于没切,并回一镜,或至少改一项。
④ 每镜盘点参考图需求(身份 / 地理 / 造型 / 构图),再交给判定树选通路;生效锁那一列直接填 LOCK 编号,交付自查时逐镜过一遍,看本镜提示词有没有包含所列锁的锁面原文。
八、把镜头清单翻译成「生成单元」
构思层交出一张人看得懂的清单,接下来要把它切成模型能一次吃下的段。
① 段长只有 10 秒 / 15 秒两档。 对应帧数传 243 / 362,落在 17k+5 的网格上,实得 10.125 s / 15.083 s——本文一、二节实测的那条视频正好是 243 帧。
4–9 秒的内容向上并进 10 秒段(短段反而更容易被跳);超 15 秒的在叙事闭合点拆段,不许压。
② 每段动作 ≤ 3 个(含 1 拍承接),一个动作单独占一个子镜;段尾停在"动作落定后的稳定状态"。
③ 段内就是一镜到底,没有剪辑点。 这一点是很多人栽跟头的地方——构思层里写的"空镜""插入镜"不能带进提示词。写进去它也不会切,只会把画面拉远或者把人变形。
正解:把空镜改写成运镜。要"空教室全景",就写"镜头缓缓拉开露出整间教室,再推回收人"。
④ 段间接缝必须叠化。 段 N 的末帧是喂进去的锚定图,段 N+1 模型重绘的首帧与它天然有差——实测接缝跳变 63.2,而段内最大帧差只有 5~7,肉眼一眼就觉得"接得不顺"。
做法:
xfade=transition=fade:duration=0.5:offset=(段1时长-0.5)
# 音频同步:acrossfade=d=0.5
另外每段开头那 0.3 秒的"首帧交棒"跳变,可以直接裁掉前 8 帧。
⑤ 重跑某段时,把「机位」与「光色」写成显式锁。 只写动作,很容易漂成另一个景别或色温。同一个内容两次运行,景别可以差这么多:
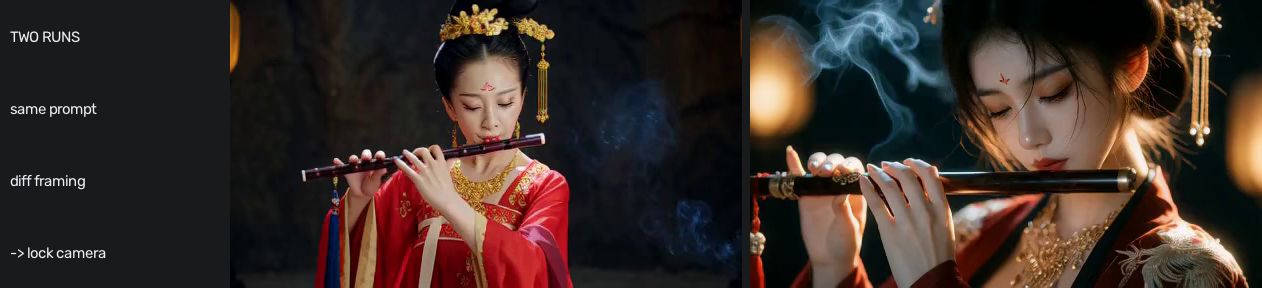
同内容两次运行:景别与构图漂移
补上"全程中景、门留在画面右缘虚焦""只由左侧窗斜阳照明、右半脸暗、暖琥珀加墨绿加浅景深"之后,同 seed 重跑就能回正。
⑥ 先跑 3 段试跑,别跳过:
- ① 色板段——验通路与色调
- ② 关键道具段——验路径链守不守得住
- ③ 动作最密的那一段——全章最容易被跳,用它验路径链有效性
过了再推全章。
⑦ 独立提交还有个工程上的好处:每段独立提交,可以绕开"段数 × 分辨率"的内存红线(那条红线来自插件把全部段的解码帧累积在 CPU 内存里)。独立段不受此限,高分辨率也能跑满整章,只需一段一段来;而且任一段返工只重跑那一段,不牵连前后。
九、连续性锁:跨镜不走样
长篇必须用锁。格式:
LOCK-XXX《中文名》(生效镜头:SHOT-EP001-002、003、007)
  · 锁面:能原样贴进 prompt 的英文短语
例:
LOCK-01《主角色 A 常服》(生效镜头:SHOT-EP001-002、005)
· 锁面:pale ivory linen shirt with a soft round collar, ankle-length chestnut skirt两条铁律:
- 写提示词时从锁文件复制锁面原文,禁止凭记忆手打——一字之差脸就变。
- 交付前自查:本镜提示词是否包含所有生效锁的锁面原文。
第 1 条听着像废话,但它是最常被违反的一条。人对"自己记得住的短语"有迷之自信。
十、四级规则分级:哪些必须守、哪些只是默认
写规程时最容易犯的错,是把"默认值"当成"铁律"。所以我给每条规则标了级别:
级别 | 性质 | 例子 |
|---|---|---|
structural_invariant | 写死,可机械检查 | H3 时长 4–15 整数秒;每镜必有叙事目的 + 起终点 + 时长;锁面必须复制原文 |
craft_default | 默认值,允许偏离(写明理由即可) | 4.1 字/秒;4–5 s 基准;组型时长档 |
reviewed_invariant | 必须守住,结合证据判断 | 没改写剧本动作;没重复落实同一动作 |
taste_option | 只提示,不判错 | 景别偏好、组型选择、风格取向 |
这张表的价值在于:当你跟模型磨的时候,知道哪条可以让、哪条不能让。craft_default 你改了要写理由,structural_invariant 改了就是错。
十一、格式判定树:按「图的用途」选通路,不按数量
构思完就该选通路了。判据不是"我手里有几张图",而是"这些图各用来干什么":
输入参考图 | 通路 | 说明 |
|---|---|---|
无图 | 三段式 | 不挂首帧 |
1 图 = 起始帧 | 三段式 | 挂首帧 |
1 起始帧 + 1 结束帧 | 首尾帧三段式 | 终点只到已接受的终点,不发明过渡后的新状态 |
图 ≥1,且含身份 / 地理 / 造型 / 构图用途 | 六段式(参考图通路) | 全部走 ref_images,起始帧也走这里 |
长片续接 | 默认尾帧接续三段式 | 漂移严重 → 换参考图通路,把上一段视频当参考 |
最后一行是经验:续接漂移严重时,换通路比调提示词有效。
十二、WorkBuddy 在这套流程里的位置
到这儿你会发现,构思层里最重的活不是"想创意",而是管账:五格表填满没、时长合不合法、锁有没有复制、动作数超没超、段切得对不对。
这些正好是我交给 WorkBuddy 干的:
环节 | 交给它做什么 |
|---|---|
填逐镜展开表 | 按剧本逐镜铺开五格,空着的格子直接标出来 |
时长核算 | 按叙事目的取基准、向上取整到 4–15 整数秒,超限的标出语义闭合点 |
镜头组划分 | 按四组型归类,检查有没有连续三镜高强度叙事后缺呼吸镜 |
生成镜头清单 | 按七要素出表,动作落实重复的直接标红 |
锁文件维护 | 建 LOCK 表,写提示词时从文件里取锁面原文而不是重打 |
量帧间差 | 成片出来后逐帧算差,把突变点标在时间轴上——本文第一节那张图就是它跑出来的 |
最后一条是这套流程里我最看重的能力。"无缝"不是形容词,是可以量出来的数字——6.00s 处 58.68 对邻域 2.77,是 21 倍,那就不叫一镜到底,叫切了两刀。
十三、踩坑速查表
症状 | 根因 | 解法 |
|---|---|---|
多出一条手臂 | 逐镜展开表第 ① 格没填(另一只手没交代) | 补"另一只手在哪、手里有什么";镜面构图另加显式声明 |
道具先消失再凭空出现 | 第 ② 格只写了持有,没写落点 | 补道具在本镜内的位置变化与最终落点 |
裙子直接缩上去 / 消失 | 第 ③ 格缺四段式路径链 | 补"物件坐标 → 接触点 → 中间站点 → 脱离点" |
镜间 / 段间跳变,承接断链 | 第 ④ 格没写本镜结束状态 | 每镜必写人、手、道具、布料的结束位置 |
动作被跳,中间过程不存在 | 物件动作数 > 3 | 数动作数拆段,每段 ≤ 3 |
成片碎、与分镜边界对不上 | 把镜级脚本直接当生成单元 | 按 10 s / 15 s 重新切段;段内接受"模型自己会切" |
接缝一眼看出不顺 | 段间没叠化 |
|
重跑后景别 / 色温变了 | 只写了动作,没锁机位与光色 | 把机位、光色写成显式锁再同 seed 重跑 |
高分辨率跑不了整章 | 用导演台多段续接,内存红线 | 改每段独立提交 |
最后
这篇没有"出图效果",因为构思层的产物本来就只是一张表。但它是前面四篇能成立的前提——角色一致性、无缝接力、长视频不漂移,靠的都是这层把账算清。
一条 10 秒的"一镜到底"能被模型自己切成三刀,这件事我量出来之前也只是怀疑。量出来之后,写法就变了:不再跟模型争"我这镜到底几秒",而是按它能吃下的生成单元去切,把"哪里该闭合"提前决定好。
镜头清单是给人看的,生成单元是给模型吃的。中间的翻译层,就是构思层。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号