如何构建上下文引擎,让智能体Token用量削减71%
原创
如何构建上下文引擎,让智能体Token用量削减71%
原创
点火三周
发布于 2026-10-09 10:38:41
发布于 2026-10-09 10:38:41
查询企业数据的智能体将大部分Token消耗在了“探索发现”上:弄清数据模式(schema)、字段含义,以及实体在复杂且可能庞大的文档和数据源之间如何关联。然后,即便是数据没有任何变化,它们在处理下一个查询时又不得不全部重来一遍。
而上下文引擎(context engine)则能在问题到来之前就理解你的数据。它会读取数据源,并将学到的知识以小型结构化上下文单元的形式存储起来。这样,当任务到来时,智能体就能直接获取相关内容,跳过探索环节。我们在Elasticsearch之上构建了一个这样的引擎,结果发现,它的每个阶段本质上都是一个搜索问题。自动化任务会搜索并预计算知识,将其存储在一个专门设计的AI索引中,并为其启用原生的混合搜索与检索能力。有了上下文引擎,智能体只需拉取所需内容,而无需翻遍原始数据。在一个示例中,使用相同的模型和数据,工具调用次数从33次降至9次,输入Token减少了71%。此外,延迟从213秒降至64秒,并且智能体的回答也更加完整,发现了那些原本会被遗漏的关联关系。
没有上下文引擎时,智能体会做什么
向数据智能体提出一个战略性的业务问题,例如:给我一份影响我们最大客户的重大问题摘要。 在没有外部辅助的情况下,一个能力较强的智能体会首先列出所有索引,以查看存在哪些数据。它会读取映射(mapping)来确定哪些字段代表“客户”、哪些字段代表“问题”。它会扫描合同以计算账户价值,并找出最大的账户。在此过程中,它会遗漏五个账户归属于同一家母公司这一关键信息,从而低估了你最重要的客户关系之一。它也不知道account_id在工单索引中有时为空值,导致部分查询在不知不觉中返回了错误的数据行。
模型的推理能力本身没有问题,但智能体将大部分预算花费在了“弄清楚数据是什么”上面,然后才能真正推理“数据说明了什么”。而且在下一次提问时,它还会重复所有这些步骤。
然而,如果能提供恰当的上下文,智能体就能高效得多。基于Elasticsearch构建的上下文引擎会预先从工单、合同等原始数据源中计算知识,并提前提供给智能体,使其在真正推理答案之前避开高成本的步骤。下表展示了上述业务问题在相同系统提示词、模型和数据下的效果差异。唯一的区别在于智能体是否有上下文引擎可供读取。我们将通过本文探讨构建上下文引擎意味着什么,以及它如何带来这些收益。
相同提示词与模型* | 无上下文引擎 | 有上下文引擎 |
|---|---|---|
工具调用次数 | 33 | 9 |
输入Token数 | 2,279,253 | 653,511 |
延迟 | 213秒 | 64秒 |
发现母公司与子公司的关联关系 | 否 | 是 |
成本 | 基线 | 降低71% |
从多个维度来看,上下文引擎都能提升智能体的表现。智能体在减少工具调用、Token和延迟的同时,还能给出更完整的答案。
* 运行时模型:claude-sonnet-5,使用LangChain Deep Agent Harness,预计算约636K输入Token(使用claude-haiku-4-6)。
为什么AI智能体需要上下文层
迄今为止,大多数上下文工程的工作都聚焦于单个智能体上下文窗口中的内容:提示词、工具定义、对话历史、压缩策略。这些工作固然重要,但当我们与基于Elastic Agent Builder构建应用的客户合作时,决定智能体成败的上下文通常根本不在对话中。它是业务知识,例如每个数据源的用途、数据源在系统间的关系、数据中存在哪些趋势或异常,以及如何针对这些数据构建高效查询。
当这些知识无处安放时,同样的问题就会在生产环境中暴露出来,具体包括:
- 每次查询的探索成本。 智能体每次查询都要付出探索成本,花费Token去搞清楚存在哪些数据、字段含义以及数据源之间的关系——哪怕数据根本没有变化。
- 上下文漂移。 无论谁以Markdown文件或目录条目的形式写下了什么上下文,随着数据和用法的变化,这些内容都会逐渐过时。
- 知识孤岛。 一个智能体学到的东西无法惠及其他智能体,因此质量无法累积,成本也不会下降。此外,演示环境与生产环境之间的鸿沟始终存在。
上下文引擎做什么
上下文层位于你的原始数据与智能体之间。它提前完成理解数据的工作,并将结果以小型结构化上下文单元的形式存储起来,然后在智能体需要时将相关内容交给它们。
我们将这些单元称为知识指示器(Knowledge Indicators,简称KI)。一个KI可能描述:
- 一个实体及其关系,例如“LongHaul(ACC-1007)是Orion Holdings的子公司”。
- 数据源概况,例如“tickets索引保存客户支持问题;应对问题描述进行语义搜索”。
- 数据特性,例如“
account_id并非始终存在,因此需要过滤掉空值”。 - 一个事实、异常或模式,如果不借助上下文引擎就需要全表扫描才能发现,例如“过去30天内查询负载的峰值和中位数”。
上下文层通过一个持续循环来创建和提供KI:
- 采集(Gather)。 读取每个数据源,了解其结构。找出对智能体完成任务至关重要的内容。
- 构建(Build)。 将这些内容转化为KI(元数据、实体、关系、异常、事实和查询指南),并进行存储。
- 检索(Retrieve)。 当智能体接到任务时,它会拉取一小批按相关性排序的KI,而不是自己去探索模式(schema)和扫描文档。
- 改进(Improve)。 每次智能体交互都会产生一条轨迹(trace),这些轨迹会作为新数据源反馈回系统,让上下文能够跟上智能体的实际使用方式。
为什么上下文工程的每个阶段都是搜索问题
在这些讨论中,搜索通常只被当作最后的检索步骤。但在实践中,这个循环的每个阶段都依赖于找到正确的信息。
阶段 | 涉及的搜索问题 |
|---|---|
采集 | 你面对的是GB级到PB级的数据,不可能持续全量重处理所有内容。要缩小到关键信息,需要同时具备高召回率和高精确率:用智能体搜索来理解意图,用词法搜索来保证精确性,用语义搜索来提升召回率,并用工作流实现自动化。 |
构建 | KI预计算了智能体在运行时本需自行推导的内容。保留什么、丢弃什么,取决于KI将来如何被检索到,因此KI需要为检索而专门设计嵌入向量、元数据字段和组合字段。 |
检索 | 进入上下文窗口的内容必须相关、完整且简洁。如果包含噪音,智能体会忽略它,转而重新去探索原始数据源。调优这一步本质上是个相关性(relevance)问题。 |
改进 | 轨迹和对话记录是非结构化数据。要发现反复出现的失败及其共性模式,你需要混合搜索。 |
我们选择在Elasticsearch上构建上下文层,因为其各个阶段都依赖于混合搜索、Elasticsearch查询语言(ES|QL)和向量搜索,而且往往是在同一次请求中同时使用。此前的博客文章分别介绍了这些能力,而本文则展示上下文引擎如何将它们整合在一起运行。
这与其他方法(如Agentic RAG和更长上下文窗口)相比如何
上下文工程并非全新实践,业界已有许多应对同样挑战的方法。通过上述循环来创建上下文,可以增强现有方法的效果,并帮助解决它们面临的许多权衡与难题。
方法 | 查询时发生什么 | 权衡取舍 |
|---|---|---|
静态上下文文件或目录 | 智能体读取人工撰写的说明 | 内容会过时,且无法从使用中学习 |
Agentic检索增强生成(RAG) | 智能体搜索原始数据块,循环往复直到满意 | 每项任务都要重新拼装知识,且会遗漏跨文档的关联关系 |
使用grep的编码智能体 | 智能体直接浏览文件 | 速度慢且消耗大量Token;难以判断哪个匹配结果才是正确的 |
更长的模型上下文窗口 | 智能体将数据直接加载到上下文窗口中进行推理 | 更长的上下文窗口难以应对上下文退化(context rot)和注意力问题,并且随着上下文累积,后续每一轮的成本都会增加。 |
上下文层用预计算和处理数据的成本,换取了运行时效率的大幅提升。由于预计算可以提前定义,因此可以使用更小、更便宜的模型来执行,这让上述权衡变得更容易管理,同时也解决了其他方法在效率和投入方面的许多顾虑。
构建上下文引擎
上下文引擎由五个组件构成,如下图所示:数据源(sources)、自动化任务(automations)、AI索引(AI index)、智能体记忆(agent memory,即agents)以及反馈闭环(feedback loop)。
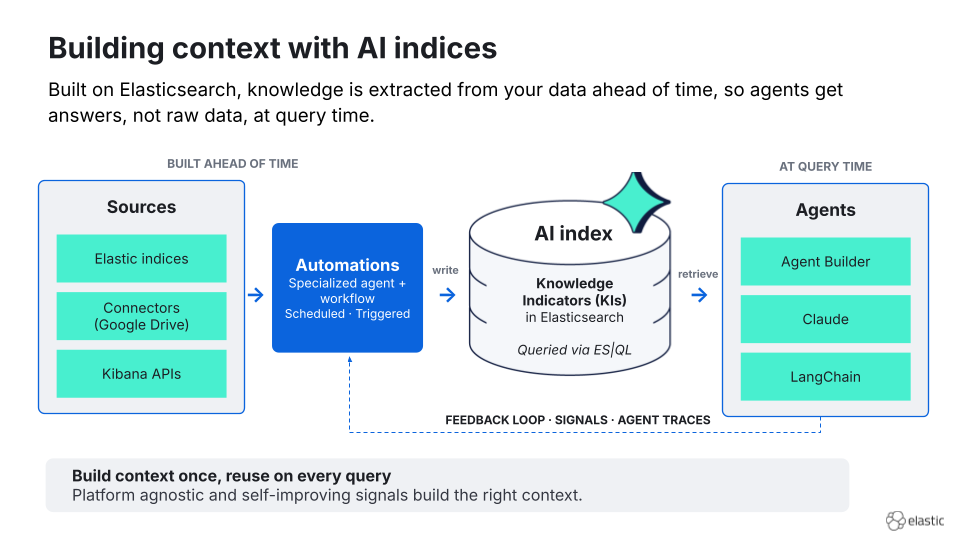
上下文引擎架构:数据源驱动自动化任务,自动化任务将知识指示器写入Elasticsearch中的AI索引
在Elastic内部,我们正在开发一个上下文引擎,以带来智能体所需的准确性和效率提升。接下来让我们逐一详细探讨每个组件。
数据源(Sources)
上下文可以来自任何Elasticsearch索引或数据流,因此你可以直接在数据所在的位置构建上下文。它也可以来自外部应用和数据源(通过连接器),以及来自Agent Builder捕获的或通过OpenTelemetry(OTel)从其他智能体框架传入的智能体轨迹。
自动化任务如何构建上下文
自动化任务负责填充AI索引。它们是Elastic Workflows,包含专门的步骤,用于搜索原始内容、用大语言模型(LLM)或其他模型处理结果、将输出结构化以便检索、验证来源、应用访问控制、跟踪状态,以及将KI写入AI索引。
你无需从头编写这些自动化任务。一个配置智能体(setup agent)会查看你连接的数据源并推荐合适的自动化任务。它们可以运行在小规模、低成本的模型上,或直接使用ES|QL,从而在每次后续查询都能节省成本的同时,保持构建成本低廉。
基于Elasticsearch向量数据库的AI索引
AI索引是上下文存储库。它运行在作为向量数据库的Elasticsearch之上,并支持ES|QL和混合搜索。它保存着自动化任务产生的KI。其模式(schema)和映射专为智能体检索而设计。
智能体记忆如何工作
当用户完成任务时,智能体可以通过“记住”(remember)、“回忆”(recall)和“遗忘”(forget)工具来存储和检索记忆。记忆整合和组织级共享已列入后续路线图。
智能体轨迹如何反馈到上下文中
每次智能体交互都会产生一条轨迹,记录智能体如何完成任务,包括在哪里成功、在哪里卡住,以及在何处花费了Token。反馈闭环会审视这些轨迹中的低效之处,并对你的自动化任务提出改进建议。这样,KI不仅能从你预先编写的测试集改善,也能从真实使用中得到持续优化。
使用上下文引擎:从原始数据到更优答案
以下是上下文引擎如何实现本文开头的那些成果。我们用一个模拟的账户分析智能体,针对上述这类问题进行了评估。它需要从多个数据源拉取数据:
- 四个Elasticsearch索引,分别存放客户工单、订阅者、内部知识库和支持页面搜索查询日志。
- 一个Google Drive文件夹,包含约50份该企业与客户或供应商之间的模拟合同。
自动化任务从这些数据源创建了两类KI。索引概况(Index profiles) 描述每个数据源的用途及查询方式。账户实体(Account entities) 从原始合同和工单文本中提取账户、项目和人员及其与其他实体的关系。这产生了约80个KI,每个KI都包含提取的内容以及跟踪来源、生命周期和查询方式的元数据。自动化任务运行在更小、更便宜的LLM上,因此提取成本保持在较低水平。
我们将AI索引连接到两个智能体框架——Elastic Agent Builder和LangChain Deep Agents,两者均通过模型上下文协议(MCP)进行连接。
基线智能体如何消耗了33次工具调用
对于上述请求给我一份影响我们最大客户的重大问题摘要,基线智能体:
- 进行探索,查看每个数据源、其字段和样本文档以了解结构。
- 弄清楚数据中“客户”的含义(这里有订阅者和签约账户)以及“最大”的定义(这里有年度合同价值[ACV]和月度经常性收入[MRR]字段)。
- 查询工单索引以查找问题。
- 拉取所有提及受影响客户的合同全文,寻找与其他组织的关联关系。
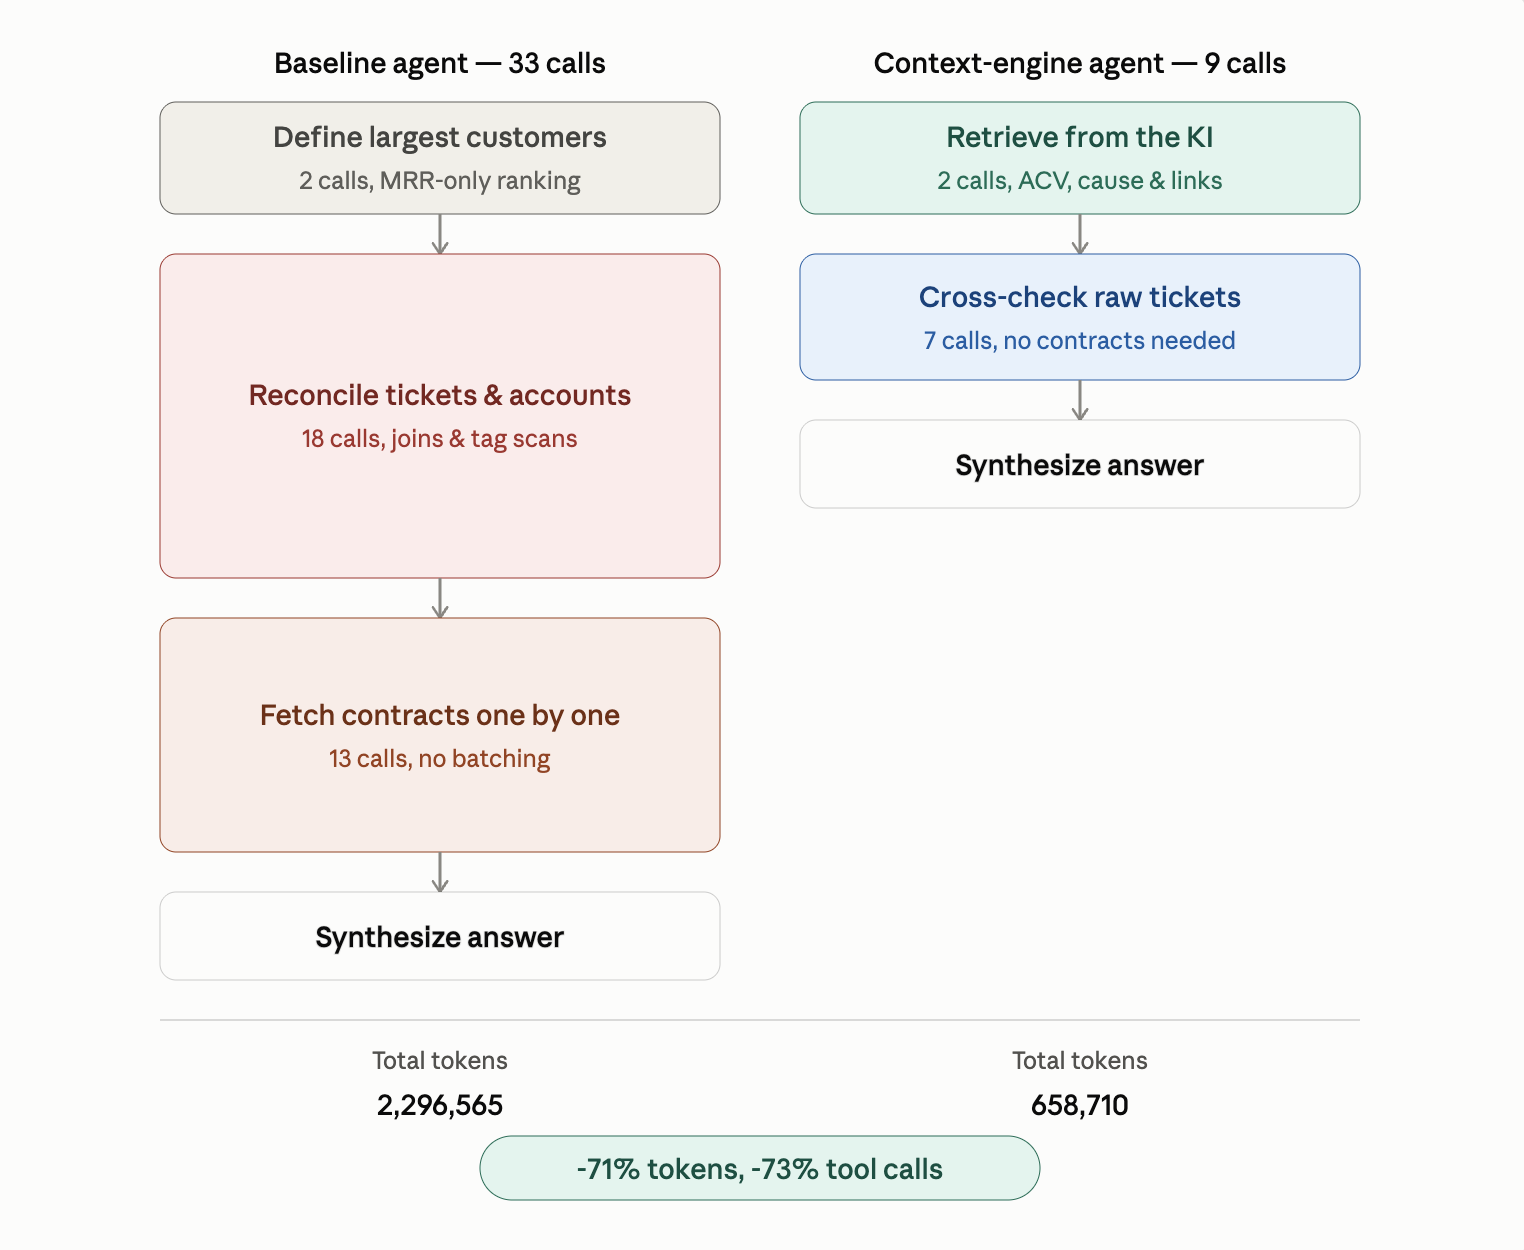
流程图:基线智能体使用33次工具调用和2.3M Token,上下文引擎智能体使用9次调用和659K Token
基线方案耗费18次调用将工单与账户进行匹配,另外13次用于逐个获取合同。而上下文引擎智能体只读取一次账户关系,然后用7次调用来核查原始工单。
探索和合同读取是最耗成本的部分,它们构成了基线运行中绝大部分Token开销。
上下文层带来了什么改变
有了AI索引,智能体从一开始就拥有自动化任务预计算好的知识。它已经知道哪些字段标识客户、哪些字段定义“最大客户”。实体KI还从原始合同文本中捕获了关系,例如一家母公司旗下有多家子公司。智能体在开始阶段就读取这些KI,从而跳过了昂贵的查询和全文档扫描,只需对原始数据做轻量级核查即可。结果是,输入Token减少了71%,上下文窗口也保持干净、没有噪音。
为什么面向智能体的上下文工程是一个搜索问题
第一波上下文工程聚焦于上下文窗口本身:提示词中放什么、压缩什么、丢弃什么。这依然重要,但对于处理企业数据的智能体而言,更困难的问题在于如何首先构建上下文。业务知识必须在对话开始之前就完成采集、整理和保持更新,并且要在多个智能体之间共享,避免各自重复构建。
上下文层正是承担了这项工作,它改变了智能体的工作方式。智能体在“去哪里找、如何查询”方面获得了一致性的指导,因此答案依然来自实时数据,却不会走进死胡同。上下文会从数据源持续刷新,因此能够适应数据、用户行为和使用场景的变化,无需人工维护。每次智能体运行都会暴露缺失,知识库会随着使用不断变好,共享它的每个智能体都能从中受益。
所有这一切都依赖于搜索。从大规模数据集中发现信号、塑造上下文使其可被再次找到、只检索相关内容、在成千上万条轨迹中识别模式——这些都是搜索问题。如果你正在为你的智能体设计上下文层,请将它构建在搜索之上。
我们正在积极寻求与想在生产环境中优化智能体的开发者合作。如果你有兴趣为你的智能体探索上下文引擎,可以在此申请访问权限。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号