基于YOLO26的痰涂片显微镜检测系统(Python源码+数据集+Pyside6界面)
原创
基于YOLO26的痰涂片显微镜检测系统(Python源码+数据集+Pyside6界面)
原创
AI小怪兽
发布于 2026-10-10 14:52:29
发布于 2026-10-10 14:52:29
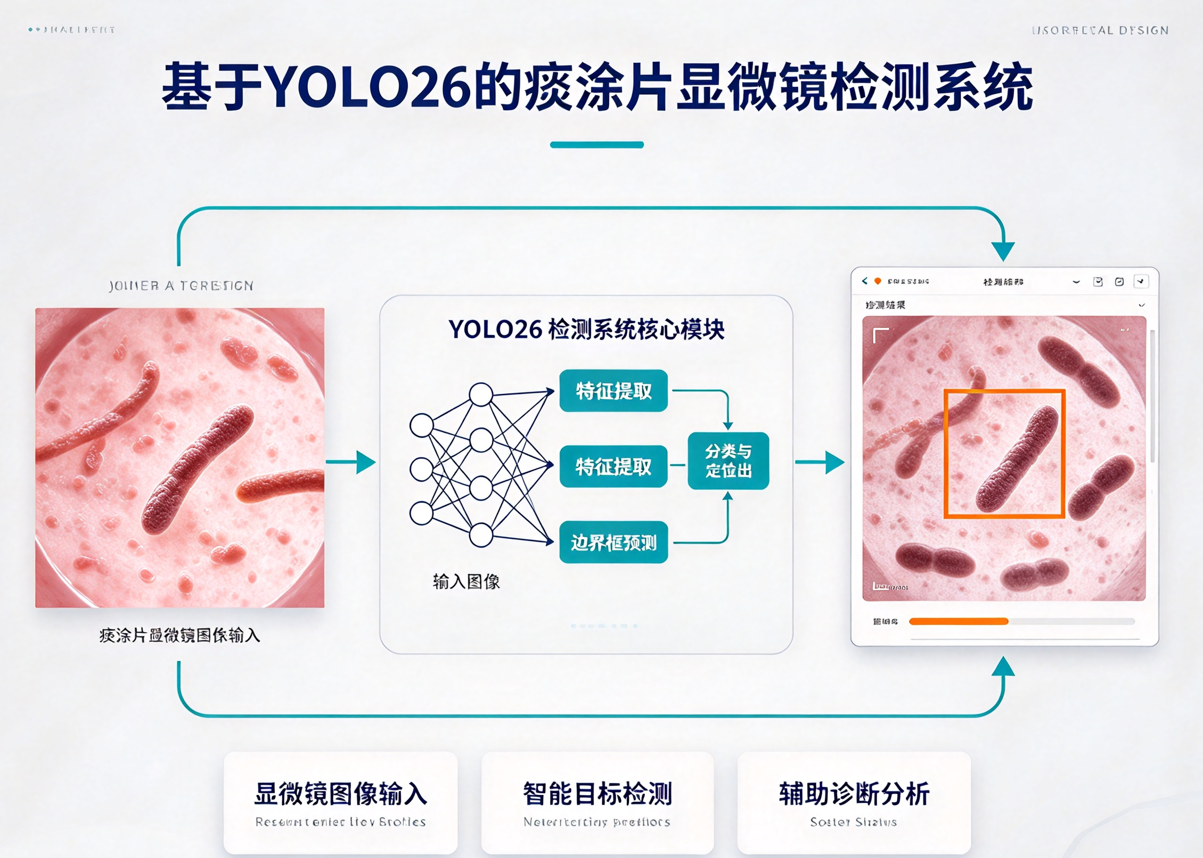
💡💡💡本文摘要:基于YOLO26的痰涂片显微镜检测系统,阐述了整个数据制作和训练可视化过程
基于YOLO26检测该痰涂片数据集的意义:
- 自动筛查病原体:快速识别痰涂片中的结核分枝杆菌等目标,辅助早期诊断。
- 减轻人工负担:替代显微镜人工阅片,提高大批量筛查效率。
- 降低主观误差:标准化标注与AI判读,减少不同人员间差异。
- 适配资源匮乏场景:YOLO26轻量实时,便于边缘设备部署。
- 推动AI辅助诊断:为痰涂片智能检测提供可复现基准,促进临床转化。
博主简介
AI小怪兽 | 计算机视觉布道者 | 视觉检测领域创新者
深耕计算机视觉与深度学习领域,专注于目标检测前沿技术的探索与突破。长期致力于YOLO系列算法的结构性创新、性能极限优化与工业级落地实践,旨在打通从学术研究到产业应用的最后一公里。
🚀 核心专长与技术创新
- YOLO算法结构性创新:于CSDN平台原创发布《YOLOv13魔术师》、《YOLOv12魔术师》等全系列深度专栏。系统性提出并开源了多项原创自研模块,在模型轻量化设计、多维度注意力机制融合、特征金字塔重构等关键方向完成了一系列突破性实践,为行业提供了具备高参考价值的技术路径与完整解决方案。
- 技术生态建设与知识传播:独立运营 “计算机视觉大作战” 公众号(粉丝1.6万),成功构建高质量的技术交流社群。致力于将复杂算法转化为通俗易懂的解读与可复现的工程代码,显著降低了计算机视觉的技术入门门槛。
🏆 行业影响力与商业实践
- 荣获腾讯云年度影响力作者与创作之星奖项,内容质量与专业性获行业权威平台认证。
- 全网累计拥有 7万+ 垂直领域技术受众,专栏文章总阅读量突破百万,在目标检测领域形成了广泛的学术与工业影响力。
- 具备丰富的企业级项目交付经验,曾为工业视觉检测、智慧城市安防等多个关键领域提供定制化的算法模型与解决方案,驱动业务智能化升级。
💡 未来方向与使命
秉持 “让每一行代码都有温度” 的技术理念,未来将持续聚焦于实时检测、语义分割及工业缺陷检测的商业化闭环等核心方向。愿与业界同仁协同创新,共同推动技术边界,以坚实的技术能力赋能实体经济与行业变革。
1.YOLO26原理介绍
论文:https://arxiv.org/pdf/2509.25164
摘要:本研究对Ultralytics YOLO26进行了全面分析,重点阐述了其关键架构改进及其在实时边缘目标检测中的性能基准测试。YOLO26于2025年9月发布,是YOLO系列最新、最先进的成员,专为在边缘及低功耗设备上实现高效、精确且易于部署的目标而构建。本文依次详述了YOLO26的架构创新,包括:移除了分布焦点损失(DFL);采用端到端的无NMS推理;集成了渐进损失(ProgLoss)与小目标感知标签分配(STAL);以及引入了用于稳定收敛的MuSGD优化器。除架构外,本研究将YOLO26定位为多任务框架,支持目标检测、实例分割、姿态/关键点估计、定向检测及分类。我们在NVIDIA Jetson Nano与Orin等边缘设备上呈现了YOLO26的性能基准测试,并将其结果与YOLOv8、YOLOv11、YOLOv12、YOLOv13及基于Transformer的检测器进行比较。本文进一步探讨了其实时部署路径、灵活的导出选项(ONNX、TensorRT、CoreML、TFLite)以及INT8/FP16量化技术。文章重点展示了YOLO26在机器人、制造业及物联网等领域的实际应用案例,以证明其跨行业适应性。最后,讨论了关于部署效率及更广泛影响的见解,并展望了YOLO26及YOLO系列的未来发展方向。
关键词:YOLO26;边缘人工智能;多任务目标检测;无NMS推理;小目标识别;YOLO(You Only Look Once);目标检测;MuSGD优化器
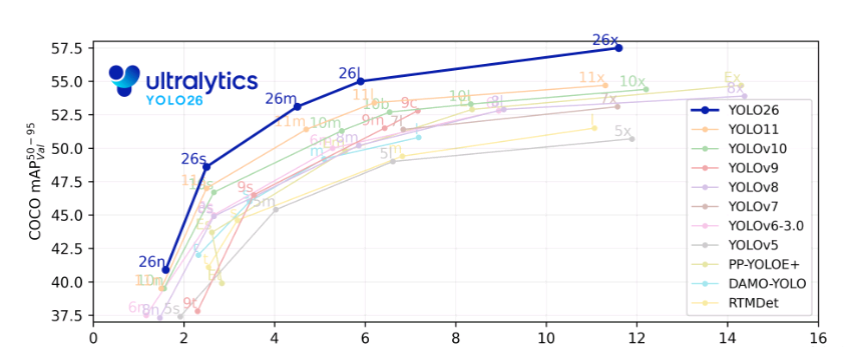
结构框图如下:
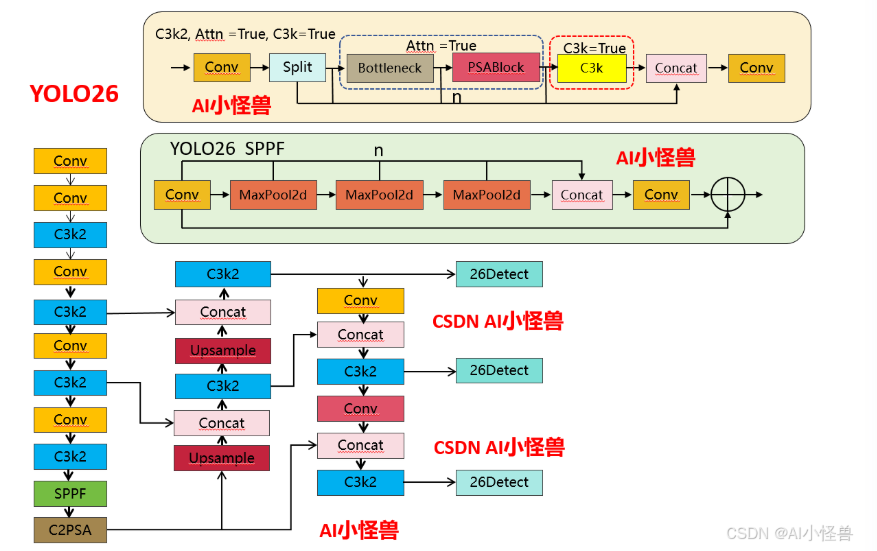
1.1 YOLO11 vs YOLO26结构差异性
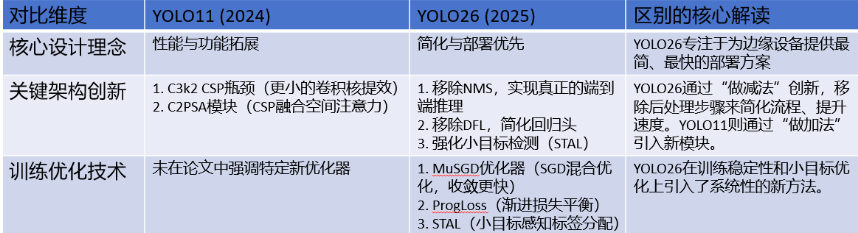
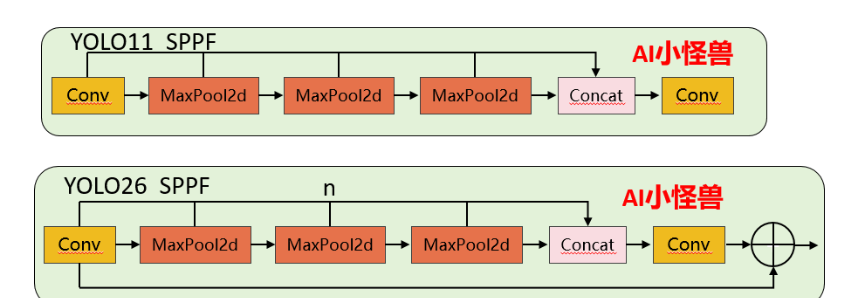
1.1.1 SPPF 核心差异对比
1)池化次数灵活性:YOLO11 的 3 次池化是硬编码的,要修改必须改源码;YOLO26 通过n参数可灵活调整(比如设为 2 次或 4 次),无需改核心逻辑。
2)Shortcut 设计:YOLO26 新增的残差连接能缓解深层网络的梯度消失问题,提升特征复用能力,而 YOLO11 无此设计。
3)激活函数控制:YOLO26 禁用 Conv1 的激活函数,让特征在池化前保持更 “原始” 的状态,是工程上对特征提取的优化。
源码位置:ultralytics/nn/modules/block.py
1.1.2 C3k2 核心差异对比
1)注意力机制的新增:YOLO26 的 C3k2 首次引入PSABlock(金字塔注意力模块),通过attn参数控制是否启用,这是两者最核心的功能差异 —— 启用后模块会先通过 Bottleneck 提取基础特征,再通过 PSABlock 增强关键区域的特征权重,提升小目标 / 复杂场景的检测效果。
2)分支逻辑的扩展:YOLO11 的分支仅受c3k控制,而 YOLO26 的分支逻辑优先级为attn > c3k,即只要attn=True,会优先启用注意力模块,忽略c3k的配置。
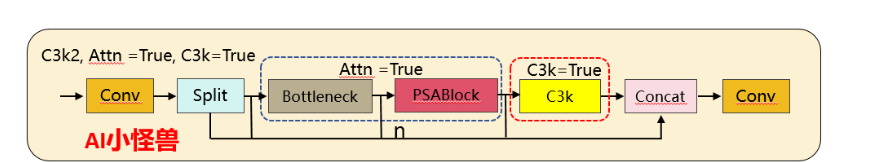
重复模块m (n次迭代):
┌─────────────────────────────────────────────────────────┐
│                                                         │
│  如果 attn=True:                                        │
│    Sequential(                                          │
│        Bottleneck(self.c, self.c),                     │  ←─ 先特征提取
│        PSABlock(self.c, attn_ratio=0.5, num_heads=...) │  ←─ 后注意力增强
│    )                                                    │
│                                                         │
│  否则如果 c3k=True:                                     │
│    C3k(self.c, self.c, 2)                             │  ←─ 同YOLOv11
│                                                         │
│  否则:                                                  │
│    Bottleneck(self.c, self.c)                         │  ←─ 同YOLOv11
│                                                         │
└─────────────────────────────────────────────────────────┘
YOLO26 C3k2代码:
源码位置:ultralytics/nn/modules/block.py
1.2 YOLO26核心创新点
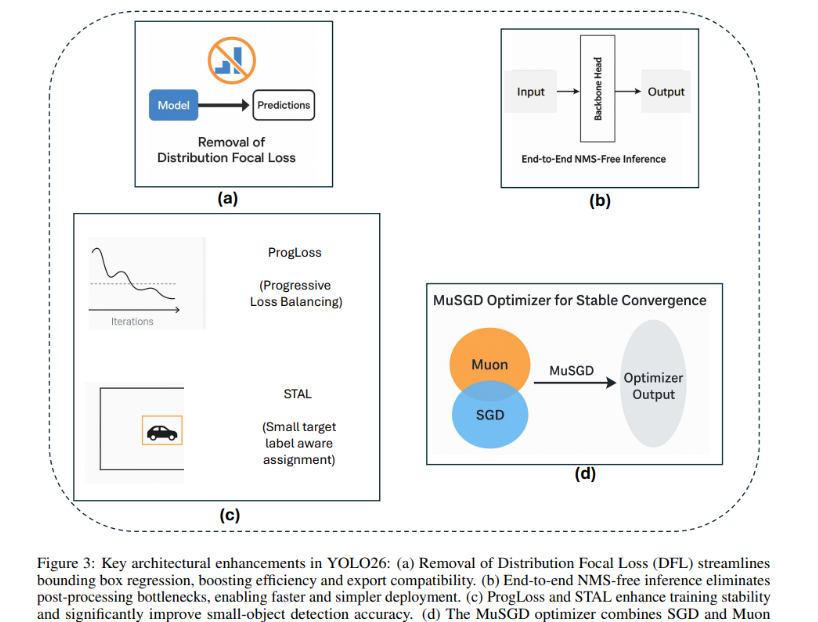
YOLO26引入了多项关键架构创新,使其区别于前几代YOLO模型。这些增强不仅提高了训练稳定性和推理效率,还从根本上重塑了实时边缘设备的部署流程。本节将详细描述YOLO26的四项主要贡献:(i)移除分布焦点损失(DFL),(ii)引入端到端无NMS推理,(iii)新颖的损失函数策略,包括渐进损失平衡(ProgLoss)和小目标感知标签分配(STAL),以及(iv)开发用于稳定高效收敛的MuSGD优化器。我们将详细讨论每一项架构增强,并通过对比分析突显其相对于YOLOv8、YOLOv11、YOLOv12和YOLOv13等早期YOLO版本的优势。
1.2.1 创新点1:移除分布焦点损失(DFL)
YOLO26最重要的架构简化之一是移除了分布焦点损失(DFL)模块(图3a),该模块曾存在于YOLOv8和YOLOv11等早期YOLO版本中。DFL最初旨在通过预测边界框坐标的概率分布来改进边界框回归,从而实现更精确的目标定位。虽然该策略在早期模型中展示了精度提升,但也带来了不小的计算开销和导出困难。在实践中,DFL在推理和模型导出期间需要专门处理,这使针对ONNX、CoreML、TensorRT或TFLite等硬件加速器的部署流程变得复杂。
源码位置:ultralytics/utils/loss.py
通过reg_max 设置为1,移除了分布焦点损失(DFL)
class BboxLoss(nn.Module):
    """Criterion class for computing training losses for bounding boxes."""

    def __init__(self, reg_max: int = 16):
        """Initialize the BboxLoss module with regularization maximum and DFL settings."""
        super().__init__()
        self.dfl_loss = DFLoss(reg_max) if reg_max > 1 else None
1.2.2 创新点2:端到端无NMS推理
YOLO26从根本上重新设计了预测头,以直接产生非冗余的边界框预测,无需NMS。这种端到端设计不仅降低了推理复杂度,还消除了对手动调优阈值的依赖,从而简化了集成到生产系统的过程。对比基准测试表明,YOLO26实现了比YOLOv11和YOLOv12更快的推理速度,其中nano模型在CPU上的推理时间减少了高达43%。这使得YOLO26对于移动设备、无人机和嵌入式机器人平台特别有利,在这些平台上,毫秒级的延迟可能产生重大的操作影响。
源码位置:ultralytics/utils/nms.py
1.2.3 创新点3:ProgLoss和STAL:增强训练稳定性和小目标检测
训练稳定性和小目标识别仍然是目标检测中持续存在的挑战。YOLO26通过整合两种新颖策略来解决这些问题:渐进损失平衡(ProgLoss)和小目标感知标签分配(STAL),如图(图3c)所示。
ProgLoss在训练期间动态调整不同损失分量的权重,确保模型不会过拟合于主导物体类别,同时防止在稀有或小类别上表现不佳。这种渐进式再平衡改善了泛化能力,并防止了训练后期的不稳定。另一方面,STAL明确优先为小目标分配标签,由于像素表示有限且易被遮挡,小目标尤其难以检测。ProgLoss和STAL共同为YOLO26在包含小目标或被遮挡目标的数据集(如COCO和无人机图像基准)上带来了显著的精度提升。
1.2.4 创新点4:用于稳定收敛的MuSGD优化器
YOLO26的最后一项创新是引入了MuSGD优化器(图3d),它结合了随机梯度下降(SGD)的优势与最近提出的Muon优化器(一种受大型语言模型训练中使用的优化策略启发而发展的技术)。MuSGD利用SGD的鲁棒性和泛化能力,同时融入了来自Muon的自适应特性,能够在不同数据集上实现更快的收敛和更稳定的优化。
源码位置:ultralytics/optim/muon.py
2.痰涂片显微镜检测系统
伪代码如下:
# ======================================================================
# 基于YOLO26的痰涂片显微镜检测系统 - 伪代码
# 数据集:Raw_Sputum_Microscopy_Dataset
# 功能:自动检测痰涂片中的病原体(如结核分枝杆菌)
# ======================================================================

import os
import cv2
import yaml
import torch
import numpy as np
import matplotlib.pyplot as plt
from pathlib import Path
from ultralytics import YOLO
from typing import List, Dict, Tuple

# ========================= 1. 配置参数 =========================
class Config:
    """系统配置参数"""
    # 数据集
    DATA_YAML = "sputum_smear.yaml"          # YOLO数据集配置文件
    CLASS_NAMES = ["AFB", "Other"]           # AFB: 抗酸杆菌;Other: 其他/背景
    NUM_CLASSES = 2

    # 模型
    MODEL_NAME = "yolo26n.pt"                # 预训练权重 (n/s/m/l/x)
    IMG_SIZE = 640
    BATCH_SIZE = 16
    EPOCHS = 100
    DEVICE = 0                               # GPU编号,-1为CPU

    # 路径
    PROJECT_DIR = "./sputum_detection"
    WEIGHT_DIR = f"{PROJECT_DIR}/weights"
    RESULT_DIR = f"{PROJECT_DIR}/results"

# ========================= 2. 数据集准备 =========================
class SputumSmearDataset:
    """痰涂片显微镜数据集管理"""

    def __init__(self, data_yaml: str):
        self.data_yaml = data_yaml
        self._load_config()

    def _load_config(self):
        with open(self.data_yaml, 'r') as f:
            self.cfg = yaml.safe_load(f)
        self.train_path = self.cfg['train']
        self.val_path = self.cfg['val']
        self.nc = self.cfg['nc']
        self.names = self.cfg['names']
        print(f"[数据集] 加载成功: {self.nc}类, 训练集: {self.train_path}")

    def analyze_distribution(self):
        """统计各类别样本数量(可选)"""
        # 遍历标签文件统计各类别实例数
        pass

# ========================= 3. 模型训练与推理 =========================
class SputumSmearDetector:
    """痰涂片病原体检测器"""

    def __init__(self, model_name: str = Config.MODEL_NAME):
        self.model_name = model_name
        self.model = None
        self._load_model()

    def _load_model(self):
        """加载YOLO26预训练模型"""
        self.model = YOLO(self.model_name)
        print(f"[模型] 加载预训练权重: {self.model_name}")

    def train(self, data_yaml: str, config: Config):
        """训练痰涂片检测模型"""
        print("\n[训练] 开始训练痰涂片检测模型...")

        train_args = {
            'data': data_yaml,
            'epochs': config.EPOCHS,
            'imgsz': config.IMG_SIZE,
            'batch': config.BATCH_SIZE,
            'device': config.DEVICE,
            'project': config.PROJECT_DIR,
            'name': 'yolo26_sputum',
            'exist_ok': True,
            'patience': 30,                # 早停
            'lr0': 0.01,
            'lrf': 0.01,
            'momentum': 0.937,
            'weight_decay': 0.0005,
            'warmup_epochs': 3,
            'box': 7.5,
            'cls': 0.5,
            'dfl': 1.5,
            'val': True,
            'plots': True,
            'save': True,
            'seed': 0,
            # 医学显微图像常用增强
            'mosaic': 0.5,
            'mixup': 0.0,
            'hsv_h': 0.015,
            'hsv_s': 0.7,
            'hsv_v': 0.4,
            'translate': 0.1,
            'scale': 0.5,
            'fliplr': 0.5,
            'flipud': 0.5,
        }

        results = self.model.train(**train_args)
        print("[训练] 训练完成!")
        return results

    def evaluate(self, data_yaml: str):
        """在验证集上评估模型性能"""
        print("\n[评估] 在验证集上评估模型...")

        metrics = self.model.val(
            data=data_yaml,
            split='val',
            conf=0.001,
            iou=0.6,
            device=Config.DEVICE,
            plots=True,
        )

        results = {
            'mAP50': metrics.box.map50,
            'mAP50-95': metrics.box.map,
            'precision': metrics.box.mp,
            'recall': metrics.box.mr,
            'F1': 2 * metrics.box.mp * metrics.box.mr / (metrics.box.mp + metrics.box.mr + 1e-6),
        }

        print(f"\n[评估结果]")
        print(f"  mAP@0.5: {results['mAP50']:.4f}")
        print(f"  mAP@0.5:0.95: {results['mAP50-95']:.4f}")
        print(f"  Precision: {results['precision']:.4f}")
        print(f"  Recall: {results['recall']:.4f}")
        print(f"  F1-Score: {results['F1']:.4f}")

        return results

    def predict(self, image_path: str, conf_thresh: float = 0.25):
        """单张痰涂片图像推理"""
        results = self.model(image_path, conf=conf_thresh, iou=0.45)[0]
        detections = self._parse_results(results, image_path)
        return detections

    def predict_batch(self, image_dir: str, output_dir: str, conf_thresh: float = 0.25):
        """批量推理并保存可视化结果"""
        os.makedirs(output_dir, exist_ok=True)
        image_paths = list(Path(image_dir).glob("*.jpg")) + list(Path(image_dir).glob("*.png"))

        print(f"[批量推理] 共 {len(image_paths)} 张图像...")
        all_detections = []

        for img_path in image_paths:
            results = self.model(str(img_path), conf=conf_thresh)[0]
            annotated = results.plot()
            out_path = os.path.join(output_dir, img_path.name)
            cv2.imwrite(out_path, annotated)

            det = self._parse_results(results, str(img_path))
            all_detections.append(det)

        self._generate_report(all_detections, output_dir)
        return all_detections

    def _parse_results(self, results, image_path: str):
        """解析YOLO检测结果"""
        detections = []
        if results.boxes is not None:
            for box in results.boxes:
                x1, y1, x2, y2 = map(int, box.xyxy[0].tolist())
                conf = float(box.conf[0])
                cls_id = int(box.cls[0])
                cls_name = results.names[cls_id]
                detections.append({
                    'class_id': cls_id,
                    'class_name': cls_name,
                    'confidence': conf,
                    'bbox': [x1, y1, x2, y2],
                })
        return {
            'image': Path(image_path).name,
            'num_detections': len(detections),
            'detections': detections,
        }

    def _generate_report(self, detections: List[Dict], output_dir: str):
        """生成检测统计报告"""
        report_path = os.path.join(output_dir, "detection_report.txt")
        total = sum(d['num_detections'] for d in detections)
        class_counts = {name: 0 for name in Config.CLASS_NAMES}

        for d in detections:
            for det in d['detections']:
                class_counts[det['class_name']] += 1

        with open(report_path, 'w') as f:
            f.write("=" * 50 + "\n")
            f.write("痰涂片显微镜检测报告\n")
            f.write("=" * 50 + "\n")
            f.write(f"处理图像数: {len(detections)}\n")
            f.write(f"检测病原体总数: {total}\n\n")
            f.write("各类别统计:\n")
            for name, cnt in class_counts.items():
                if cnt > 0:
                    f.write(f"  {name}: {cnt}\n")
        print(f"[报告] 已保存: {report_path}")

# ========================= 4. 可视化 =========================
class Visualizer:
    """检测结果可视化工具"""

    @staticmethod
    def plot_metrics(results: dict, save_path: str = None):
        """绘制评估指标柱状图"""
        fig, axes = plt.subplots(1, 2, figsize=(12, 5))

        # 指标柱状图
        metrics = ['mAP50', 'mAP50-95', 'Precision', 'Recall', 'F1']
        values = [results.get(m, 0) for m in metrics]
        axes[0].bar(metrics, values, color=['#2E86AB', '#A23B72', '#F18F01', '#C73E1D', '#3B1F2B'])
        axes[0].set_ylim(0, 1)
        axes[0].set_title('Detection Metrics')
        axes[0].grid(axis='y', alpha=0.3)

        # 各类别AP(示意)
        # axes[1].barh(Config.CLASS_NAMES, ap_values)
        axes[1].set_title('Per-Class AP')
        axes[1].grid(axis='x', alpha=0.3)

        plt.tight_layout()
        if save_path:
            plt.savefig(save_path, dpi=300)
        plt.show()

# ========================= 5. 主程序 =========================
def main():
    print("=" * 60)
    print("  基于YOLO26的痰涂片显微镜检测系统")
    print("=" * 60)

    config = Config()
    os.makedirs(config.PROJECT_DIR, exist_ok=True)
    os.makedirs(config.WEIGHT_DIR, exist_ok=True)
    os.makedirs(config.RESULT_DIR, exist_ok=True)

    # 检查数据集配置
    if not os.path.exists(config.DATA_YAML):
        print(f"[错误] 数据集配置文件不存在: {config.DATA_YAML}")
        print("请创建包含 train/val 路径及 nc/names 的 YAML 文件。")
        return

    # 初始化检测器
    detector = SputumSmearDetector(config.MODEL_NAME)

    # 训练(如果已有权重则跳过)
    best_weight = os.path.join(config.WEIGHT_DIR, "best.pt")
    if not os.path.exists(best_weight):
        print("\n[提示] 未找到训练权重,开始训练...")
        detector.train(config.DATA_YAML, config)
        # 实际训练后可将最佳权重复制到 WEIGHT_DIR
    else:
        print(f"\n[提示] 加载已有权重: {best_weight}")
        detector.model = YOLO(best_weight)

    # 评估
    eval_results = detector.evaluate(config.DATA_YAML)

    # 可视化指标
    Visualizer.plot_metrics(eval_results, save_path=os.path.join(config.RESULT_DIR, "metrics.png"))

    # 批量推理示例
    test_image_dir = "./sputum_smear/test/images"   # 替换为实际路径
    output_dir = os.path.join(config.RESULT_DIR, "predictions")
    if os.path.exists(test_image_dir):
        print("\n[推理] 对测试集进行批量检测...")
        detector.predict_batch(test_image_dir, output_dir, conf_thresh=0.25)

    print("\n" + "=" * 60)
    print("  系统运行完成!")
    print("=" * 60)

# ========================= 入口 =========================
if __name__ == "__main__":
main()2.1 痰涂片显微镜检测数据集介绍
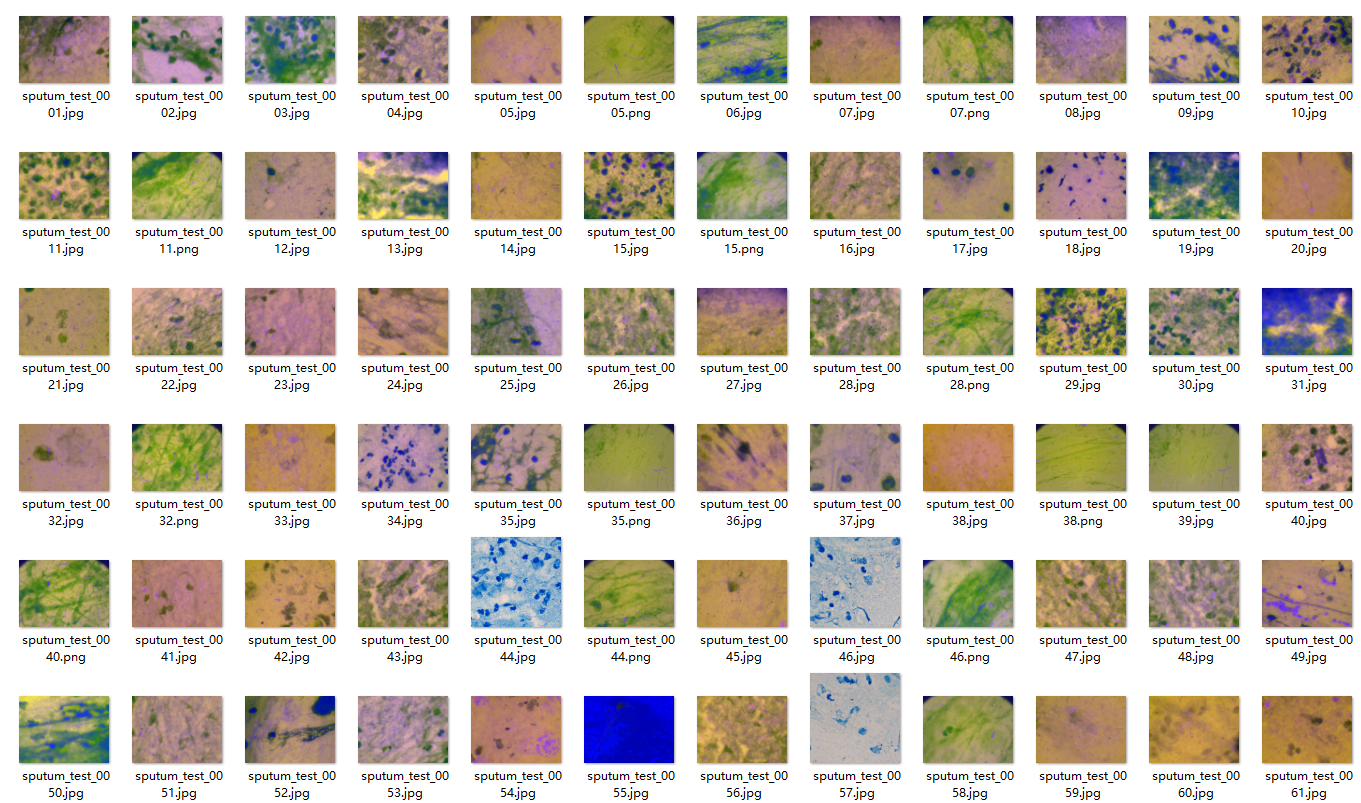
训练集1319张,验证集167张,测试集164张
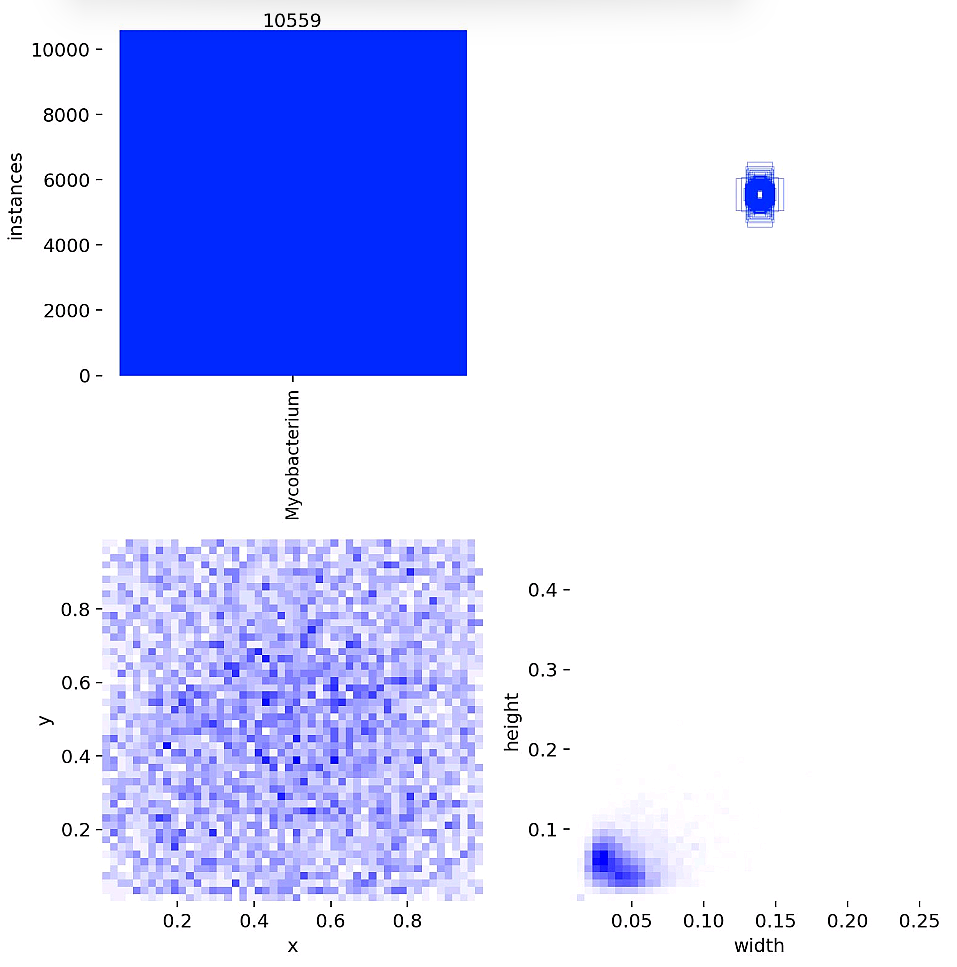
标签可视化分析
2.2 配置Microscopy.yaml
ps:建议填写绝对路径
# Dataset unificado a partir de Final_dataset.
path: D:/YOLO26data/Microscopy

train: images/train
val: images/val
test: images/test

nc: 1

names:
  - Mycobacterium
2.3 如何训练
import warnings
warnings.filterwarnings('ignore')
from ultralytics import YOLO

if __name__ == '__main__':
    model = YOLO('ultralytics/cfg/models/26/yolo26.yaml')
    model.train(data='data/Microscopy.yaml',
                cache=False,
                imgsz=640,
                epochs=200,
                batch=8,
                close_mosaic=10,
                device='0',
                optimizer='SGD', # using SGD
                project='runs/train',
                name='exp',
                )
2.4 训练结果可视化结果
YOLO26 summary (fused): 120 layers, 2,375,031 parameters, 0 gradients, 5.3 GFLOPs
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95): 100% ━━━━━━━━━━━━ 6/6 1.6it/s 3.7s
                   all        167       1400      0.623      0.628      0.571      0.278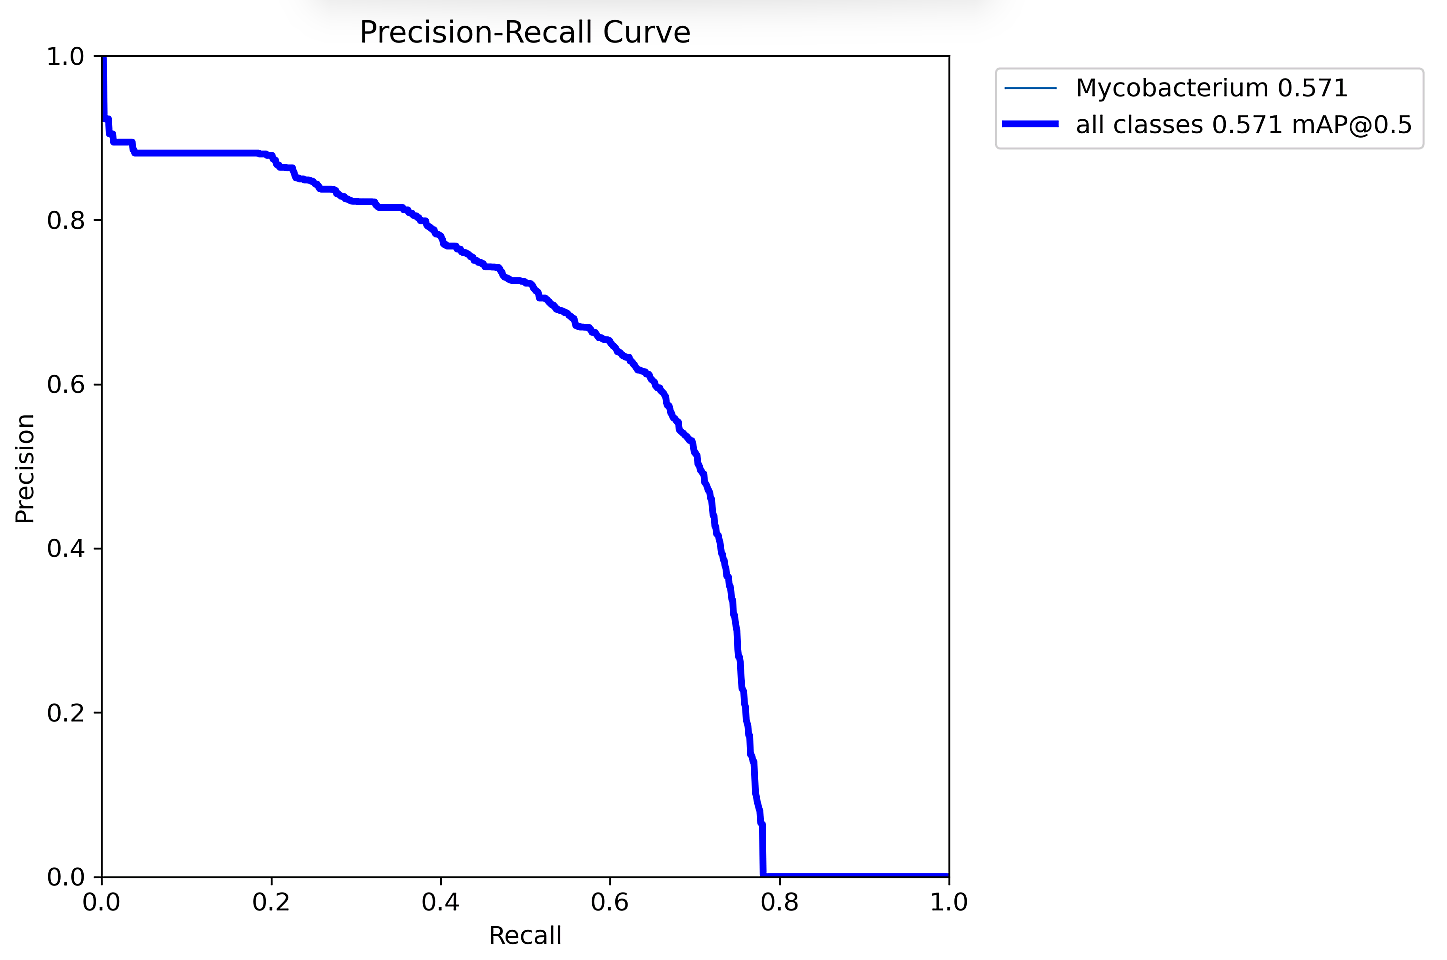
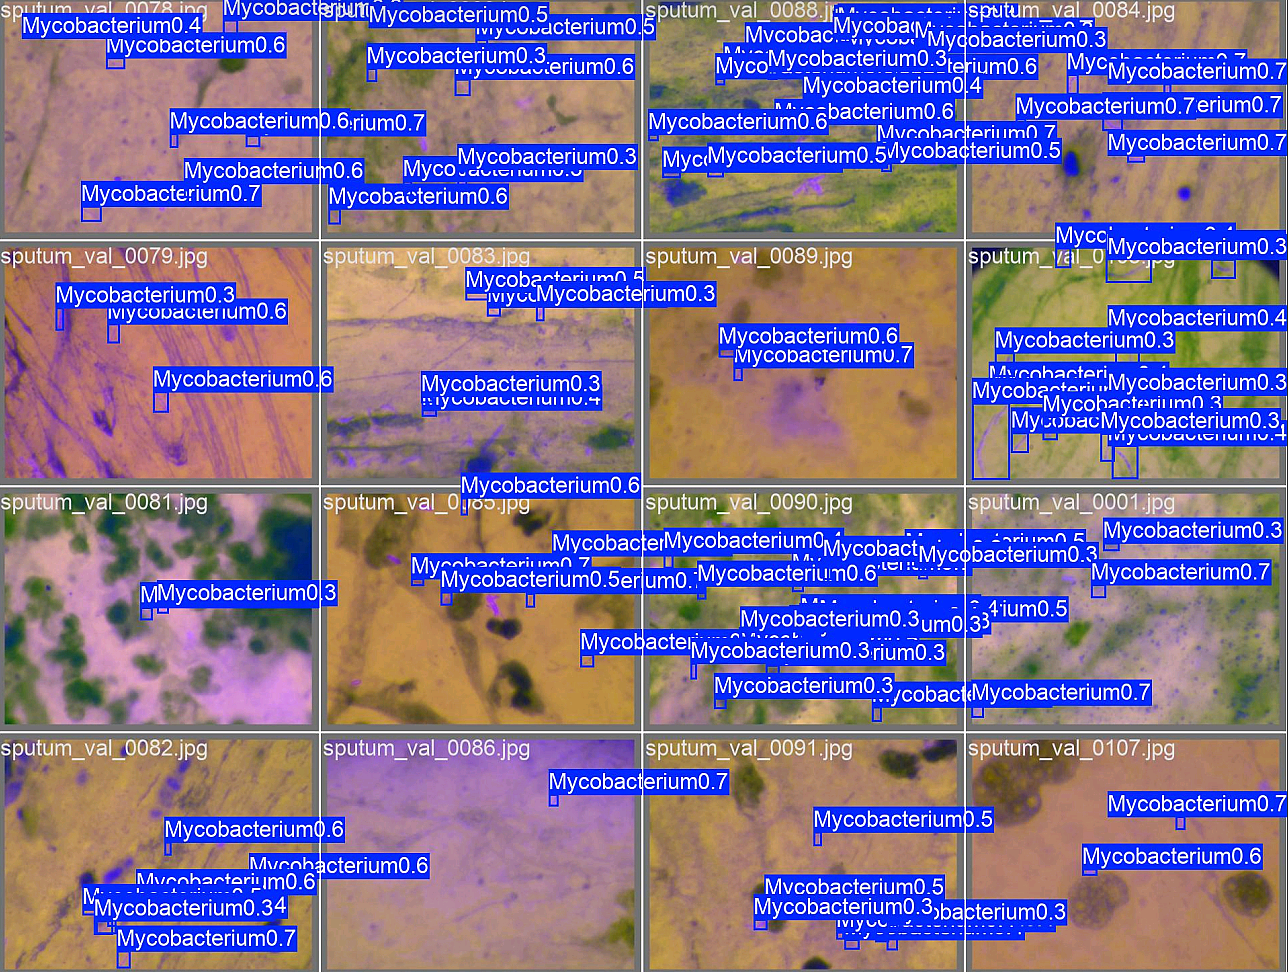
预测结果:
3. 痰涂片显微镜检测系统设计
3.1 PySide6介绍
受益于人工智能的崛起,Python语言几乎以压倒性优势在众多编程语言中异军突起,成为AI时代的首选语言。在很多情况下,我们想要以图形化方式将我们的人工智能算法打包提供给用户使用,这时候选择以python为主的GUI框架就非常合适了。
PySide是Qt公司的产品,PyQt是第三方公司的产品,二者用法基本相同,不过在使用协议上却有很大差别。PySide可以在LGPL协议下使用,PyQt则在GPL协议下使用。
PySide目前常见的有两个版本:PySide2和PySide6。PySide2由C++版的Qt5开发而来.,而PySide6对应的则是C++版的Qt6。从PySide6开始,PySide的命名也会与Qt的大版本号保持一致,不会再出现类似PySide2对应Qt5这种容易混淆的情况。
3.2 安装PySide6
pip install --upgrade pip
pip install pyside6 -i https://mirror.baidu.com/pypi/simple
基于PySide6开发GUI程序包含下面三个基本步骤:
- 设计GUI,图形化拖拽或手撸;
- 响应UI的操作(如点击按钮、输入数据、服务器更新),使用信号与Slot连接界面和业务;
- 打包发布;
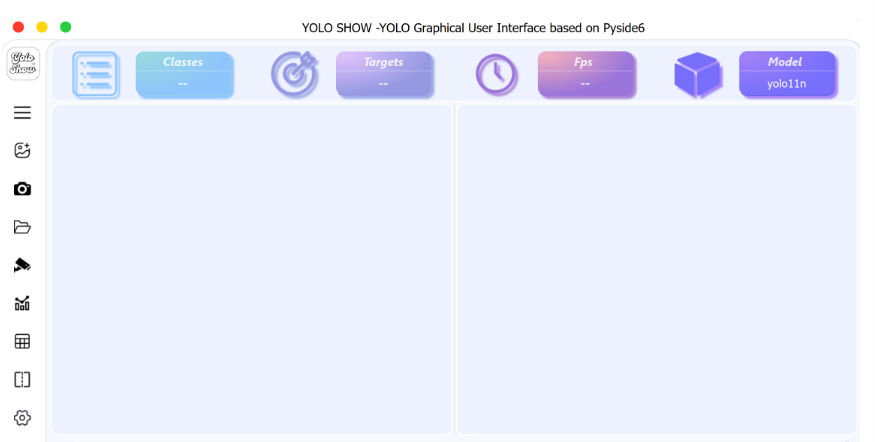
3.3 痰涂片显微镜检测系统设计
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号