多站点机房统一监控:基于IP传感终端的温湿度数据汇聚架构
原创
多站点机房统一监控:基于IP传感终端的温湿度数据汇聚架构
原创
HONSOR盛世宏博
发布于 2026-10-10 15:33:17
发布于 2026-10-10 15:33:17
多站点机房统一监控:基于IP传感终端的温湿度数据汇聚架构
物联网 · 盛世宏博 · 多站点汇聚 · IP传感终端 · 统一监控 · 数据汇聚
关键词:多站点机房、统一监控、IP传感终端、温湿度数据汇聚、分布式采集、SNMP、Modbus TCP、集中管理 标签:#物联网 #Modbus #TCP/IP #UDP #POE供电 #腾讯云 #Wireshark #Python #InfluxDB #以太网温湿度传感器 #网口温湿度变送器 #机房监控
一、多站点机房的监控困局
企业级IT基础设施往往分散在多个地理位置:总部数据中心、分支机构机房、边缘节点、异地灾备中心。每个站点少则1~2个机柜,多则几十个机柜,各自独立运行。传统做法是每个站点配一台本地监控屏或独立动环主机,运维人员需要登录不同系统才能查看各站点状态。
痛点清单:
痛点 | 具体表现 | 业务影响 |
|---|---|---|
信息碎片化 | 5个站点=5套系统=5个账号 | 故障排查需反复切换 |
告警响应慢 | 夜间告警只推送到本地,无人值守 | MTTR(平均修复时间)延长 |
缺乏全局视角 | 无法一眼看到所有站点的健康状态 | 无法做容量规划和资源调度 |
运维成本高 | 每个站点需独立维护监控设备 | 人力投入翻倍 |
数据无法对比 | 各站点数据格式不统一 | 无法做横向能效分析 |
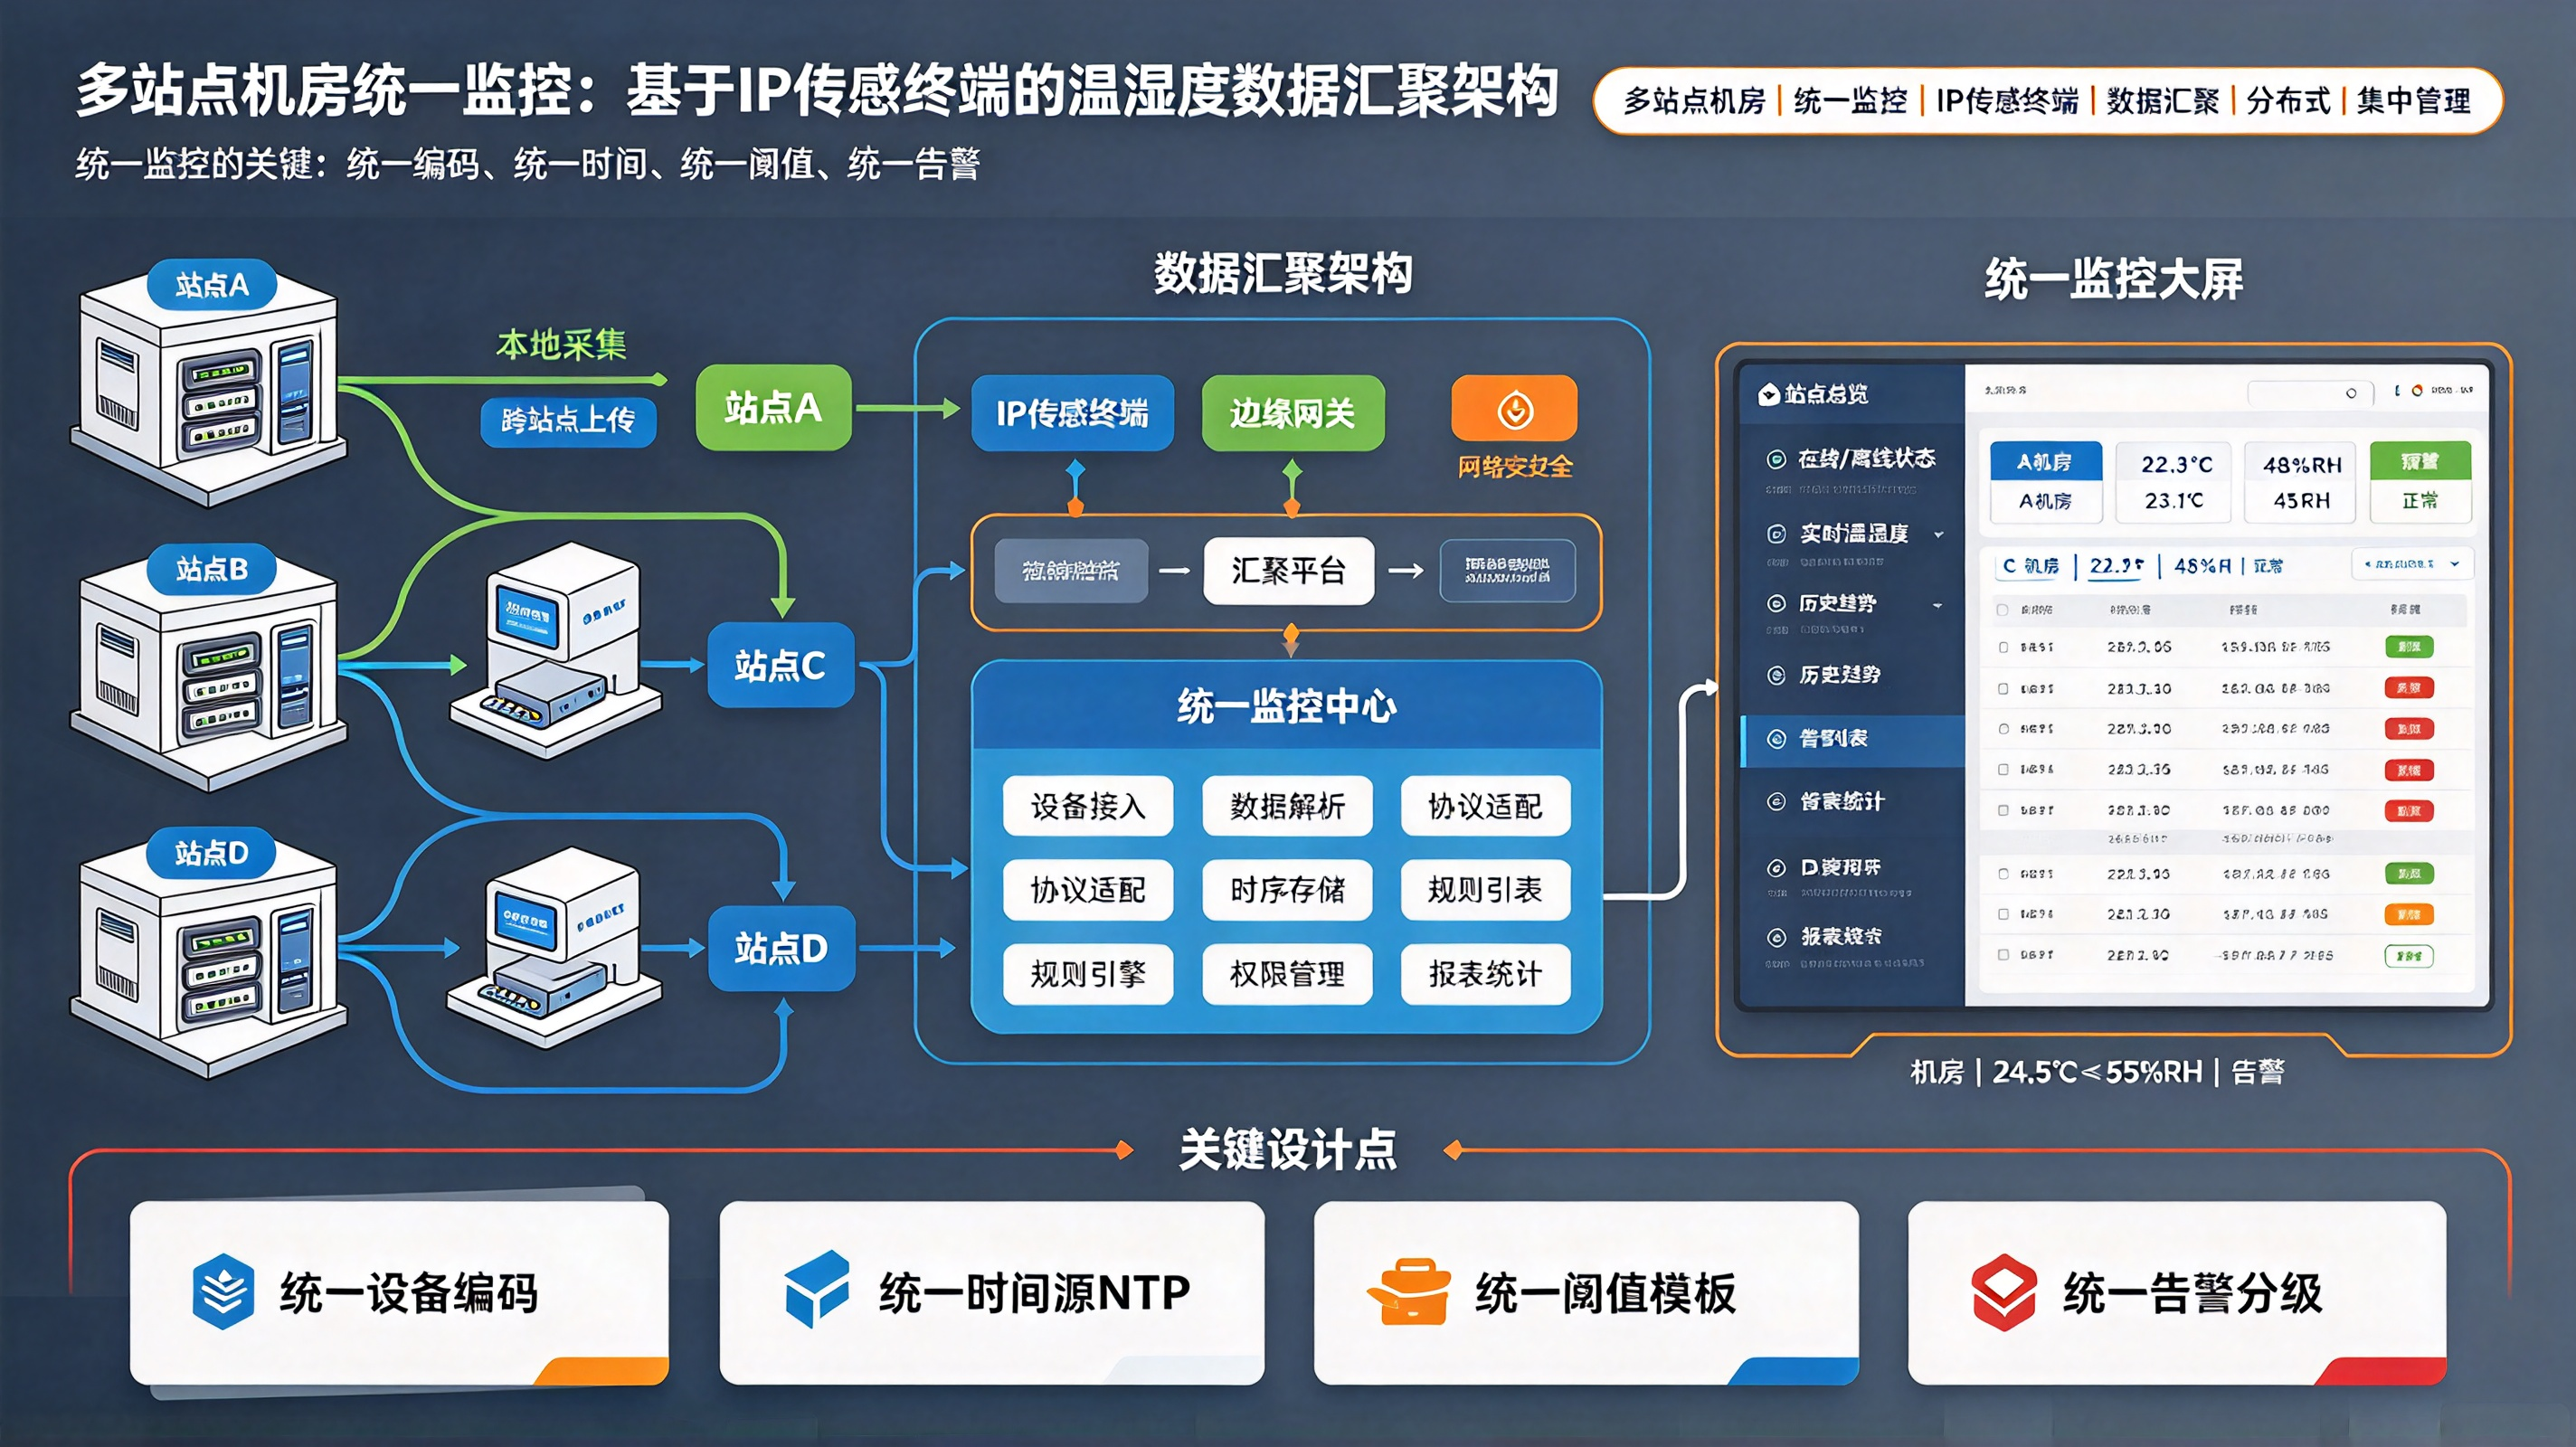
建设目标:构建一套统一监控平台,将所有站点的IP传感终端数据汇聚到中心节点,实现"一个平台管全部、一张地图看全局"。
二、IP传感终端的选型与部署
2.1 为什么选IP传感终端
对比项 | 传统RS485传感器 | IP传感终端(以太网) |
|---|---|---|
通信距离 | ≤1200米(需中继) | 无限制(走网络) |
布线成本 | 需单独拉485总线 | 复用现有网络(POE供电) |
协议 | Modbus RTU(串口) | Modbus TCP / SNMP / UDP上报 |
接入方式 | 需串口服务器/采集网关 | 直接接入网络,平台直连 |
扩展性 | 单总线≤32节点 | 理论上无限制 |
故障隔离 | 单点故障影响整条总线 | 单设备离线不影响其他 |
结论:IP传感终端天然适合多站点分布式部署,每个传感器就是一个网络节点,中心平台通过IP直接访问。
2.2 典型部署拓扑
中心监控平台(总部)
    │
    ├── VPN隧道/专线 ──→ 站点A(总部机房)
    │                      ├── 交换机 ── 传感器-01 (192.168.A.10)
    │                      ├── 交换机 ── 传感器-02 (192.168.A.11)
    │                      └── 交换机 ── 传感器-03 (192.168.A.12)
    │
    ├── VPN隧道/专线 ──→ 站点B(分公司机房)
    │                      ├── 传感器-04 (192.168.B.10)
    │                      └── 传感器-05 (192.168.B.11)
    │
    ├── 4G/5G ──→ 站点C(边缘节点)
    │                ├── 传感器-06 (10.0.C.10)
    │                └── 传感器-07 (10.0.C.11)
    │
    └── VPN隧道/专线 ──→ 站点D(灾备中心)
                         ├── 传感器-08 ~ 传感器-20
三、数据汇聚架构设计
3.1 架构总览
┌──────────────────────────────────────────────────────────────────┐
│                    中心监控平台(总部)                           │
│  ┌────────────┐  ┌────────────┐  ┌────────────┐  ┌──────────┐ │
│  │ 采集引擎    │→│ 时序数据库  │→│ 可视化引擎  │→│ 告警引擎  │ │
│  │ (多协议    │  │ (InfluxDB/ │  │ (Web/Grafana│  │ (阈值/   │ │
│  │  并发轮询)  │  │  TDengine) │  │  /大屏)     │  │  趋势)   │ │
│  └────────────┘  └────────────┘  └────────────┘  └──────────┘ │
│         │              │                │              │        │
│  ┌────────────┐  ┌────────────┐  ┌──────────────────────────┐ │
│  │ 站点管理    │  │ 设备管理   │  │ 用户权限 / 审计日志      │ │
│  │ (增删改查)  │  │ (注册/状态) │  │ (操作记录/登录审计)      │ │
│  └────────────┘  └────────────┘  └──────────────────────────┘ │
└──────────────────────────────────────────────────────────────────┘
3.2 采集引擎设计
核心挑战:站点数量多(几十到上百)、每个站点传感器数量不等(2~20个)、网络质量参差不齐(专线/VPN/4G)。
采集策略:
站点类型 | 网络质量 | 采集方式 | 采集间隔 | 超时策略 |
|---|---|---|---|---|
总部/核心机房 | 专线,稳定 | 同步轮询 | 10秒 | 3次重试 |
分支机构 | VPN,一般 | 异步轮询 | 30秒 | 2次重试 |
边缘节点 | 4G,不稳定 | UDP上报+心跳 | 60秒 | 离线告警 |
# collector.py - 多站点并发采集引擎(核心逻辑)

import asyncio
import aiohttp
from dataclasses import dataclass, field
from typing import Dict, List, Optional

@dataclass
class SensorNode:
    site_id: str
    sensor_id: str
    ip: str
    port: int = 502
    protocol: str = "modbus_tcp"  # modbus_tcp / snmp / udp_push
    timeout: int = 5
    last_seen: float = 0
    last_value: Optional[dict] = None
    online: bool = True

class MultiSiteCollector:
    def __init__(self, max_concurrent=50):
        self.nodes: Dict[str, SensorNode] = {}
        self.semaphore = asyncio.Semaphore(max_concurrent)
        self.running = False

    def register(self, node: SensorNode):
        key = f"{node.site_id}_{node.sensor_id}"
        self.nodes[key] = node

    async def _collect_modbus(self, node: SensorNode) -> dict:
        """Modbus TCP采集(使用aiohttp模拟,实际用pymodbus.async)"""
        async with self.semaphore:
            try:
                # 实际实现:pymodbus.client.AsyncModbusTcpClient
                # 这里简化为模拟数据
                import random
                await asyncio.sleep(0.1)  # 模拟网络延迟
                return {
                    'temperature': round(random.uniform(18, 28), 1),
                    'humidity': round(random.uniform(30, 65), 1),
                    'timestamp': asyncio.get_event_loop().time()
                }
            except Exception as e:
                node.online = False
                return {'error': str(e)}

    async def _collect_snmp(self, node: SensorNode) -> dict:
        """SNMP采集"""
        # 实际实现:asyncio.create_subprocess_exec调用snmpget
        # 或使用pysnmp async
        pass

    async def collect_one(self, key: str):
        node = self.nodes[key]
        if node.protocol == "modbus_tcp":
            result = await self._collect_modbus(node)
        elif node.protocol == "snmp":
            result = await self._collect_snmp(node)
        else:
            result = {'error': 'unsupported protocol'}

        if 'error' not in result:
            node.last_value = result
            node.last_seen = asyncio.get_event_loop().time()
            node.online = True
        return result

    async def collect_all(self):
        """并发采集所有节点"""
        tasks = [self.collect_one(key) for key in self.nodes]
        results = await asyncio.gather(*tasks, return_exceptions=True)
        return dict(zip(self.nodes.keys(), results))

    async def run_loop(self, interval=30):
        """主循环"""
        self.running = True
        while self.running:
            results = await self.collect_all()
            # 写入数据库(此处省略)
            await asyncio.sleep(interval)
3.3 网络连通方案
方案 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
IPsec VPN | 站点有固定公网IP | 安全性高、稳定 | 配置复杂 |
SD-WAN | 多站点、需要智能选路 | 自动故障切换、QoS | 成本较高 |
4G/5G DTU | 无固定网络 | 部署灵活 | 流量费用、延迟高 |
专线MPLS | 核心站点间 | 极稳定、低延迟 | 昂贵 |
反向SSH隧道 | 站点在内网无公网IP | 无需改网络配置 | 维护复杂 |
推荐组合:核心站点用IPsec VPN或专线,边缘节点用4G DTU+UDP上报模式。
四、数据存储与查询
4.1 数据模型
时序数据库设计(以InfluxDB为例):

Measurement: site_env
Tags:
  site_id     站点编号(如 "SITE_A01")
  site_name   站点名称(如 "北京总部")
  sensor_id   传感器编号
  zone        区域(如 "A区机柜列1")
Fields:
  temperature 温度(℃)
  humidity    湿度(%RH)
Timestamp:   采集时间

保留策略:
  raw_data    原始数据,保留90天
  downsampled 降采样(5分钟均值),保留3年
4.2 查询示例
// 查询所有站点当前温度状态
from(bucket: "site_env")
  |> range(start: -5m)
  |> filter(fn: (r) => r._measurement == "site_env" and r._field == "temperature")
  |> last()
  |> group(columns: ["site_id"])
  |> yield(name: "current_temp")

// 查询某站点过去24小时温湿度趋势
from(bucket: "site_env")
  |> range(start: -24h)
  |> filter(fn: (r) => r.site_id == "SITE_A01")
  |> aggregateWindow(every: 5m, fn: mean)
  |> yield(name: "trend")
五、可视化与告警
5.1 全局总览大屏
┌────────────────────────────────────────────────────────────────────┐
│  多站点机房统一监控平台                              [刷新: 30s]   │
├────────────────────────────────────────────────────────────────────┤
│                                                                    │
│  ┌─────────┐ ┌─────────┐ ┌─────────┐ ┌─────────┐ ┌─────────┐    │
│  │站点A     │ │站点B     │ │站点C     │ │站点D     │ │站点E     │ │
│  │北京总部   │ │上海分公司 │ │广州边缘   │ │成都灾备   │ │西安分支   │ │
│  │🟢 正常   │ │🟡 预警   │ │🟢 正常   │ │🔴 告警   │ │🟢 正常   │ │
│  │24.2℃    │ │26.8℃    │ │22.1℃    │ │31.5℃    │ │23.4℃    │ │
│  │48%RH    │ │52%RH    │ │45%RH    │ │68%RH    │ │50%RH    │ │
│  │12/12在线 │ │6/8在线   │ │4/4在线   │ │2/6在线   │ │3/3在线   │ │
│  └─────────┘ └─────────┘ └─────────┘ └─────────┘ └─────────┘    │
│                                                                    │
│  ┌──────────────────────────────────────────────────────────────┐  │
│  │ 温度趋势对比(近24h)                                        │  │
│  │  站点A ████████████████████ 22~25℃                          │  │
│  │  站点B ██████████████████████ 24~27℃                        │  │
│  │  站点C ██████████████████ 21~24℃                            │  │
│  │  站点D ██████████████████████████ 28~32℃ ← 异常             │  │
│  │  站点E ████████████████████ 22~25℃                          │  │
│  └──────────────────────────────────────────────────────────────┘  │
│                                                                    │
│  ┌──────────────────────────────────────────────────────────────┐  │
│  │ 告警列表(实时)                                              │  │
│  │ 🔴 站点D-传感器03 高温告警 31.5℃ (阈值28℃) 3分钟前          │  │
│  │ 🔴 站点D-传感器05 离线 15分钟前                              │  │
│  │ 🟡 站点B 湿度偏高 52%RH (阈值50%) 10分钟前                   │  │
│  └──────────────────────────────────────────────────────────────┘  │
└────────────────────────────────────────────────────────────────────┘
5.2 告警规则
告警级别 | 触发条件 | 通知方式 | 升级策略 |
|---|---|---|---|
INFO | 单传感器离线>5分钟 | 平台内通知 | 不升级 |
WARNING | 温度>26℃或湿度>55%持续10分钟 | 短信+平台 | 30分钟未确认→电话 |
ALARM | 温度>30℃或湿度>70%持续5分钟 | 短信+电话 | 15分钟未确认→升级到主管 |
CRITICAL | 温度>35℃或传感器离线>30分钟 | 短信+电话+声光 | 立即升级 |
六、可靠性与容灾
6.1 平台高可用
组件 | 高可用方案 |
|---|---|
采集引擎 | 双机热备,主备自动切换 |
时序数据库 | 集群模式(InfluxDB Enterprise / TDengine集群) |
前端服务 | Nginx负载均衡 + 多实例 |
网络 | 双链路(主用专线+备用4G) |
6.2 断网续传
断网场景处理:

站点端(传感器/网关):
  □ 本地缓存最近24小时数据(Flash/SD卡)
  □ 网络恢复后自动补传

中心端:
  □ 接收补传数据时按时间戳写入(不覆盖实时数据)
  □ 补传完成后触发数据完整性校验

关键代码逻辑:
  if network_available:
      send_realtime(data)
  else:
      local_cache.append(data)
      # 网络恢复后
      for cached in local_cache:
          send_realtime(cached)
      local_cache.clear()
七、典型坑
- 站点IP冲突:不同站点用了相同的内网IP段(都是192.168.1.x),VPN打通后路由混乱。解决:统一规划各站点IP段,或用NAT映射。
- 防火墙拦截:站点出口防火墙只允许80/443,Modbus TCP(502端口)被拦截。解决:改用HTTP上报或SNMP,或申请开放端口。
- 传感器时间不同步:各站点无NTP,时间戳偏差大。解决:中心平台收到数据时用接收时间覆盖,或部署NTP。
- 采集间隔设置过短:50个站点×10个传感器=500个并发连接,平台撑不住。解决:按站点分级设置采集间隔,边缘站点60秒以上。
- 未处理传感器IP变更:DHCP分配导致传感器IP变化。解决:传感器设静态IP,或DNS域名解析。
- 告警风暴:站点网络抖动导致所有传感器同时离线。解决:告警聚合+抑制,同一站点>50%传感器离线只发一条汇总告警。
- 数据库写入瓶颈:500个传感器每10秒写一次,InfluxDB写入队列堆积。解决:批量写入(每100条flush一次)+ 增加batch size。
- 站点命名不规范:site1/SITE_01/机房一混用。解决:建立统一编码规范(如SITE-城市-序号)。
- 忽略传感器固件版本管理:不同批次传感器协议有差异。解决:记录每个传感器的固件版本,解析时做版本适配。
- 平台单点故障:中心平台宕机后所有站点失联。解决:平台双活部署+异地灾备。
八、小结
多站点机房统一监控的核心在于"分布采集、集中管理"。IP传感终端天然适配这种架构——每个传感器即网络节点,通过VPN/专线/4G汇聚到中心平台。架构设计的关键是采集引擎的并发能力和网络容错,数据存储要选时序数据库并做好降采样,可视化要做到"全局一目了然、细节随时下钻",告警要做到分级通知和智能聚合。最终目标是让运维人员坐在总部就能掌握所有站点的环境状态,把被动抢修变成主动预警。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号