零基础用AI做出一份世界经济报告,全过程记录(附完整Prompt)
原创
零基础用AI做出一份世界经济报告,全过程记录(附完整Prompt)
原创
轻松悠悠
修改于 2026-10-10 16:50:50
修改于 2026-10-10 16:50:50
先看成果。
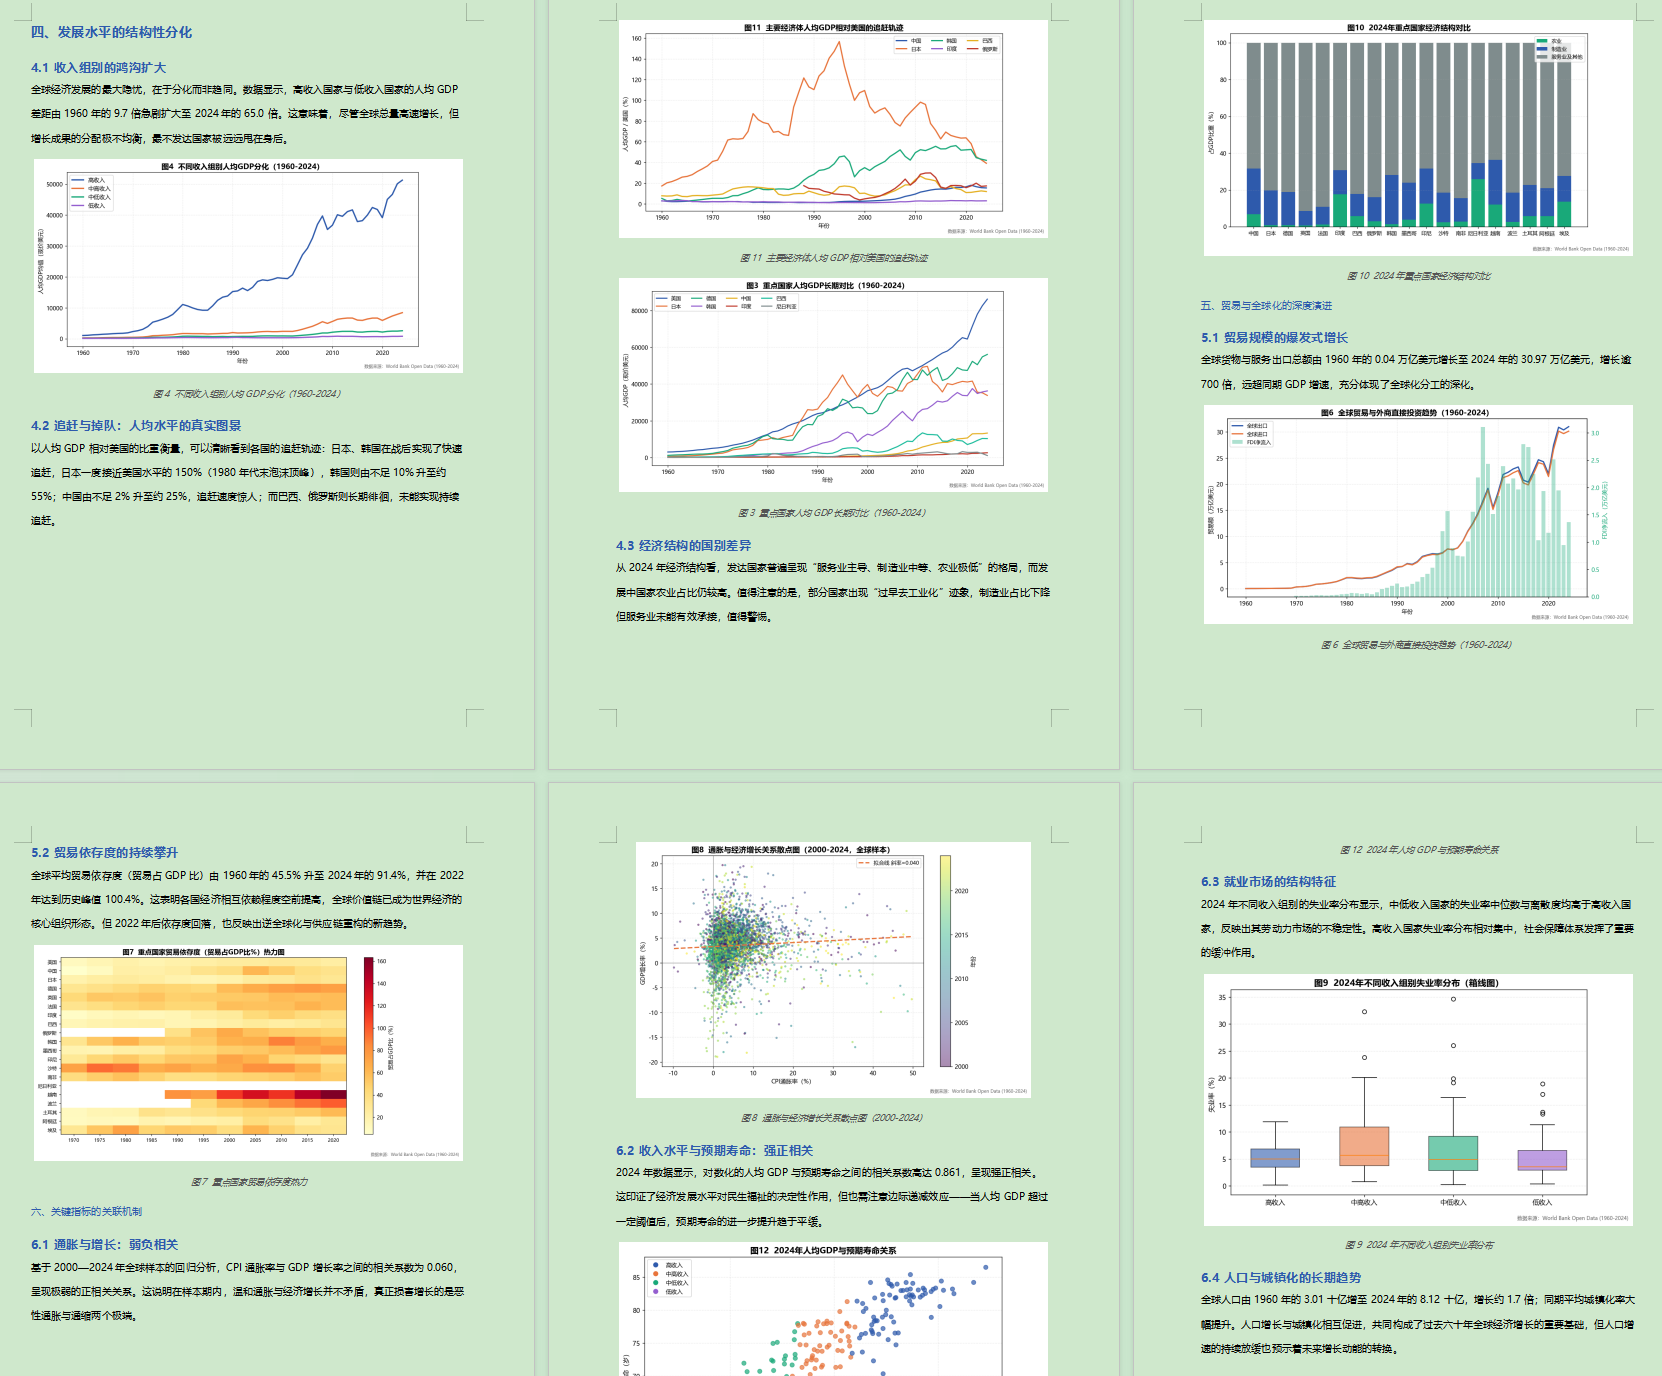
一份Word报告,覆盖世界银行1960到2024年数据,217个经济体、22项指标、202,708条记录,含15张图表。数据校验对上了官方口径:2024年全球GDP 110.62万亿美元、中国18.73万亿、美国29.30万亿。
附:完整Prompt
直接复制这段丢给AiPy(你可以选择你喜欢的智能体):
拉取世界银行60年数据,制作一份跨国经济报告,要求数据抓取到位、分析到位、逻辑严谨,最终输出一份包含大量图表的 Word 报告。
执行要求: 1. 明确报告范围与指标:从世界银行公开数据源(World Bank Open Data / World Bank API)拉取近60年(约1960年代至今)的跨国经济数据。需要覆盖的国家范围、核心经济指标(如GDP、GDP增长率、人均GDP、通胀、人口、贸易、失业率等)以及报告主题重点,若用户未指定则按合理默认执行:____(请补充:目标国家/地区范围);____(请补充:核心经济指标清单);____(请补充:报告主题与重点分析方向)。 2. 数据抓取:使用可用的数据获取能力(如通过 Trustoken-search 检索世界银行数据接口信息,或使用 aipy_builtin 执行 Python 代码调用世界银行 API / 下载数据集),确保数据来源真实、字段完整、时间跨度覆盖约60年。抓取后需做数据清洗与校验(缺失值、异常值、单位统一、国家代码标准化),并保存为本地数据文件(如 CSV/Excel)。 3. 数据分析:基于清洗后的数据开展跨国对比分析,包括但不限于趋势分析、国家间横向对比、分组/聚类、相关性分析、关键转折点识别等,确保分析逻辑严谨、结论有数据支撑。 4. 图表制作:生成尽可能丰富的可视化图表(折线图、柱状图、散点图、热力图、地图、堆叠图、箱线图等),覆盖时间趋势、国家对比、指标关系等维度,图表需有清晰标题、坐标轴、图例与数据来源标注。 5. 报告输出:将分析结论与图表整合为一份结构完整的 Word 报告(.docx),包含封面/标题、摘要、数据来源与方法说明、分章节分析、图表、结论与局限说明。报告文件需保存到本地并给出绝对路径。 6. 验证方式:确认数据文件已成功生成且记录数/时间跨度符合预期;确认 Word 报告可正常打开、图表已正确嵌入、章节逻辑完整;对关键结论做交叉核对。 7. 交付物:世界银行原始/清洗后数据文件、分析脚本、图表文件(如单独保存)、最终 Word 报告。
八个步骤
第一步,读懂需求。它先识别我发的策划图,判断出这是数据研判报告,自动定了口径——时间1960到2024年,国家200多个,指标22项。
第二步,探测数据源。试世界银行API通不通,确认能拿到数据。
第三步,批量抓取。按22个指标逐个调用接口。这里遇到过一次问题——API返回的国家代码是两位内部码,跟标准ISO3对不上,数据匹配失败。它自己发现了,改用正确字段重新抓。
第四步,清洗校验。国家代码标准化、剔除聚合体、去重、标记异常值、统一单位。然后校验:2024年全球GDP 110.62万亿、中国18.73万亿、美国29.30万亿,全部对上。
第五步,定量分析。算关键指标。
第六步,画图。15张图表,都是代码画的。
第七步,组装报告。整合成Word文档。
第八步,自检交付。验证文件完整性。
报告里的核心发现
全球GDP从1960年的1.28万亿美元涨到2024年的110.62万亿美元,增长86.6倍。
美国GDP份额从42.45%降到26.49%,中国从4.69%升到16.93%。G7从66.4%跌到44.9%,金砖从7.5%涨到24.6%。
高收入国家和低收入国家的人均GDP差距,从9.7倍扩大到65倍。
几个实用提示
需求描述越具体,结果越准。可以指定时间范围、国家范围、指标清单。
数据校验很重要。拿到结果后对一下官方口径。
这套方法可以套用到其他数据源。国家统计局、行业协会、公开财报都能用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号