当“更快“遇上“更脆“——DeepSeek V4.1 与 GLM-4.7/5.3 的复读与戒断,一场激进架构优化的系统性代价

当“更快“遇上“更脆“——DeepSeek V4.1 与 GLM-4.7/5.3 的复读与戒断,一场激进架构优化的系统性代价
安全风信子
发布于 2026-10-12 08:25:55
发布于 2026-10-12 08:25:55
作者: HOS(安全风信子) 日期: 2026-09-12 主要来源平台: GitHub(vllm-project/vllm Issue #38652、PR #45111/#48051/#43676、QwenLM/qwen-code Issue #4695、NousResearch/hermes-agent Issue #37255、musistudio/claude-code-router Issue #1378、baixiaoustc 故障复盘、AReaL grpo_series.md、Z.ai 博客、alphaxiv/DeepSeek-V4.1-Flash 摘要页、Unsloth 文档;全部关键事实于 2026-09-12 联网核实,未经核实细节已逐处标注【需核实】) 读完你能学到: 看懂 DeepSeek V4.1-Flash(CSA2/CED/FP4 KV)与 GLM-4.7/5.3(MLA/交错思考/后训练 RL 缩放)两条技术路线各自埋下的"复读"与"戒断"隐患及其数值根源;掌握 vLLM FP8 KV Cache × MLA 复读 Bug 的完整复现链、定位方法与三级防御配置;带走一套自研的 Agent 断路器脚本(DedupLoopBreaker)与模型选型体检清单。
目录- 先看问题场景
- 一、先把词定义清楚:什么是"复读",什么是"戒断"
- 1.1 两个词的工程定义
- 1.2 为什么 2026 年集中爆发
- 二、DeepSeek 路线:极致压缩的精度代价
- 2.1 一份纠偏声明:V4 系列与 V4.1 的架构关系
- 2.2 CSA2:把 KV 压到 890 字节/token 的三层手术
- 2.3 CED:非对称结构的另一种脆弱性
- 2.4 FP4 主 KV:一次被量化的赌博,以及它谨慎的那一面
- 2.5 复读机理推断:压缩注意力的误差广播链
- 2.6 工具调用复读:与精度无关的另一条独立风险线
- 2.7 DSpark 推测解码:效率第三级火箭的潜在干扰
- 三、GLM 路线:后训练缩放放大的稳定性问题
- 3.1 与 DeepSeek 相反的路线图
- 3.2 素材纠偏:GRPO、SAO 与 IcePop 的三角关系
- 3.3 FP8 KV Cache × MLA:一场教科书级的推理侧精度事故
- 3.4 RL"分布提纯":一种训练出来的确定性
- 3.5 戒断:交错思考的终止协议之困
- 四、合流:为什么两条路线会撞上同一堵墙
- 4.1 容错空间守恒
- 4.2 全景对照表
- 4.3 一个必须拆穿的误判:别把 Harness 的锅甩给模型
- 五、防御实战:三层防线与可复用代码
- 5.1 第一层:部署配置(成本最低,收益最大)
- 5.2 第二层:采样参数(分病因使用,别当安慰剂)
- 5.3 第三层:客户端断路器(Agent 场景的保命符)
- 5.4 上线前五问自检
- 六、趋势研判:这场竞赛会把我们带向哪里
- 6.1 判断一:量化与容错的矛盾会继续加深,但形式会从"裸奔"变成"带保险裸奔"
- 6.2 判断二:断路器会从"民间偏方"变成"Harness 标准件"
- 6.3 判断三:"复读体质"会成为模型选型的一等评估维度
- 6.4 给你的行动节奏
- 本文核心观点回顾
- 1.1 两个词的工程定义
- 1.2 为什么 2026 年集中爆发
- 2.1 一份纠偏声明:V4 系列与 V4.1 的架构关系
- 2.2 CSA2:把 KV 压到 890 字节/token 的三层手术
- 2.3 CED:非对称结构的另一种脆弱性
- 2.4 FP4 主 KV:一次被量化的赌博,以及它谨慎的那一面
- 2.5 复读机理推断:压缩注意力的误差广播链
- 2.6 工具调用复读:与精度无关的另一条独立风险线
- 2.7 DSpark 推测解码:效率第三级火箭的潜在干扰
- 3.1 与 DeepSeek 相反的路线图
- 3.2 素材纠偏:GRPO、SAO 与 IcePop 的三角关系
- 3.3 FP8 KV Cache × MLA:一场教科书级的推理侧精度事故
- 3.4 RL"分布提纯":一种训练出来的确定性
- 3.5 戒断:交错思考的终止协议之困
- 4.1 容错空间守恒
- 4.2 全景对照表
- 4.3 一个必须拆穿的误判:别把 Harness 的锅甩给模型
- 5.1 第一层:部署配置(成本最低,收益最大)
- 5.2 第二层:采样参数(分病因使用,别当安慰剂)
- 5.3 第三层:客户端断路器(Agent 场景的保命符)
- 5.4 上线前五问自检
- 6.1 判断一:量化与容错的矛盾会继续加深,但形式会从"裸奔"变成"带保险裸奔"
- 6.2 判断二:断路器会从"民间偏方"变成"Harness 标准件"
- 6.3 判断三:"复读体质"会成为模型选型的一等评估维度
- 6.4 给你的行动节奏
先看问题场景
2026 年 6 月 7 日,一位开发者让 Claude Code 执行一个再普通不过的任务:过滤一批无效数据。接下来发生的事情,他在复盘文章里写道:模型连续 30 多次执行完全相同的 python3 -c "import pandas as pd; ...",command 和 description 参数一字不差,输出永远是 61 rows, Y=2, N=27, unmarked=32。他打了两次 “stop”,模型置若罔闻,直到他说"升级 ClaudeCode"才把循环打破1。
同一天,另一个叫 OpenClaw 的客户端在同一个模型上出现了同样的症状。这位作者据此把矛头指向服务端——火山引擎托管的 DeepSeek V4.0 Pro。一周之后,qwen-code 的 Issue 区出现了第二个案例:50 轮工具调用循环,烧掉 8.9M input tokens,而且因为渠道侧每轮 cached_content_token_count=0,这些重复前缀被反复全价计费2。再往后,hermes-agent 的 Issue #37255 记录了更诡异的一幕:模型的 thinking 块里反复写着 “I need to stop. I’m going to just give the final answer now.”,但 action 层照样发起第 101 次代码执行3。
这不是 DeepSeek 一家的故事。把时间拨到 2026 年上半年,HuggingFace 的 unsloth/GLM-4.7-Flash-FP8-Dynamic 讨论区里,有用户报告:在 vLLM V1 引擎上加了 --kv-cache-dtype fp8,模型立刻开始输出无尽的 !!!!!!!!!!——同样的 prompt,去掉这个参数立刻恢复正常4。vLLM 官方仓库随后收到带完整基准数据的 Issue #38652:GLM-4.7-Flash 在 FP8 KV Cache 下多轮对话平均得分从 4.61 跌到 1.07(满分 5),而同样开 FP8 的 Qwen3-235B(标准 FlashAttention 架构)几乎无感——4.74 对 4.715。
一边是压缩注意力 + 激进量化的 DeepSeek 路线,一边是后训练 RL 极限缩放的 GLM 路线,两条路线在 2026 年不约而同地撞上了同一堵墙:模型的输出会退化成机械复读,或者 Agent 在工具调用后"戒断"——停不下来,或者停不下来得恰到好处。
我第一次系统性遭遇这个问题是在自己的 Agent 项目里:凌晨三点,一个跑批任务对着同一个接口连续调用了 214 次,每次参数只有最后一字节的差异,账单比平时高了一个数量级。当时我把锅甩给了"模型抽风",直到把 vLLM 的量化配置逐项排查完才发现:**复读不是玄学,它有精确的数值根源、清晰的触发路径和可复现的修复方法。**这篇文章就是那次排查的完整沉淀——用两个头部国产模型的技术报告和一批 GitHub Issue 原始数据,把"复读"与"戒断"从玄学拉回到工程学的讨论框架里。
本文使用对比驱动链展开:方案 A(DeepSeek 架构压缩)vs 方案 B(GLM 后训练缩放)→ 各自的失效模式解剖 → 适用场景 → 选择建议 → 避坑指南。所有技术细节标注来源,无法核实的细节逐处标注【需核实】;涉及机理演绎的地方,我会明确写出"这是作者的推断",绝不把假说伪装成事实。
一、先把词定义清楚:什么是"复读",什么是"戒断"
本节核心收获: 用一句话区分两个容易混淆的失效模式,并建立一个贯穿全文的分析坐标——复读是"输出的熵坍塌",戒断是"终止信号的失灵",两者的工程防御手段完全不同。
1.1 两个词的工程定义
全网讨论这两类故障时用词很随意:“死循环”、“复读机”、“鬼打墙”、“无限输出”。为了让后文的分析有的放矢,先给两个词一个工程定义:
复读(Repetition Loop):模型在生成过程中陷入对已有内容(或特定 token 片段)的无限重复,输出分布的熵坍塌到极低值,采样无法逃逸。典型表现:
!!!!!!!!!!、重复单词、逐字重复的代码块。它发生在单次生成的 token 流内部。 戒断(Termination Failure):模型已经完成了任务目标(或 thinking 层已经"意识到"该结束),但生成流无法在正确位置终止——要么在工具调用后继续发起无意义的调用,要么把本该闭合的回复无限延长。它发生在"步与步"之间,是 Agent 循环层面的失效。
这个区分不是文字游戏,因为它直接决定排查方向:
维度 | 复读 | 戒断 |
|---|---|---|
失效层面 | token 级(单次生成内部) | 步级(Agent 循环 / 对话轮次间) |
数值根源 | 输出分布熵坍塌、量化误差累积 | 终止 token 概率被压制、状态机错位 |
典型触发 | FP8/FP4 量化、长上下文累积 | 工具调用协议缺陷、思考模式边界 |
首选防御 | 修量化配置、调采样参数 | 客户端断路器、修协议回传 |
错误防御 | 加大 max_tokens(火上浇油) | 调 repeat_penalty(南辕北辙) |
**一句话记住:复读治"生成",戒断治"循环"——下错药,症状只会更重。**后文第二章讲 DeepSeek(两类都有),第三章讲 GLM(复读为主、戒断为辅),第四、五章给防御方案。
1.2 为什么 2026 年集中爆发
这两个失效模式并不新鲜——GPT-2 时代就有 the the the the 的经典复读案例。但 2026 年集中爆发,是因为两条技术路线在同一个时间窗口内做了同一件事:把输出分布的"容错空间"压到了极限。
- DeepSeek 路线:为了把百万 token 上下文的经济性做出来,把 KV Cache 压到 890 字节/token,用 MXFP4 量化主 KV——精度空间被主动压缩;
- GLM 路线:为了让 Agent 能力跃升,在 743B 基座上做后训练 RL 极限缩放,Terminal-Bench 3.0 分数一年内从 4.6 拉到 28.3——行为分布被主动"提纯"。
前者压缩的是数值容错空间,后者压缩的是行为容错空间。复读和戒断,就是这两类压缩越界之后的账单。接下来两章,我们逐项拆解。
二、DeepSeek 路线:极致压缩的精度代价
本节核心收获: 看懂 V4.1-Flash “CSA2 + CED + FP4 KV” 三件套各自的压缩原理与数值脆弱点,理解为什么压缩注意力对量化误差零容忍,以及工具调用复读与推测解码的两条独立风险线。
2.1 一份纠偏声明:V4 系列与 V4.1 的架构关系
在展开之前,先纠正一个流传甚广的混淆(包括本文写作所依据的大纲初稿也踩了这个坑):
【纠偏】"DeepSeek V4 = CSA + HCA 混合压缩注意力,V4.1 Flash 是它的升级"这一表述不准确。根据 2026-09-10 发布的官方技术材料6:
- DeepSeek-V4(上一代)采用 CSA(Compressed Sparse Attention,每 m 个 token 压缩为一个 KV 条目 + Top-k 索引)+ HCA(Heavily Compressed Attention,更激进压缩) 的混合架构——这一表述属实;
- DeepSeek-V4.1-Flash(2026-09-10 发布,552B 骨干参数 MoE,1M 上下文)恰恰是把 CSA+HCA 混合架构砍掉,改用纯 CSA2(Compressed Sparse Attention 2),主打跨层 KV 复用,全局 KV 压到 890 字节/token,约为 V4-Flash 的 1/4、初代 V1 的 1/437。
这个纠偏不是抠字眼——因为 V4 与 V4.1 的"复读风险画像"并不相同:V4 的混合压缩路径更多、压缩更激进;V4.1 反而把压缩方向收拢到了"层维度"这一条主轴上,并在量化方案上做了更谨慎的选择(2.4 节展开)。分析失效风险,必须对准具体版本,不能拿"DeepSeek V4 系列"一锅烩。
2.2 CSA2:把 KV 压到 890 字节/token 的三层手术
V4.1-Flash 的技术报告把 KV 成本拆成一个乘法公式6:
V4 的 CSA/HCA 主攻前两项(把多个 token 压成一个条目、把条目压得更小),V4.1 的 CSA2 则把主战场移到第三项——层维度复用。每一层被静态指派三种模式之一67:
模式 | 行为 | 开销 |
|---|---|---|
Full | 完整计算自身主 KV,投影 indexer K,生成新的 Top-512 稀疏索引 | 最重 |
Reindex | 复用上一个 Full 层的主 KV 和 indexer K,但用自己的 indexer Q 重新打分选新 Top-K | 中等 |
Reuse | 直接继承主 KV 和 Top-K 索引,完全跳过索引计算 | 最轻 |
配比上,编码器 18 层 CSA2 按"1 Full + 5 Reuse"分 3 组;解码器 20 层中,首组"1 Full + 3 Reuse",其余 4 组"1 Reindex + 3 Reuse"6。也就是说,绝大多数层根本不计算自己的 KV——它们"信任"前面某一层算出来的结果。
这个设计的数值含义值得每个工程师停下来想十秒:当 5 层共享同一份 KV 时,这份 KV 的任何数值误差都会被原样复制到 5 层的注意力计算里——压缩换来的不是"误差分摊",而是"误差广播"。这就是 2.5 节复读机理的第一块拼图。
2.3 CED:非对称结构的另一种脆弱性
第二个构件是 CED(Causal Encoder-Decoder,因果编码器-解码器):40 层 Transformer 切成前 20 层因果编码器 + 后 20 层解码器,解码器的全局 KV 不再由各层自己的隐状态导出,而是从编码器最后一层的隐状态经投影直接得到(思路源自 YoCo——You Only Cache Once)67。收益是 prefill 复杂度近乎减半,输入端每 token 只激活 8B 参数(解码端 16B),精准匹配 Agent 场景"输入重、输出轻"的负载特征。
但注意这个结构的隐含假设:解码器的全部"记忆"都来自编码器最后一层的那一个投影。编码器侧任何一点数值扰动,都会经过这个单点投射、无衰减地进入解码器的每一步生成。用信号系统的话说:这是一个单级联系统,中间没有隔离级。它跑得快,但它把"编码器精度"提升成了"全系统命门"。
2.4 FP4 主 KV:一次被量化的赌博,以及它谨慎的那一面
然后是最关键的量化决策。V4.1-Flash 把主 KV Cache 压到 MXFP4(OCP 标准,E2M1)+ 每 16 通道一个 E4M3 scale6。这里必须公平地指出:DeepSeek 在这一步的表现是审慎的,官方技术材料给出了三点防御性论证6:
- 动态范围余量论证:RMSNorm 后 512 维 latent 的 L2 范数上界约为
,实测最大幅度仅约 10;而 E2M1 配合 scale 可表示的上界高达 211 ≈ 2048(比 22.6 高出近两个数量级)——动态范围余量充足;
- QAT(量化感知训练)兜底:FP4 不是推理侧后处理,而是通过后训练阶段的量化感知训练引入,模型在训练中就"见过"量化噪声;
- 敏感度分级:对量化更敏感的 SWA(滑动窗口)KV 保留 FP8,不跟主 KV 一起上 FP4。
**这个分级恰恰暴露了问题:官方自己承认"不同位置的 KV 对量化的容忍度不同"——那么"压缩注意力架构对精度极其敏感"就不再是社区传言,而是写进官方设计权衡的前提。**压缩架构在精度上能省的每一分钱,都是从容错空间里预支的。
【架构决策对照 · 来源整理】
来源项目:DeepSeek-V4.1-Flash 技术报告(alphaxiv 摘要页 2609.deepseek-v4-1-flash,2026-09-10)
整理:HOS(安全风信子),2026-09-12

主 KV Cache   → MXFP4 (E2M1) + 每16通道 E4M3 scale   ← QAT 兜底,动态范围论证
SWA KV Cache  → FP8(保守保留)                       ← 官方承认敏感度高
索引器        → 候选池训练/推理一致(16384 候选)      ← 主动消除 train/test mismatch
残差流        → Single-Pass mHC(数值稳定性修正)      ← 承认深层残差有数值稳定性问题
顺带把 mHC(流形约束的超连接)放回正确的位置:素材大纲把 mHC 列为"修正深层残差连接数值稳定性的手段",这个表述方向正确,但要点在于——它的存在本身就是证据:当模型深到必须动用流形几何约束来"扶住"残差流的数值稳定性时,整个系统的数值余量已经薄到需要专门部件来维护的程度6【mHC 具体数学形式以官方技术报告为准,需核实】。
2.5 复读机理推断:压缩注意力的误差广播链
把前三节的构件拼起来,就能得到一条完整的失效链条。先声明:以下机理是作者的演绎推断,用于组织排查思路,非官方结论——目前没有 DeepSeek 官方文档描述复读 Bug 的内部机理。
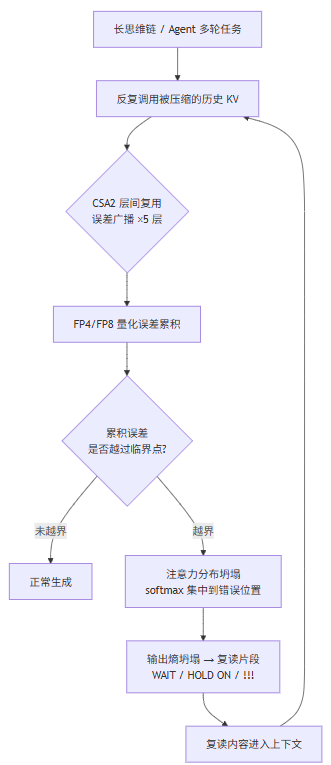
链路上有两个正反馈回路,这是复读"一旦开始就停不下来"的原因:
- 压缩回环:复读内容作为新生成 token 进入上下文 → 下一步注意力要调用的"历史"里混入了垃圾 → 进一步污染压缩后的 KV → 更严重的坍塌;
- 终止信号淹没:正常情况下,模型靠"下一个 token 是 EOS/终止符"的概率峰值结束生成。当注意力分布坍塌时,生成被"惯性最大的高频片段"接管,EOS 的概率峰值被淹没——复读和"停不下来"在这条链上是同一个病灶的两个症状。
社区佐证:开发者社区(DeepSeek Harness 相关讨论)流传的说法是"deepseek 这种 CSA+HCA 架构对精度极其敏感,就是容易出这种复读精度 bug"。该说法来自社区讨论,非官方背书,原文出处与发帖时间【需核实】——但它的方向与 2.4 节官方自己的敏感度分级设计相互印证:官方在 SWA KV 上退回 FP8 的决定,说明"精度敏感"是 DeepSeek 内部已知且正在管理的风险。
2.6 工具调用复读:与精度无关的另一条独立风险线
如果说 2.5 节是"数值病",那么工具调用复读就是"协议病"——它不依赖量化配置,任何精度下都会发生。2026 年 6 月的三份独立记录拼出了完整画像:
来源 | 现象 | 关键数据 |
|---|---|---|
baixiaoustc 复盘1(2026-06-08) | Claude Code 与 OpenClaw 两个独立客户端同时陷入 30+ 次相同工具调用,两次 “stop” 无效 | 现象稳定复现,作者自评根因置信度 95%(推测性结论) |
qwen-code Issue #46952(2026-06-02 前后) | deepseek-v4-pro 在工作上下文窗口内坍缩为重复的相同 tool_call,客户端无熔断 | 50 轮循环,8.9M input tokens,且 cached_content_token_count=0 导致全价重计费 |
hermes-agent Issue #372553 | thinking 块反复声明 “I need to stop”,action 层照样发起第 100+ 次 execute_code | thinking/action 不一致:推理层已识别终止条件,动作解码器卡死在工具调用模式 |
三份记录指向同一个结构性事实:当模型进入"工具调用决策"这一特殊解码模式时,存在一种与内容质量无关的循环陷阱。baixiaoustc 给出的假说是"隐式任务完成度评分卡在阈值边界"(例如 unmarked=32 恰好落在未完成一侧),导致模型每一轮都做出"任务还没完成 → 再调一次工具"的决策1;hermes-agent 的维护者则定位为"thinking/action 不一致"3。两种解释细节不同,但结构相同:决策循环缺少一个与内容无关的、确定性的终止出口。
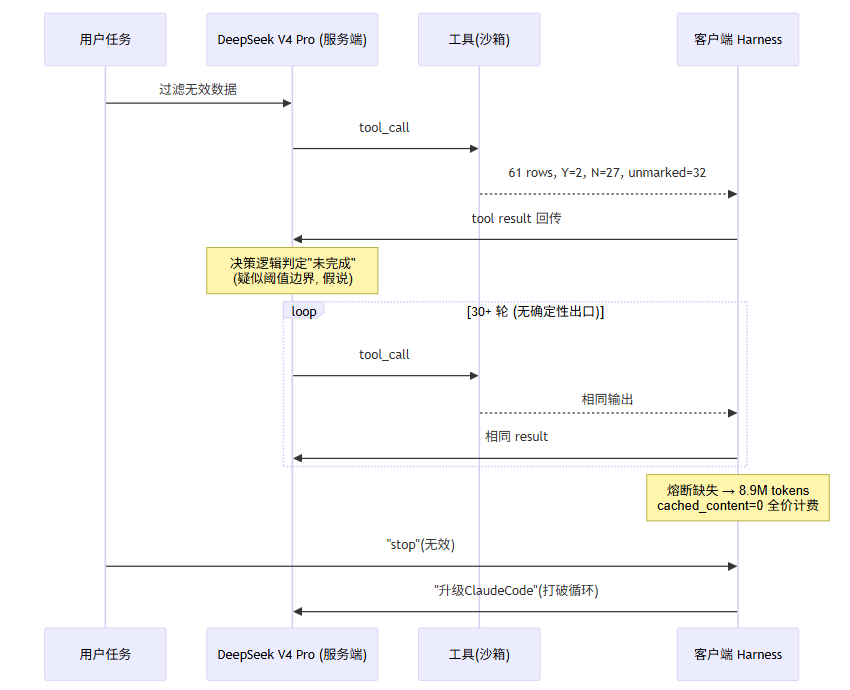
这解释了为什么"复读"会呈现两种完全不同的面目:纯文本场景的复读是数值病(2.5 节),Agent 场景的复读是协议病(本节)——前者修量化,后者修 Harness。混为一谈的排查,注定两边都修不好。
2.7 DSpark 推测解码:效率第三级火箭的潜在干扰
V4 系列的效率优化还有第三级火箭:DSpark 投机解码(草稿-验证范式,官方宣称提速 60%-85%)6。它的原理是让一个小的草稿模型先猜若干 token,主模型并行验证,验证通过就整段采纳。
素材大纲提出一个担忧:推测解码对验证精度要求极高,在 CSA/HCA 这种精度敏感架构上叠加,可能引入额外的数值不一致,干扰生成终止信号。这个担忧方向合理,但我必须标注证据等级:目前没有公开 Issue 或官方文档证实 DSpark 引发过复读,且 V4.1 的 DSpark 采用了"骨干冻结、单独训练草稿器 + 置信度调度验证"的保守设计6。所以本节的结论是一条观察项而非结论项:如果你的复读案例恰好只出现在开启投机解码的部署形态上,把 DSpark 加入排查矩阵的第一层——关掉它复测一次,成本几乎为零。
DeepSeek 小结:CSA2 的误差广播、CED 的单点投射、FP4 的量化赌注(带 QAT 与分级保护)、工具调用的协议陷阱、DSpark 的待观察项——五条线索里,前两条是架构固有属性,第三条有官方防御但余量未知,第四条已被三个独立来源实锤,第五条存疑待查。给它们排好优先级,排查时才不会先去调
repeat_penalty这种安慰剂参数。
三、GLM 路线:后训练缩放放大的稳定性问题
本节核心收获: 看懂 GLM-4.7/5.3 "交错思考 + 后训练 RL 极限缩放"如何系统性收窄输出分布的容错空间,掌握 FP8 KV Cache × MLA 复读 Bug 的完整证据链(含官方 benchmark 数据),以及一条重要的素材纠偏:IcePop 并不在 GLM 的技术栈里。
3.1 与 DeepSeek 相反的路线图
如果说 DeepSeek 的能力叙事是"把架构压到极限",GLM 的能力叙事就是"把训练压到极限"。两者在 2026 年的产品矩阵如下(版本信息以官方发布为准,均为 2026-09-12 联网核实):
产品 | 关键规格 | 能力叙事 |
|---|---|---|
GLM-4.7 | 355B 总参 / 32B 激活的 MoE;Flash 版 30B【规格为社区整理,官方模型卡为准,需核实】 | 交错思考:推理与工具调用交替进行,服务 Agentic 工作流 |
GLM-5.2 → 5.3 | 同一 743B MoE 基座(约 40B 激活),架构与上下文窗口不变 | 后训练缩放:全部增益来自 RL 规模扩大 |
GLM-5.3 的官方博客开场白是一句值得裱起来的话:“Scaling post-training is all we did for GLM-5.3.”8——在完全相同的基座上,只靠扩大后训练 RL 的规模(数十倍的长程任务环境、更长的训练时间),Terminal-Bench 3.0 从 4.6 拉到 28.3(约 6 倍),DeepSWE v1.1 从 46.2 到 66.9,底层是 IndexShare(长上下文高效处理)+ SAO(长程任务 RL 算法)+ slime(异步 RL 框架) 三件套,端到端 RL 吞吐提升超过 2.3 倍8。
这是一次几乎完美的对照实验:基座冻结,唯一变量是后训练。正因为变量干净,它也干净地暴露了后训练缩放的副作用——这是 3.4 节的主题。
3.2 素材纠偏:GRPO、SAO 与 IcePop 的三角关系
原文素材称"GLM-5 的 RL 算法基于 GRPO,并引入 IcePop 技术来缓解训练与推理之间的分布不匹配"。这里必须做一次三层纠偏,因为这三个词代表三条不同团队、不同体系的技术线:
【纠偏】
- GRPO 在 GLM-5.3 的长程 Agent RL 中恰恰是被放弃的方案。GRPO 的组式同步采样要求同 prompt 的 N 条轨迹全部完成才能更新,而 Agent 任务轨迹长度差异达数十倍,GPU 空转、离策略偏差放大、熵坍塌接踵而至。GLM 采用的 SAO(Single-Rollout Asynchronous Optimization,清华 KEG,arXiv:2607.07508) 反其道而行:单轨迹即时更新 + 重新请回 Actor-Critic 价值网络 + DIS 双向 token 级重要性采样(训推概率比越出信任域的 token 直接从梯度中屏蔽)。论文数据:普通 GRPO 约 160 步崩溃,SAO 可稳定训练约 1000 步9。
- IcePop 不属于 GLM 技术栈。它是蚂蚁集团 InclusionAI 的工作(arXiv:2510.18855),服务于 Ring-1T 万亿参数 MoE 的 RL,在 AReaL 框架中以
metric=ratio配置启用:对训推 token 概率比设固定双侧区间(默认 [0.5, 5.0]),区间外 token 的策略梯度直接归零10。 - 但两者的思想确实同族:SAO 的 DIS 与 IcePop 都属于"冻结过大训推概率比 token 的梯度"这一族方法(与 TIS 的"调权继续学"相对)。素材把两者并置,机制直觉是对的,归属搞错了。
这次纠偏对本文主题有实际意义:GLM 的训练侧已经开始用"硬屏蔽"的方式对抗训推数值不一致——他们比谁都清楚,这套 Agent RL 的数值链条有多脆弱。训练侧管住了概率比,推理侧的量化配置却没人管(直到 3.3 节的 FP8 事故),这正是同一条数值脆弱性在两个环节的两次显形。
3.3 FP8 KV Cache × MLA:一场教科书级的推理侧精度事故
现在看 GLM 路线最实锤、证据链最完整的一个复读案例。这是全文技术含金量最高的一节,建议逐行读完。
症状:vLLM V1 引擎 + --kv-cache-dtype fp8,GLM-4.7-Flash 多轮对话立即进入无限重复循环(!!!!!!!!!! 或同一单词无尽重复);单轮对话正常;--kv-cache-dtype auto 立即恢复正常4。
证据链(全部可点开复核):
- HuggingFace unsloth/GLM-4.7-Flash-FP8-Dynamic Discussion #24:H200 + vLLM V1,开启 FP8 KV 立即复现,报告者定性为"FP8 权重 × FP8 KV Cache × V1 引擎 FlashMLA 实现的交互数值稳定性问题";维护者回复"先用 auto,我会继续查";
- zai-org/GLM-4.7-Flash Discussion #4811:独立用户用 bf16 权重(排除权重量化变量)+
--kv-cache-dtype fp8(TP=4, H200)复现同一症状——锁死变量是 KV Cache 量化,不是权重; - vLLM Issue #386525:带 20 个多轮场景、Llama-3.3-70B 裁判的对照基准,这是关键一击——
模型 | KV Cache | 平均得分(满分 5) |
|---|---|---|
GLM-4.7-Flash (BF16) | FP16 基线 | 4.61 |
GLM-4.7-Flash (BF16) | FP8 | 1.07 |
Qwen3-235B AWQ(对照) | FP16 基线 | 4.74 |
Qwen3-235B AWQ(对照) | FP8 | 4.71 |
注意对照的意义:Qwen3-235B 是标准 FlashAttention/GQA 架构,FP8 开与不开几乎无差(4.74 → 4.71);GLM-4.7-Flash 崩到 1.07。变量隔离至此完成——问题不在 FP8 本身,在 FP8 × MLA 的组合。
根因(Issue #38652 报告者的分析,与 FlashMLA 实现行为一致):vLLM 的 FLASHMLA 后端把 FP8 量化施加在 MLA 的潜在向量(kv_c_normed)上,缺乏逐张量的校准缩放(per-tensor scaling);量化误差随上下文增长逐轮累积——这精确解释了"单轮正常、多轮崩溃"的症状指纹5。vLLM 自己的日志警告也承认:“FP8 KV cache may cause accuracy drop without a proper scaling factor.”
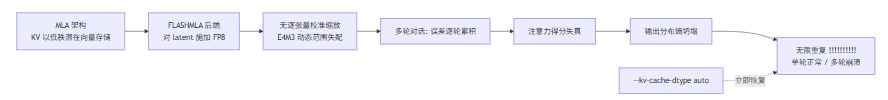
一个反直觉的排查教训:社区里流传的缓解方法是"关闭重复惩罚(repeat_penalty=1.0)"或调 temperature=1.011。必须说清楚:这些采样参数调整对 FP8 量化型复读基本无效——你的输出分布已经被数值噪声推到了错误的区域,惩罚重复 token 只是在错误的分布上做表面功课。它们真正有效的场景是 llama.cpp 路径上另一类复读(Unsloth 文档记载的 scoring_func: softmax 配置错误,应为 sigmoid,该 Bug 导致循环输出,GGUF 文件已于 2026-01-21 更新修复12)。同一种症状,两套病因,两套药方——这就是本文第一章坚持先分类再排查的原因。
3.4 RL"分布提纯":一种训练出来的确定性
3.3 节是推理侧的事故,本节回到训练侧。以下机理分析是作者的演绎,基于 GLM-5.3 官方博客披露的训练事实做合理外推,非官方结论。
GLM-5.3 的 6 倍提升来自"长周期环境中的大规模 RL":任务不再是习题,而是"相当于资深工程师数天工作量"的沙箱——拿到集群、存储、内部文档、代码库,自行诊断并交付可测量的结果8。RL 的奖励结构天然偏好能够连续、稳定执行长步骤序列的策略:一个 600 轮里步骤连贯的策略拿到高分,一个步骤跳跃但同样解题的策略拿不到。
于是出现一个微妙的训练效应——我称之为分布提纯:
大规模长程 RL 像一个超高倍率的过滤器,把输出分布中"发散的、探索性的、非模板化"的成分逐步洗掉,留下"确定性最强、步骤最连贯"的行为模式。这在基准测试上是纯收益(分数 6 倍),但在分布偏移时是纯负债:被提纯后的分布,遇到训练分布之外的输入,退化的方向不是"灵活纠错",而是"更用力地重复模板"。
三个旁证让这个推断不至于悬空:
- 官方自己承认的遗忘对抗:GLM-5.3 的 OPD(在线策略蒸馏)被明确用于"对抗多轮 RL 后的灾难性遗忘",把各阶段模型当多教师做"复习"8——说明多轮 RL 确实在系统性侵蚀模型行为的多样性,官方用工程手段在补;
- SAO 论文的熵坍塌警告:SAO 的 DIS 机制(屏蔽越界 token 梯度)要解决的核心问题之一就是长程 RL 的熵坍塌9——训练侧需要专门机制防止分布坍塌,本身就说明坍塌压力真实存在;
- 社区实测的重复惩罚敏感性:GLM-4.7 社区报告"关闭重复惩罚可解决部分复读"11——如果输出分布没有被 RL 推得过于尖锐,
repeat_penalty=1.0不至于成为"部分有效"的民间偏方【该参数效应为社区 anecdote,无对照实验,需核实】。
必须公平地补一句:分布提纯是收益与风险的同一次交易,不是设计失误。GLM-5.3 用它换来了 Terminal-Bench 3.0 上 28.3 分、token 效率亮点(Z.ai Code Bench 31.4% 只花约 50K 输出 token,Claude Opus 4.8 花 120K 才到 29.5%)8。工程师要做的不是否定这笔交易,而是在部署时知道自己的模型带着什么样的"出厂体质"。
3.5 戒断:交错思考的终止协议之困
GLM 路线的戒断问题集中在"交错思考"(interleaved thinking)模式上:推理过程与工具调用交替进行。这个设计对 Agentic 工作流是能力增益,但它引入了新的失败面——思考模式与工具调用的边界协议。
素材记录的案例:GLM-4.7 Flash 在工具调用后停止生成(该终止而不终止的变体),在 Ollama 上需要大幅增加 max_tokens(如 40,000)才能恢复【原始社区讨论出处需核实】。Unsloth 的 GLM-4.7-Flash 文档则记录了一个更可定位的同域问题:llama.cpp 侧 scoring_func 配置错误(softmax vs sigmoid)导致循环与劣质输出12——再次印证:"边界模糊"的锅,有时在模型行为,有时在推理框架的配置;先查配置,再怪模型。
与 DeepSeek 的戒断对比一下,会发现结构性差异:
DeepSeek 戒断(2.6 节) | GLM 戒断(本节) | |
|---|---|---|
失效位置 | 工具调用决策循环缺确定性出口 | 思考/工具交替的终止协议 |
症状 | 停不下来,重复相同调用 | 该停不停 / 提前停死 |
已验证根因 | thinking/action 不一致3、完成度阈值假说1 | 推理框架配置错误12、协议缺陷【需核实】 |
防御重心 | 客户端断路器(第五章) | max_tokens 预算、解析器配置核查 |
GLM 小结:一条推理侧的实锤事故(FP8 × MLA,有官方 benchmark)、一条训练侧的机制推断(分布提纯,有三条旁证)、一条协议侧的边界问题(交错思考,部分需核实)。证据等级从强到弱,排查时也应该按这个顺序消耗你的排查预算。
四、合流:为什么两条路线会撞上同一堵墙
本节核心收获: 把两条路线的五个失效点放进一个统一框架——“容错空间守恒”,并给出一张可直接用于选型与部署决策的对照表。
4.1 容错空间守恒
把前两章的发现抽象一层,我会用这样一个框架来统一解释(这是作者的分析框架,非任何一方的官方表述):
容错空间守恒:模型的输出行为分布存在于一个"容错空间"里——空间越大,数值噪声、分布偏移、协议抖动可以被吸收,输出依然正常;空间越小,同样的扰动会直接把系统推出稳定区。2026 年的效率竞赛,本质上是一场各方都在主动出售容错空间、换取速度/规模/分数的竞赛——DeepSeek 卖给 KV 压缩,GLM 卖给 RL 分数,推理框架(FP8 KV)再从下游刮走一层。
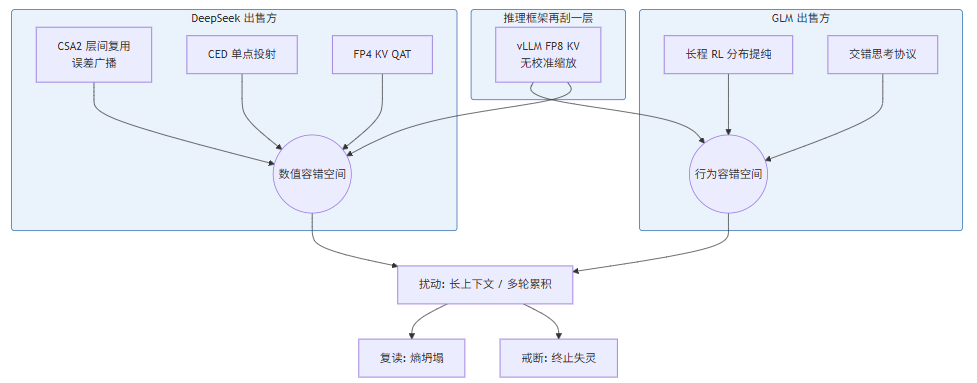
这个框架的价值在于预测性:任何"更快、更省、更强"的新版本发布时,你可以直接问三个问题——它出售了哪种容错空间?出售了多少?配套的防御(QAT、分级量化、DIS、OPD)补回了多少?三个问题问完,新版本的"复读/戒断体质"基本可以预判,不必等凌晨三点的账单来教你。
4.2 全景对照表
维度 | DeepSeek(V4 / V4.1-Flash) | GLM(4.7 / 5.2-5.3) |
|---|---|---|
架构核心 | 纯 CSA2 跨层 KV 复用(V4.1 砍掉 V4 的 CSA+HCA 混合)【纠偏后表述】 | MoE + 交错思考(推理/工具交替) |
效率手段 | MXFP4 主 KV(QAT)+ CED 非对称 + DSpark 投机解码 | 推理侧 FP8 KV Cache(部署选项)+ 训练侧 RL 吞吐优化 |
能力来源 | 架构压缩 + 1M 上下文经济性 | 后训练 RL 极限缩放(基座冻结) |
训练侧防坍塌 | mHC 数值稳定性、SWA KV 保留 FP8 | SAO/DIS 熵保护、OPD 抗遗忘 |
复读实锤 | 工具调用循环(3 个独立 Issue)123 | FP8 KV × MLA 多轮崩溃(benchmark 1.07/5)45 |
复读推断 | 压缩注意力精度敏感(官方敏感度分级佐证) | RL 分布提纯(官方抗遗忘设计佐证) |
戒断实锤 | thinking/action 不一致3 | scoring_func 配置错误12 / 终止协议【需核实】 |
修复杠杆 | 客户端断路器 + 工具去重 | kv-cache-dtype auto + 采样参数(限 llama.cpp 类) |
选型建议 | Agent 重度场景必须配断路器与轮次上限 | vLLM 部署禁用 FP8 KV(MLA 路径),或等上游修复 |
读表的方式:不要只看"谁更差"——两家都没有官方 postmortem 承认复读问题(这点对两家都公平),差异在于失效点分布:DeepSeek 的风险集中在 Agent 协议层(可被客户端工程兜住),GLM 的风险集中在推理部署层(可被配置决策避开)。知道风险在哪一层,防御就花在哪一层。
4.3 一个必须拆穿的误判:别把 Harness 的锅甩给模型
排查复读时最容易犯的错误,是把三个不同根因的故事线搅在一起。2026 年 6 月的 Claude Code 故障潮就是现成的例子:那批故障的已披露根因是 Claude Code 自身的 sub-agent 递归增殖(Issue #69578:无递归深度限制,约 800K token / $27.60 意外扣费;Issue #68430:50+ 层递归烧掉 1.2M token)——锅在 Harness,不在模型13。
判断"锅在谁"的最可靠信号是 baixiaoustc 复盘给出的那条:两个独立客户端同时中招1。同一模型 + 不同 Harness + 同症状 → 指向模型/服务端;同一 Harness + 不同模型 + 同症状 → 指向 Harness。在发出"这模型有病"的结论前,先做这道二选一的排列组合题。
五、防御实战:三层防线与可复用代码
本节核心收获: 按"部署配置 → 采样参数 → 客户端断路器"的顺序落地三级防御,拿到两段可直接运行的配置/代码,并学会用表格化的"五问自检"在上线前发现复读体质。
5.1 第一层:部署配置(成本最低,收益最大)
依据第四章的证据分布,第一层防御就是把已实锤的配置雷区排掉。以下逐条标注证据等级:
GLM(MLA 架构)路径:
- vLLM 部署禁用
--kv-cache-dtype fp8(证据等级:实锤,Issue #38652 benchmark:4.61 → 1.075)。代价是 KV 显存约 2 倍,但对 MLA 模型这是当前唯一安全选项; - 权重选择:若必须 FP8,用官方量化分发的 FP8-Dynamic 版本并仍然保持 KV BF164;
- llama.cpp/GGUF 路径:核查
scoring_func是否为sigmoid(softmax 是已修复的循环 Bug)12(证据等级:实锤); - 等待 vLLM 上游对 MLA FP8 缩放的正式修复(跟踪 Issue #38652;截至 2026-09-12 未确认有合并的修复 PR)【需核实】。
DeepSeek 路径:
- Agent 场景开启 prompt cache 并验证命中:qwen-code #4695 的教训是 8.9M token 全价计费的直接原因就是
cached_content_token_count=02(证据等级:实锤); - 工具 schema 严格校验:BigGo 报道的确定性修复显示,DeepSeek V4 Pro 遇到 schema 格式错误(数组传成 JSON 字符串等)时平均重复同一错误调用 56 次,配合确定性补丁 + repair hint 后第三次调用即修正、每会话失败从 50+ 降到近零(证据等级:单一来源报道,工程方向可信,数字【需核实】)14;
- 怀疑数值型复读时,关闭 DSpark/投机解码复测一次(证据等级:观察项,无实锤案例)。
一段可直接使用的启动配置对照(以 vLLM 为例;版本参数以你所部署的 vLLM 版本文档为准):
# =============================================================
# 场景:GLM-4.7-Flash(MLA 架构)vLLM 部署安全基线
# 依据:vllm-project/vllm Issue #38652 (benchmark 4.61→1.07)
#       + HF unsloth/GLM-4.7-Flash-FP8-Dynamic Discussion #2
# 整理:HOS(安全风信子) 2026-09-12;参数名以你的 vLLM 版本文档为准
# =============================================================

# ❌ 事故配置(多轮对话复读, benchmark 实锤)
# vllm serve zai-org/GLM-4.7-Flash --kv-cache-dtype fp8

# ✅ 安全基线(KV 保持 BF16/auto, 代价: KV 显存约 2x)
vllm serve zai-org/GLM-4.7-Flash \
    --dtype bfloat16 \
    --kv-cache-dtype auto \
    --max-model-len 131072        # 按显存预算调整, 长上下文本身会放大误差累积

# ✅ 显存紧张时的替代思路(不压缩 KV, 压缩并发/长度)
#    或评估 turboquant-plus-vllm 插件(PyPI): 其 PolarQuant 路径在
#    GLM-4.7-Flash 上报 4.63/5(vs FP16 基线 4.61),声称是 MLA 上
#    唯一可用的 KV 压缩方案【第三方插件自报数据, 需核实后再上生产】
5.2 第二层:采样参数(分病因使用,别当安慰剂)
你的症状 | 先查的参数 | 原理 | 证据等级 |
|---|---|---|---|
llama.cpp 路径复读 | scoring_func=sigmoid(修配置) | 已实锤的框架 Bug12 | 实锤 |
GGUF 轻度重复 | --temp 1.0 --min-p 0.01 --top-p 0.95 --dry-multiplier 1.1(模型卡建议)15 | 采样侧打散低熵分布 | 模型卡建议 |
vLLM FP8 量化复读 | 调参数无效,回退 KV dtype | 分布已被数值噪声破坏 | 实锤(#38652 症状指纹) |
工具调用循环 | 调参数基本无效,上第三层断路器 | 协议病,非采样病 | 实锤(#37255 thinking/action 不一致)3 |
**记忆口诀:数值病修 dtype,协议病修 Harness,采样参数只治轻度低熵。**社区偏方"关 repeat_penalty"对 GLM-4.7 部分场景有效的 anecdote11可以试,但请把它排在 dtype 修复之后。
5.3 第三层:客户端断路器(Agent 场景的保命符)
前两层管不住协议病。DeepSeek 工具调用循环的三个案例123共同证明:服务端没有熔断,客户端必须有。qwen-code #4695 的讨论区给出了防御设计原型:同一 turn 内 tool-call 去重 + 每 turn 硬轮次上限 + 触发时强制 tool_choice="none"2。
下面是把这些原则落成的可运行脚本(作者自编,基于公开 Issue 中的防御原则实现;Python 3.10+):
# =============================================================
# DedupLoopBreaker —— Agent 工具调用循环断路器(作者自编实现)
# 设计原则来源(公开 Issue,非代码引用):
#   - QwenLM/qwen-code Issue #4695: 同 turn 去重 + 硬轮次上限
#     + tool_choice="none" 强制文本回复
#   - NousResearch/hermes-agent Issue #37255 / PR #37280:
#       跨轮调用跟踪 + 连续"停意"阈值 + 硬截断
#   - baixiaoustc 复盘(2026-06-08): 两次用户 stop 无效的教训
# 环境:Python 3.10+;仅依赖标准库;可直接嵌入你的 Agent 主循环
# =============================================================
from __future__ import annotations
import hashlib, json
from dataclasses import dataclass, field

@dataclass
class LoopBreakerConfig:
    """阈值取自公开 Issue 的讨论共识, 可按业务调整"""
    max_tool_rounds: int = 30          # 每 turn 工具轮次硬上限(#4695 建议 ~30)
    dedup_window: int = 5              # 去重滑动窗口: 最近 N 次调用
    dedup_threshold: int = 3           # 窗口内 >=3 次完全相同 → 注入打断(#4695 建议)
    stop_intent_threshold: int = 3     # 连续 N 轮 thinking 声明"要停"却仍调工具(#37280 思路)
    hard_cutoff: int = 5               # 打断注入仍循环 → 强制截断的最大容忍

class DedupLoopBreaker:
    """跨轮跟踪工具调用指纹, 三级熔断: 提示 → 注入打断 → 硬截断"""

    def __init__(self, cfg: LoopBreakerConfig = LoopBreakerConfig()):
        self.cfg = cfg
        self.rounds = 0                      # 当前 turn 已发生的工具调用轮数
        self.fingerprints: list[str] = []    # 调用指纹滑动窗口
        self.stop_intents = 0                # 连续"声称要停却没停"计数
        self.injected = 0                    # 已注入打断消息的次数
        self.forced_stop = False

    @staticmethod
    def _fp(name: str, args: dict) -> str:
        """工具调用指纹: 规范化 JSON 后哈希(键序无关)"""
        canonical = json.dumps({"n": name, "a": args},
                               sort_keys=True, ensure_ascii=False)
        return hashlib.sha256(canonical.encode()).hexdigest()[:16]

    def on_tool_call(self, name: str, args: dict,
                     thinking_says_stop: bool = False) -> dict:
        """每次模型发起工具调用前调用; 返回决策指令"""
        self.rounds += 1
        fp = self._fp(name, args)
        self.fingerprints.append(fp)
        window = self.fingerprints[-self.cfg.dedup_window:]
        dup = window.count(fp)

        # 0) 硬截断已触发: 本轮禁止任何工具调用
        if self.forced_stop:
            return {"allow": False, "action": "tool_choice_none",
                    "reason": "hard_cutoff_reached"}

        # 1) 轮次硬上限(#4695): 30 轮封顶
        if self.rounds > self.cfg.max_tool_rounds:
            self.forced_stop = True
            return {"allow": False, "action": "tool_choice_none",
                    "reason": f"rounds>{self.cfg.max_tool_rounds}"}

        # 2) 指纹去重(#4695): 窗口内 >=3 次完全相同
        if dup >= self.cfg.dedup_threshold:
            self.injected += 1
            if self.injected >= self.cfg.hard_cutoff:
                self.forced_stop = True      # 注入也打不断 → 硬截断
                return {"allow": False, "action": "tool_choice_none",
                        "reason": "dedup_persists_after_injection"}
            return {"allow": True, "action": "inject_system_message",
                    "reason": f"duplicate_call_x{dup}",
                    "hint": ("你已连续多次执行完全相同的调用且输出未变化。"
                             "请停止调用工具, 直接用文本总结当前结果。")}

        # 3) 停意-行动不一致检测(#37255): thinking 说停, 手上不停
        self.stop_intents = self.stop_intents + 1 if thinking_says_stop else 0
        if self.stop_intents >= self.cfg.stop_intent_threshold:
            return {"allow": True, "action": "inject_system_message",
                    "reason": "stop_intent_mismatch",
                    "hint": ("你在推理中多次表示应给出最终答案。"
                             "本次调用将被视为最后一次, 之后必须输出最终答复。")}

        return {"allow": True, "action": "proceed"}

    def on_turn_end(self) -> None:
        """每个对话 turn 结束时复位(跨轮状态仅保留聚合统计)"""
        self.rounds, self.fingerprints = 0, []
        self.stop_intents, self.injected, self.forced_stop = 0, 0, False


# ---- 最小验证 ----
if __name__ == "__main__":
    br = DedupLoopBreaker()
    # 模拟复读: 同一调用连发(第3次重复→注入打断, 第7次注入耗尽→硬截断)
    for i in range(9):
        d = br.on_tool_call("execute_code", {"code": "print(61 rows)"})
        print(f"call#{i+1}: {d['action']:<22} {d.get('reason','')}")
    assert br.on_tool_call("execute_code", {"code": "print(61 rows)"})["allow"] is False
print("OK: dedup 注入升级为硬截断 — 断路器工作正常")三个工程细节说明(都来自前文案例的血泪):
- 指纹要做键序无关的规范化哈希——qwen-code #4695 里"一字不差"的循环,在你这里可能表现为"参数顺序抖动的等价调用",规范化后再比对才抓得住;
stop_intents检测的是 hermes-agent #37255 的症状(thinking 说停、action 不停),这是所有断路器里最容易被忽略、却最早出现的一级信号——它能在烧钱之前告诉你"模型已经想停了";on_turn_end必须复位——断路器状态跨 turn 泄漏会造成误杀;但聚合统计要保留,"本周触发过 4 次硬截断"本身就是该模型/Harness 组合的体检指标。
5.4 上线前五问自检
把第四章的对照表压缩成五问,部署任何一个新模型前花五分钟过一遍:
# | 自检问题 | 依据 | 不达标动作 |
|---|---|---|---|
1 | 部署架构是 MLA 类吗?KV dtype 是什么? | GLM FP8 事故5 | auto 回退,重跑多轮回归测试 |
2 | Agent 主循环有轮次硬上限与工具去重吗? | #4695: 50 轮 8.9M token2 | 部署 5.3 断路器 |
3 | 工具调用失败(schema 错误)有确定性修复吗? | 平均重复 56 次14 | 加 schema 校验 + repair hint |
4 | prompt cache 命中率验证过吗? | cached=0 全价计费2 | 压测 cache 命中,账单对账 |
5 | thinking 层"停意"被监控了吗? | #37255 早于账单爆炸的信号3 | 接入断路器第 3 级检测 |
六、趋势研判:这场竞赛会把我们带向哪里
本节核心收获: 三条可检验的趋势判断(各自标注推理依据与被证伪的条件),以及对你选型节奏的具体建议。
6.1 判断一:量化与容错的矛盾会继续加深,但形式会从"裸奔"变成"带保险裸奔"
DeepSeek V4.1 的 FP4 KV 已经展示了"带保险的激进":QAT 兜底、SWA 保留 FP8、动态范围论证写进技术报告6。可以预期,后续版本的量化会更激进(FP4 铺到更多组件、推测解码更深),但保险装置会成为技术报告的标配章节——因为 GLM 的 FP8 事故已经示范了"不带保险上量化"的舆情代价(benchmark 1.07/5 白纸黑字挂在公开 Issue 里5)。被证伪条件:如果下一代模型的 KV 量化在无校准缩放的情况下未出现公开事故报告,说明校准技术已被默会为基础设施,本判断作废。
6.2 判断二:断路器会从"民间偏方"变成"Harness 标准件"
2026 年 6 月的故障潮之后,Peter Steinberger(OpenClaw 创始人)与 Boris Cherny(Claude Code 负责人)分别发声"不要再手动提示 agent,应设计 loop 来提示 agent",被 Addy Osmani 命名为 Loop Engineering——其中多条讨论明确把"agent 陷入无法恢复的无限循环"列为核心失败模式,强调去重、迭代硬上限、独立 verifier 与可观测性16。hermes-agent 的修复 PR #37280(跨轮跟踪 + 停意阈值 + 硬截断)3正是标准件化的第一步。本文 5.3 节的 DedupLoopBreaker 本质上就是这个趋势的单文件实现。被证伪条件:主流 Harness 在一个发布周期内未内置任何循环熔断,且社区不再讨论该话题。
6.3 判断三:"复读体质"会成为模型选型的一等评估维度
今天选模型看跑分、看价格、看上下文长度;2026 年之后,"在激进量化配置下的多轮稳定性"会挤进评估表——理由很功利:复读与戒断的代价不是"质量差一点",而是账单爆炸 + 任务静默失败,这两者的工程代价远超分数差。GLM 的 FP8 事故给行业上的一课是:跑分表不包含推理配置的交互效应——4.74 分的 Qwen 和 4.61 分的 GLM 在各自默认配置下都很好,一开 FP8 一个 4.71 一个 1.075。评估矩阵必须是「模型 × 推理配置 × 多轮长度」的三维张量,这个实践会慢慢成为大团队标配。被证伪条件:如果上游推理框架把 MLA 量化校准做成默认安全项,使配置不再是变量,该维度自然退役。
6.4 给你的行动节奏
把以上判断落成三条可执行建议,按优先级排列:
- 本周:如果你在生产环境用 vLLM 跑任何 MLA 架构模型(GLM-4.7 系列、DeepSeek MLA 变体等),立刻检查
--kv-cache-dtype——这是全文性价比最高的一次检查; - 本月:给你的 Agent 主循环装上轮次上限 + 工具去重(5.3 节脚本或你自己的实现),并把"硬截断触发次数"接进监控面板;
- 本季度:把 5.4 节五问自检纳入你的模型接入流程,在评估矩阵里加入"FP8/FP4 配置 × 多轮长度"的压力测试项。
学完本文你能做什么:① 对着 2.1-2.4 与 3.1-3.3 的架构拆解,读懂任意一家新模型技术报告里的"效率创新"并预判其风险面;② 用第一章的两分法 + 第四章对照表,在 30 分钟内定位一次真实的复读/戒断故障属于哪一层;③ 用 5.3 节断路器脚本为你的 Agent 系统加上最后防线;④ 用 6.4 节的三条行动建议重排你的部署检查清单。
本文核心观点回顾
- 复读与戒断是两类失效:复读是 token 级的输出熵坍塌,戒断是步级的终止信号失灵;修 quantization 与修 Harness 是两套完全不同的动作,混用必然低效(第一章)。
- DeepSeek 路线的风险集中在数值层:CSA2 的层间复用把误差广播给 5 层注意力、CED 的单点投射无隔离、FP4 KV 是带 QAT 保险的激进赌注;而 Agent 工具调用循环是独立于精度的协议病,已有三个独立 Issue 实锤(第二章)。注意 V4.1-Flash 已是纯 CSA2 而非 CSA+HCA 混合——版本混谈是当前社区讨论的第一大误区。
- GLM 路线的风险分布在两端:推理侧 FP8 KV × MLA 是有官方 benchmark 的实锤事故(4.61 → 1.07,根因是无校准缩放 + 误差逐轮累积);训练侧的 RL 分布提纯是机制推断,但有三条官方设计(OPD/DIS/多教师复习)旁证(第三章)。IcePop 属蚂蚁 Ring-1T 体系,不在 GLM 技术栈内——素材级混淆需在引用前核实。
- 两条路线共享同一个结构困境:效率竞赛在系统性地出售输出分布的容错空间;推理框架的量化选项再刮走一层。复读与戒断因此从偶发 Bug 变成结构性风险(第四章"容错空间守恒"框架)。
- 防御分三层且顺序固定:部署配置(dtype 回退、cache 命中验证)→ 采样参数(只治轻度低熵)→ 客户端断路器(轮次上限 + 指纹去重 + 停意检测)。Loop Engineering 的行业共识正在把第三层标准件化(第五、六章)。
参考链接:
- 主要来源:
- vllm-project/vllm Issue #38652 — FP8 KV Cache 在 MLA 模型(GLM-4.7-Flash)多轮场景产生乱码输出(含 20 场景 benchmark) - FP8×MLA 事故的核心证据链与根因分析
- unsloth/GLM-4.7-Flash-FP8-Dynamic Discussion #2 — vLLM
--kv-cache-dtype fp8严重循环/重复输出 - 首次报告与维护者回应 - baixiaoustc — ClaudeCode/OpenClaw 复读循环故障复盘(2026-06-08) - DeepSeek V4 Pro 工具调用复读的完整复盘(结论含推测成分)
- QwenLM/qwen-code Issue #4695 — deepseek-v4-pro 工具调用循环(8.9M tokens) - 独立复现 + 客户端防御原型
- NousResearch/hermes-agent Issue #37255 — thinking/action 不一致导致无限工具调用 - 戒断型失效的定位与修复 PR #37280
- DeepSeek-V4.1-Flash 技术报告摘要(alphaxiv 2609.deepseek-v4-1-flash) - CSA2/CED/MXFP4/DSpark 官方数据
- Z.ai 博客 — GLM-5.3: Frontier Coding with Emergent Cyber Capabilities(2026-08-14) - 后训练缩放官方叙事与全部 benchmark
- 辅助来源:
- 清华 KEG — SAO: Single-Rollout Asynchronous Optimization(arXiv:2607.07508) - GLM Agent RL 算法,GRPO 对比与熵坍塌数据
- 蚂蚁集团 InclusionAI — IcePop(arXiv:2510.18855)与 AReaL grpo_series 文档 - 素材纠偏依据:IcePop 的真实归属
- vLLM PR #48051 — 禁止对 GLM MoE DSA 的 bf16 MLA kv_b_proj 重新量化 - "重量化驱动 greedy 解码进入重复循环"的官方代码注释
- Unsloth GLM-4.7-Flash 部署文档 - llama.cpp
scoring_funcBug 与采样参数建议 - 腾讯云社区 — Loop Engineering 讨论(Steinberger/Cherny/Osmani) - 循环熔断标准件化的行业趋势
- BigGo Finance — CommandCode 3200 行确定性修复报道 - 工具 schema 错误重复 56 次与修复效果(单一来源【需核实】)
附录(Appendix):
附录 A:术语与缩写速查
术语 | 全称 | 一句话解释 |
|---|---|---|
CSA2 | Compressed Sparse Attention 2 | V4.1-Flash 的压缩注意力:按 Full/Reindex/Reuse 三模式做跨层 KV 复用 |
CSA/HCA | Compressed / Heavily Compressed Attention | 上一代 V4 的混合压缩架构(已被 V4.1 弃用) |
CED | Causal Encoder-Decoder | 20 层编码器 + 20 层解码器的非对称结构,解码器 KV 从编码器末层投射 |
MLA | Multi-head Latent Attention | 将 KV 压缩为低秩潜在向量存储的注意力架构(GLM/DeepSeek 均采用或衍生) |
MXFP4 | Microscaling FP4(OCP 标准) | E2M1 格式 + 16 通道一组 scale 的 4bit 浮点格式 |
QAT | Quantization-Aware Training | 量化感知训练:训练阶段就让模型适应量化噪声 |
SAO | Single-Rollout Asynchronous Optimization | 单轨迹异步 RL 优化:即时更新 + Actor-Critic 回归 + DIS 裁剪 |
DIS | Dual-side Importance Sampling | SAO 中的双向 token 级重要性采样,越界 token 梯度屏蔽 |
IcePop | —(蚂蚁 InclusionAI) | 训推概率比双侧区间裁剪,区间外梯度归零(Ring-1T 体系) |
DSpark | —(DeepSeek 投机解码) | 半自回归草稿 + 置信度调度验证的推测解码 |
OPD | Online Policy Distillation | 在线策略蒸馏:多教师"复习"对抗 RL 后灾难性遗忘 |
FP8 KV Cache | FP8 Key-Value Cache | 用 8bit 浮点存储 KV 缓存以省显存的推理配置(本文核心事故源) |
附录 B:素材纠偏与核实清单
# | 素材原表述 | 核实结果 | 处理方式 |
|---|---|---|---|
1 | “V4.1 Flash 将 CSA+HCA 升级为 CSA2” | V4 才是 CSA+HCA 混合;V4.1-Flash 弃用混合架构改用纯 CSA2(官方技术报告6) | 2.1 节专项纠偏声明 |
2 | “V4.1 解码器 KV Cache 需求降至上一代 1/4” | 属实(890 字节/token ≈ V4-Flash 的 1/4)6 | 采用并补全 1/437(对 V1) |
3 | “GLM-5 基于 GRPO + IcePop” | GLM-5.3 用 SAO(arXiv:2607.07508),GRPO 恰是被放弃的基线;IcePop 属蚂蚁 Ring-1T(arXiv:2510.18855)910 | 3.2 节三层纠偏 |
4 | “Terminal-Bench 3.0 从 4.6 → 28.3,RL 效率 +2.3 倍” | 属实(官方博客口径8;4.6→28.3 约 6 倍) | 采用 |
5 | “FP8 KV Cache 在 vLLM V1 上多轮立即无限重复” | 属实且证据链完整(HF Discussion #2/#48 + vLLM Issue #38652 benchmark)4511 | 3.3 节完整展开 |
6 | “FP8 施加于 MLA 潜在向量、缺乏逐张量校准缩放” | 与 Issue #38652 报告者分析一致5 | 采用(标注为报告者分析) |
7 | “关闭重复惩罚可解决部分复读” | 社区 anecdote,无对照实验;且对 FP8 量化型复读无效11 | 3.3/5.2 节限定适用范围并标【需核实】 |
8 | “Ollama 上需 max_tokens=40000 恢复” | 未能定位原始讨论 | 保留于 3.5 节并标【需核实】 |
9 | “V4 预训练超 32T Token” | 未能直接核实该数字(V4.1 官方口径为 45T 多模态 token,V4 为 32T+ 的说法未在本次检索中复现) | 2.4 节不引用该数字;V4.1 数据采用6 |
10 | “DSpark 提速 60%-85%” | 与官方口径一致6;"引发复读"无实锤 | 2.7 节列为观察项 |
11 | “Claude Code/OpenClaw 同时复读,根因 V4.0 Pro 工具调用 Bug(置信度 95%)” | 复盘文章存在且现象可复述1;95% 置信度与阈值假说为作者推测,无官方 postmortem | 2.6 节采用现象、假说降级为"假说",并补 4.3 节 Harness 误判警告 |
12 | “mHC 修正深层残差数值稳定性” | mHC(Single-Pass 形态)在 V4.1 材料中出现,定位为激活内存优化的同时与数值稳定性相关6【具体数学形式需核实】 | 2.4 节谨慎表述 |
附录 C:DedupLoopBreaker 参数速调表
场景 | max_tool_rounds | dedup_threshold | stop_intent_threshold | 说明 |
|---|---|---|---|---|
高频探查型任务(如批量检索) | 60 | 3 | 3 | 放宽轮次,保去重 |
常规 Agent 任务 | 30 | 3 | 3 | Issue #4695 讨论共识 |
成本敏感批处理 | 20 | 2 | 2 | 更早打断,宁可误杀 |
已知模型有复读体质 | 15 | 2 | 2 | + 部署侧先做 5.1 检查 |
附录 D:多轮稳定性压测最小协议(建议纳入评估矩阵)
- 固定 20 个多轮任务(含 system prompt),覆盖纯对话 / 工具调用 / 长上下文回看三类;
- 对照矩阵:
kv-cache-dtype ∈ {auto, fp8}× 轮次 ∈ {1, 5, 20}; - 裁判模型与被测模型不同源,1-5 分制,报告
avg与min(min 才暴露坍塌,avg 会掩盖 1.07 型事故); - 记录每次工具调用的指纹序列,断路器触发即记为失败而非重试;
- 全部配置、版本号、结果入库,跑分与"推理配置交互效应"绑定存档。
关键词: DeepSeek V4.1-Flash, GLM-4.7, 复读循环, 工具调用戒断, FP8 KV Cache, MLA 量化, Agent 断路器, 安全风信子, 技术深度, 专业价值
在这里插入图片描述
- baixiaoustc,《ClaudeCode/OpenClaw 复读循环故障复盘——DeepSeek V4 工具调用 Bug 深度诊断》,2026-06-08,https://baixiaoustc.github.io/2026/06/08/claude-code-repetition-loop-deepseek-bug/ 。现象部分(30+ 次相同调用、两次 stop 无效、"升级 ClaudeCode"打破循环)为作者实录;"完成度阈值/unmarked=32"机制为作者假说,自评置信度 95%,非官方结论。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- QwenLM/qwen-code Issue #4695 “Tool-call loop: deepseek-v4-pro collapses into repeated identical tool_call inside its working context window, no client-side circuit breaker”,2026-06,https://github.com/QwenLM/qwen-code/issues/4695 。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- NousResearch/hermes-agent Issue #37255 “deepseek-v4-pro thinking/action inconsistency causes infinite tool-calling loop”,https://github.com/NousResearch/hermes-agent/issues/37255 ;修复 PR #37280(跨轮跟踪 + 三次停意阈值 + 五次硬截断)。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- unsloth/GLM-4.7-Flash-FP8-Dynamic Discussion #2 “Severe Looping/Repetitive Output when using --kv-cache-dtype fp8”,https://huggingface.co/unsloth/GLM-4.7-Flash-FP8-Dynamic/discussions/2 。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- vllm-project/vllm Issue #38652 “[Bug]: --kv-cache-dtype fp8 produces garbage output on MLA models (GLM-4.7-Flash) at multi-turn”,https://github.com/vllm-project/vllm/issues/38652 。基准:20 多轮场景、Llama-3.3-70B 裁判、1-5 分制。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- DeepSeek-V4.1-Flash 技术报告摘要页(alphaxiv 2609.deepseek-v4-1-flash,2026-09-10),https://www.alphaxiv.org/abs/2609.deepseek-v4-1-flash ;权重与 51 页技术报告 PDF 见 huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash(MIT 许可)。CSA2 分组/配比、MXFP4 动态范围论证、45T token、DSpark 等均出自该报告及同步解读(知乎精讲 https://zhuanlan.zhihu.com/p/2081570257479774340 ;MarkTechPost https://www.marktechpost.com/2026/09/10/deepseek-ai-released-deepseek-v4-1-flash-with-1m-context-fp4-kv-cache-and-cross-layer-attention-reuse/amp/ )。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- YoCo(You Only Cache Once)思路出处见 V4.1-Flash 报告致谢与解读文6;原文出处【需核实】。 ↩︎ ↩︎
- Z.ai 官方博客 “GLM-5.3: Frontier Coding with Emergent Cyber Capabilities”,2026-08-14,https://z.ai/blog/glm-5.3 。Terminal-Bench 3.0(4.6→28.3,评测条件 Claude Code 2.1.207/effort=max/400K 上下文/avg@3)、DeepSWE(46.2→66.9)、OPD 多教师、训推 logprob 对齐 1e-7、token 效率对比等数字均出自该博客及一致转述(ai-primer https://www.ai-primer.com/engineer/stories/glm53-posttraining-benchmark-gains ;知乎解读 https://zhuanlan.zhihu.com/p/2073347214466888486 )。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- 清华 KEG,“Single-Rollout Asynchronous Optimization for Agentic Reinforcement Learning”,arXiv:2607.07508,https://arxiv.org/abs/2607.07508 。GRPO 约 160 步崩溃 vs SAO 约 1000 步、DIS 信任域屏蔽、价值模型三层约束等数据出自该论文及其精读(BAAI Hub https://hub.baai.ac.cn/view/56382 )。 ↩︎ ↩︎ ↩︎
- 蚂蚁集团 InclusionAI,IcePop,arXiv:2510.18855,https://arxiv.org/abs/2510.18855 ;AReaL 框架配置文档 https://github.com/areal-project/AReaL/blob/main/docs/en/algorithms/grpo_series.md (
metric=ratio即 IcePop,默认区间 [0.5, 5.0])。 ↩︎ ↩︎ - zai-org/GLM-4.7-Flash Discussion #48 “Endless Repetition? Anyone encountered?”(bf16 权重 + FP8 KV 复现;评论区建议 temperature=1.0 / SGLang BF16),https://huggingface.co/zai-org/GLM-4.7-Flash/discussions/48 ;"关闭重复惩罚可解决部分复读"为社区 anecdote,未做对照实验【需核实】。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎
- Unsloth GLM-4.7-Flash 部署文档(llama.cpp
scoring_func: softmax配置错误导致循环,GGUF 2026-01-21 更新修复;采样建议--temp 1.0 --top-p 0.95、工具调用--temp 0.7 --top-p 1.0、--repeat-penalty 1.0、--min-p 0.01),https://unsloth.ai/docs/zh/mo-xing/tutorials/glm-4.7-flash 。 ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ ↩︎ - anthropics/claude-code Issue #69578(sub-agent 无递归深度限制,~800K token / $27.60)、#68430(50+ 层递归 / 1.2M token),https://github.com/anthropics/claude-code/issues/69578 ;TechTimes 2026-06-23 报道 https://www.techtimes.com/articles/318925/20260623/claude-outage-tops-8000-reports-agentic-pipeline-failures-mount-before-anthropic-ipo.htm 。 ↩︎
- BigGo Finance 对 CommandCode.ai / Ahmad Awais "3200 行确定性修复"的报道(DeepSeek V4 Pro 对 schema 错误平均重复 56 次;补丁后第三次调用即修正、每会话失败 50+→近零、会话时长 30 分钟→12+ 小时),https://finance.biggo.com/news/4fe837b3cdc77cc9 。单一来源,数字【需核实】。 ↩︎ ↩︎
- evilfreelancer/GLM-4.7-Flash-GGUF 模型卡复读缓解建议(
--temp 1.0 --min-p 0.01 --top-p 0.95 --dry-multiplier 1.1,顽固时 1.5),https://huggingface.co/evilfreelancer/GLM-4.7-Flash-GGUF 。 ↩︎ - Loop Engineering 讨论汇总:腾讯云开发者社区 https://cloud.tencent.cn/developer/article/2689195 ;腾讯新闻(十四君)https://view.inews.qq.com/k/20260621A06HEI00 。Steinberger/Cherny 原始发帖时间 2026-06-07 前后。 ↩︎
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-10-12,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号