【征文】我用 WorkBuddy 接上麦当劳 MCP,做了个"点餐最优解"技能
原创
【征文】我用 WorkBuddy 接上麦当劳 MCP,做了个"点餐最优解"技能
原创
用户11018591
修改于 2026-10-12 13:02:12
修改于 2026-10-12 13:02:12
【征文】我用 WorkBuddy 接上麦当劳 MCP,做了个"点餐最优解"技能
标签:#WorkBuddy #MCP #AI Agent #Python
一、起因:一张优惠券引发的血案
麦当劳的优惠券,规则是混着来的:
- 满 40 减 10(满减)
- 汉堡 8.8 折(折扣)
- 麦乐鸡第二份半价(品类限定)
单看每一张都懂,放在一起就不会算了。
举个例子:你点了一个 25 元的板烧鸡腿堡,手里有「满 40 减 10」和「汉堡 8.8 折」两张券。
- 用满减:得再凑 15 元,凑完实付 30 元(假设凑单商品正好 15 元)
- 用折扣:直接付 25 × 0.88 = 22 元
折扣更省。 但如果汉堡是 40 元呢?
- 满减:付 30 元
- 折扣:付 35.2 元
这次满减更省。
也就是说,哪张券更划算,取决于你这单的具体构成,没有标准答案。人脑在这种组合空间里只能靠猜。
再加上"我在控糖,热量别超 1100 kcal""两个人吃,蛋白质要够""总共别超过 45 块"这类约束 —— 满足条件的组合有上千套(按项目内置的离线示例数据算,是 1554 套)。
手算不可能。
所以我就想:这事能不能交给 AI 干?
二、先看结果
先说结论。我在 WorkBuddy 里做了个技能叫「麦麦点餐最优解」。给它下面这组约束(这也是仓库里 --demo 用的默认约束):
预算 ≤ ¥45|热量 ≤ 1100 kcal|蛋白质 ≥ 35 g
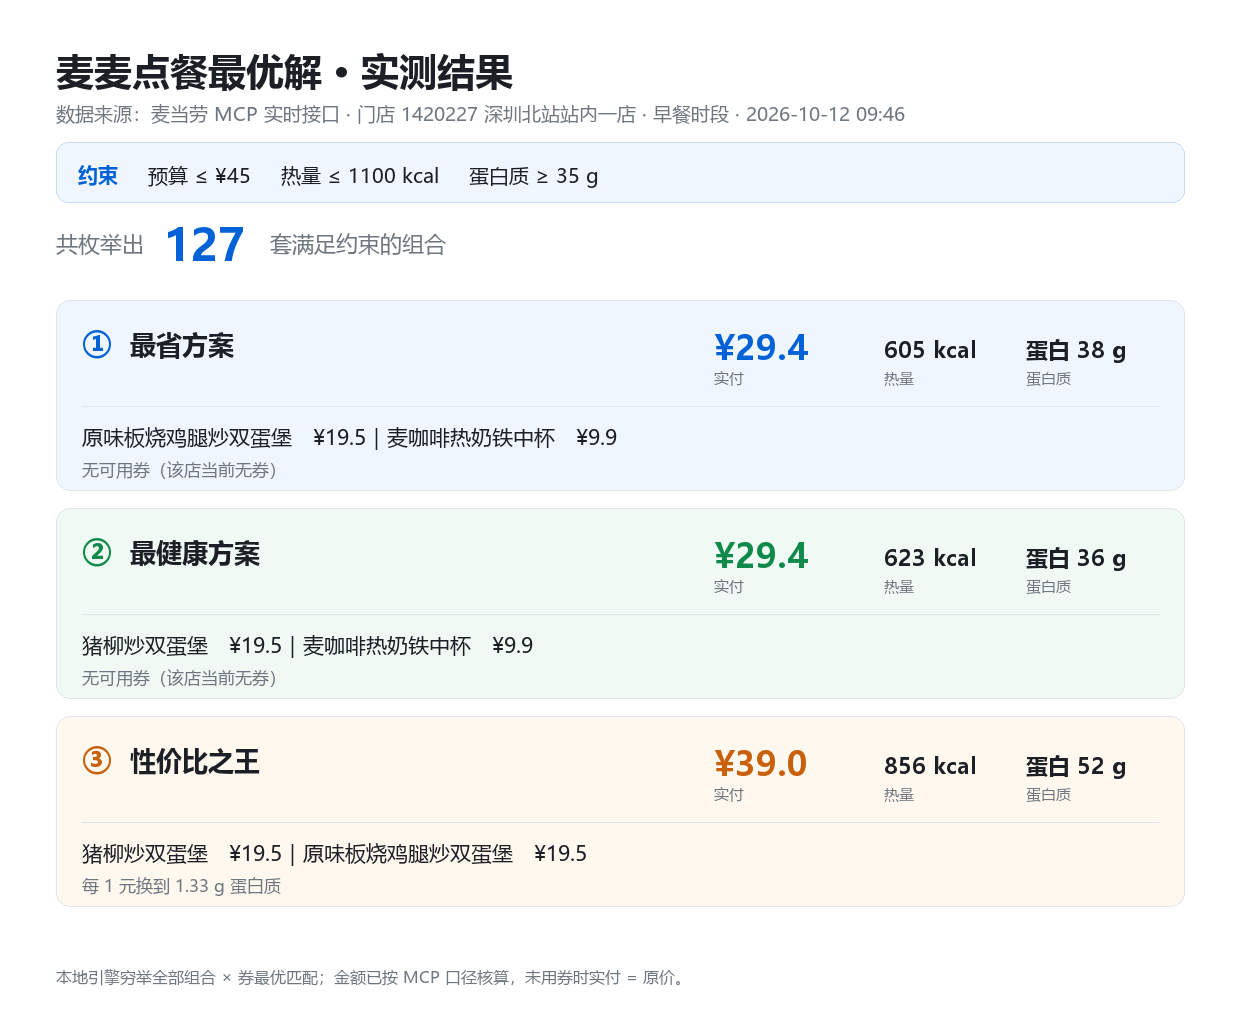
先给一个不用 Token 就能复现的演示结果。下面这三套方案来自项目内置的离线示例数据(--demo 模式),共枚举 1554 套满足约束的组合,用来演示组合枚举和优惠券匹配是怎么跑的:
类型 | 方案 | 实付 | 原价 | 省 | 热量 | 蛋白 |
|---|---|---|---|---|---|---|
最省 | 麦香鸡 + 吉士汉堡 | ¥24.0 | ¥30.0 | ¥6.0 | 720 kcal | 35 g |
最健康 | 板烧鸡腿堡 + 麦乐鸡5 + 豆浆 | ¥35.0 | ¥45.0 | ¥10.0 | 810 kcal | 45 g |
性价比 | 那么大鸡排 + 麦乐鸡10 | ¥32.0 | ¥42.0 | ¥10.0 | 880 kcal | 50 g |
上述三套方案来自项目内置的离线示例数据,无需 MCP Token 即可复现,用于演示组合枚举与优惠券匹配流程。连接麦当劳 MCP 后,系统会使用所选门店当时的菜单、营养信息和可用优惠券重新计算;实际结果随门店、时段、账户优惠券及输入约束变化,最终金额以服务端核价为准。
本文第八节还有一次真实 MCP 调用的实测记录,那里的数字才是当次门店的真实数据。
图 1:技能输出的三套方案成果图
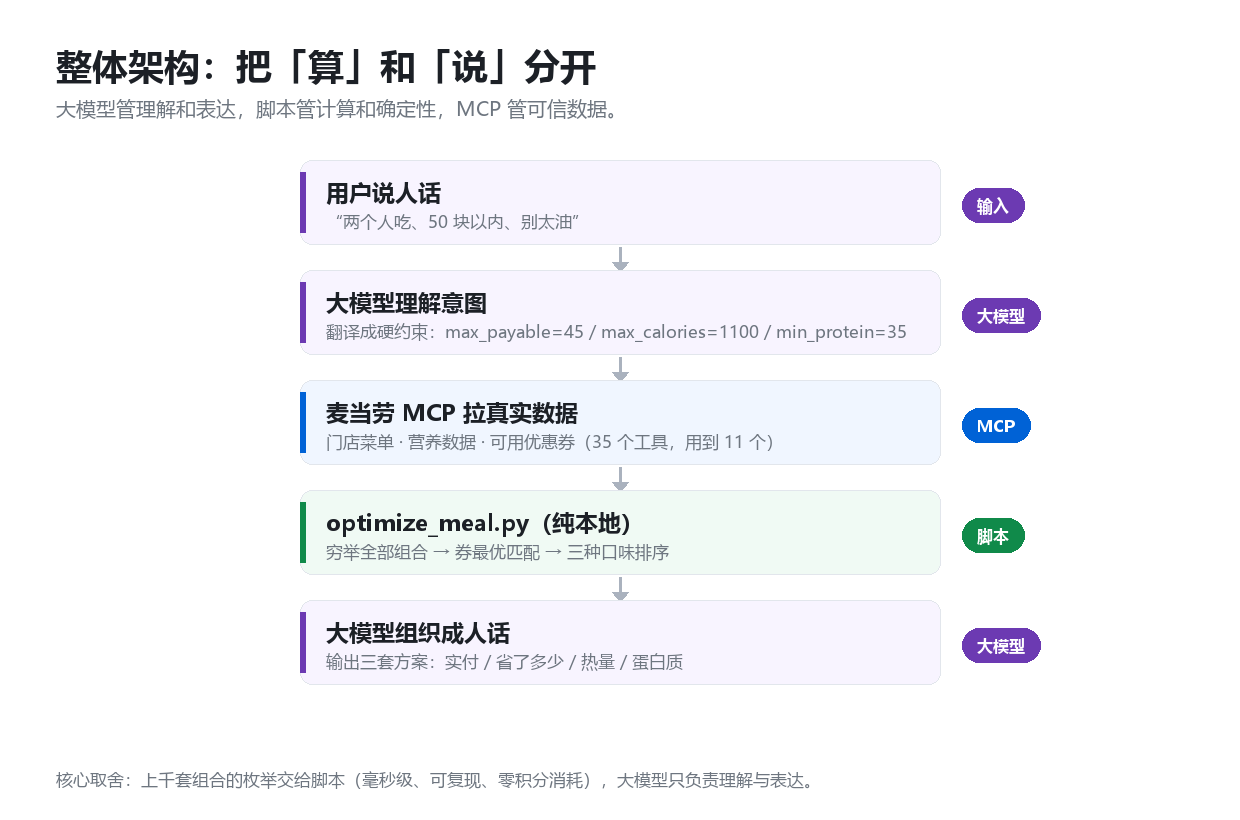
三、整体架构:把"算"和"说"分开
这是整个项目最重要的一个设计取舍。
用户说人话undefined │ "两个人吃、50 块以内、别太油"undefined ▼undefined大模型(WorkBuddy)理解意图 ──► 翻译成硬约束undefined │ max_payable=45, max_calories=1100, min_protein=35undefined ▼undefined麦当劳 MCP 拉真实数据 ──► 门店菜单 / 营养 / 可用券undefined │undefined ▼undefinedoptimize_meal.py(纯本地,无网络)──► 穷举组合 + 券最优匹配undefined │undefined ▼undefined大模型组织成人话 ──► 三套方案
为什么不把组合枚举交给大模型?
因为枚举上千套组合是纯数学问题,不是语言问题。交给大模型有三个问题:
- 慢 —— 上千次乘加运算,模型是 token by token 生成的
- 贵 —— 全在烧积分
- 会算错 —— 大模型的算术能力,做过的人都懂
交给脚本:几毫秒出结果、结果可复现、零积分消耗、不会算错钱。
大模型只干它擅长的事:理解"别太油"是什么意思,以及把结果讲成人话。
四、第一步:把麦当劳 MCP 接进 WorkBuddy
4.1 申请 Token
访问 https://open.mcd.cn/mcp,右上角登录 → 控制台 → 激活 → 复制 Token。
4.2 配置连接器
在 WorkBuddy 左侧边栏打开【专家·技能·连接器】→【连接器】→ 右上角【自定义连接器】→【配置 MCP】,填入:
{
  "mcpServers": {
    "mcd-mcp": {
      "type": "streamableHttp",
      "url": "https://mcp.mcd.cn",
      "headers": {
        "Authorization": "Bearer YOUR_MCP_TOKEN"
      }
    }
  }
}
图 2:自定义连接器配置界面截图
4.3 踩坑记录(这里我卡了半小时)
坑 1:**type** 字段的大小写。
麦当劳官方文档给的示例是 "type": "streamablehttp"(全小写),但 WorkBuddy 客户端只认驼峰写法:
"type": "streamableHttp"   // ✅ 正确
"type": "streamablehttp"   // ❌ 不识别
我是从 WorkBuddy 内置连接器清单里反推出这个字段的 —— 内置的都写驼峰。
坑 2:配置文件路径。
网上不少教程写 ~/.workbuddy/mcp.json,但实际生效的路径是:
~/.workbuddy-ai/mcp.json
~/.workbuddy/ 目录确实存在,但里面只有 device-id 和 logs,不是配置目录。
坑 3:配好了不等于能用了。
配置写对之后,还得在【自定义连接器】里把 mcd-mcp 启用,客户端才会真正去加载它。
4.4 验证连通性
配置完之后,我用一段最朴素的 Python 脚本直接打了一遍 JSON-RPC,确认服务端是通的:
import json, urllib.request

payload = {
    "jsonrpc": "2.0", "id": 1, "method": "initialize",
    "params": {
        "protocolVersion": "2024-11-05",
        "capabilities": {},
        "clientInfo": {"name": "probe", "version": "1.0"},
    },
}
req = urllib.request.Request(
    "https://mcp.mcd.cn",
    data=json.dumps(payload).encode(),
    headers={
        "Content-Type": "application/json",
        "Accept": "application/json, text/event-stream",
        "Authorization": f"Bearer {TOKEN}",
    },
)
print(urllib.request.urlopen(req).read().decode())
返回 HTTP 200,serverInfo 是 {"name": "mcd-mcp", "version": "1.0.0"}。
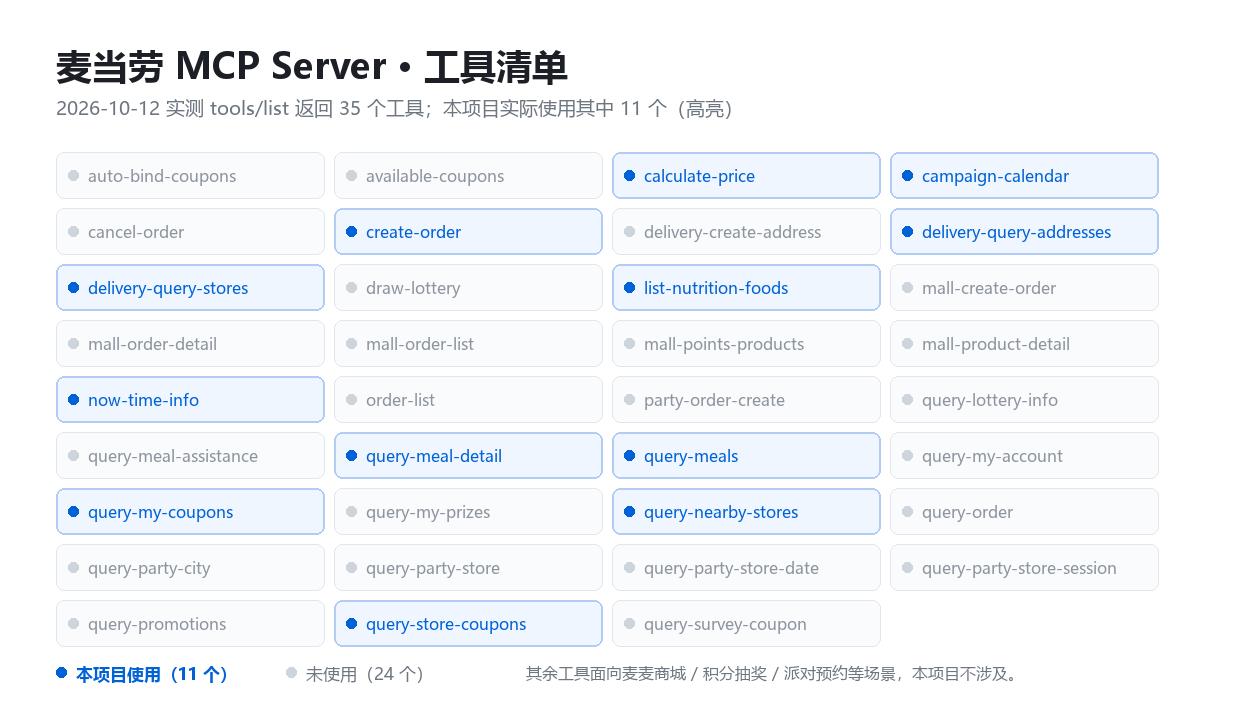
再发一次 tools/list —— 拿到 35 个工具。
图 3:tools/list 返回的 35 个工具成果图
五、第二步:拉真实数据(别信自己的记忆)
麦当劳 MCP 一共 35 个工具,这个项目实际用到 11 个:
Tool | 用途 |
|---|---|
| 校准当前时间,判断券是否过期 |
| 到店场景:按地址定位门店 |
| 外送场景:取用户配送地址 |
| 外送场景:确认哪家店可配送 |
| 核心:拉门店在售菜单(含餐品编码) |
| 套餐组成、能否换品 |
| 核心:能量 / 蛋白质 / 脂肪 / 碳水 / 钠 / 钙 |
| 核心:门店可用券 |
| 用户账户里已有的券 |
| 核价:算真实应付金额 |
| 可选:用户确认后下单 |
这里有一条铁律:所有数据必须来自 MCP,一行都不许硬编码。
原因很简单 —— 大模型记忆里的麦当劳菜单是过时的、不完整的、还会编。而且:
同一家连锁品牌,不同门店的在售商品和优惠券是不一样的。
所以流程必须是:先确定门店 → 再拉菜单和券。
这也成了这个技能里最重要的一条红线:
⚠️ 门店/地址必须由用户确认,不许按关键词猜。
我在实测时就差点栽在这上面 —— 按关键词"深圳"搜门店,出来一堆高铁站内的店。如果我直接替用户选了一家,用户人不在那儿,这单就白下了。
图 4:门店选择与菜单拉取截图
六、第三步:写优化引擎
数据拉齐之后,落成一份统一的输入 JSON:
{
  "constraints": {
    "max_payable": 45,
    "max_calories": 1100,
    "min_protein": 35,
    "exclude": [],
    "must_include": []
  },
  "menu": [
    { "code": "...", "name": "板烧鸡腿堡", "category": "汉堡",
      "price": 23.5, "calories": 550, "protein": 25 }
  ],
  "coupons": [
    { "couponId": "...", "name": "满40减10", "type": "full_reduction",
      "threshold": 40, "discount": 10, "applicable_categories": [] }
  ]
}
引擎做四件事:
1. 品类归一化
不同门店的品类文案不一样,有的写"汉堡",有的写"主食",有的写"超值主食"。先把它们归到 主食/配餐/饮品/甜品 四类,后面的枚举才能统一。
2. 组合枚举
主食 1–2 份 + 配餐 0–1 份 + 饮品 0–1 份 + 甜品 0–1 份
逐个组合过约束(预算、热量、蛋白质、忌口)。
3. 券最优匹配(这是最有价值的一步)
对每个组合,遍历所有券,按"这一单实际能减多少钱"挑最省的一张。
注意:一张订单只能用一张券,所以不能简单地"哪张券面额大用哪张"。
满减券要判断门槛够不够,折扣券要算折后价,品类限定券要判断本单有没有那个品类的商品 —— 全都要算。
4. 三种口味排序
类型 | 排序依据 |
|---|---|
最省 | 实付金额升序 |
最健康 | 热量/蛋白质与目标的偏离度升序 |
性价比 | 每 1 元换到的蛋白质克数降序 |
跑起来:
python scripts/optimize_meal.py --input meal_input.json --out result.json --md result.md --top 3图 5:引擎输出的 Markdown 结果截图
七、第四步:核价(别信自己算的钱)
这一步很容易被忽略,但很重要。
本地引擎算出来的金额只是预估 —— 配送费、包装费、门店级活动这些只有服务端知道。
所以最终输出前,必须把方案里的餐品编码丢给 calculate-price 复核一遍,两边不一致时以服务端为准。
图 6:calculate-price 核价结果截图
八、完整跑一遍:真实下单
数据链路打通之后,我在 WorkBuddy 里真实跑了一次完整流程:
now-time-info确认时间(当时是早餐时段)query-nearby-stores定位门店(由我自己确认门店)query-meals拉菜单list-nutrition-foods拉营养query-store-coupons/query-my-coupons查券- 本地引擎算组合
calculate-price核价create-order下单
最后拿到一个 ¥49 的订单,商品是双层原味板烧鸡腿麦满分 ×2 + 脆薯饼 ×1,热量 856 kcal、蛋白质 47 g —— 热量和蛋白质两条约束达标。
说明:前文"预算 ≤ ¥45"是离线示例演示用的约束;这一单是另一次实机运行,实付 ¥49,所以不拿 ¥45 去套它。两次运行的门店、时段、券都不一样,数字不可直接横向对比。
图 7:订单详情截图
九、踩坑清单(省你半小时)
坑 | 解法 | |
|---|---|---|
1 |
| 用驼峰 |
2 | 配置文件路径找错 | 是 |
3 | 配好没生效 | 要去【自定义连接器】手动启用 |
4 |
| 最终金额必须用 |
5 | 门店按关键词猜 | 必须让用户确认门店,不同门店菜单/券不同 |
6 | 大模型编营养数据 | 一律以 |
7 | 一次枚举上千组合卡住 | 交给本地脚本,别让大模型算 |
十、边界与合规
这个技能我给自己划了几条红线:
- 不下单、不领券、不取消订单,除非用户明确说要。涉及花钱和动账号的操作一律先确认。
- 门店/地址必须用户确认,不替用户拍板。
- MCP Token 只存在于 MCP Client 配置里,不打印、不写进文件、不贴进对话。项目仓库里只有
${MCD_MCP_TOKEN}占位符。 - 遵守《麦当劳 MCP 服务规则》:仅个人非商业用途,不做批量/高频自动化调用(官方限流 600 次/分钟,正常使用远达不到),不做代下单、代领券、倒卖权益。
十一、小结
这个项目最有价值的其实不是"算出了最省的套餐",而是一次架构上的分工示范:
大模型负责理解和表达,脚本负责计算和确定性。
把上千套组合的枚举交给大模型,既慢又贵还会算错;交给脚本,几毫秒出结果且可复现。
而 MCP 的价值在于把"可信数据"这件事解决了 —— 不用再担心模型编菜单、编价格、编优惠券。数据是实时的、结构化的、可以直接进计算的。
如果你也在做类似的"决策类"技能(选餐、选品、排班、比价),这个"大模型管说、脚本管算、MCP 管数据"的三段式结构,可以直接抄。
本文为原创实操记录,首发于腾讯云开发者社区 #WorkBuddy 话题。文中包含离线示例演示与真实 MCP 调用实测,两者已分别标注;示例价格及营养数值不代表当前门店数据。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号