面向JSON半结构化数据的字段级加密:嵌套脱敏与函数下推的工程权衡
原创
面向JSON半结构化数据的字段级加密:嵌套脱敏与函数下推的工程权衡
原创
安当加密 3
发布于 2026-10-12 13:52:52
发布于 2026-10-12 13:52:52
摘要:从图库与文档库的半结构化字段出发,拆解嵌套层级脱敏、保留格式加密与函数下推在查询性能上的工程权衡,给出一套可落地的字段级加密与动态脱敏方法论。 正在上传图片...
关键词:字段级加密,数据脱敏,数据安全,动态脱敏,透明数据加密,密评合规,国密,JSON脱敏
一、半结构化字段为什么让"列级脱敏"失灵
在关系型数据库占据主流的年代,数据脱敏与加密的落点相对清晰:列是确定的,类型是可枚举的,规则可以按表结构静态下发。但当业务进入图库、文档库与宽表混合存储的阶段,数据形态发生了根本变化——一个客户档案可能被存成嵌套五层的 JSON,设备上报数据可能是 BSON 里套着数组、数组里再套对象。此时,传统「按列脱敏」的范式失效了——脱敏单元不再是列,而是路径。
更棘手的是查询。文档库的能力很大程度建立在嵌套字段的索引与下推上,如果脱敏发生在应用层或者对结果集做全量回扫,原本落在存储引擎内部的过滤、排序、前缀匹配都会被抬到网络边界之外执行。这正是「数据库加密网关」需要正面回答的问题:如何在字段级加密与动态脱敏的前提下,保住半结构化查询的执行效率,又不影响图谱与文档的可用语义。
本文以嵌套 JSON 的层级脱敏为主线,结合保留格式加密(FPE)对 LIKE 与范围查询的支持、函数下推的执行位置选择、关联键保真等机制,给出一套可落地的工程拆解。
二、JSON Path 脱敏:把脱敏单元从列变成路径
解决嵌套字段的第一性工具是 JSON Path。脱敏引擎在解析 SQL 或驱动协议时,需要识别哪些输出列是 JSON 类型,并对指定路径套用脱敏函数。一个典型的策略配置如下:
{
  "table": "customer_doc",
  "column": "doc",
  "type": "json",
  "rules": [
    {
      "path": "$.profile.contact.phone",
      "method": "mask",
      "params": {"head": 3, "tail": 2}
    },
    {
      "path": "$.orders[*].buyer.mobile",
      "method": "fpe",
      "params": {"alphabet": "digit", "keepFormat": true}
    },
    {
      "path": "$.audit.snapshot.contact.tel",
      "method": "redact"
    }
  ]
}这里有三个要点。第一,路径支持通配与递归:orders[*] 让引擎对数组每个元素应用同一规则。第二,方法可叠加:对手机用 FPE 保留格式,对身份证用掩码,对审计快照里的电话直接整段剔除。第三,规则与列解耦后,新增嵌套层级不需要改表结构,只需补一条 path 规则,这正是「应用零改造加密」在文档场景下的具体体现。
需要强调的是,JSON Path 脱敏必须发生在「返回结果集、尚未交给客户端」的边界上,也就是数据库加密网关的协议解析层。网关作为应用与数据库之间的透明代理,既解析协议又不必改动两端,恰是脱敏插入的甜点位置。
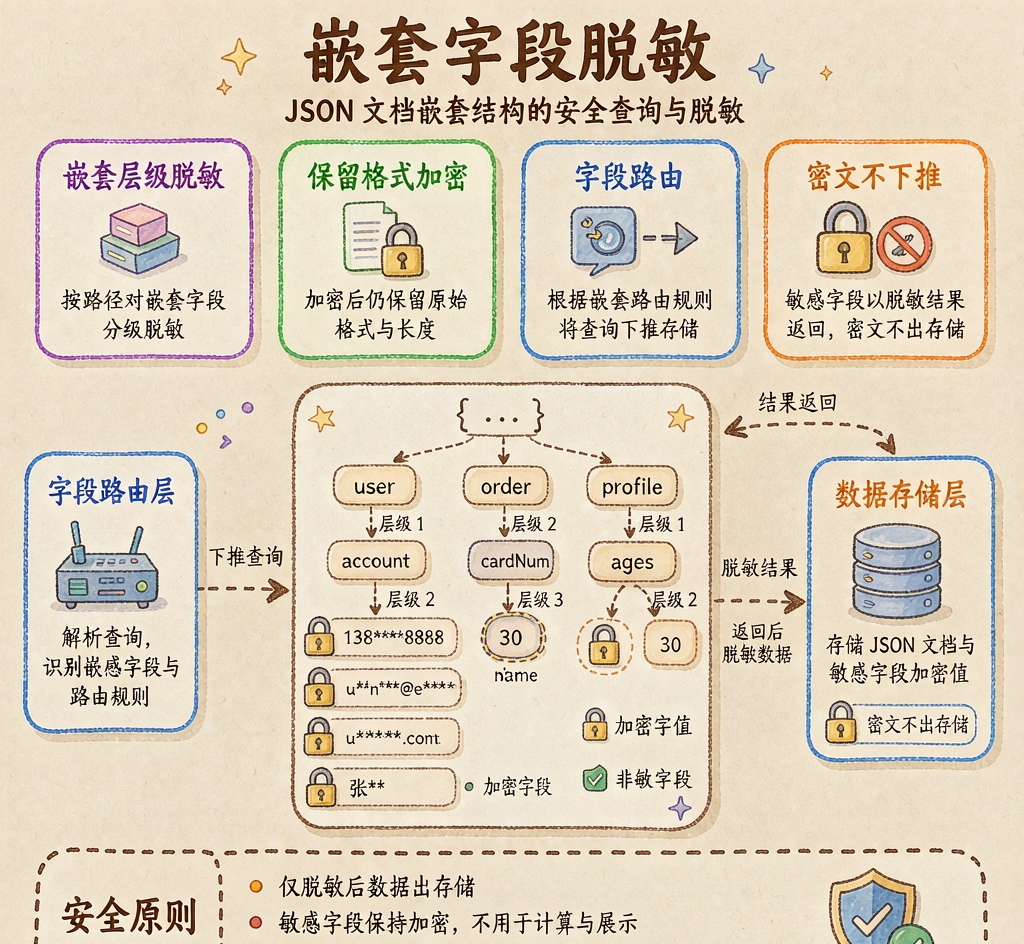
嵌套脱敏结构
三、嵌套 BSON 的递归脱敏:处理数组套对象
BSON 是文档库常见的二进制编码。对 BSON 做脱敏,难点不在单值,而在递归。一段设备上报数据可能是这样:
{
  "device_sn": "SN-8821-AX",
  "sensors": [
    {"type": "gps",  "loc": {"lat": 31.22, "lng": 121.47, "owner": "张三"}},
    {"type": "temp", "owner": "张三", "note": "现场联系人 13800001234"}
  ],
  "meta": {"operator": {"name": "张三", "phone": "13800001234"}}
}
注意 owner 出现在两处,phone 又藏在 meta.operator 里。如果只按顶层 key 匹配,会漏掉 sensors 数组内部。递归脱敏算法应当是树遍历:进入每个节点时先判定其类型,若是对象则继续下钻,若是数组则对元素逐个下钻,若是叶子字符串且路径命中规则,则原地替换。
def desensitize(node, rules, path="$"):
    if isinstance(node, dict):
        for k, v in node.items():
            node[k] = desensitize(v, rules, f"{path}.{k}")
        return node
    if isinstance(node, list):
        return [desensitize(e, rules, f"{path}[*]") for e in node]
    # 叶子节点
    if path in rules:
        return rules[path](node)
    return node
这段伪代码揭示了一个工程现实:递归脱敏的开销随嵌套深度线性增长。因此生产环境必须做两件事:路径剪枝只下钻命中规则前缀的子树,语句级缓存避免对同一结果集重复遍历。
四、函数下推:让加密字段也能走索引
嵌套脱敏解决了「看得见的泄露」,但没解决「查得出的性能」。文档库的强项之一是在存储引擎内部对嵌套字段建索引并下推过滤条件;一旦字段被加密或脱敏,普通密文不可检索,查询只能把整表拉到网关端再过滤。
业界通用方案在透明加密网关模式下提供保留格式加密(FPE)。FPE 密文与明文等长、同字符集,这一性质让两种查询得以下推:
- 等值查询:明文
13800001234的密文是确定值,网关把查询条件先 FPE 加密再下发,存储引擎用密文索引直接命中,无需回表。 - 前缀/范围查询:对手机号、证件号这类有结构的前缀字段,FPE 若按「分段密钥」设计,可保证相同前缀的明文映射到相同前缀的密文,于是
LIKE '138%'与BETWEEN范围比较都能在引擎内完成。
# 原始语句:应用发出,含嵌套路径 LIKE 条件
# SELECT doc FROM customer_doc
#   WHERE doc->>'$.orders[*].buyer.mobile' LIKE '138%';
#
# 网关下推到数据库的执行形态(条件已被 FPE 变换)
# SELECT doc FROM customer_doc WHERE fpe_col LIKE '951%';
# 说明:951 是 138 的密文前缀,索引与比较都在密文域完成
这里的关键是「函数下推」的执行位置:FPE 变换发生在网关侧、下发前,数据库看到的仍是密文条件,索引与比较都在密文域完成,明文不落盘、不外泄。与此同时,doc 列的嵌套脱敏(第二节的路径规则)在结果返回网关时再执行,实现「存储密文、检索可用、展示脱敏」并存。
需要说明一个边界:FPE 的前缀保真是有代价的——相同前缀的明文会聚合成相同的密文前缀,在统计意义上会泄露一点分布信息。对高敏感数据,应当把 FPE 前缀长度限制在业务必需的最小范围,或用「等值可用、前缀不可用」的纯确定性加密替换范围查询。这是加密网关在可用性与保密性之间的标准权衡,没有银弹。
五、关联键保真:图谱与文档为什么不能全字段脱敏
图库的核心是拓扑。一条「用户—下单—商品」的边,靠 customer_id 与 product_id 连接;若这两个键被脱敏成不可逆的随机值,且每次查询生成不同值,那么跨语句的图谱遍历就会断裂——上一跳拿到的 customer_id 与下一跳存储的 customer_id 对不上,整张图就废了。
因此关联键要走「保真」通道:它可以是明文(当键本身非敏感时),也可以是确定性加密(同一明文恒等映射同一密文),但必须保证跨语句、跨表一致。与之相对,实体属性里的敏感值(姓名、电话、住址)走「遮蔽」通道,按展示需要脱敏。两者在同一 JSON 文档里共存:
{
  "customer_id": "C10086",
  "name": "张*",
  "mobile": "138****1234",
  "orders": [{"order_id": "O775", "mobile": "138****1234"}]
}
保真键的命名应在脱敏策略里显式声明为 identity: true,让网关在递归脱敏时主动跳过这些路径,只对遮蔽字段动手。这样图谱遍历用 customer_id 照常工作,而任何面向人的输出都看不到真实姓名与电话。对文档库同理,文档 _id 与业务外键保持原值,嵌套的敏感子树才被改写。
还要提醒一点:保真键一旦明文存在,它就成为关联图谱的「锚」。若攻击者接触到数据库落盘文件(例如备份泄露),锚点本身虽不含明文秘密,但结合其他表可推导关系网。因此保真键应与字段级加密配合,必要时对锚点也做确定性加密,使落盘文件被拿走也无法直接拼出关系网。
六、查询性能:损耗从哪来,怎么压
透明加密网关在协议层插入了三件事:语句解析与重写、字段加解密、结果集脱敏遍历。它们各自带来开销。我们用一组内部压测口径(文档库、单节点、JSON 嵌套深度约 4 层、单文档含 3 个敏感路径)描述量级:
场景 | 平均 QPS | 相对裸库损耗 | 主要开销来源 |
|---|---|---|---|
裸库直连 | 32000 | 0% | 无 |
仅 FPE 等值查询下推 | 30500 | 约 4.7% | 条件 FPE 变换 |
FPE + 嵌套路径脱敏 | 29800 | 约 6.9% | 结果集递归改写 |
全量脱敏 + 深度递归 BSON | 28600 | 约 10.6% | 深嵌套树遍历 |
可以看到,损耗主要来自结果集的递归改写而非条件变换。优化抓手因此很清楚:
- 路径剪枝:只下钻命中规则前缀的子树,避免全文档遍历。
- 语句级缓存:同一 SELECT 的脱敏结果在一次事务内复用,减少重复遍历。
- 下推优先:凡是能转化成密文等值/前缀的条件,坚决下推到存储引擎,不让网关承担过滤。
- 批量向量化:对数组元素批处理而非逐元素函数调用,降低解释开销。
横向看,文档库的「数据库加密网关」在合理配置下把损耗控制在 5% 到 10% 区间是可预期的;当嵌套极深且必须全量递归时,损耗会逼近上限,此时应通过 schema 设计把高频敏感字段提到顶层路径,减少递归深度。
七、运维管控网关:明文存储 + 输出脱敏的另一条路
并非所有场景都适合把数据改成密文。有些遗留系统依赖数据库端的全文索引、触发器或存储过程,字段一旦加密,这些能力会失效。此时可切换到运维管控网关模式:数据仍以明文落库,网关只在「输出给人或给非可信连接」的边界做动态脱敏,把保护点从存储移到出口。运维管控网关正是为这类「数据库端能力不能动、但访问通道要收敛」的场景而设,它对 DBA、外包人员、远程接入的只读连接施加 SQL 级拦截与输出脱敏,业务主链路仍可走透明加密网关保住落盘安全。
两种模式的取舍:
维度 | 透明加密网关 | 运维管控网关 |
|---|---|---|
落盘形态 | 密文 | 明文 |
防拖库 | 强(拿到文件也无明文) | 弱(文件即明文) |
数据库端能力 | 受限(依赖 FPE 下推) | 完整保留 |
适用对象 | 业务应用读写 | 运维/分析/第三方只读 |
动态脱敏 | 支持 | 支持(主力能力) |
实践中常见组合:业务主链路走透明加密网关保住落盘安全,运维与分析通道走运维管控网关,对 DBA、外包人员、远程接入的只读连接施加 SQL 级拦截与输出脱敏。
八、SQL 级拦截与全量审计:脱敏不是终点
动态脱敏解决「看到什么」,但内部数据泄露的另一条主因是「越权查」。一个客服本应只查自己区域的订单,却用 SELECT * 把全表拉走;一个外包运维直接 COPY 整库。运维管控网关的能力因此要延伸到语句层:
# 拦截高风险语句示例(网关侧策略)
# DENY  COPY customer_doc TO STDOUT;          -- 禁止整库导出
# DENY  SELECT * FROM customer_doc WHERE 1=1; -- 禁止无区域限定全表扫
# ALLOW SELECT doc FROM customer_doc
#       WHERE region = :staff_region;          -- 仅放行带区域绑定
这类规则配合全量审计落地:每一条经过网关的语句、命中的脱敏路径、返回的字段清单都进入审计流水,事后可按人、按时间、按表回溯「谁在什么时刻看过了哪些敏感字段」。对内部数据泄露的治理,审计的威慑与可追溯性往往比单点加密更关键。
需要澄清一个常见误解:审计不是「装上了就安全」。审计内容应只记录「访问了哪些路径、命中了哪条规则、返回行数」,不落原始敏感内容;原始值只在会话内短暂存在,随响应返回后即销毁。
九、落地时容易踩的坑
第一,过度脱敏。把关联键也一并遮蔽,查询会当场瘫痪。记住:保真键与遮蔽字段要分开声明。
第二,把 FPE 当万能。FPE 保前缀带来分布泄露,对高敏感、低基数字段不宜使用,这类字段加密后等同于明文分组。
第三,只在应用层做脱敏。应用层脱敏意味着每条读路径都要改代码,既违背「应用零改造加密」,又无法约束运维通道与第三方连接。
第四,忽略协议解析的边界。网关必须能解析所用驱动协议(MySQL 文本/二进制协议、PG 的扩展查询、Oracle 的 TNS 等),否则无法在正确的结果集位置插入脱敏。数据库矩阵越宽,协议覆盖越要扎实,主流与国产数据库都要纳入同一套路径规则体系。
第五,密钥与数据同库。字段级加密的密钥必须由独立的密钥服务管理,绝不能把密钥放在数据库同实例。
十、小结与延伸
半结构化数据的字段级加密与动态脱敏,本质是「在路径维度重建脱敏单元」:用 JSON Path 定位嵌套敏感字段,用递归遍历覆盖 BSON 的数组套对象,用 FPE 与函数下推保住密文域的检索能力,用关联键保真维持图谱与文档的拓扑可用,最后用 SQL 级拦截与全量审计堵住越权查询。每一层都有独立的性能与语义权衡,没有哪个开关能一键解决全部。
当业务从关系表走向文档与图,脱敏复杂度从「列」跃迁到「路径 + 拓扑」。越早把路径规则、保真键声明、密钥来源三件事在架构层面定清楚,后续边际成本就越低。
补充一个常被忽视的工程点:字符集与排序规则。FPE 的字母表必须与实际字段字符集严格对齐,否则密文无法回填、索引比较错乱——手机号、身份证是纯数字字母表,而姓名含多字节汉字,用数字字母表做 FPE 会失败,这类字段更适合掩码或不可逆哈希。另外不同数据库的排序规则(collation)会影响字符串比较语义,网关做密文等值下推时需保证客户端、网关、存储引擎三处排序规则一致,否则同一明文可能映射到不等价的密文比较结果,导致漏查或误查。
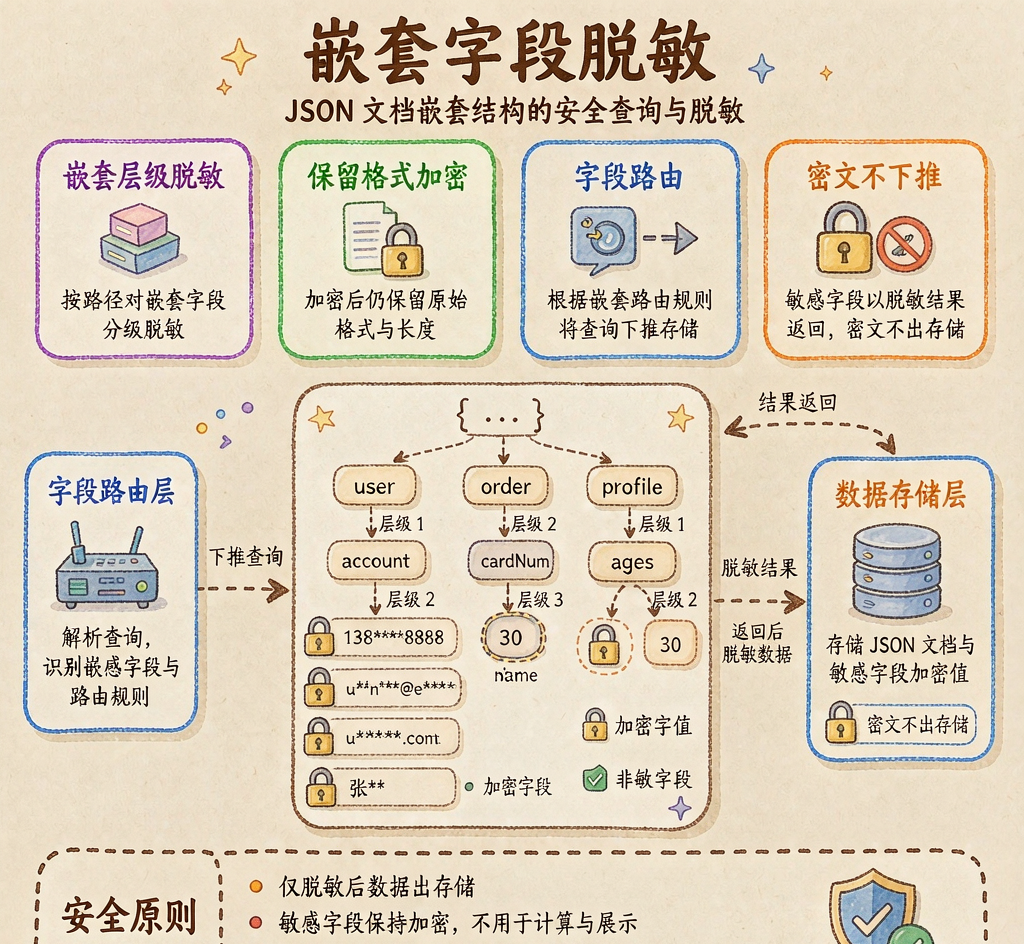
函数下推性能
方案参考
对于准备在半结构化数据上落地字段级加密与脱敏的团队,下面几条是通用的方法论,不依赖具体产品:
一是先梳理数据地图,再定规则。动手写脱敏策略前,先把文档 schema 的嵌套层级、数组形态、敏感字段所在路径画清楚,区分哪些路径是关联键(需保真)、哪些是需要遮蔽的内容字段。规则必须基于真实 schema 而非想象,否则上线即漏。在落地实践中,可参考安当DBG等数据库加密网关类产品,将字段路径解析与函数下推能力嵌入其双模式代理结构。
二是按「存储密文 or 输出脱敏」两条路线分别评估。若数据库端有强依赖明文的能力(全文索引、触发器、存储过程),优先考虑出口脱敏;若首要威胁是拖库与备份泄露,优先考虑落盘加密。两条路线可并行服务于不同通道。
三是把检索需求前置到加密方案选型。凡有前缀、范围、LIKE 查询的字段,需确认所选加密是否支持在密文域完成这些算子;不支持就要评估能否改为确定性加密或把查询下推。检索能力应在设计期验证,而非上线后发现查不动。
四是密钥与数据必须分治。密钥服务独立部署、独立授权、独立审计,密钥轮换要有明确周期与回滚预案。任何把密钥与数据放在同一故障域的做法,都会让字段级加密的保密性承诺落空。
五是审计要可回溯且不含原始敏感值。审计流水记录「谁、何时、访问了哪些路径、命中哪条规则、返回多少行」,但不落原始内容。审计的价值在于威慑与溯源,而非再造一个明文副本。
六是把性能压测纳入验收。半结构化字段的脱敏损耗主要来自结果集的递归改写,应在接近生产的文档深度与数组规模下测 QPS 与延迟,针对路径剪枝、语句级缓存、下推优先等优化点逐项验收,确认损耗落在可接受区间后再全量切换。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号