干货!MySql实战01:一条SQL查询语句执行大揭秘!
原创
干货!MySql实战01:一条SQL查询语句执行大揭秘!
原创
ProcessOn
发布于 2026-10-12 14:09:07
发布于 2026-10-12 14:09:07
大家好,这篇文章我们聊MySql的基础架构。
相信各位猿都深有体会,数据库中最最常用的sql就是查询语句了,那么一条SQL查询语句的底层是如何执行的呢?比如,你有个最简单的表,表里只有一个 ID 字段,在执行下面这个查询语句时:
mysql> select * from T where ID = 100;
往往大家只是看到我输入了一条语句,然后返回了一个结果,却不知道这条语句在MySql内部的执行过程。下面我们好好聊一下这个过程:
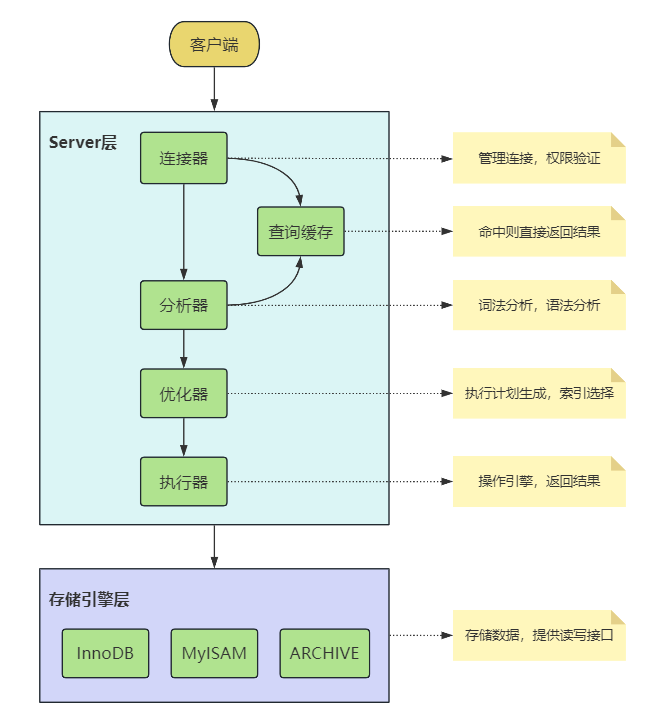
从上面给出的MySql逻辑架构图我们可以看到,MySql大体分为Server层和存储引擎层两部分。
Server层:
包括连接器、查询缓存、分析器、优化器、执行器等,涵盖 MySQL 的大多数核心服务功能,以及所有的内置函数(如日期、时间、数学和加密函数等),所有跨存储引擎的功能都在这一层实现,比如存储过程、触发器、视图等。
存储引擎层:
负责数据的存储和提取。其架构模式是插件式的,支持 InnoDB、MyISAM、Memory 等多个存储引擎。InnoDB从 MySQL 5.5.5 版本开始成为了默认存储引擎。不同的存储引擎共用一个 Server 层,也就是从连接器到执行器的部分。
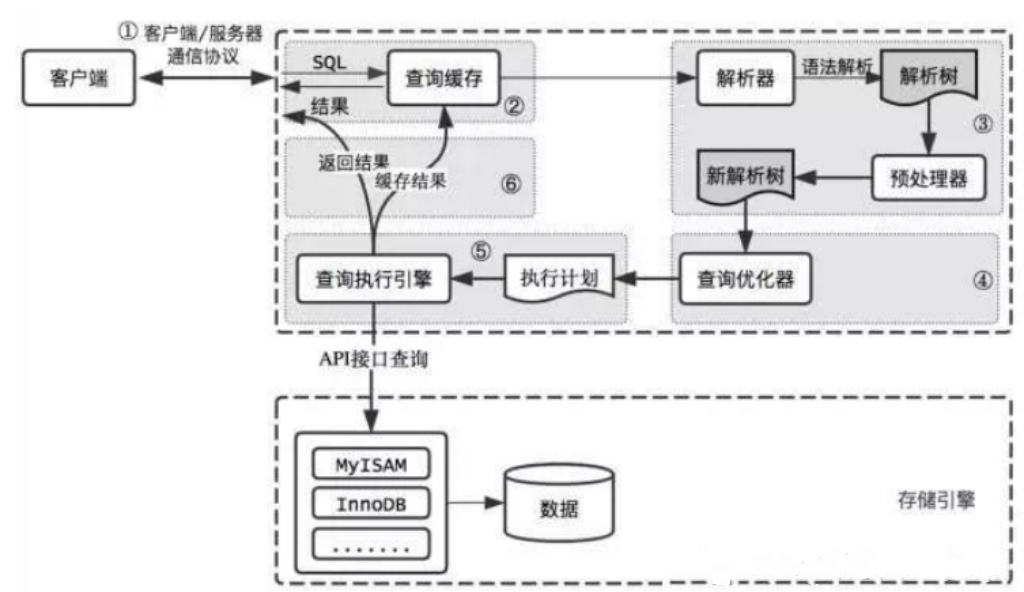
存储引擎层
连接器
系统(客户端)访问 MySQL 服务器前,做的第一件事就是建立 TCP 连接。经过三次握手建立连接成功后,MySQL 服务器对 TCP 传输过来的账号密码做身份认证、权限获取。
TCP 连接收到请求后,必须要分配给一个线程专门与这个客户端的交互。所以还会有个线程池,去走后面的流程。每一个连接从线程池中获取线程,省去了创建和销毁线程的开销。
mysql -h$ip -P$port -u$user -p
连接命令中的 mysql 是客户端工具,用来跟服务端建立连接。在完成经典的 TCP 握手后,连接器就要开始认证你的身份,这个时候用的就是你输入的用户名和密码。
- 如果用户名或密码不对,你就会收到一个"Access denied for user"的错误,然后客户端程序结束执行。
- 如果用户名密码认证通过,连接器会到权限表里面查出你拥有的权限。之后,这个连接里面的权限判断逻辑,都将依赖于此时读到的权限。
注意:一个用户成功建立连接后,即使你用管理员账号对这个用户的权限做了修改,也不会影响已经存在连接的权限。修改完成后,只有再新建的连接才会使用新的权限设置。
连接完成后,如果你没有后续的动作,这个连接就处于空闲状态,你可以在 show processlist 命令中看到它。其中的 Command 列显示为“Sleep”的这一行,就表示现在系统里面有很多空闲连接。
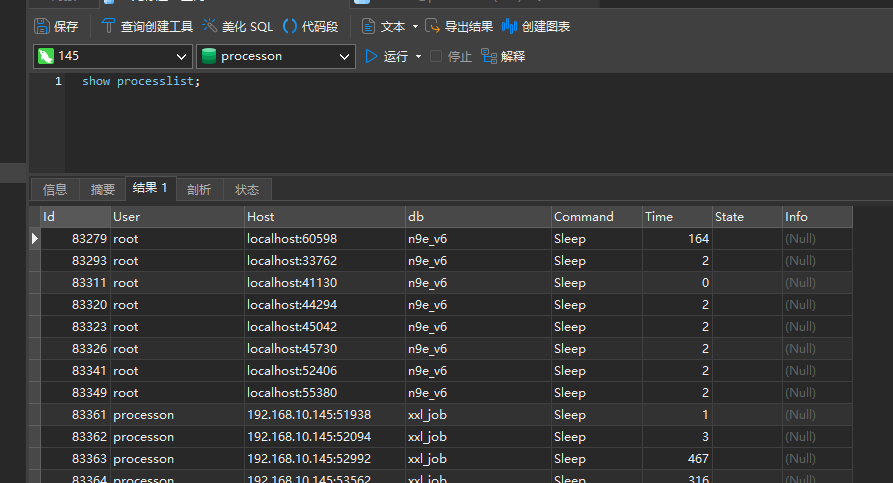
MySQL 连接器
客户端如果太长时间没动静,连接器就会自动将它断开。这个时间是由参数 wait_timeout 控制的,默认值是 8 小时。
如果在连接被断开之后,客户端再次发送请求的话,就会收到一个错误提醒: Lost connection to MySQL server during query。这时候如果你要继续,就需要重连,然后再执行请求了。
长连接:是指连接成功后,如果客户端持续有请求,则一直使用同一个连接。
短连接:则是指每次执行完很少的几次查询就断开连接,下次查询再重新建立一个。
建立连接的过程通常是比较复杂的,在使用中要尽量减少建立连接的动作,尽量使用长连接。
但是全部使用长连接后,你可能会发现,有些时候 MySQL 占用内存涨得特别快,这是因为 MySQL 在执行过程中临时使用的内存是管理在连接对象里面的。这些资源会在连接断开的时候才释放。所以如果长连接累积下来,可能导致内存占用太大,被系统强行杀掉(OOM),从现象看就是 MySQL 异常重启了。
你可以考虑以下两种方案来解决这个问题:
- 定期断开长连接。使用一段时间,或者程序里面判断执行过一个占用内存的大查询后,断开连接,之后要查询再重连。
- 如果你用的是 MySQL 5.7 或更新版本,可以在每次执行一个比较大的操作后,通过执行 mysql_reset_connection 来重新初始化连接资源。这个过程不需要重连和重新做权限验证,但是会将连接恢复到刚刚创建完时的状态。
查询缓存
顾名思义,此模块就是传统的先查询缓存,缓存命中了直接返回,不命中则继续向下执行,大家了解一下即可,这里不做过多介绍,因为MySQL 8.0 版本直接将查询缓存的整块功能删掉了,也就是说 8.0 开始彻底没有这个功能了。
分析器
如果没有命中查询缓存,就要开始真正执行语句了。首先,MySQL 需要知道你要做什么,因此需要对 SQL 语句做解析。
MySQL分析器(也被称为解析器或Analyzer)是MySQL查询执行过程中的一个关键组件,它主要负责解析和处理SQL语句,确保它们的语法正确,并将其转换为数据库能够理解和执行的格式。
1. 词法分析(Lexical Analysis)
将输入的SQL字符串分解成一系列的词法单元(tokens),如关键字(SELECT、FROM、WHERE等)、标识符(表名、列名等)、运算符、常量等。
你输入的是由多个字符串和空格组成的一条 SQL 语句,MySQL 需要识别出里面的字符串分别是什么,代表什么。
MySQL 从你输入的"select"这个关键字识别出来,这是一个查询语句。它也要把字符串“T”识别成“表名 T”,把字符串“ID”识别成“列 ID”。
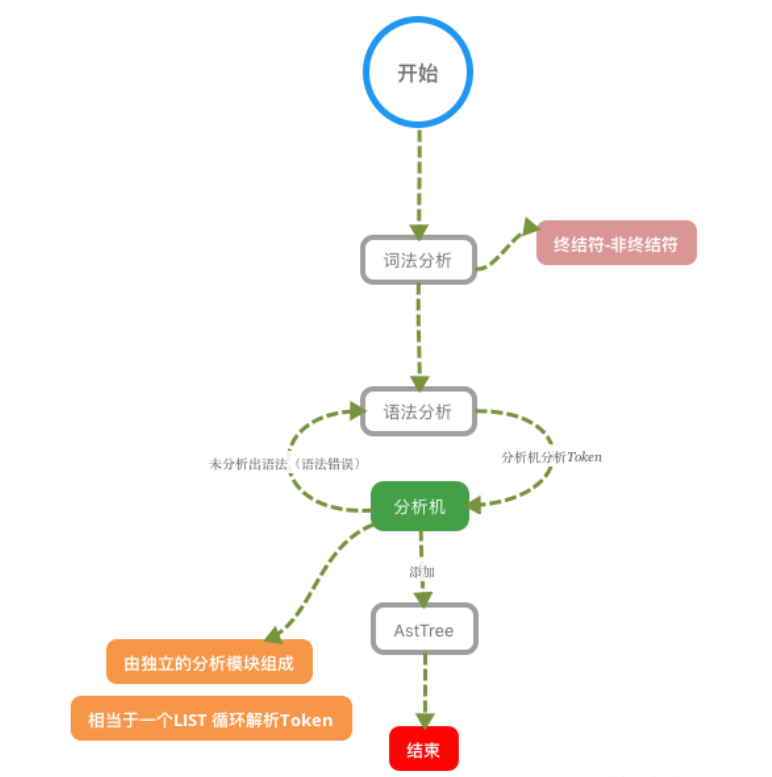
MySQL 分析器
2. 语法分析(Syntax Analysis)
根据MySQL的语法规则,将词法分析阶段生成的词法单元组织成一个语法树(Syntax Tree)或抽象语法树(Abstract Syntax Tree,AST)。来判断你输入的这个 SQL 语句是否满足 MySQL 语法。
如果你的语句不对,就会收到“You have an error in your SQL syntax”的错误提醒,比如下面这个语句 select 少打了开头的字母“s”。
mysql> elect * from t where ID=1;
ERROR 1064 (42000):
You have an error in your SQL syntax;
check the manual that corresponds to your MySQL server version for the right syntax to use near 'elect *
from t where ID=1' at line 1
一般语法错误会提示第一个出现错误的位置,所以你要关注的是紧接“use near”的内容。
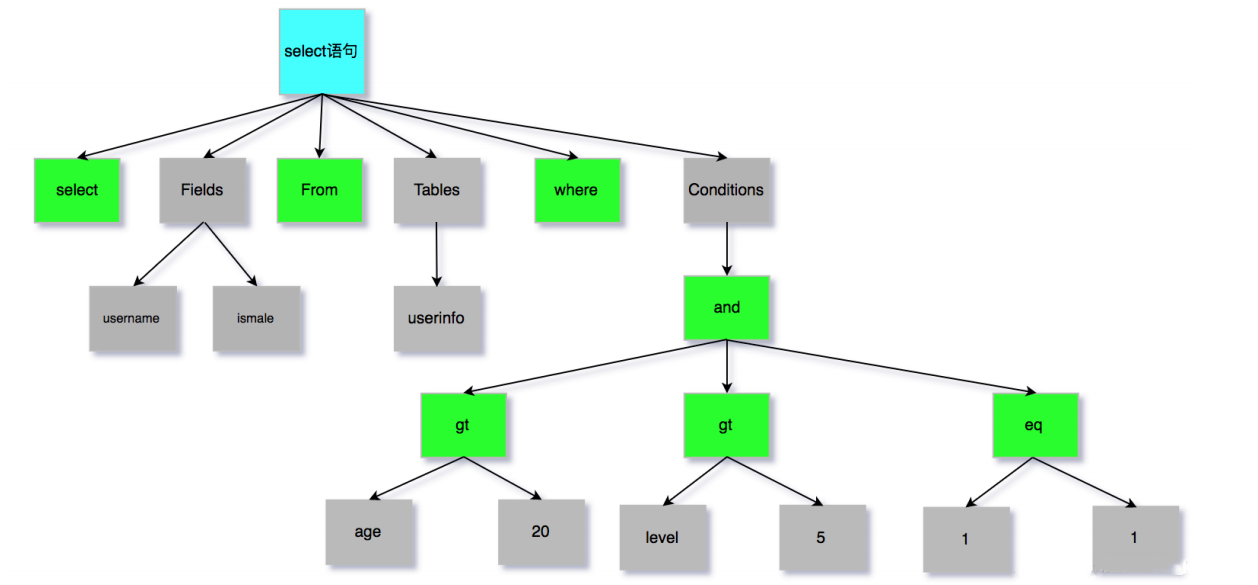
3. 语义分析(Semantic Analysis)
在语法正确的基础上,对SQL语句进行语义检查。验证SQL语句中的表、列、函数等是否存在,并检查它们之间的引用关系、数据类型是否匹配等。
优化器
经过了分析器,MySQL 就知道你要做什么了。在开始执行之前,还要先经过优化器的处理。
优化器是在表里面有多个索引的时候,决定使用哪个索引;或者在一个语句有多表关联(join)的时候,决定各个表的连接顺序。比如你执行下面这样的语句,这个语句是执行两个表的 join:
mysql> select * from t1 join t2 using(ID) where t1.c=10 and t2.d=20;
- 既可以先从表 t1 里面取出 c=10 的记录的ID 值,再根据 ID 值关联到表 t2,再判断 t2 里面 d 的值是否等于 20。
- 也可以先从表 t2 里面取出 d=20 的记录的 ID 值,再根据 ID 值关联到 t1,再判断 t1 里面 c 的值是否等于 10。
这两种执行方法的逻辑结果是一样的,但是执行的效率会有不同,而优化器的作用就是决定选择使用哪一个方案。优化器阶段完成后,这个语句的执行方案就确定下来了,然后进入执行器阶段。
执行器
MySQL 通过分析器知道了你要做什么,通过优化器知道了该怎么做,于是就进入了执行器阶段,开始执行语句。
开始执行的时候,要先判断一下你对这个表 T 有没有执行查询的权限,如果没有,就会返回没有权限的错误,如下所示 (在工程实现上,如果命中查询缓存,会在查询缓存返回结果的时候,做权限验证。查询也会在优化器之前调用 precheck 验证权限)。
mysql> select * from T where ID=10;
ERROR 1142 (42000): SELECT command denied to user 'b'@'localhost' for table 'T'
如果有权限,就打开表继续执行。打开表的时候,执行器就会根据表的引擎定义,去使用这个引擎提供的接口。
比如我们这个例子中的表 T 中,ID 字段没有索引,那么执行器的执行流程是这样的:
- 调用 InnoDB 引擎接口取这个表的第一行,判断 ID 值是不是 10,如果不是则跳过,如果是则将这行存在结果集中;
- 调用引擎接口取“下一行”,重复相同的判断逻辑,直到取到这个表的最后一行。
- 执行器将上述遍历过程中所有满足条件的行组成的记录集作为结果集返回给客户端。
至此,这个语句就执行完成了。
对于有索引的表,执行的逻辑也差不多。第一次调用的是“取满足条件的第一行”这个接口,之后循环取“满足条件的下一行”这个接口,这些接口都是引擎中已经定义好的。
你会在数据库的慢查询日志中看到一个 rows_examined 的字段,表示这个语句执行过程中扫描了多少行。这个值就是在执行器每次调用引擎获取数据行的时候累加的。
在有些场景下,执行器调用一次,在引擎内部则扫描了多行,因此引擎扫描行数跟 rows_examined 并不是完全相同的。
小结
MySQL 的逻辑架构今天就讲到这里,希望你对一个 SQL 语句完整执行流程的各个阶段有了一个初步的印象。
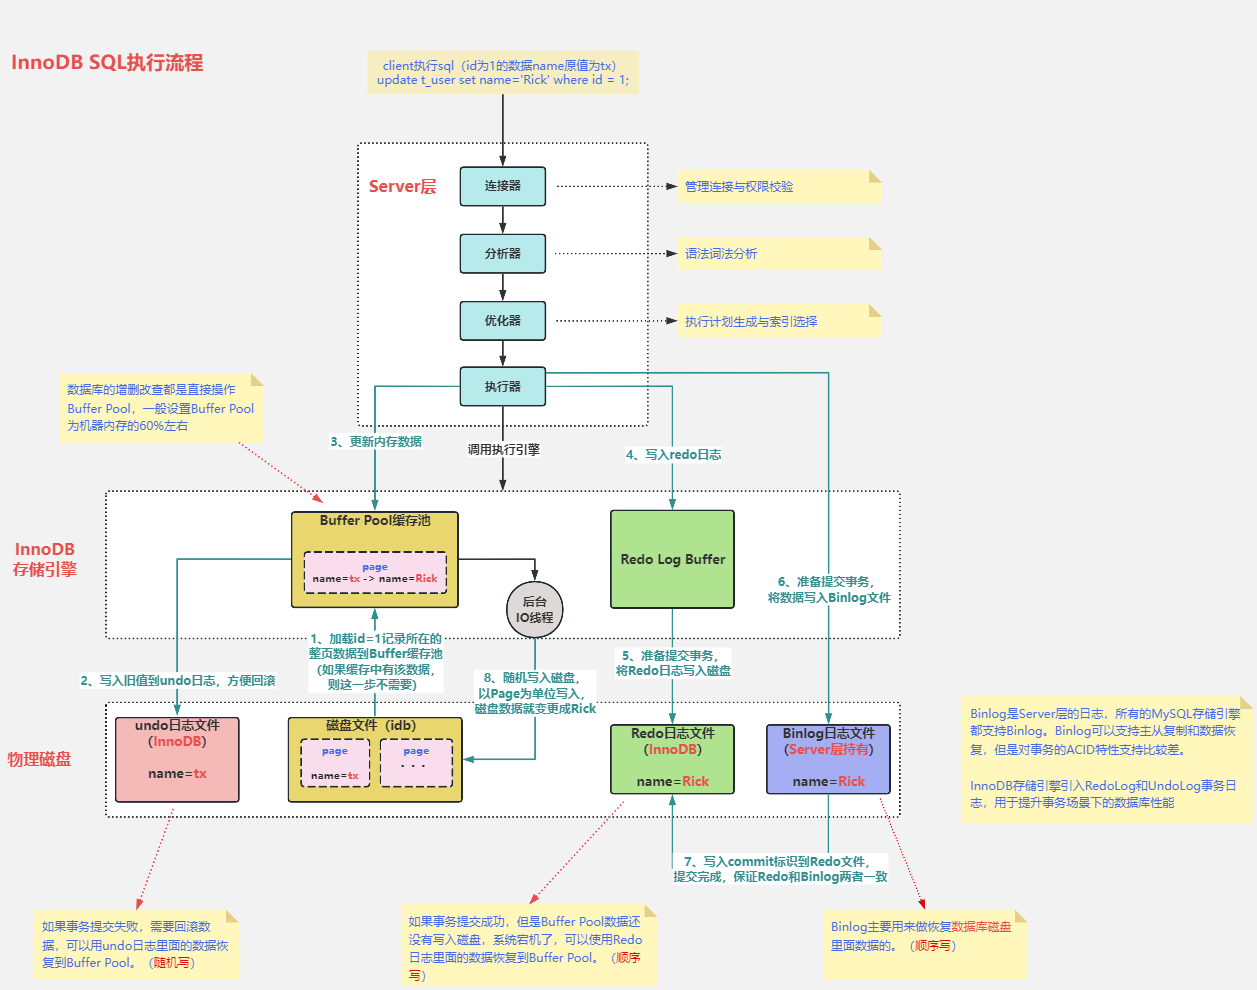
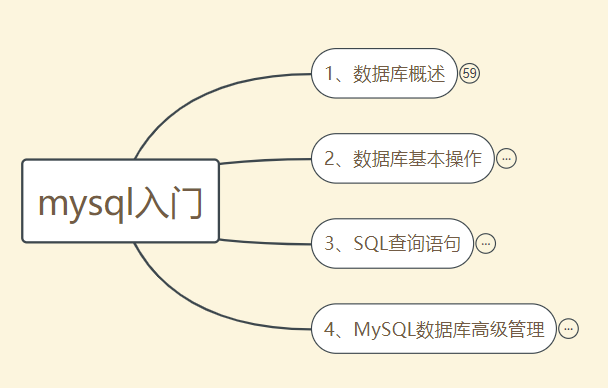
推荐几个社区内其它比较优秀的模版,感兴趣的同学可以参考学习
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号