Prometheus已经能监控服务器,为什么还是看不到MySQL状态?我用mysqld_exporter把9105指标和告警链路接起来了

Prometheus已经能监控服务器,为什么还是看不到MySQL状态?我用mysqld_exporter把9105指标和告警链路接起来了
fruge365
发布于 2026-10-13 08:21:44
发布于 2026-10-13 08:21:44
Prometheus已经能监控服务器,为什么还是看不到MySQL状态?我用mysqld_exporter把9105指标和告警链路接起来了
前言
Prometheus已经能看服务器CPU、内存,不代表它天然就知道MySQL现在有多少连接、慢查询有没有突增、主从复制是不是异常。数据库内部这些状态,需要有人先把它们转换成Prometheus能抓取的指标,这正是mysqld_exporter在整条链路里的位置。
这次我在CentOS 7上把这条链从头走了一遍:先下载并启动mysqld_exporter,让它通过9105暴露指标;再把Prometheus指向这个端点,确认Target能够正常抓取;随后加入MySQL宕机、复制异常、连接数过高、慢查询等告警规则,并实际验证MySQL停止后告警出现、恢复后状态回归。
后半部分再处理一个更现实的问题:如果Prometheus和MySQL不在同一局域网,怎样让远端Prometheus继续抓到9105指标。这里会先验证随机公网地址,再配置固定二级子域名。
不过这篇配置里有几处不能机械照抄:授权用户写的是mysqld_exporter,客户端配置却写成exporter;systemd路径和手动启动路径也分别用了mysqld_exporter与mysql_exporter。这些代码我会原样保留,但把风险位置明确指出。
对我来说,这类监控最重要的不是“多一个页面”,而是出了问题以后能不能马上知道问题在哪一层:是MySQL本身没启动、连接数接近上限、复制延迟,还是exporter根本没有采集成功。把这几个环节拆开验证,后面的排障会比只看日志清楚很多。
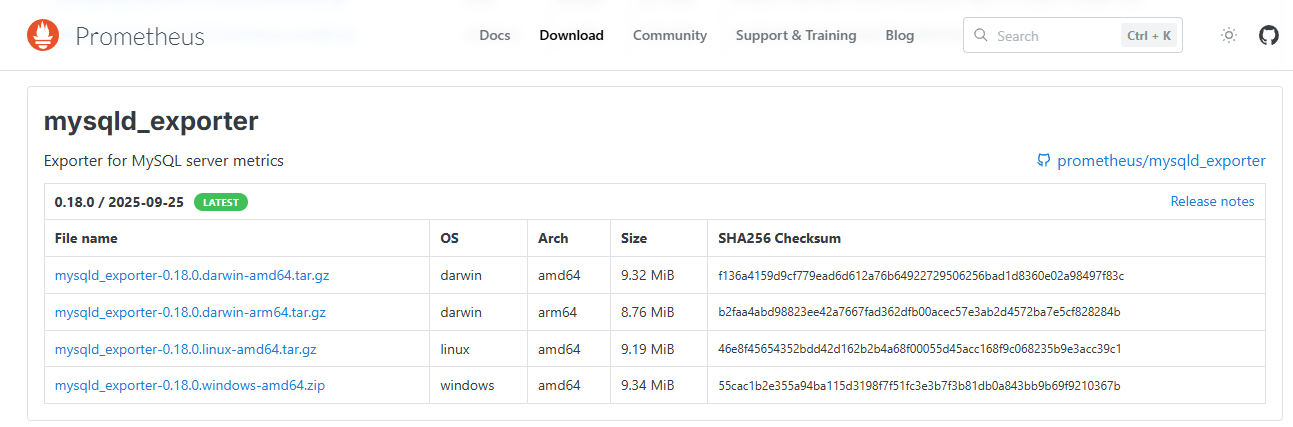
image-20251124142636252
1 先把MySQL监控链路的角色分清
这篇最重要的不是记命令,而是先看懂四层关系:
MySQL → mysqld_exporter → Prometheus → 告警规则
MySQL 本身提供运行状态。
mysqld_exporter 负责读取这些状态,并转换成 Prometheus 能抓取的指标。
Prometheus 再定期抓取 9105,把指标保存下来并用于查询、规则评估和告警判断。
所以 mysqld_exporter 更像一座桥。
没有这座桥,Prometheus 并不会凭空知道 MySQL 内部的连接数、复制状态和慢查询情况。
2 下载mysqld_exporter
在 Prometheus 相关下载页面获取 Linux 版本:
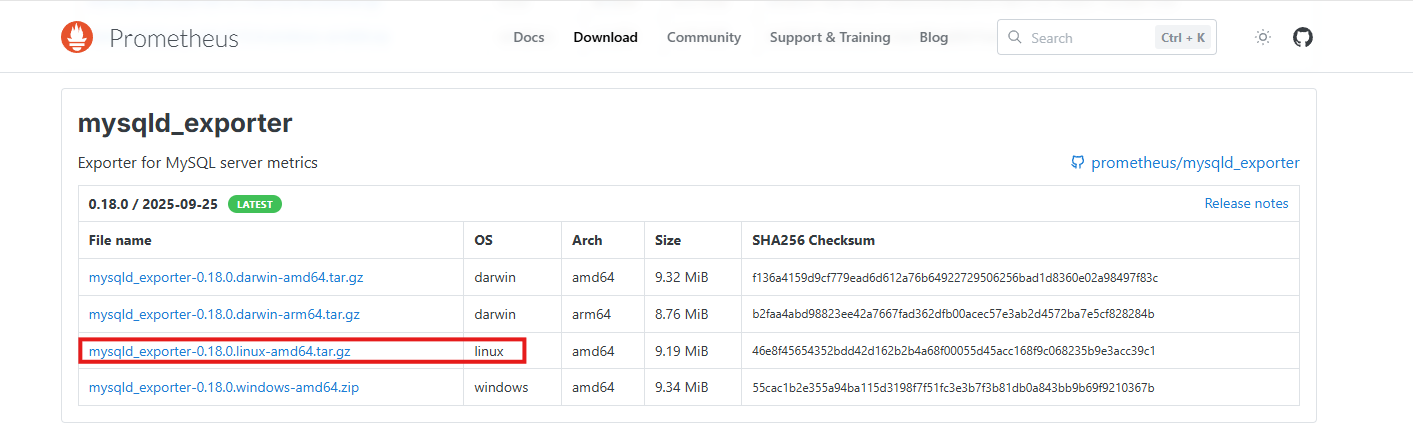
image-20251124150101916
下载后上传到 /app:

image-20251124150459790
也可以使用命令:
wget
https://github.com/prometheus/mysqld_exporter/releases/download/v0.18.0/mysqld_exporter-0.18.0.linux-amd64.tar.gz
这里有一个细节值得注意。
代码块把:
wget
和下载 URL 分成了两行。
如果终端直接逐行执行,第一行只会执行一个不带参数的 wget。
真正执行时应该先确认命令格式,而不是机械复制。
3 解压并整理目录
执行:
tar -zxvf mysqld_exporter-0.18.0.linux-amd64.tar.gz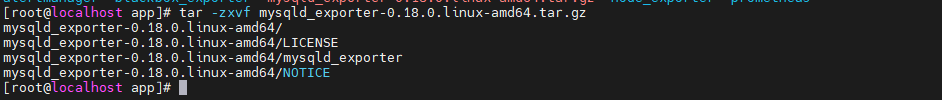
image-20251124150544662
然后改名:
mv mysqld_exporter-0.18.0.linux-amd64/ mysqld_exporter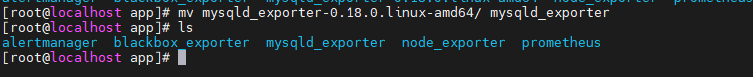
image-20251124152121251
最终目录是:
/app/mysqld_exporter
后面的 systemd 配置也会用到这个路径。
4 给监控单独创建MySQL账号
在 MySQL 中执行:
GRANT REPLICATION CLIENT, PROCESS ON *.* TO 'mysqld_exporter'@'localhost' identified by '12345678';
GRANT SELECT ON performance_schema.* TO 'mysqld_exporter'@'localhost';
flush privileges;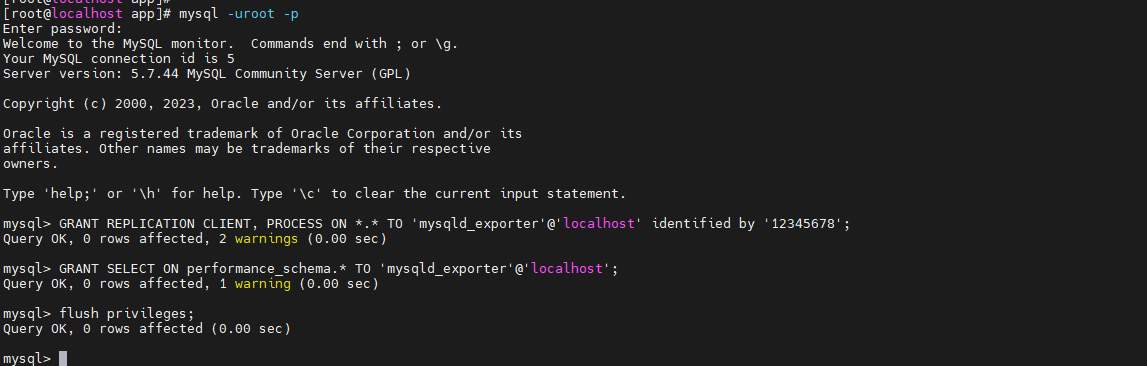
image-20251124173648818
这里创建的是:
mysqld_exporter@localhost
并授予:
REPLICATION CLIENTPROCESSperformance_schema.*的SELECT
这比直接用 root 账号给 exporter 连接数据库更合理。
监控账号只拿采集指标需要的权限,长期维护也更容易控制。
5 客户端配置里的用户名和前面不一致
接下来配置文件写的是:
[client]
user=exporter
password=12345678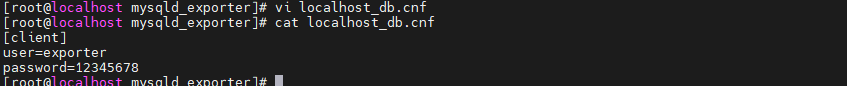
image-20251124164410692
这里用户名变成了:
exporter
而前面真正授权的是:
mysqld_exporter
这两者并不一致。
如果数据库里没有额外创建 exporter 用户,那么 exporter 启动以后很可能因为认证失败而无法采集。
所以真正执行时,必须让:
MySQL创建的用户名
和:
客户端配置中的 user
保持一致。
代码块按照已有操作原样保留,不在这里偷偷替换。
6 创建mysqld_exporter systemd服务
服务配置:
[Unit]
Description=exporter
After=network.target
[Service]
Type=simple
User=prometheus
ExecStart=/app/mysqld_exporter/mysqld_exporter --config.my-cnf="/app/mysqld_exporter/localhost_db.cnf" --web.listen-address=":9105"
Restart=on-failure
[Install]
WantedBy=multi-user.target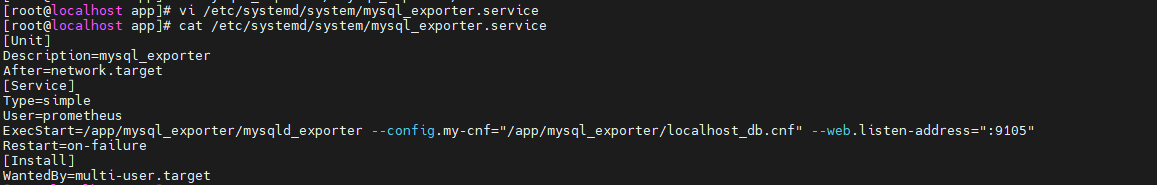
这里有三个关键点:
- 运行用户:
prometheus - 配置文件:
/app/mysqld_exporter/localhost_db.cnf - 监听地址:
:9105
因此如果后面服务启动失败,优先检查:
- 系统里是否真的存在
prometheus用户; /app/mysqld_exporter/mysqld_exporter是否存在;- 配置文件路径是否正确;
prometheus用户是否有读取权限。
7 手动启动命令又出现了另一套目录名
手动方式是:
sudo -u prometheus /app/mysql_exporter/mysqld_exporter --config.my-cnf="/app/mysql_exporter/localhost_db.cnf" --web.listen-address=":9105"这里使用的是:
/app/mysql_exporter/
而前面实际改名后的目录是:
/app/mysqld_exporter/
也就是说:
mysqld_exporter
和:
mysql_exporter
在路径里混用了。
这不是单纯的写法差异,而会直接影响命令能不能找到文件。
如果 systemd 方式能启动,但手动方式报“文件不存在”,应该先核对这个路径。
8 先确认9105指标页面能打开
浏览器通过服务器 IP 加 9105 访问:
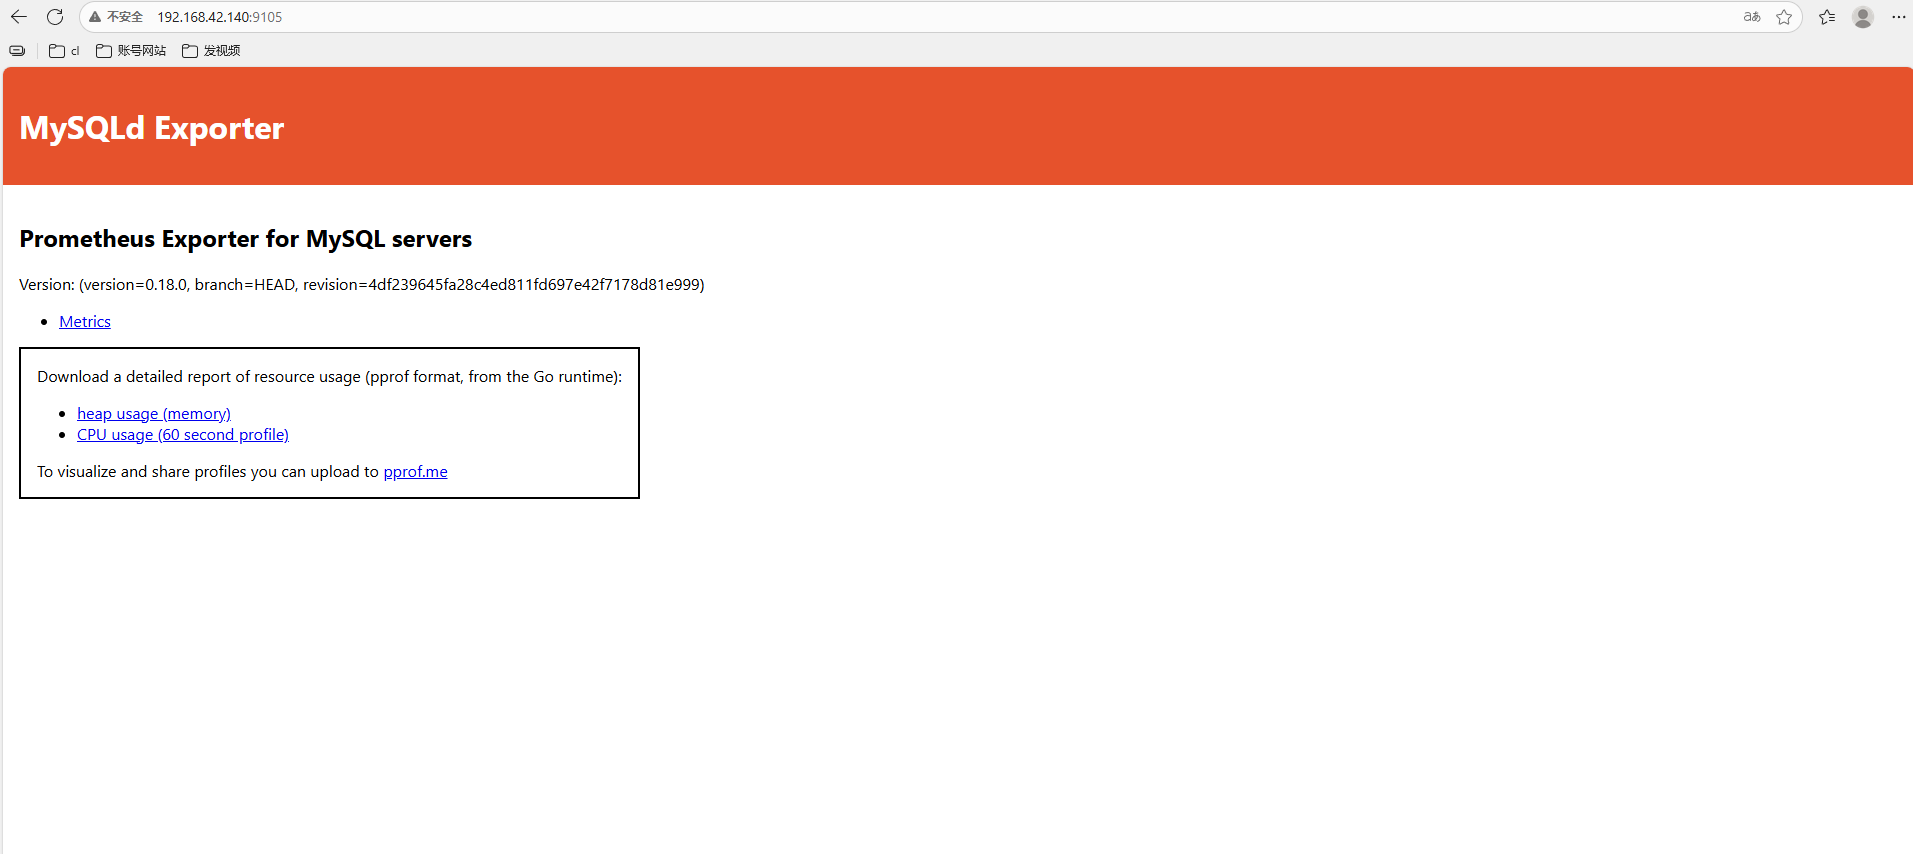
image-20251124175742970
这一步能证明的是:
mysqld_exporter进程已经监听9105,并且Web端点可访问。
如果这一步失败,就不要急着去改 Prometheus。
先把 exporter 自身跑通。
9 再把Prometheus指向9105
编辑配置文件:
vi prometheus.yml加入目标:
      - targets: ["localhost:9105"]
        labels:
          app: "mysql_exporter"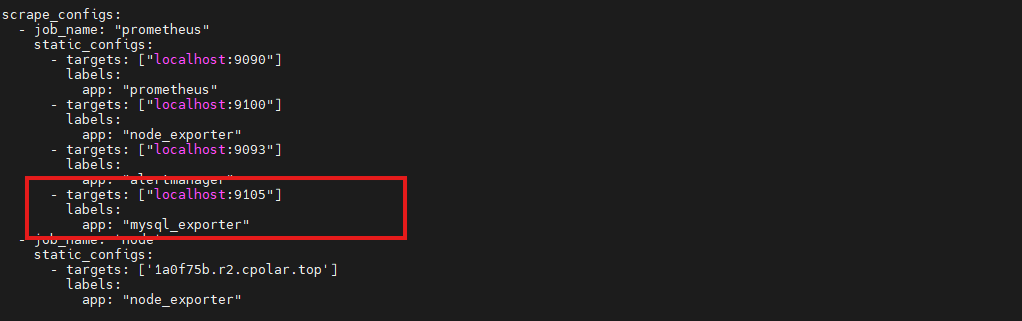
image-20251125104102393
然后重启 Prometheus:
systemctl restart prometheus打开 Prometheus 9090:
image-20251125103926501
Target 被检测到:
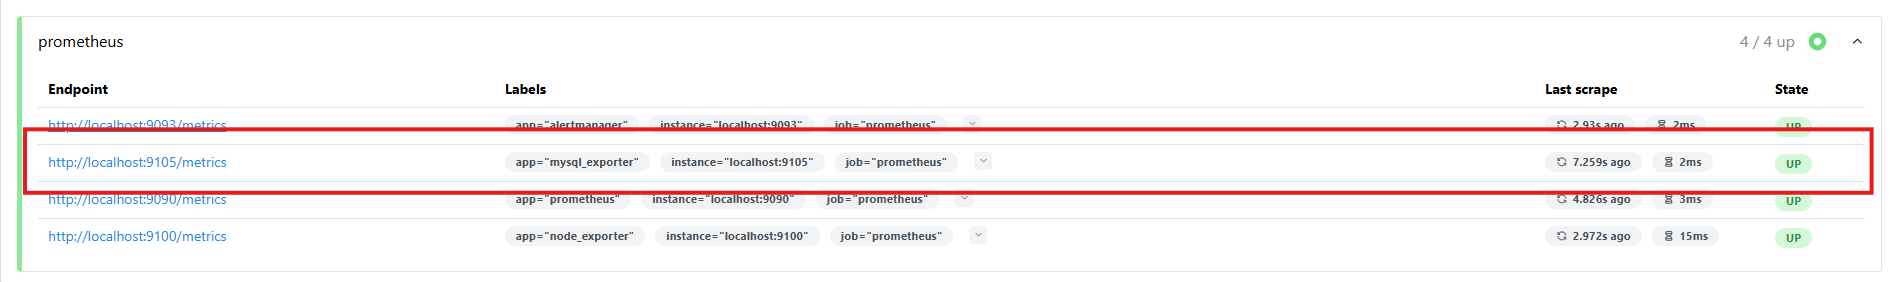
image-20251125104153997
做到这里,才算真正打通:
MySQL → mysqld_exporter:9105 → Prometheus
10 这段Target配置只是局部片段
示例里只展示了:
targets
和:
labels
但没有把完整的 scrape_configs、job_name 一起展示。
所以如果直接把这两行粘贴到 prometheus.yml 任意位置,配置未必有效。
真正执行时,应该确认它位于正确的 scrape job 下面。
这篇保留现有片段,但不把它描述成可以脱离上下文直接复制的完整配置。
11 加入MySQL告警规则
示例规则如下:
groups:
- name: mysql-alerts
  rules:

  # 1. MySQL 实例宕机或 exporter 无法采集
  - alert: MySQLDown
    expr: mysql_up == 0
    for: 1m
    labels:
      severity: critical
    annotations:
      summary: "MySQL instance down"
      description: "MySQL instance {{ $labels.instance }} has been down for more than 1 minute."

  # 2. 主从复制中断(仅适用于有从库的场景)
  - alert: MySQLReplicationBroken
    expr: mysql_slave_status_seconds_behind_master > 300
    for: 2m
    labels:
      severity: warning
    annotations:
      summary: "MySQL replication lag"
      description: "MySQL replication on {{ $labels.instance }} is lagging by {{ $value }} seconds."

  # 3. 主从 IO/SQL 线程停止
  - alert: MySQLReplicationIOThreadDown
    expr: mysql_slave_status_master_server_id > 0 and mysql_slave_status_slave_io_running == 0
    for: 1m
    labels:
      severity: critical
    annotations:
      summary: "MySQL replication IO thread stopped"
      description: "Slave IO thread is not running on {{ $labels.instance }}."

  - alert: MySQLReplicationSQLThreadDown
    expr: mysql_slave_status_master_server_id > 0 and mysql_slave_status_slave_sql_running == 0
    for: 1m
    labels:
      severity: critical
    annotations:
      summary: "MySQL replication SQL thread stopped"
      description: "Slave SQL thread is not running on {{ $labels.instance }}."

  # 4. 连接数使用率过高(超过 80%)
  - alert: MySQLTooManyConnections
    expr: (mysql_global_status_threads_connected / mysql_global_variables_max_connections) * 100 > 80
    for: 2m
    labels:
      severity: warning
    annotations:
      summary: "High MySQL connection usage"
      description: "{{ $labels.instance }}: MySQL connection usage is {{ $value | printf \"%.2f\" }}% of max_connections."

  # 5. 慢查询数量突增(过去5分钟慢查询 > 10 条)
  - alert: MySQLHighSlowQueries
    expr: rate(mysql_global_status_slow_queries[5m]) > 0.1  # ≈ 每分钟 > 6 条
    for: 5m
    labels:
      severity: warning
    annotations:
      summary: "High rate of slow queries on MySQL"
      description: "{{ $labels.instance }}: Slow query rate is {{ $value | printf \"%.2f\" }} per second."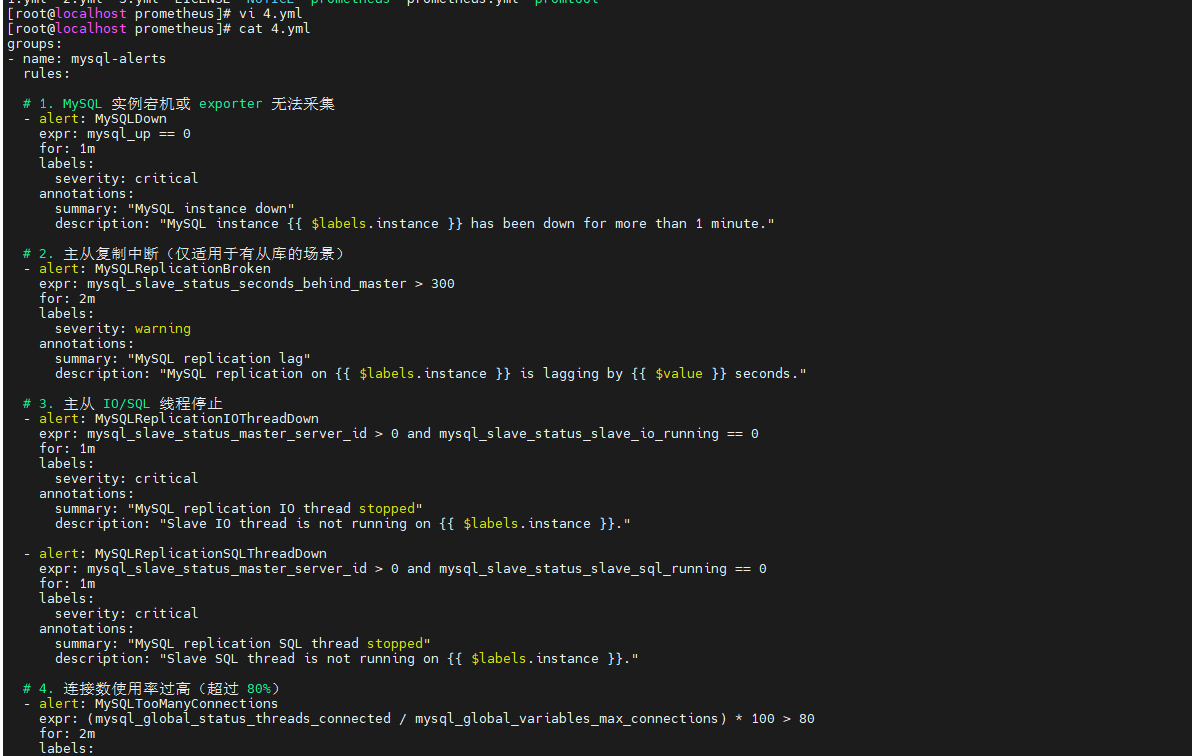
image-20251125112832127
这组规则覆盖了几类常见数据库状态:
- MySQL 实例不可用;
- 主从复制延迟;
- 主从 IO 线程停止;
- 主从 SQL 线程停止;
- 连接数使用率过高;
- 慢查询速率升高。
这些规则的意义是:
Prometheus已经不只是“采集”,开始对指标做条件判断。
12 规则文件加入Prometheus
进入配置文件:
vi prometheus.yml把规则文件加入:
rule_files:
  -  "/app/prometheus/1.yml"
  -  "/app/prometheus/2.yml"
  -  "/app/prometheus/3.yml"
  -  "/app/prometheus/4.yml"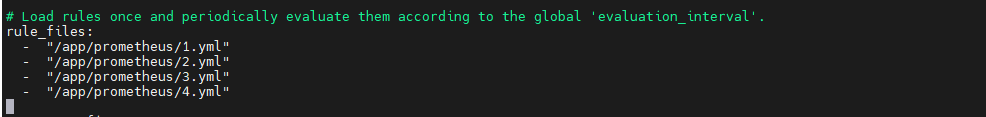
image-20251125113103946
然后重启:
systemctl restart prometheus再次打开 Prometheus:
image-20251125103926501
可以看到告警规则:
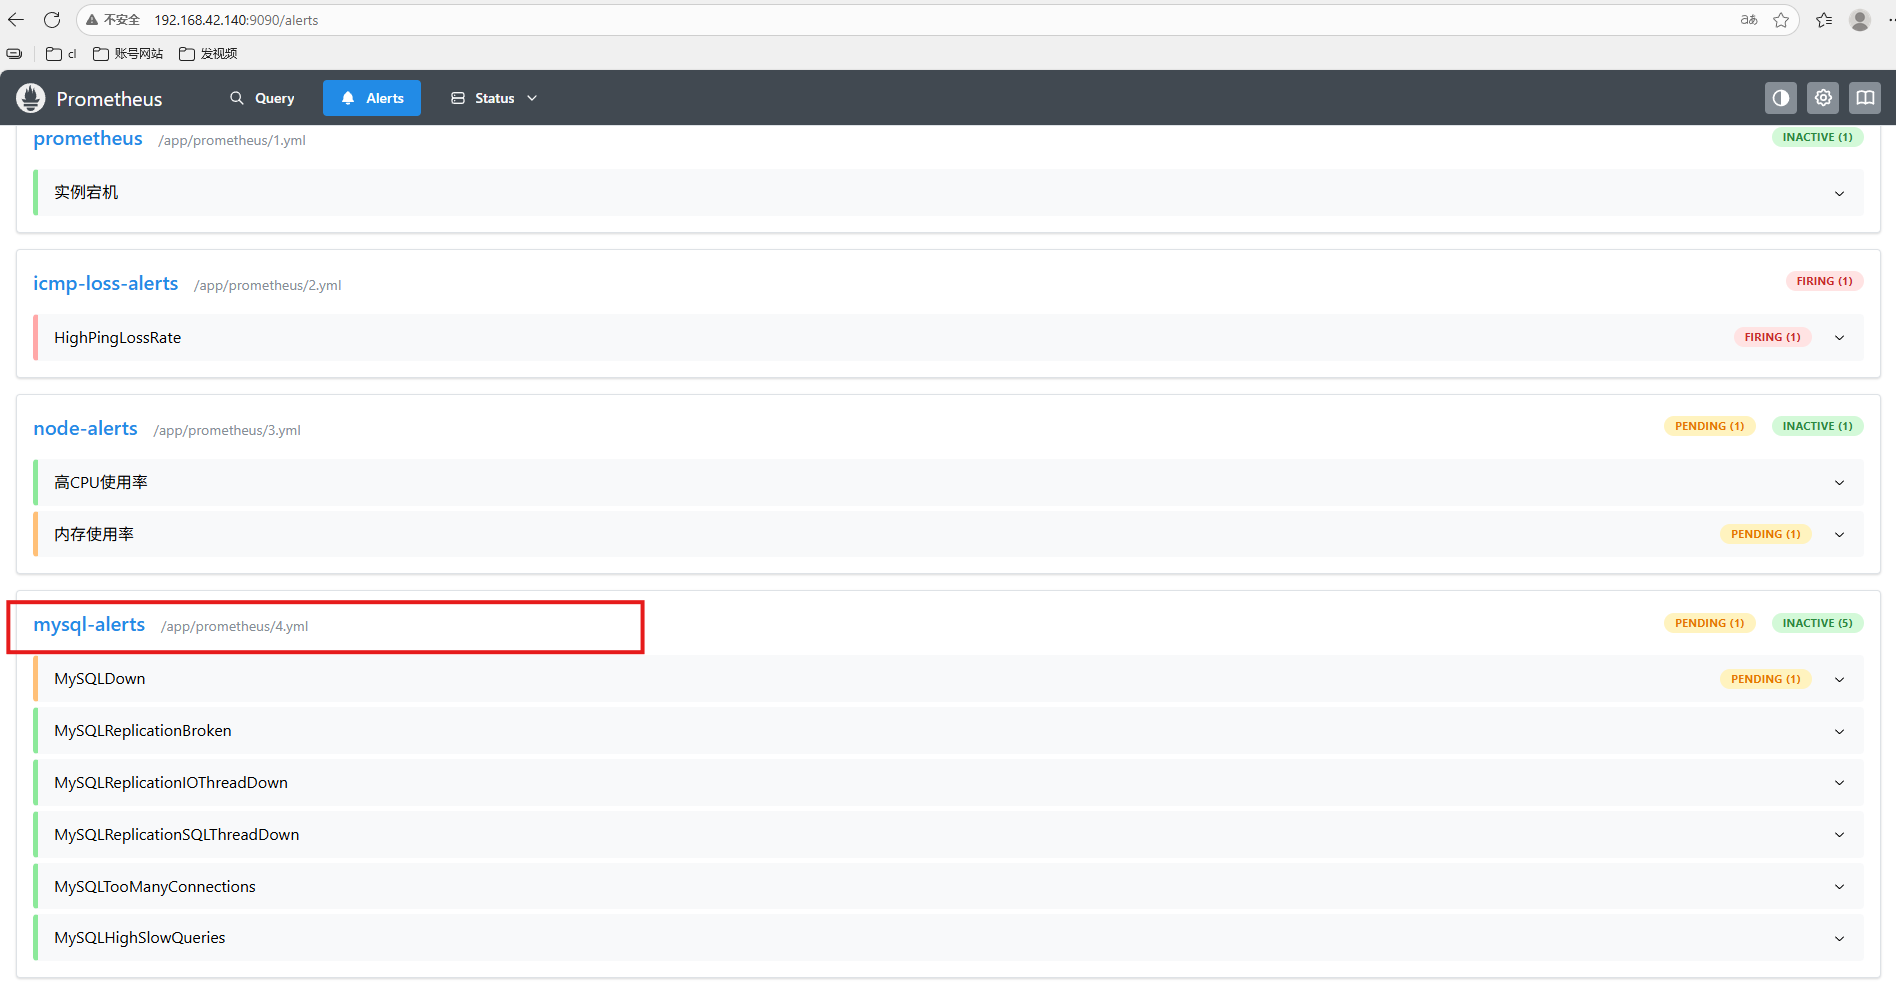
image-20251125134824200
13 这篇实际验证了MySQLDown告警
此时 MySQL 没有启动:
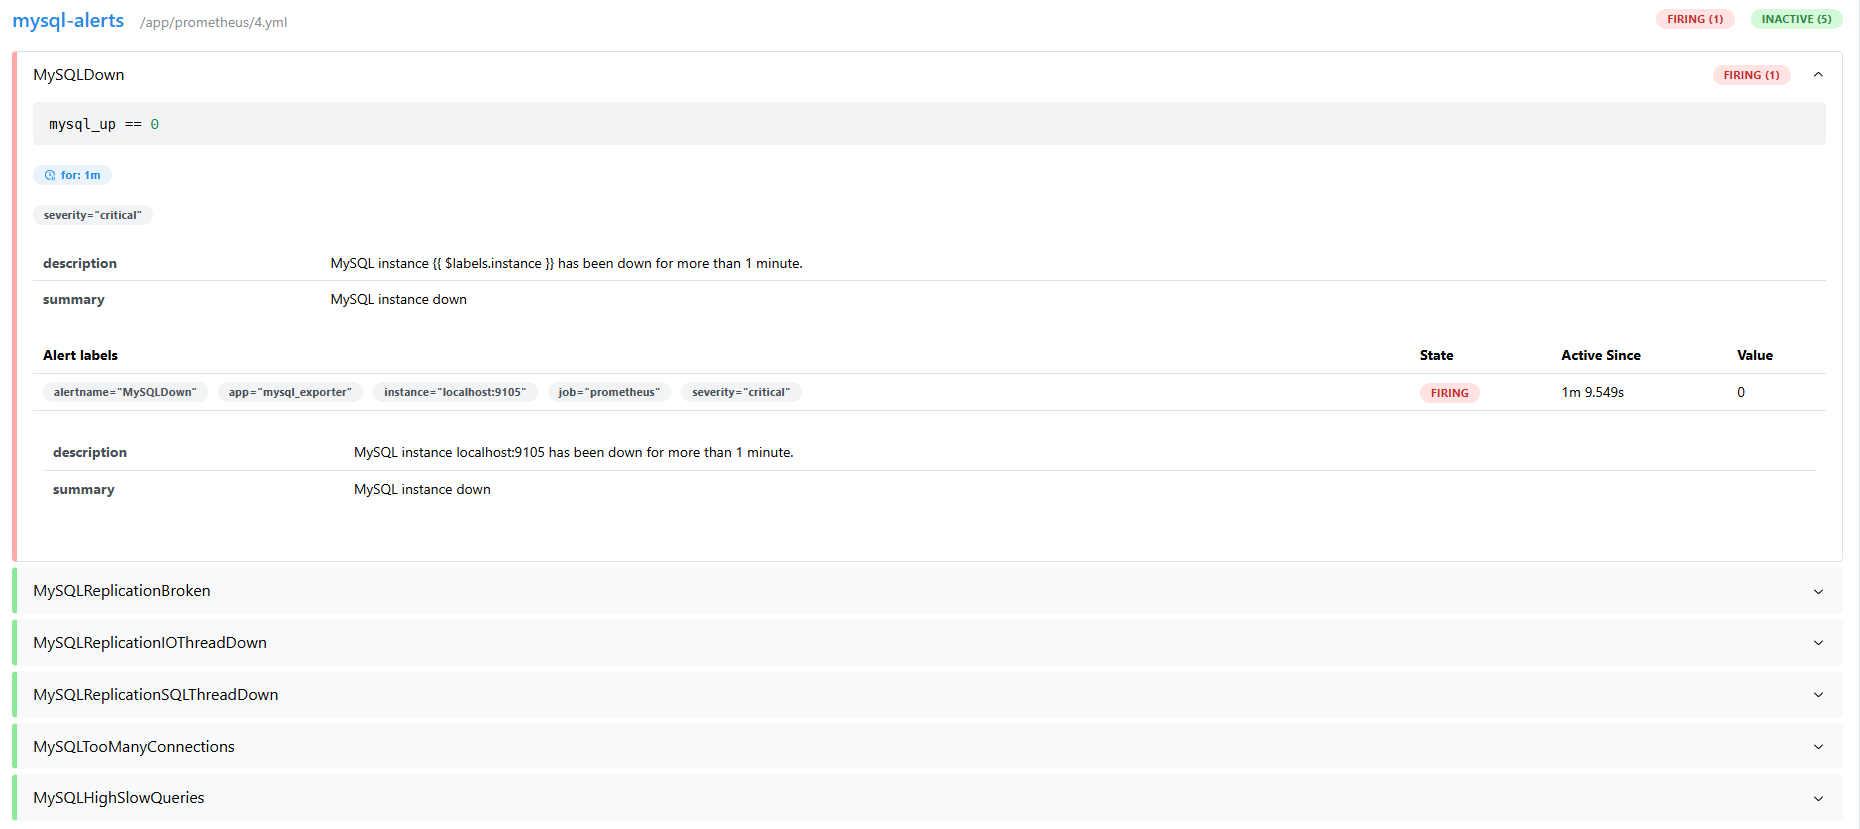
image-20251125134912322
所以告警进入异常状态。
随后重新启动 MySQL:
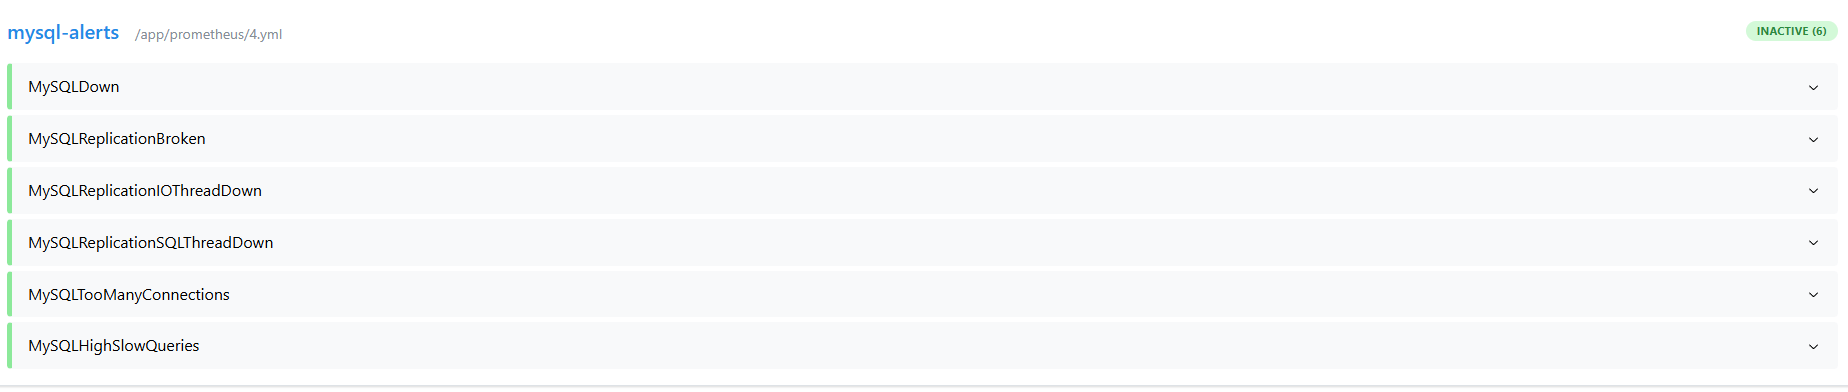
image-20251125140748166
状态恢复。
这段验证非常重要。
因为它不只是“规则写进去了”,而是实际证明:
MySQL状态变化 → exporter指标变化 → Prometheus规则状态变化
这条链已经工作。
14 但这还不等于Alertmanager通知已经完成
章节标题写的是:
“使用alertmanager配置mysql_exporter告警”。
但正文这一段实际展示的是:
- Prometheus rule 文件;
- Prometheus 重启;
- Prometheus Alerts 页面;
- MySQL停止与恢复。
没有继续展示:
- Alertmanager receiver;
- 邮件;
- Webhook;
- 企业微信;
- Slack;
- 其他消息通知。
所以更准确的说法应该是:
Prometheus告警规则已经配置并触发。
如果前面已经另外部署并接入 Alertmanager,它可以继续接收这些告警。
但仅凭当前内容,还不能证明通知渠道已经完整跑通。
15 主从复制规则只适合真正有从库的环境
这组规则里包含:
mysql_slave_status_seconds_behind_mastermysql_slave_status_slave_io_runningmysql_slave_status_slave_sql_running
如果当前 MySQL 没有主从架构,这些规则没有实际意义。
所以不要为了“规则越多越完整”全部照搬。
更合理的是:
按自己的数据库架构选择规则。
单机 MySQL 可以先保留:
- MySQLDown
- 连接数
- 慢查询
复制类规则只在真的存在从库时使用。
16 本地监控跑通以后,再考虑异地抓取
到这里,如果 MySQL、mysqld_exporter 和 Prometheus 都在同一个网络中,本地监控已经完成。
但如果:
- MySQL 在朋友服务器;
- Prometheus 在另一台机器;
- 两边不在同一局域网;
Prometheus 就需要一个能够访问到 exporter 的网络入口。
这才是后面公网部分的用途。
17 安装cpolar
执行:
sudo curl https://get.cpolar.sh | sh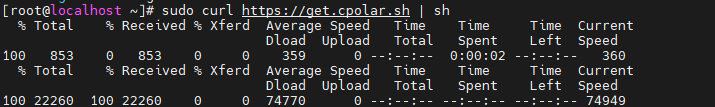
image-20250814101639846
安装后查看服务:
sudo systemctl status cpolar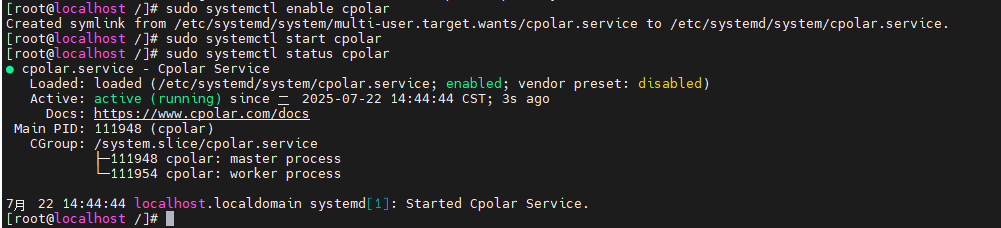
22e5adfaf290a17fc3384bb296055259
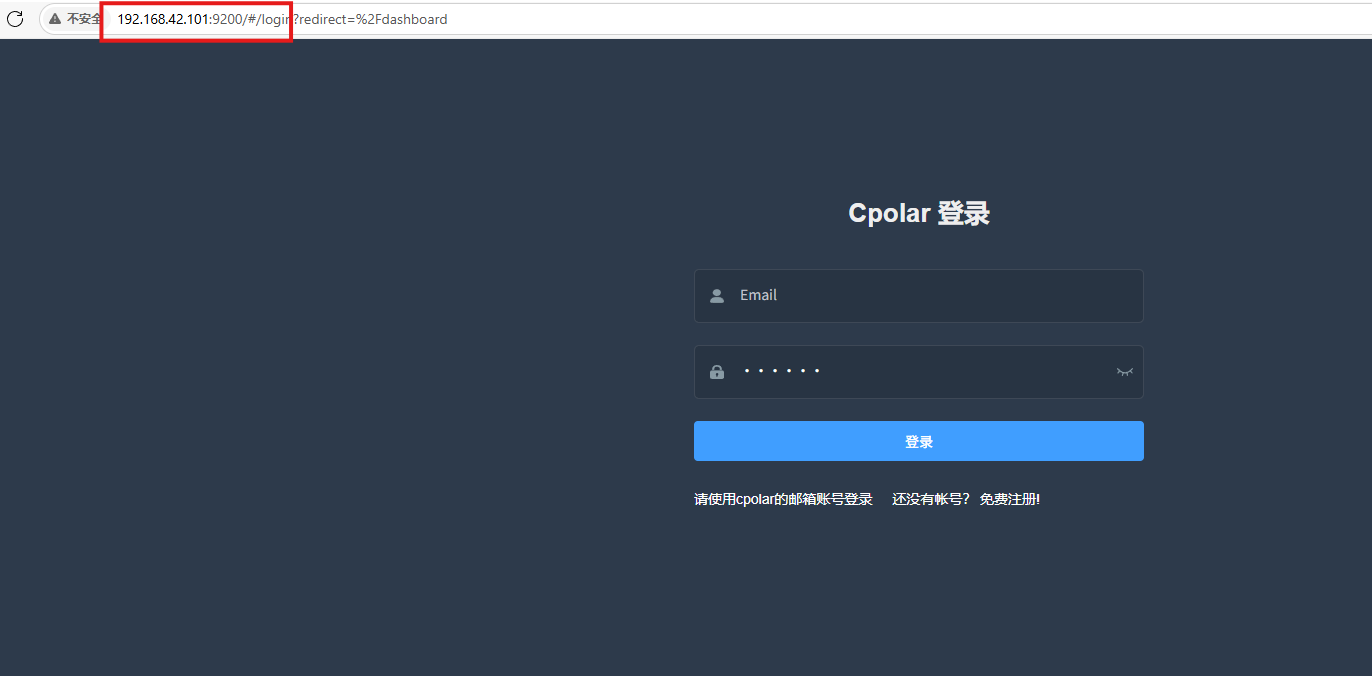
然后通过:
服务器IP:9200
进入 Web UI:
8a6698b1bf26d64ba3645827fbfb1c29
18 给9105创建随机公网入口
创建隧道:
- 隧道名称:
mysql_exporter - 协议:
http - 本地地址:
9105 - 域名类型:随机域名
- 地区:
China Top
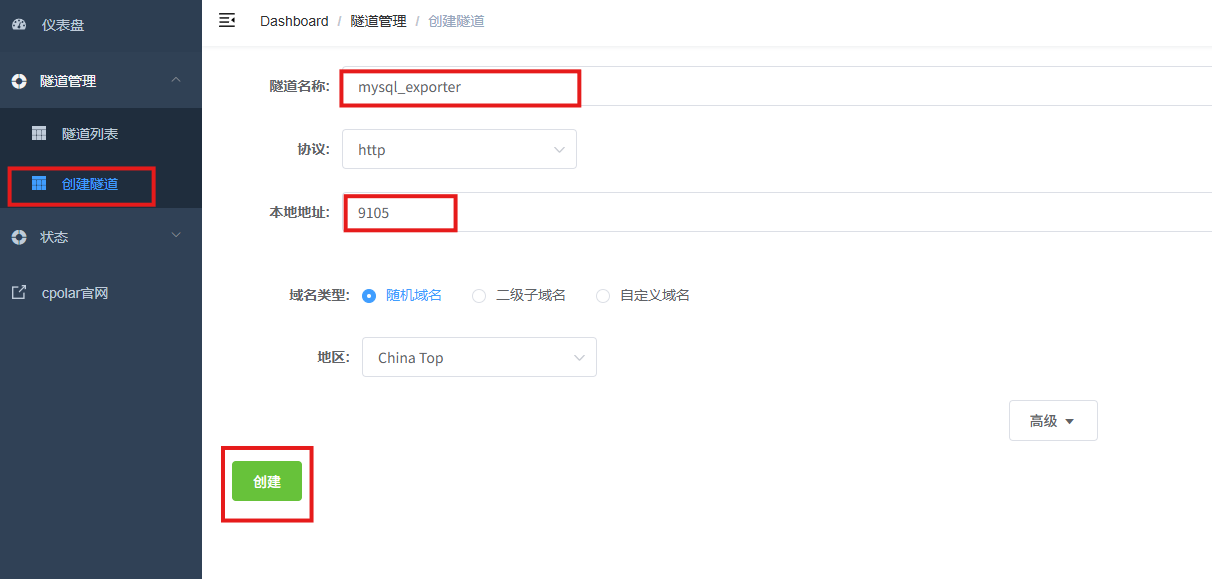
image-20251125140431855
创建以后查看在线隧道:
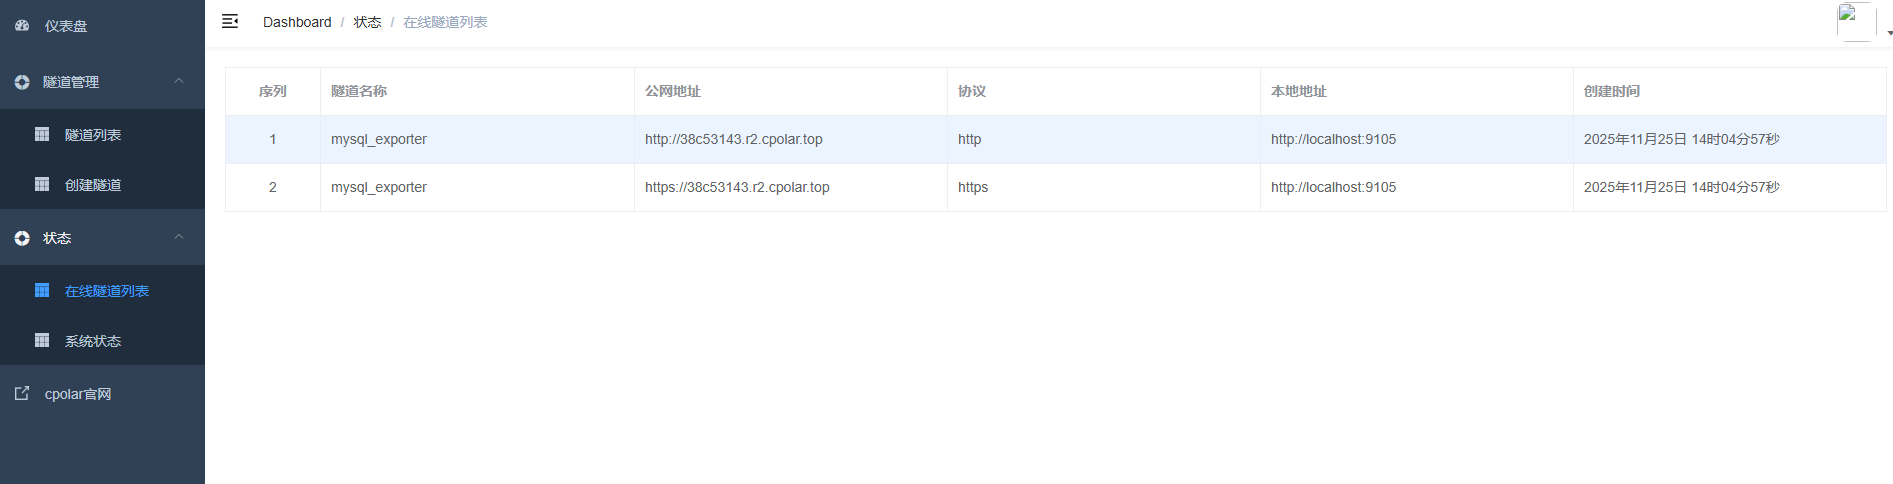
image-20251125140532931
从外部访问:
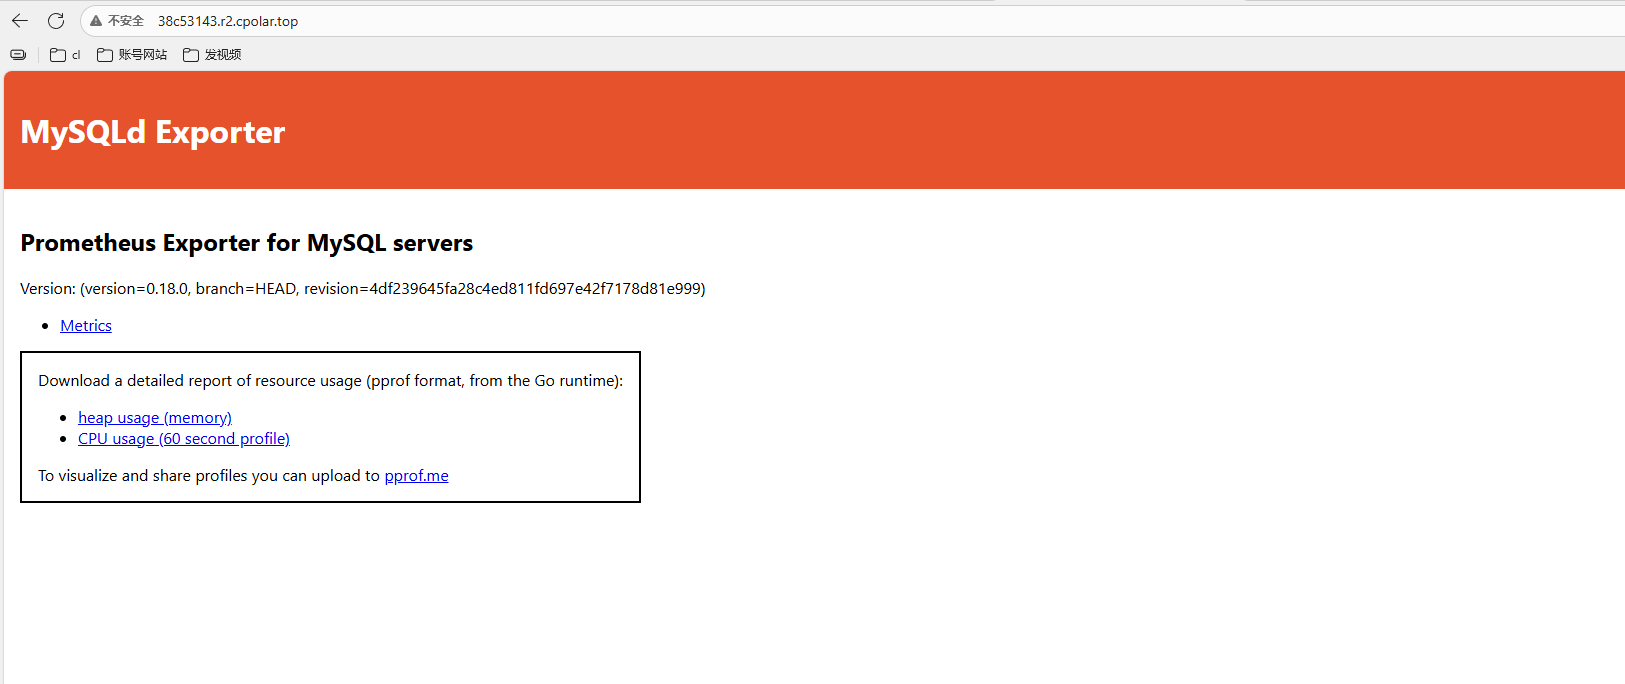
image-20251125140523720
页面能打开以后说明:
外部浏览器 → 公网地址 → cpolar → 9105 → mysqld_exporter
这条网络链路已经通了。
19 远程Prometheus再抓公网地址
Prometheus 示例配置:
      - targets: ["38c53143.r2.cpolar.top"]
        labels:
          app: "mysql_exporter"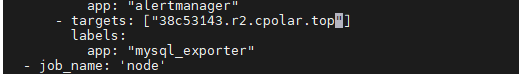
image-20251125140712345
随后显示抓取成功:
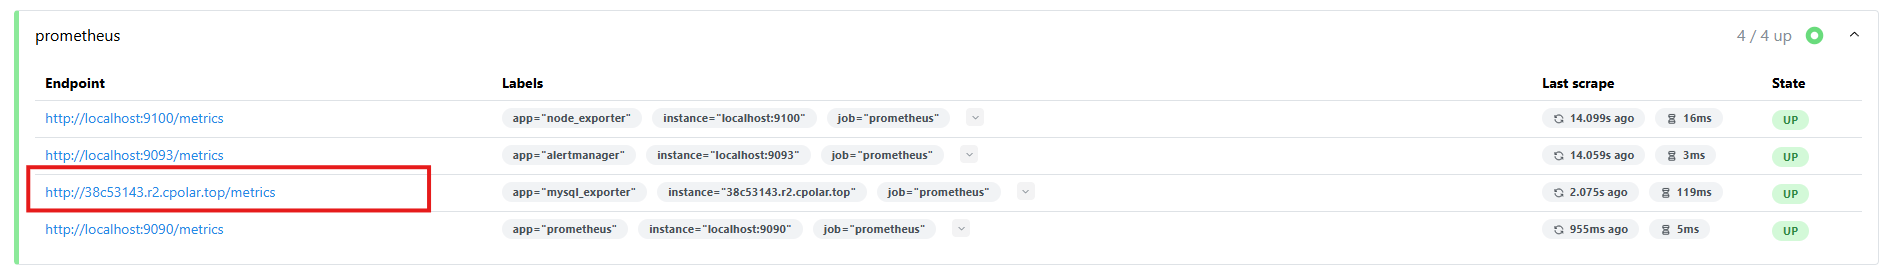
image-20251125140820943
这一段证明的是:
异地 Prometheus 可以通过公网地址访问 exporter 指标端点。
但仍然需要注意:
示例 target 只写了主机名,没有展示完整 job、scheme 和端口上下文。
所以它仍然更像局部配置片段,而不是完整 scrape job。
20 把9105指标端点公开以后要注意信息暴露
mysqld_exporter 的指标页不是普通宣传页面。
它可能暴露:
- 数据库连接状态;
- 运行指标;
- 复制状态;
- 性能信息;
- 实例标签。
这些信息本身就属于运维数据。
所以真正长期远程抓取时,不应该只考虑“Prometheus能不能访问”,还要考虑:
- 地址是否需要小范围可见;
- 是否增加额外认证;
- 是否限制来源;
- 是否真的需要把指标端点公开到互联网。
cpolar 只负责网络入口。
访问控制仍然需要结合实际环境设计。
21 随机地址适合先验证
如果只是临时测试远程抓取,随机地址已经足够。
先确认:
- 9105端点能打开;
- Prometheus能抓;
- Target状态正常;
- 指标能查询。
验证完成以后,再考虑长期固定地址。
22 配置固定二级子域名
进入预留页面:
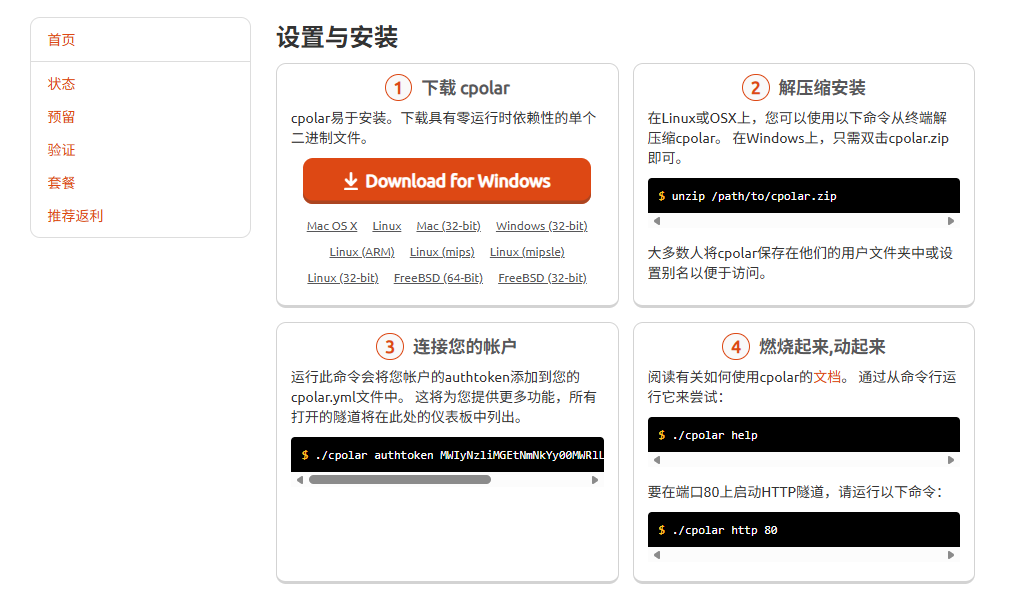
image-20251125141035399
示例名称使用:
mysqll
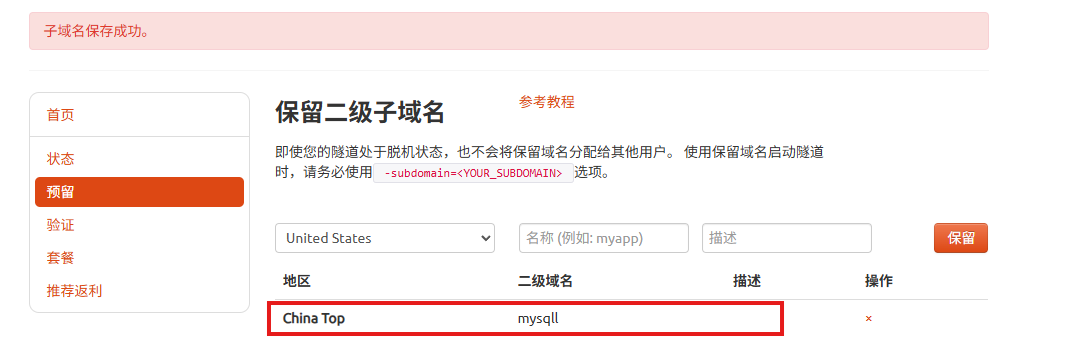
image-20251125141009206
这里比 mysql 多了一个 l。
二级子域名本身可以自定义,所以技术上不一定有问题。
但如果希望名称和服务保持一致,自己配置时最好统一命名。
23 把隧道切换为固定地址
进入隧道列表:
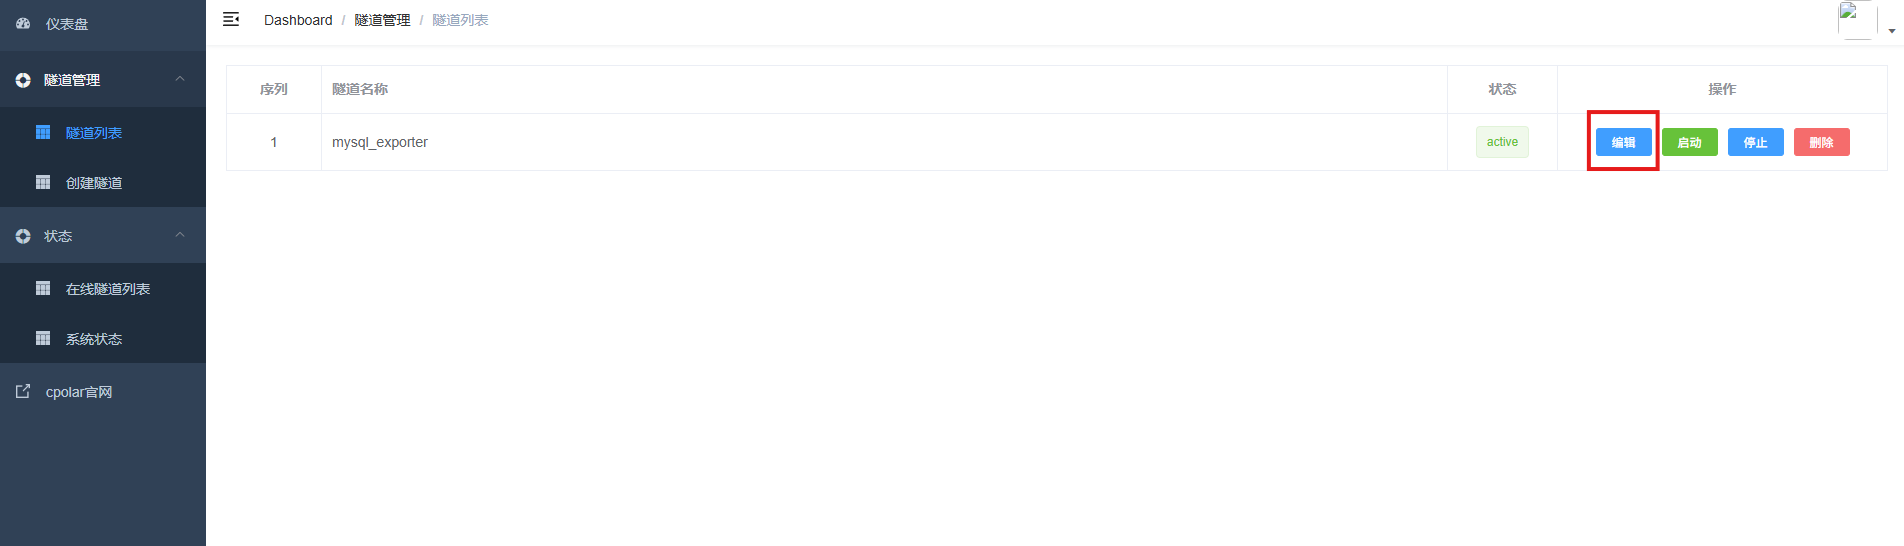
image-20251125141100804
修改:
- 域名类型:二级子域名;
- Sub Domain:填写预留名称;
- 地区:
China Top。
更新:
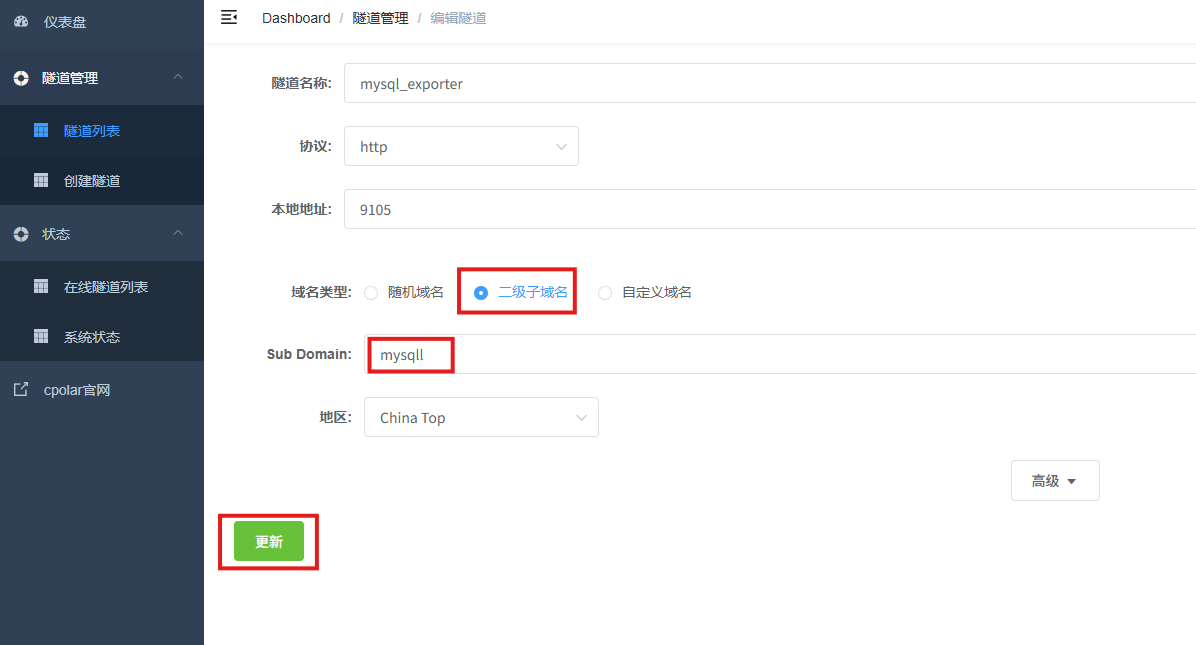
image-20251125141128044
查看在线隧道:
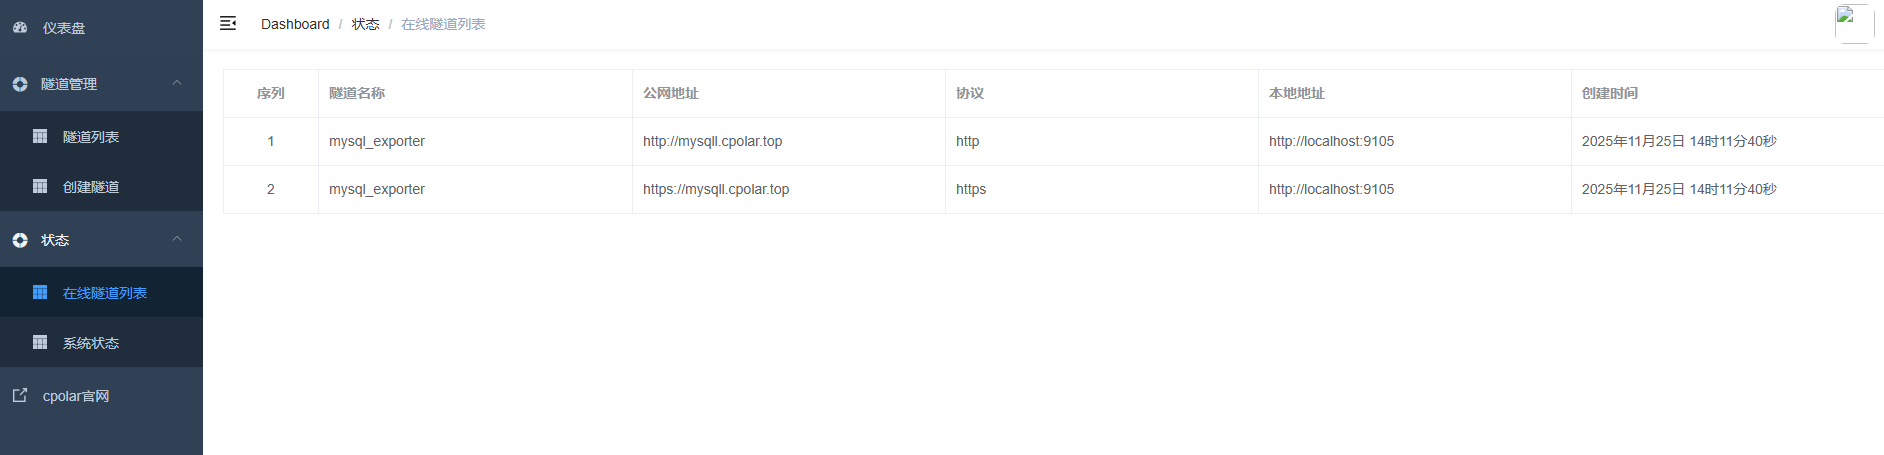
image-20251125141147962
最后使用固定地址访问:
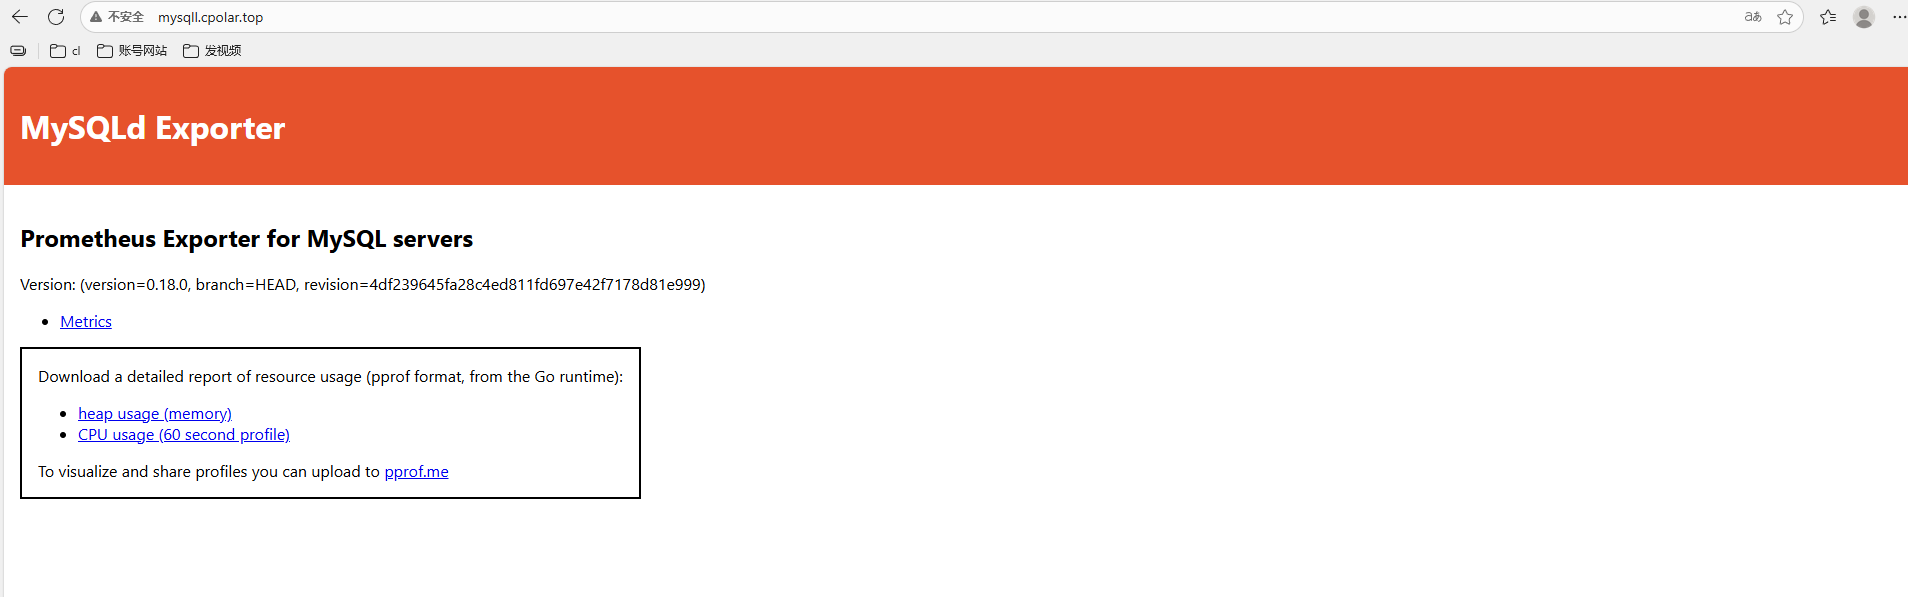
image-20251125141202184
页面正常打开以后,固定入口就配置完成。
具体固定域名、套餐和使用规则可能变化,应以实际账号页面为准。
24 这篇真正跑通了哪些环节
实际完成:
- mysqld_exporter 0.18.0 下载;
- MySQL监控用户与权限;
- 9105指标端点;
- Prometheus本地抓取;
- Target验证;
- MySQL告警规则;
- MySQL停止后告警出现;
- MySQL恢复后状态恢复;
- 9105公网访问;
- 异地Prometheus抓取;
- 固定二级子域名。
没有完整展示:
- Grafana仪表盘;
- Alertmanager receiver;
- 邮件 / Webhook / IM通知;
- exporter端点认证;
- 多实例集中监控;
- 长期安全访问策略。
所以文章最准确的定位是:
把MySQL指标从数据库内部带到Prometheus,并继续验证告警规则和异地抓取。
总结
这次真正跑通的是一条完整的MySQL指标链:MySQL负责提供运行状态,mysqld_exporter把这些状态暴露到9105,Prometheus再负责抓取、查询和评估告警规则。
最有价值的验证不是“页面能打开”,而是MySQL停止以后Prometheus告警真的出现,重新启动后状态又恢复。这说明从数据库状态变化到告警规则判断的链路确实在工作。
远程部分则把9105提供给异地Prometheus抓取,但指标端点本身属于运维信息,不应该因为能通过公网访问就忽略认证和暴露范围。
另外,部署里几个用户名和目录名不一致的问题一定要先核对清楚。把这些细节处理好以后,这套方案才更适合作为MySQL监控链的基础。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-10-12,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号