【征文】整站打不开的那天,我用 WorkBuddy 从「重启服务」查到了「内核内存限流」
原创
【征文】整站打不开的那天,我用 WorkBuddy 从「重启服务」查到了「内核内存限流」
原创
用户12816708
发布于 2026-10-13 13:03:05
发布于 2026-10-13 13:03:05
重启只能把它藏起来 5 分钟。真正的答案,在系统最底层。
一、现象:所有页面都在转圈
我有一台自建的数据服务,跑在一台内存只有 1.6G 的云服务器上,负责定时聚合行情数据、给几个前端页面供数。平时稳稳当当,直到那天下午——
页面打不开了。
不是某一个页面,是全部:首页、数据页,甚至连一个不做任何数据库查询、只返回状态码的健康检查接口,都要转圈 20 到 30 秒才吐结果。
二、我的第一反应,是错的
看到"所有页面都慢",我的第一反应很自然:服务挂了,重启一下。
重启。页面恢复正常。我松了口气,以为是个偶发。
结果没几分钟,又开始转圈。再重启,再好;再卡。
到这儿,问题反而变得有意思了——能被重启"治好"、但很快又复发的故障,几乎肯定不是服务本身的问题。 如果是代码或配置出错,重启不会让它好上几分钟。它更像是一个"环境层面的东西"在被反复触发。
更诡异的是:连那个零 I/O 的健康检查接口都卡。 一个不读数据库、不算数据的接口也要排队 20 秒——这说明瓶颈根本不在业务逻辑里。
三、换个思路:把现象交给 WorkBuddy
我停下了"重启大法",做了一件和以前不一样的事:把现象和一整套现场信息一起交给 WorkBuddy,让它带我按线索排查——而不是直接要一个答案。
我给它的是原始现象,而不是我的猜测:
「服务重启能好一阵,然后又卡。所有接口都慢,包括一个只返回状态、不查数据库的健康检查接口,也要等 20 多秒。」
它没有急着下结论,而是先给了我一条排查路径——先判断"是不是被内核限流了",再看"进程到底在等什么",最后才谈改。具体是这四层:
① 先看内存控制组的事件计数。
去读 memory.events:如果里面的 high 计数在持续上涨、而 oom_kill 是 0,那就说明——进程不是被"杀死"的,而是被"限流"的。 这是关键分水岭:OOM 杀进程和内核限流,表现完全不同,处理方式也完全不同。
② 再看内存压力。
读 /proc/pressure/memory,确认系统当时是不是真的处于内存紧张状态。
③ 然后看进程到底卡在哪。
用 py-spy 之类的工具 dump 一下服务进程——结果它在 idle(空闲)。一个空闲的进程,却不响应请求,那就只剩一种解释:它在等,等的不是 CPU,也不是 I/O,而是内存页。
④ 最后看堆。
看 memory.stat 里的 anon(匿名内存),确认内存究竟被谁吃掉。
顺着这条路径走完,答案就很清楚了。
四、真凶:不是服务挂了,是"内存被限流"
根因是:这台只有 1.6G 内存的机器上,服务撞到了 cgroup 的 MemoryHigh 阈值,被内核限流了。
一旦撞到限流线,内核不会杀进程,而是让进程慢下来、等内存页——它进入 D 状态(不可中断睡眠)。这时候:
- 进程既不崩溃、也不报错,就是"不动";
- 因为整个进程被拖住,连零 I/O 的健康检查接口也会一起排队(这正好解释了第二节那个最诡异的症状);
- 而我的健康检查超时了,于是看门狗判定"服务死了"、把它重启——重启后内存释放、短暂恢复,然后很快又撞线、又卡、又被重启。
所以真正在"制造故障"的,是我的看门狗和系统的限流在互相打架。我每次手动重启,其实都是在帮倒忙。
五、修复:不是重启,而是热调阈值
找到根因后,修复反而变得很克制——不该重启服务,该调的是资源阈值:
- 把
MemoryHigh(开始限流的线)和MemoryMax(硬上限)一起往上提。 这里有个我差点踩的坑:这两个值不能只提一个。MemoryHigh只是"开始限流"的软阈值,MemoryMax才是超了就 OOM kill 的硬顶。把 High 提到等于 Max,等于取消了限流这道保险,那比卡死更危险。 - 用热改的方式调整资源属性,不重启服务——这样正在跑的任务不会被打断。
- 再配合 swap 和内核参数,把"内存不够时的行为"从"卡死"改成"多撑一会儿"。
改完之后,整站恢复,并且没有再复发。这次故障最后是靠"改一个数字"解决的,而不是靠"重启一百次"。
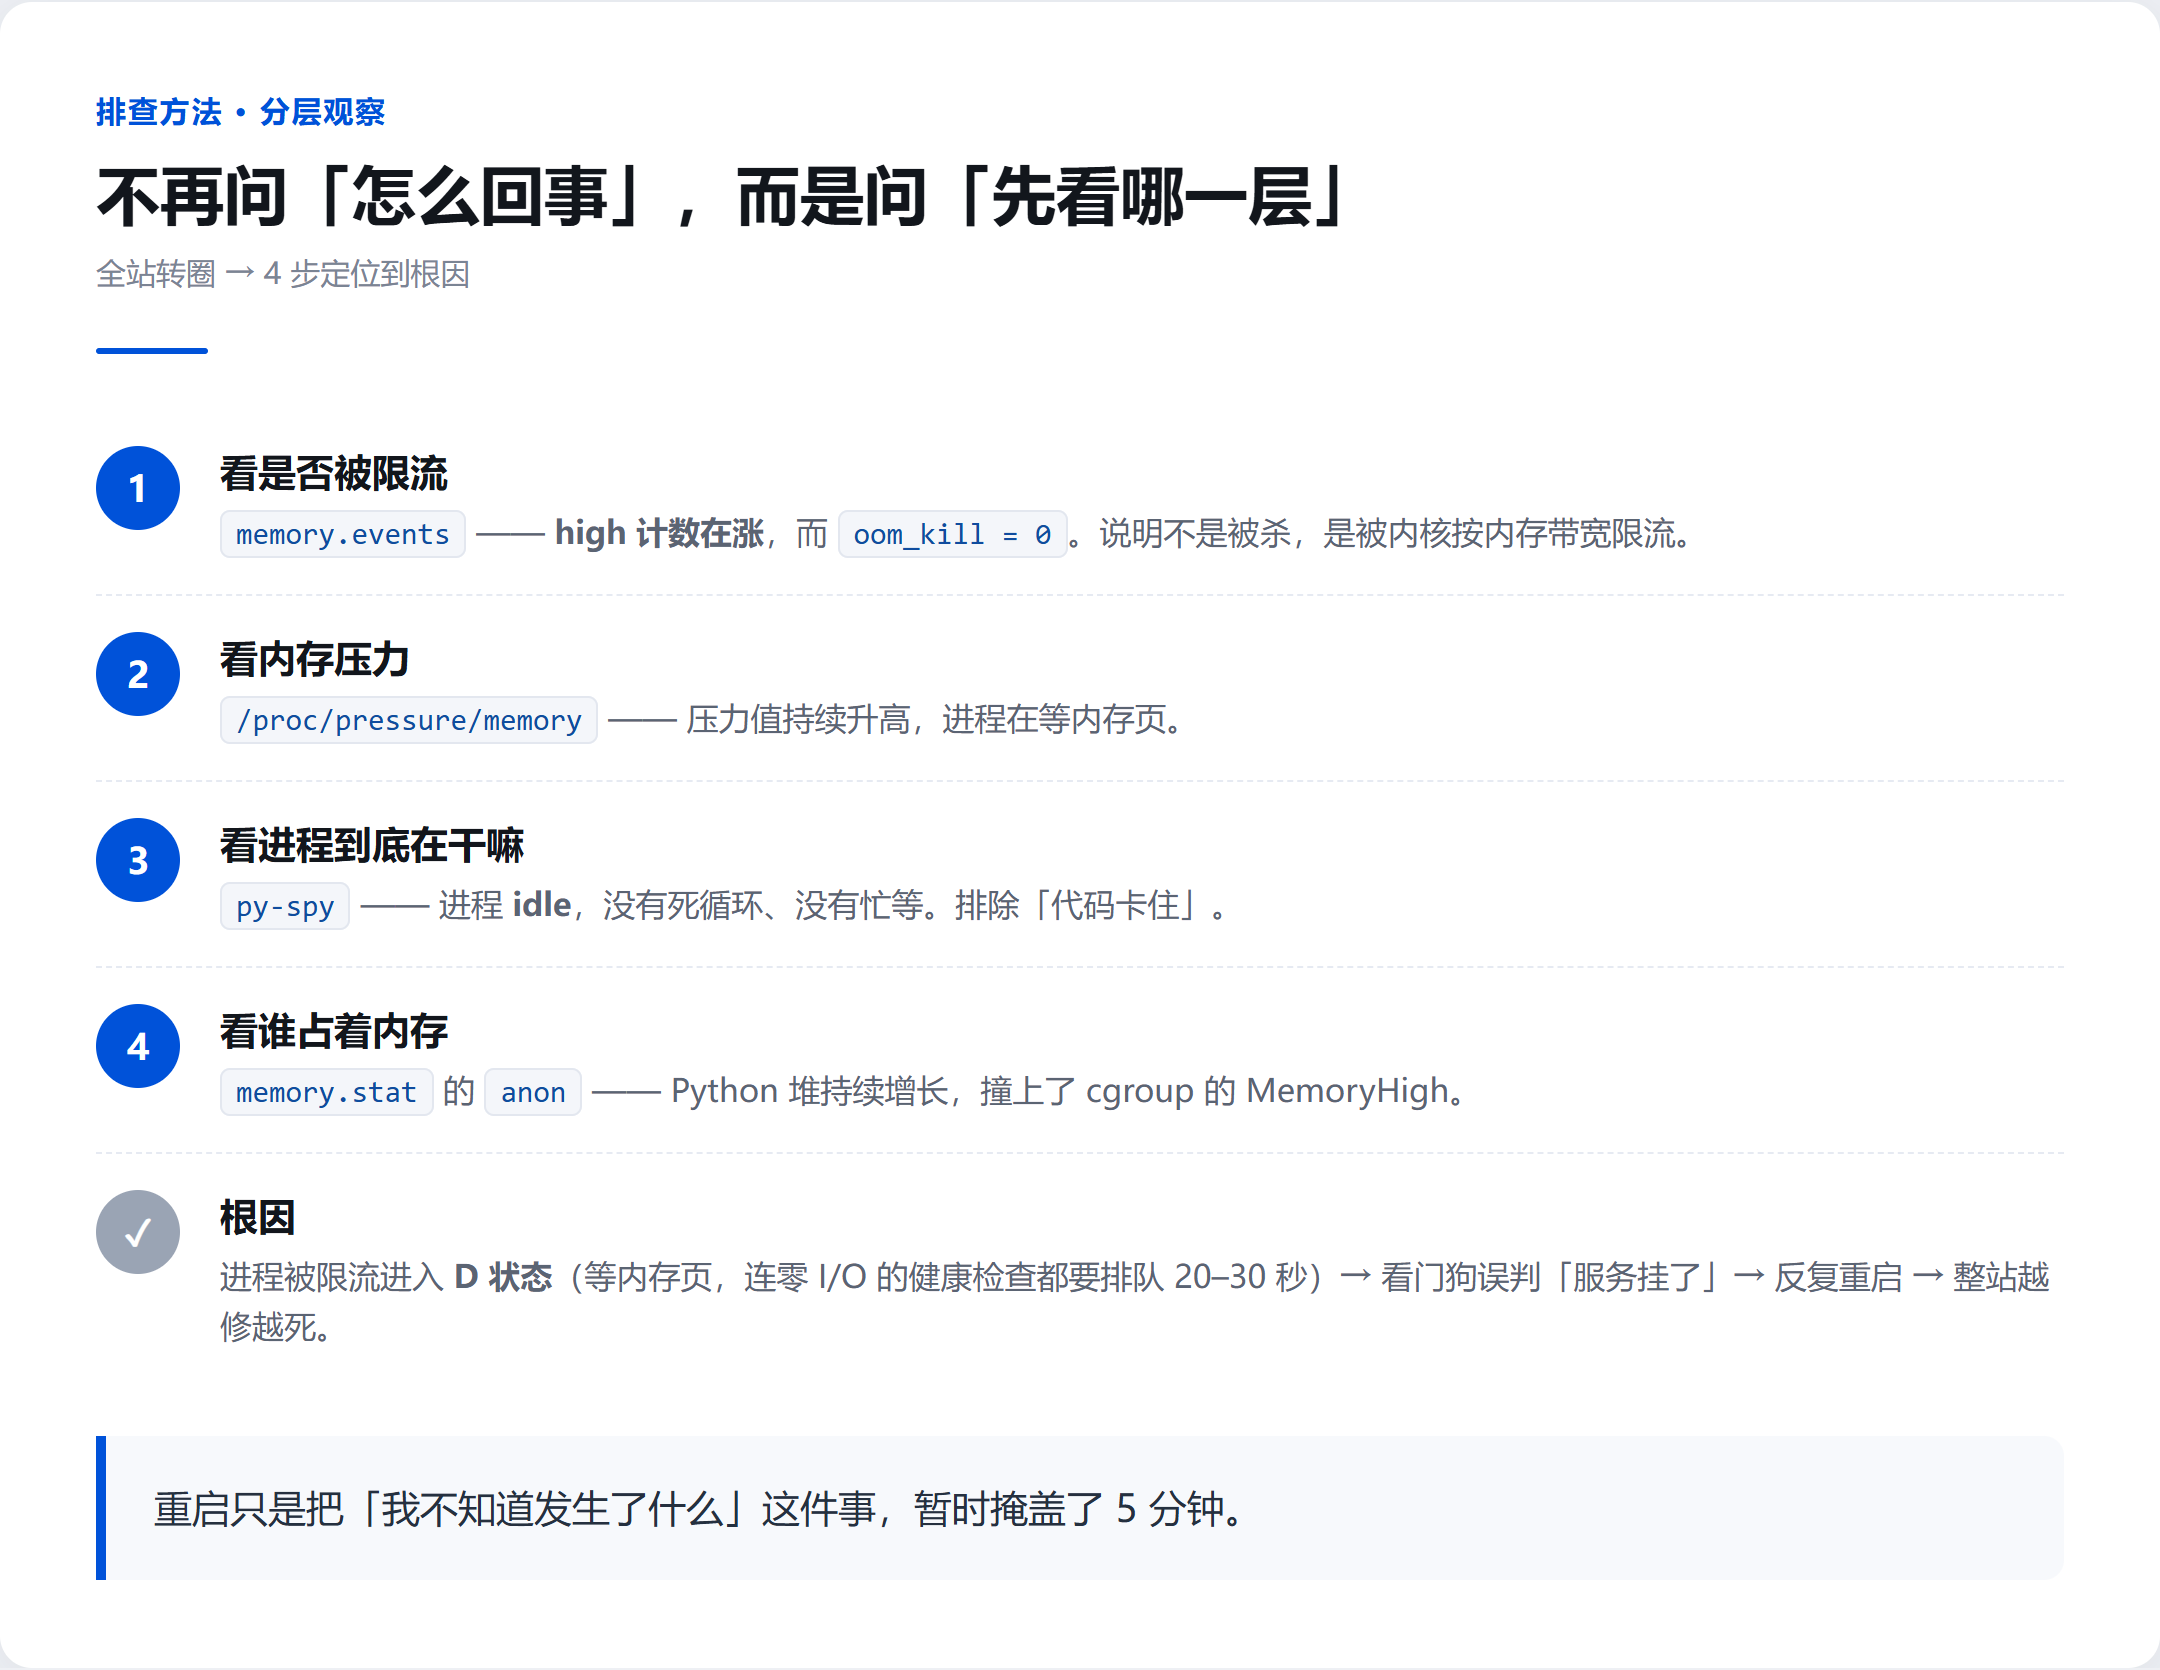
分层排查路径:从「怎么回事」到「先看哪一层」
图:分层排查路径:从「怎么回事」到「先看哪一层」
六、这件事之后,我真正学到了什么
这次排查对我最大的价值,不是修好了一台服务器,而是改掉了两个习惯:
- "重启能好"不等于"重启就是解法"。 能反复复发的故障,重启只是把症状藏起来几分钟。而真正的线索,恰恰是"它为什么会被重启治好"。
- 别急着要答案,先要一套排查路径。 我这次刻意没有问"这是怎么回事",而是把现象交给它,让它给我"先看什么、再看什么、什么条件下是哪种结论"的分层路径。结果它先排除掉的,正是我最容易误判的方向。这一步省下的不是时间,是我在错误方向上反复重启的那些小时。
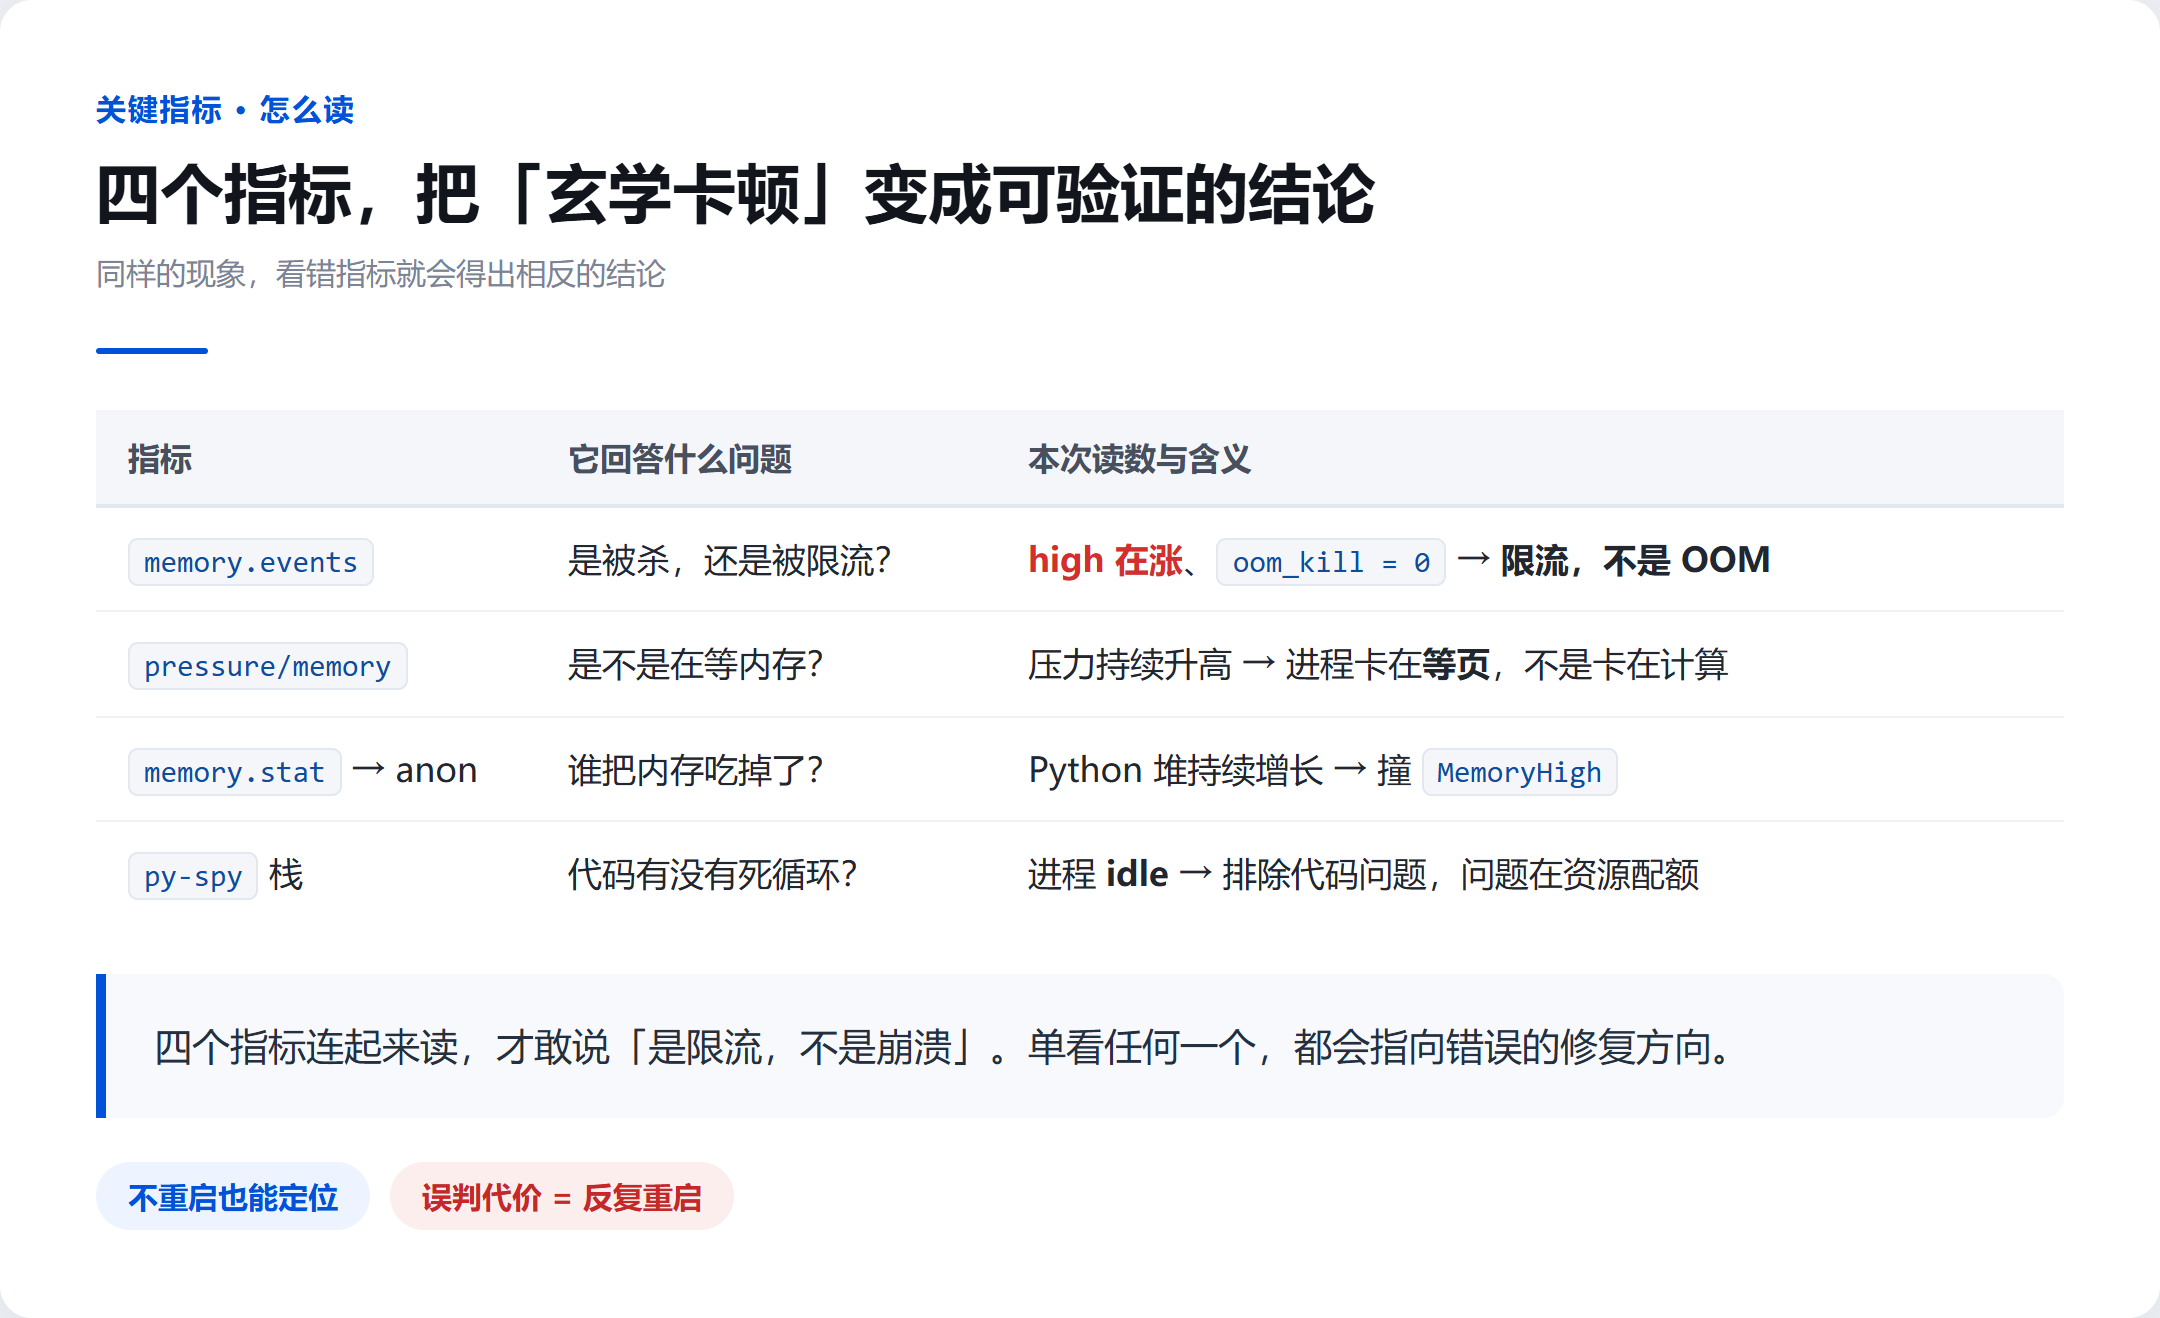
四个关键指标怎么读,看错就会得出相反结论
图:四个关键指标怎么读,看错就会得出相反结论
七、可复用的排查清单
如果你也管着一台内存不太宽裕的服务器,遇到"重启能好、然后复发"的卡顿,可以按这个顺序查:
顺序 | 看什么 | 怎么判断 |
|---|---|---|
1 |
|
|
2 |
| 确认当时是否真的内存紧张 |
3 | dump 进程(如 py-spy) | 进程 idle 却不响应 → 它在等内存页(D 状态) |
4 |
| 确认内存被谁吃掉 |
5 | 调 | 两个一起提,用热改,别重启服务 |
易错点:把
MemoryHigh提到等于MemoryMax,等于取消限流保险——比卡死更危险。
结语
以前遇到"服务卡了",我的肌肉记忆是重启。这次之后我才明白:
重启,只是把"我不知道发生了什么"这件事,暂时掩盖了 5 分钟。
而把现象——而不是猜测——交给 WorkBuddy,让它先给我一套"分层的排查路径",才是这次能真正定位到根因的关键。它没有替我做决定,但它让我在正确的方向上,少走了那几小时的弯路。
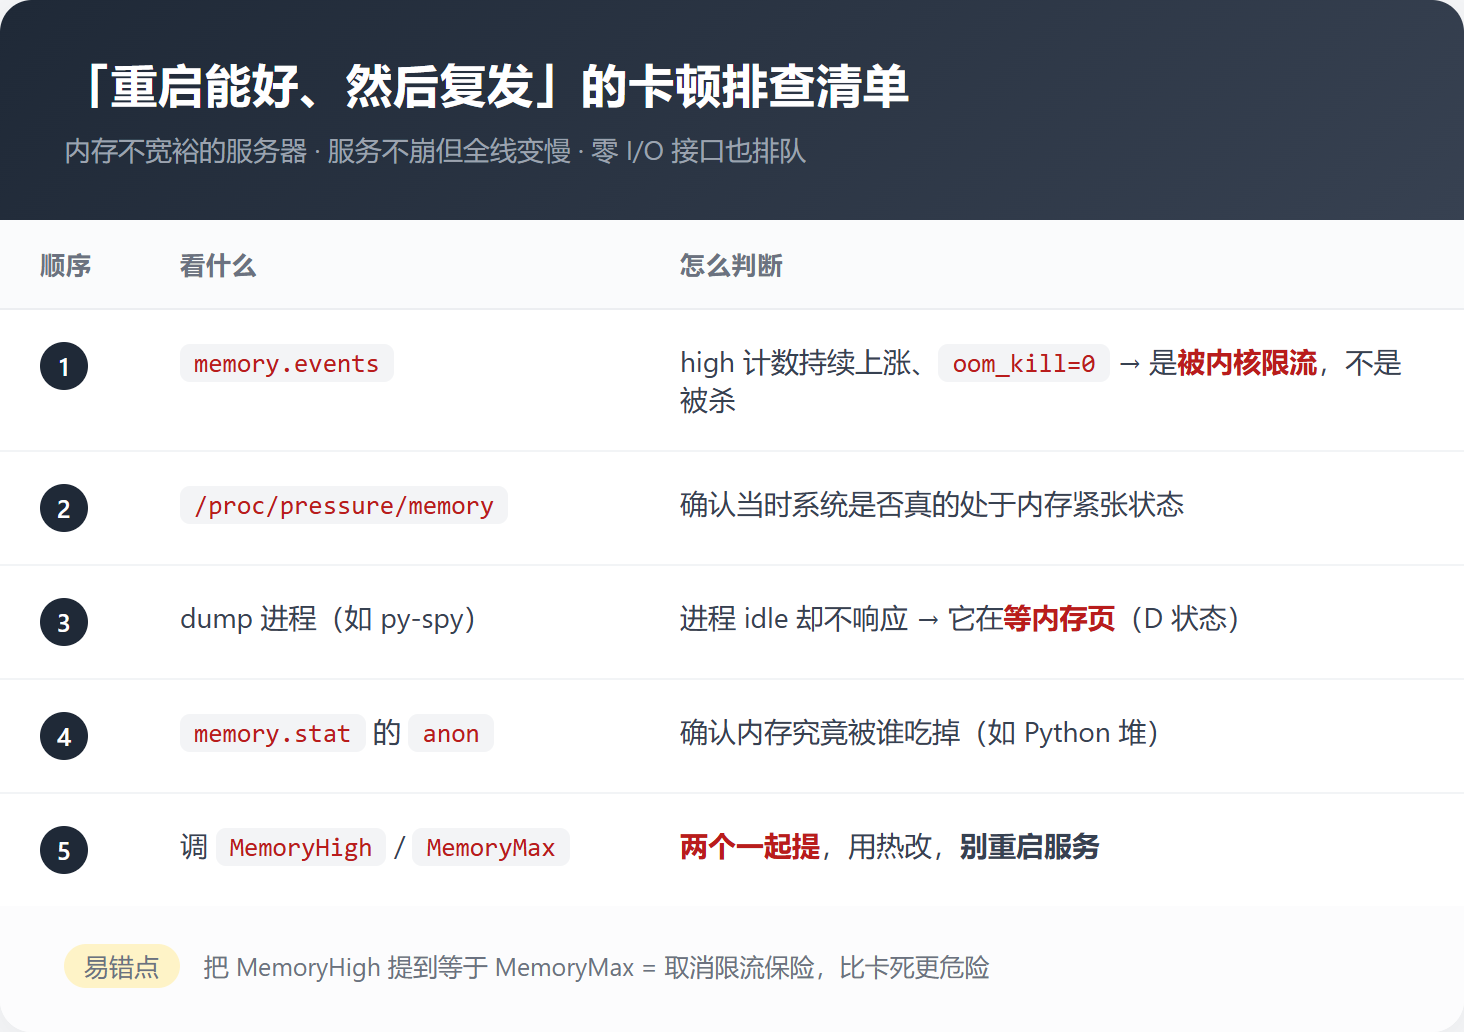
卡顿排查清单(可收藏)
图:卡顿排查清单(可收藏)
#WorkBuddy #AI办公
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号