从业务群消息到绩效评分表:两个真实办公场景的踩坑记录
原创
从业务群消息到绩效评分表:两个真实办公场景的踩坑记录
原创
用户12816612
发布于 2026-10-13 13:12:39
发布于 2026-10-13 13:12:39
从业务群消息到绩效评分表:两个真实办公场景的踩坑记录
每月要人工折腾大半天的两类数据,交给 AI Agent 做成脚本化流程。 本文不复述「AI 真好用」,只记录哪里会翻车、怎么发现的、怎么修的。 所有处理全部在本地完成,数据不出机器。
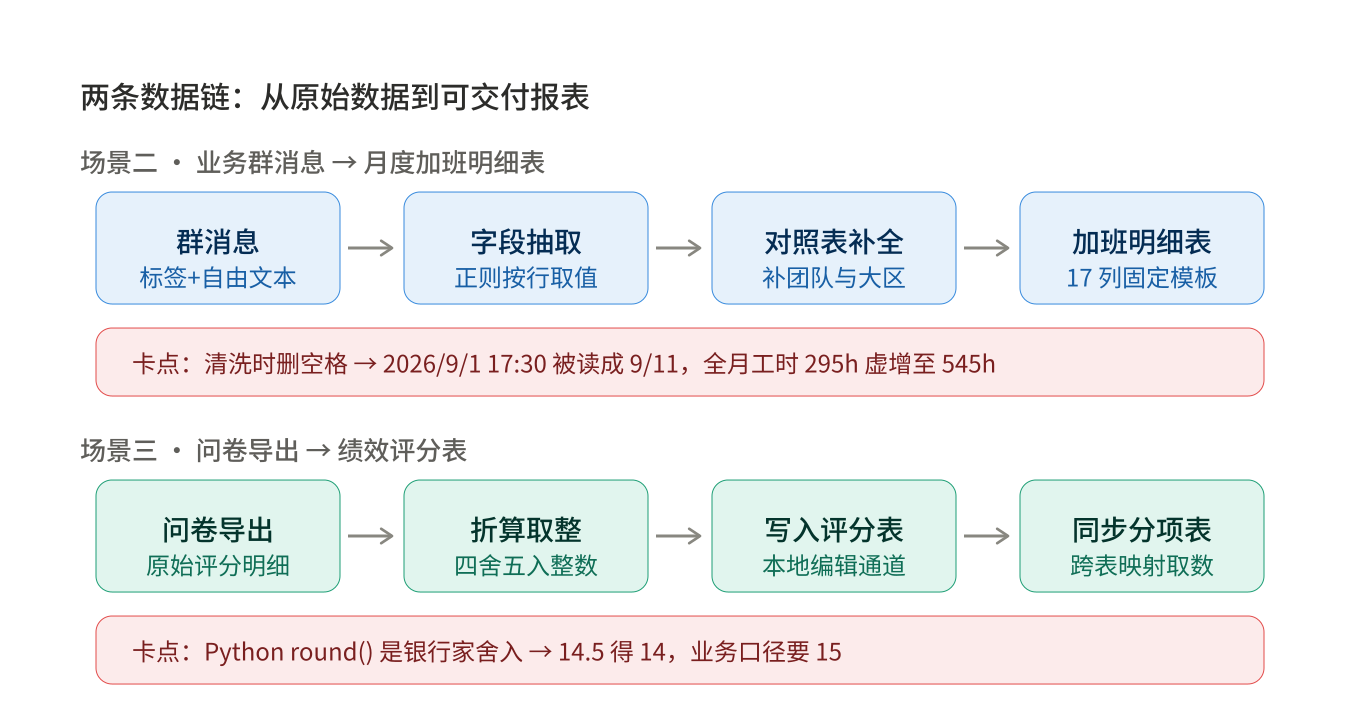
图1:两条数据链总览
写在前面
我在一家工业自动化公司做市场和技术条线的工作,有两类数据每月都重复折磨人:
- 一线同事在业务群里发的加班申请——固定标签 + 自由文本的混合体,要人工抄成 Excel 明细表;
- 跨部门绩效评分靠问卷收集——导出的原始明细要按一套折算规则填进评分表,再同步到另一张汇总表。
这些活本身不难,但量大、重复、容易错,而且错一个字段,后面的奖金计算就歪了。
我用 AI Agent 工作台把这两件事做成了可复用的脚本化流程。下面按场景记录踩过的坑。
场景二:从群消息里抽出结构化数据
消息长什么样
业务群里的申请是固定标签 + 自由文本的混合体:
厂内终端:
评估工时:
加班时间:2026/9/1 17:30-21:30
客户名称:某项目
是否收费:是
...
@审批人A @审批人B
要抽成 17 列的结构化记录(申请人 / 团队 / 客户 / 时长 / 审批人 / 事由……)并生成月度报表。消息文本来自群聊的常规导出,本文只讲解析,不讲获取。
坑 1:正则里的 \s* 会吃掉换行
表示「标签: 值」的直觉写法:
re.search(lab + r"\s*[::]\s*(.*)", text) # 危险\s 包含 \n。当某个标签的值本身就是空的(「厂内终端:\n评估工时:」),\s* 会一路跨过换行,把下一行的标签当作它的值取出来。于是整条记录从第一个空字段开始全部错位。
改成只在同一行内取值:
re.search(re.escape(lab) + r"[ \t]*[::][ \t]*([^\n\r]*)", text) # 正确坑 2(数字上最吓人的一个):清洗文本时删空格,把日期吃掉了
为了「统一清洗」文本,我先做了一次 text.replace(" ", "")。看起来无害,实际上:
2026/9/1 17:30 → 2026/9/117:30 → 被解析成 9 月 11 日日期整整错了 10 天,而小时数照样能解析出来,所以全程没有任何报错——只是全月工时从 295 小时虚增到 545 小时。
发现过程:拿上个月报表对照,总时长几乎翻倍,才回头去看解析的中间结果。
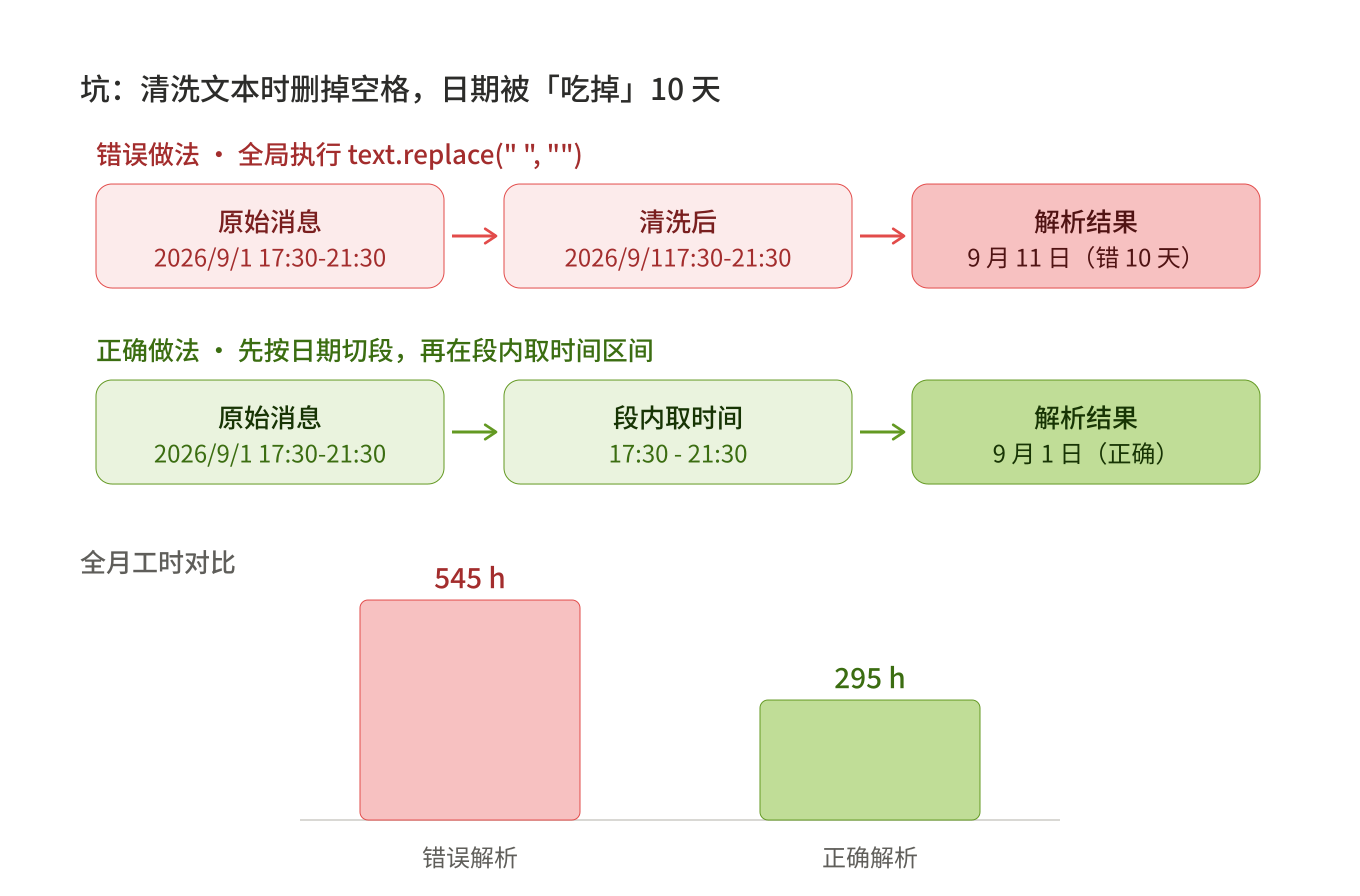
图2:日期被吃掉的前后对比
正确做法:先按日期切开,再在每段内取时间区间,只做最小限度的归一化,绝不全局删分隔符。
坑 3:组织字段不在消息里,靠对照表补;而口径要从历史报表的公式里反推
群消息里只有申请人姓名和客户名,没有所属团队、对接大区这类字段。这两列要靠一张外部的「人员 → 部门」对照表补:
团队列 = VLOOKUP(申请人, 人员表.姓名→部门)
大区列 = VLOOKUP(对接市场人员, 人员表.姓名→部门)这里有个隐藏陷阱:第二列的「大区」不是申请人自己的归属,而是他所对接的市场负责人所属的大区。我一开始按申请人自己的团队去填,结果和上月报表对不上,翻了历史月报的单元格公式才发现口径。
修法有两点:
- 把对照表做成独立 CSV,脚本自动加载——换名单只换文件、不改代码;
- 群里显示的是备注名,真名要从通讯录的「昵称 → 备注」映射里反查,再把备注里的部门前缀截掉。
场景三:问卷结果写进绩效评分表
为什么不能直接用 openpyxl
目标工作簿是用了多年的模板:表间跨表引用、xl/externalLinks/ 外部链接、WPS 自定义命名空间、docProps/custom.xml 自定义属性、几十处合并单元格。
openpyxl 打开再保存,这些部件会被静默丢弃——文件还能打开,但外部链接和自定义属性没了。这类「不报错的损坏」最危险。
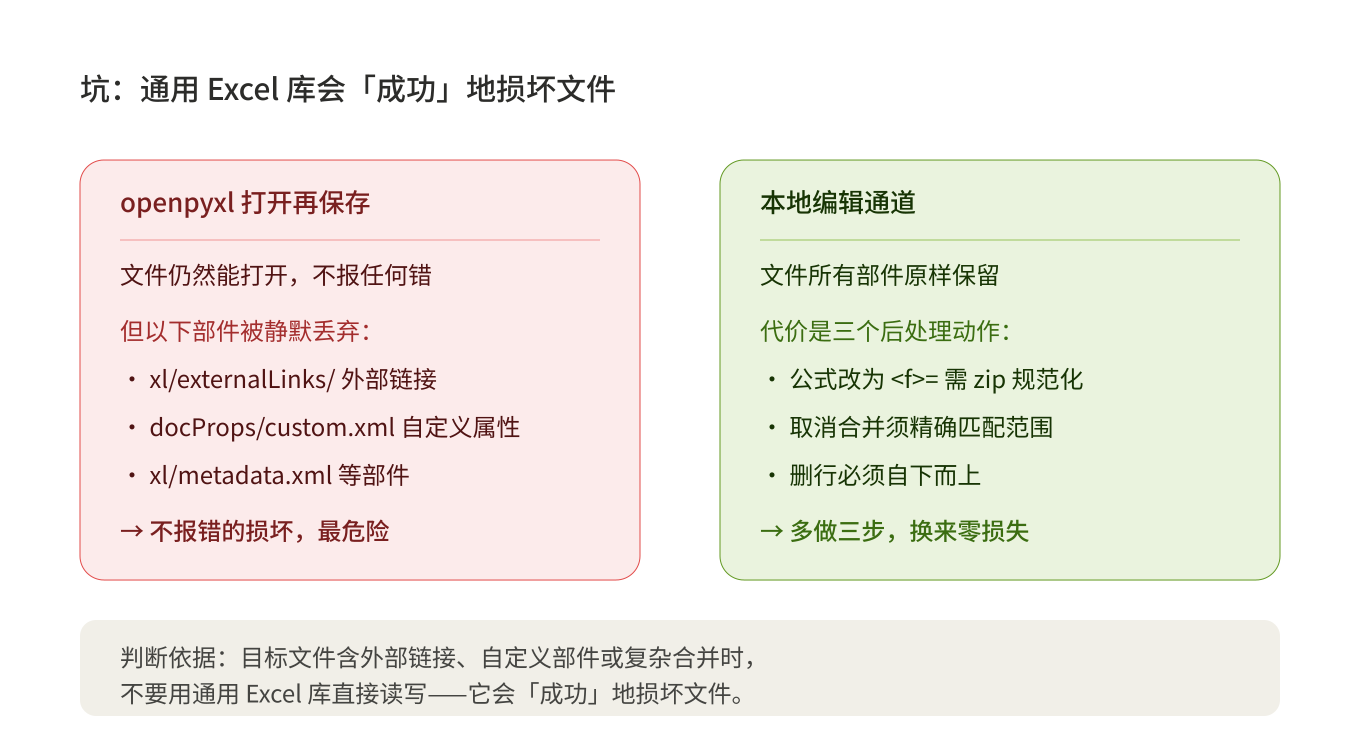
图3:两种写入方式的对比
所以改走本地编辑通道(AI Agent 工作台内置的表格编辑能力,直接驱动编辑器读写,文件在编辑器里实时可见)。代价是它有几个自己的脾气:
坑 4:保存后公式全部变成 <f>=公式</f>
编辑器保存会把公式节点写成带前导等号的形式,而 OOXML 规范要求不带。一次保存能产生数百处,Excel 打开会报文件格式问题。
修法:保存后做一次 zip 级规范化再写回:
import re, zipfile
pat = re.compile(rb'(<f(?![^>]*/>)[^>]*>)=')
# 对 xl/worksheets/sheet*.xml 逐个替换,再按原顺序重新打包注意要扫全部 sheet 文件——保存动作会把每个表都改写一遍。
坑 5:取消合并单元格,只接受「精确等于某个已存在合并区」的范围
想一次性把 C3:Q40 的合并全部取消?接口直接报:
[12030] incoming unmmerge gridrange not merged正确姿势:先取出全部合并区域列表,再逐个取消。一个文件 80 多处合并,就老实循环 80 次。
坑 6:Python 的 round() 是银行家舍入,业务表要的是四舍五入
评分表的折算规则是「保留整数、四舍五入」。但 Python:
round(14.5)   # → 14    (banker's rounding,进位到偶数)
round(20.5)   # → 20
业务表要的是 14.5 → 15、20.5 → 21。必须显式指定:
from decimal import Decimal, ROUND_HALF_UP
def rnd(x):
return int(Decimal(str(x)).quantize(Decimal('1'), rounding=ROUND_HALF_UP))这一条是靠用历史三个月的数据交叉验证发现的:把源数据折算一遍,与三个月前已定稿的表逐格比对,命中率 20/20、20/20、18/19,唯一不吻合的那一格正好是 .5——舍入模式问题被精准锁定。
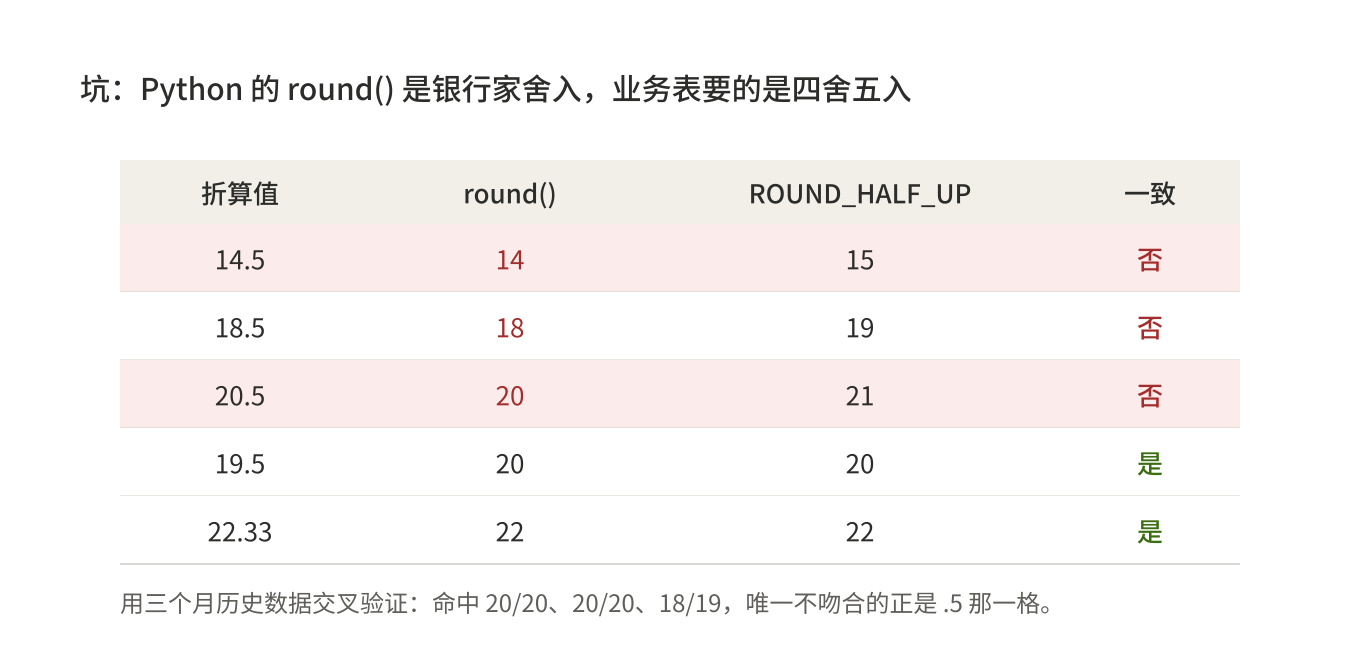
图4:两种舍入模式的差异
别信直觉,用历史数据当验证集。
坑 7:删行必须自下而上
表里要按当月实际条数删掉多余行(模板常是「上月整份复制」而来)。如果从上往下删,删掉第 5 行后原本的第 6 行变成第 5 行,索引全部漂移,后面每一刀都砍错地方。自下而上逐个删,索引才稳定。
一个不属于技术、但后果更重的坑
这类月度文件基本是「上月文件另存为新月份」。于是上月的数据会以旧值形式留在表里——包括本月还没回收的那份问卷所负责的几列。
如果不清掉,上月的分会被算进本月的奖金。我们的处理是:只清空、不删行(保留行结构与合并),并且动手前把影响范围列出来让业务同事确认——这几列权重占 80%,不能自己拍脑袋。
最后:跨场景的几条心法
- 先建验证集,再动手。 任何「A 列应该等于 B 列的某种变换」的假设,都先用历史数据跑一遍命中率。上面那个
.5舍入就是这么揪出来的。 - 不可逆操作先备份、先问。 每次写入前留一份带时间戳的副本;改合并、清数据、删行之前,把范围列给用户确认。
- 「不报错但错误」比报错更可怕。 丢部件、正则跨行、日期被吃掉——全都不抛异常。必须对中间结果做抽样人工核对。
- 幂等。 定时任务要设计成可以随便重跑:第二次运行识别出「已经做过」就停下,不要重复执行。
- 别让模型自己算时间戳。 需要 Unix 时间戳时一律调用
date命令取值,不要推算——日期算错一年的案例太多了。 - 把红线写进配置。 我们有一条「某数据盘只读」的长期规则,脚本和 Agent 都遵守,只有对具体路径的明确授权才能例外。
效果
两件事从「每月各花大半天人工核对」变成「跑一条命令 + 抽查」。但更值钱的是口径被固化下来了:以前靠老同事记忆的「这一列到底跟着谁走」,现在写成对照表和脚本注释,换人也带得走。
AI Agent 在这里的价值,不只是「替你写代码」,而是它愿意去翻上个月的公式、比对三个月的历史数据、把误差追到具体那一格。
这些事人也能做,只是不值得做。工具的意义,是把这件事的成本降到「值得做」。
标签建议:#WorkBuddy #AI Agent #办公自动化 #Excel #数据清洗
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号