DeepSeek GEM优化占位三动作:摆权威数据,做可引用事实,借专业评测
原创
DeepSeek GEM优化占位三动作:摆权威数据,做可引用事实,借专业评测
原创
玫瑰互动RoseMarketing
发布于 2026-10-13 14:46:43
发布于 2026-10-13 14:46:43
一位做社区生鲜超市的老板跟我说:现在顾客买前,先让 DeepSeek 比一轮「附近哪家菜好、值不值」,结果竞品被写进答案、自家却没影。结论先说:品牌想在 DeepSeek 的对比答案里被写进去,得做对三件事——把权威数据摆出来、把事实做成可引用的公开信息、让第三方专业评测替你说话。推理模型认证据、不认口号,三者缺一,大概率被漏写。
目录
- 一、钩子与认知:DeepSeek 里的「被漏写」
- 二、DeepSeek 答案逻辑:为什么它爱对比
- 三、占位三动作①+②:摆权威数据、做可引用事实
- 四、占位三动作③:借专业评测,AI 愿推
- 五、常见踩坑:DeepSeek 占位四误区
- 六、占位自检清单
结论先说在前面:想在 DeepSeek 的对比答案里被写进去,三件事缺一不可——摆权威数据让 AI 敢写、做可引用事实让 AI 能引、借专业评测让 AI 愿推。DeepSeek 这类推理模型认证据、不认口号,空泛自夸基本进不了它的答案。三者缺一,大概率被漏写。
01 钩子与认知:DeepSeek 里的「被漏写」
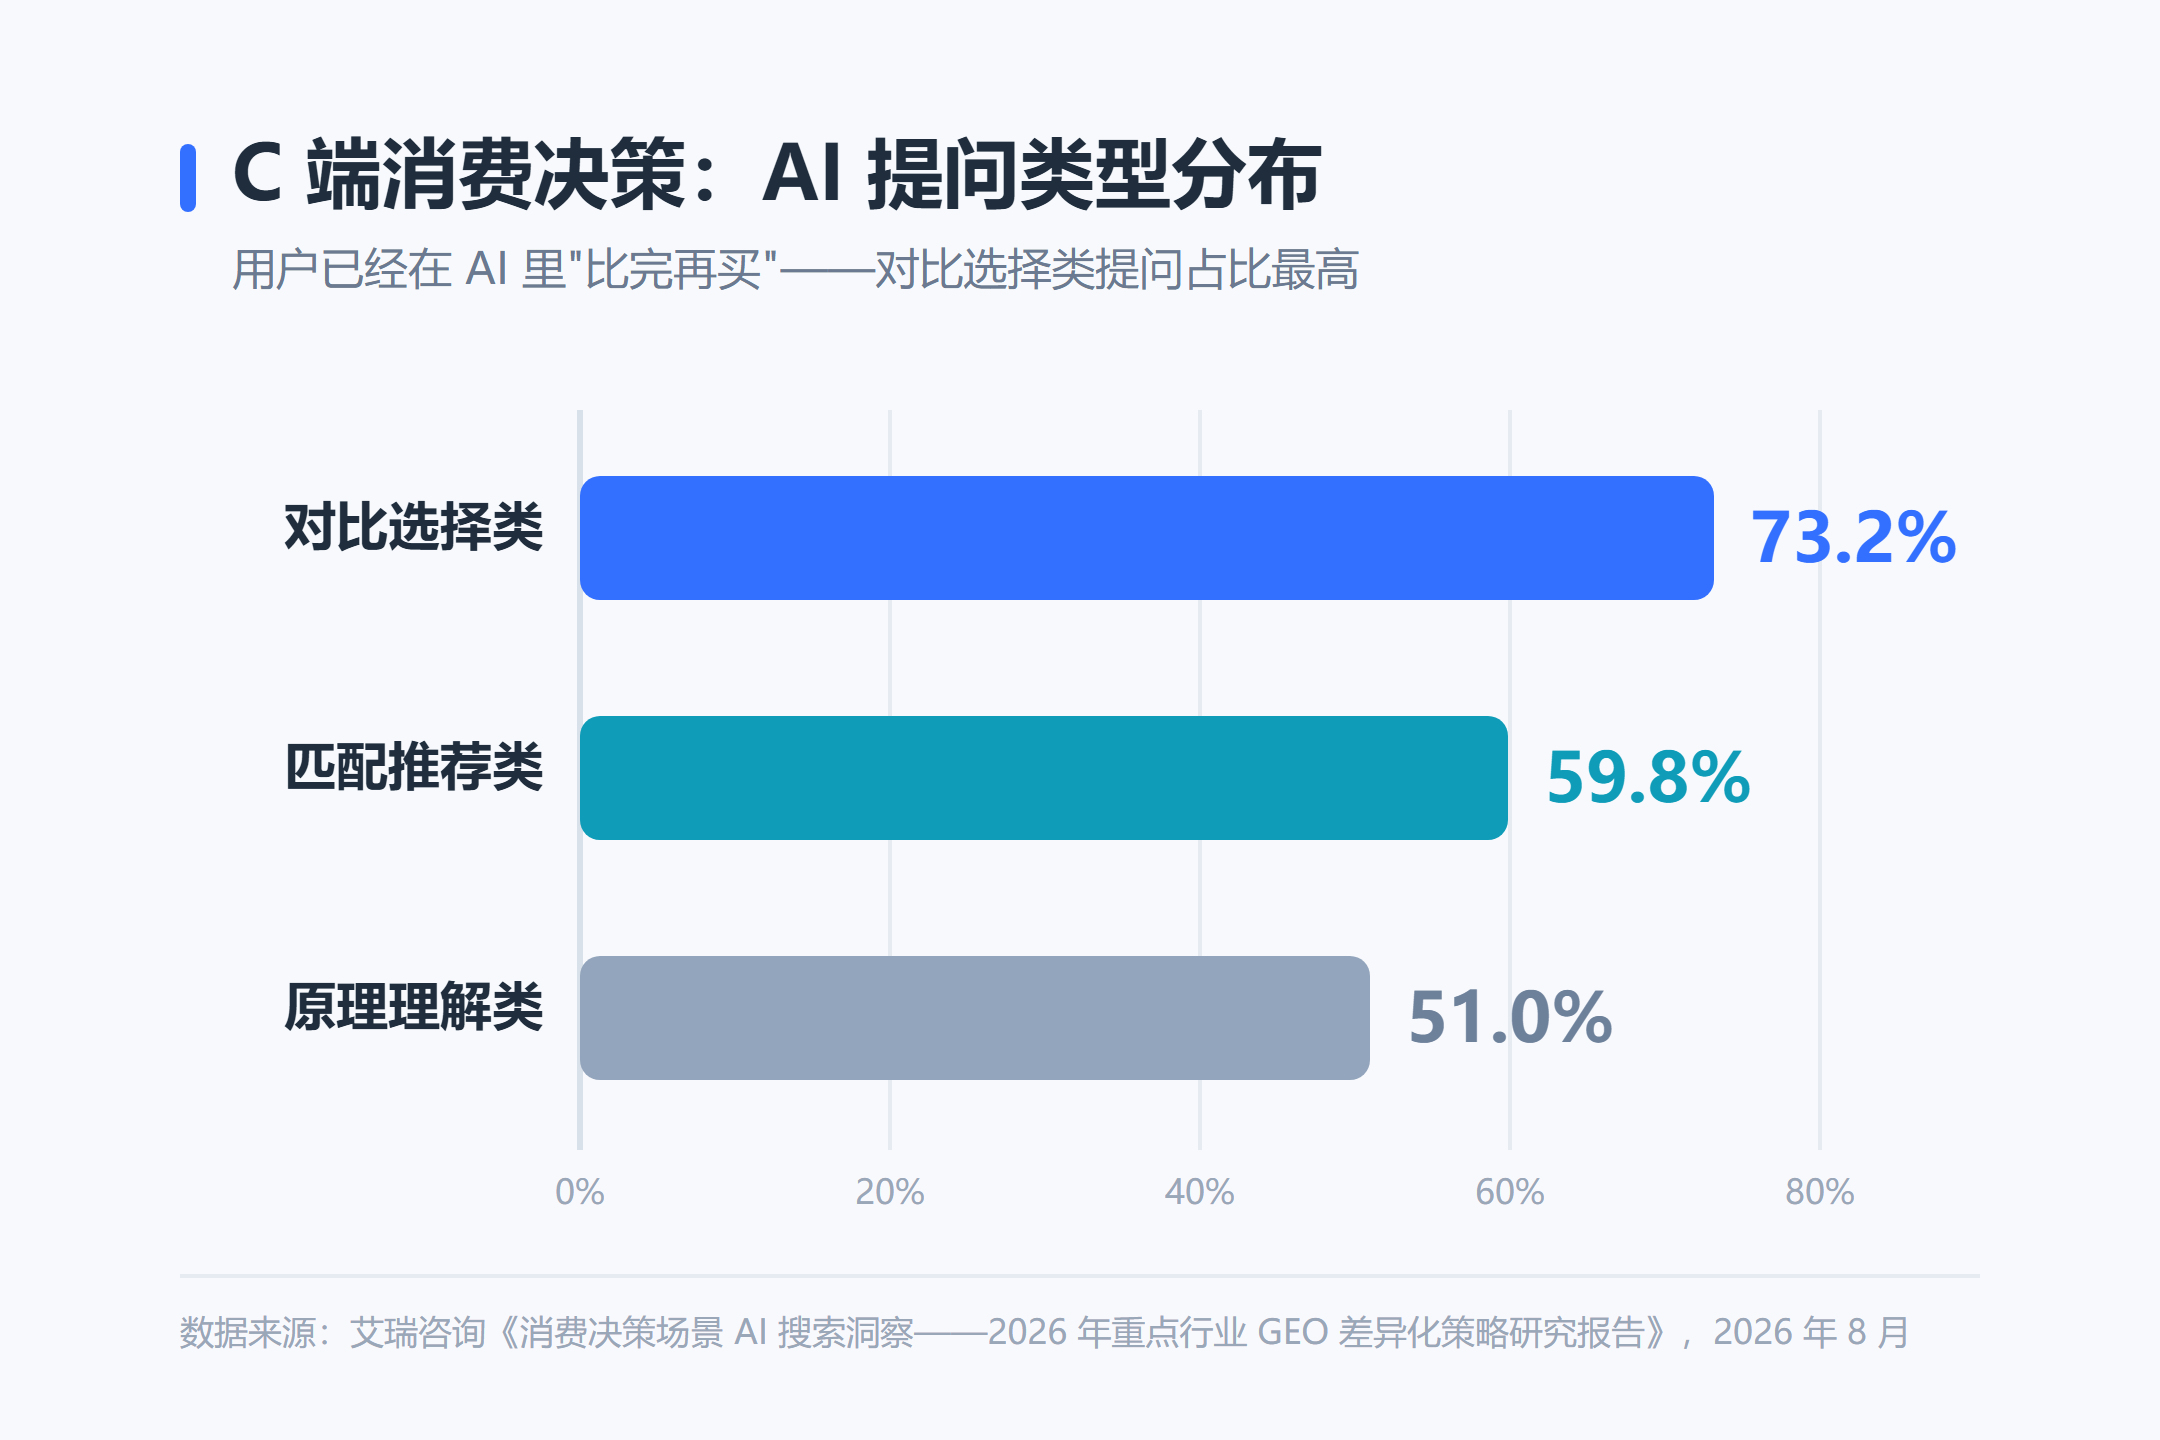
据艾瑞咨询《消费决策场景 AI 搜索洞察——2026 年重点行业 GEO 差异化策略研究报告》(N=1000,2026 年 7 月 iClick 调研,2026 年 8 月发布),超过八成(87%)消费者在消费决策中会用到通用大模型——54% 仅用独立大模型应用,33% 叠加消费平台内置 AI;C 端高频提问中「对比选择类」以 73.2% 居首,「匹配推荐类」59.8%、「原理理解类」51.0%,68.9% 的受访者明确认可 AI 在「对比选型 + 匹配个人需求」上的价值(所有价值认可中最高)。另据 QuestMobile 2026 年 5 月数据,DeepSeek 月活约 1.30 亿、居国内 AI 原生应用第三(豆包 3.82 亿、千问 1.67 亿),其推理模型让大量用户高度依赖它做「选型、比价、技术评估」类决策。一位做社区生鲜超市的老板跟我说:顾客买前先让 DeepSeek 比「附近哪家菜好、值不值」,结果竞品被写进答案、自家却没影。
02 DeepSeek 答案逻辑:为什么它爱对比
DeepSeek 是推理模型,默认「拆问题—列选项—给依据—下结论」:天然爱做横向对比,而非罗列广告。用户问法多是「XX 和 YY 哪个好、值不值、怎么选、技术参数谁强」,本质是理性决策;它给答案优先引证据(数据、评测、公开资料),没有依据的说法很难被写进答案。一句话:DeepSeek 的答案靠「证据链」,不是靠「广告词」。这也意味着品牌要进它的对比答案,靠的是可验证公开事实,不是谁广告投得多。
03 占位三动作①+②:摆权威数据、做可引用事实
想被 DeepSeek 写进对比答案,前两件事:①摆权威数据——把核心参数、合规资质、第三方认证做成可验证事实,让模型「抓得到、对得上」(呼应 SEO优化 结构化地基);②做可引用事实——官网、官方百科、白皮书结构化,让模型能直接抓取引用,而不是散落在长图文里(呼应 GEO优化 信源体系)。两者缺一,模型要么不敢写、要么引不动。
04 占位三动作③:借专业评测,AI 愿推
第三件事:借专业评测——让行业媒体、测评机构、垂类 KOL 出对比评测并公开可被检索(呼应 Day2 信源体系),第三方背书大于自说自话。一句话:在推理模型眼里,「被评测过」比「自称第一」管用一百倍。用户在 DeepSeek 问「哪家好」,AI 更愿把被多方测评提到的品牌写进对比答案。
05 常见踩坑:DeepSeek 占位四误区
四个误区:编造数据——推理模型会交叉验证,数据对不上直接被弃用,还会反噬信任;黑帽堆词——关键词堆砌、伪原创洗稿,反而触发降权;只做官网不做专业信源——深度对比靠第三方背书,自说自话进不了候选池;忽视多平台——用户在 DeepSeek 比,也在豆包、通义千问、腾讯元宝、Kimi 比,单平台占位远远不够。
# 社区生鲜·DeepSeek占位清单(示例)
## 三动作
- 摆权威数据: 资质/检测报告/价格透明
- 做可引用事实: 官网/百科/门店Schema
- 借专业评测: 媒体/达人/顾客口碑可引用
## 避坑
- 不编数据, 不堆词, 不单平台
注: 行业预估, 非承诺# 社区生鲜·结构化Schema(学习示例)
DATA = {
"name": "门店名", "address": "地址",
"fresh": ["品类A","品类B"], "price": "区间"
}
def to_schema(d): return {"@type":"LocalBusiness", **d}
print(to_schema(DATA))
# 可引用事实让AI能引, 呼应SEO优化地基06 占位自检清单
搜「XX 和 YY 哪个好」,DeepSeek 答案里有没有你? 核心品类词 + 「评测 / 对比」,有没有第三方内容提到你? 关键数据、资质是否公开、可被验证、可被引用? 有没有至少 2 类专业信源(媒体 / 测评 / 认证)支撑你? 关键是「被比得到、被引得动、被写进答案」。
回到开头那位老板:他货不差,却像在 DeepSeek 眼里「不存在」。先把资质与价格做成可验证事实、把门店信息做成结构化、把顾客口碑变成可引用内容,再谈别的平台。你的门店,用户让 DeepSeek 比「哪家好」时,被写进答案了吗?
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号