把 Tailscale 接进 Prometheus 监控
原创
把 Tailscale 接进 Prometheus 监控
原创
东风微鸣
发布于 2026-10-14 10:37:00
发布于 2026-10-14 10:37:00
背景
终于等来了国庆长假!宅在家折腾自己的 HomeLab、 K8s、 NAS 服务器集群的感觉真爽!这次长假真的是折腾了好多东西,感兴趣的读者请期待后续的爆更,等不及的话也可以直接看我的 repo - east4ming/homelab2 的 PR 和 Commits。
homelab2 这套环境不大:4 台 node(3 master + 1 worker),Ubuntu 26.04.1,K3s v1.36.5,能跑的都跑上了。就是这 4 台机器,我给它套了一层 tailscale-operator(外加原生的 Linux 版本 tailscale),用 ProxyGroup 把 Ingress 和 egress 流量都塞进了 tailnet。
问题也随之而来:我根本不知道 Tailscale 那层在发生什么。
- 节点上的
tailscaled是不是在报 health message? - 有没有 packet 被 drop,reason 是什么?
- 代理 Pod 起来了,但它真的连上 control plane 了吗?
- DERP 是不是偷偷给我换了个远的 region?
没有指标,这一切都只能靠 tailscale status 手动肉眼看,出了事再 ssh 进去查。这显然不行。于是我趁着国庆长假有时间把 Tailscale 的指标监控给落地了。
这篇主要就讲监控的实现和取舍,顺便把整条链路交代清楚。
📝声明:
本文所有结论都基于 homelab2 这套具体环境的实测。Tailscale 迭代很快,请以你手上的版本源码为准。
最终效果展示
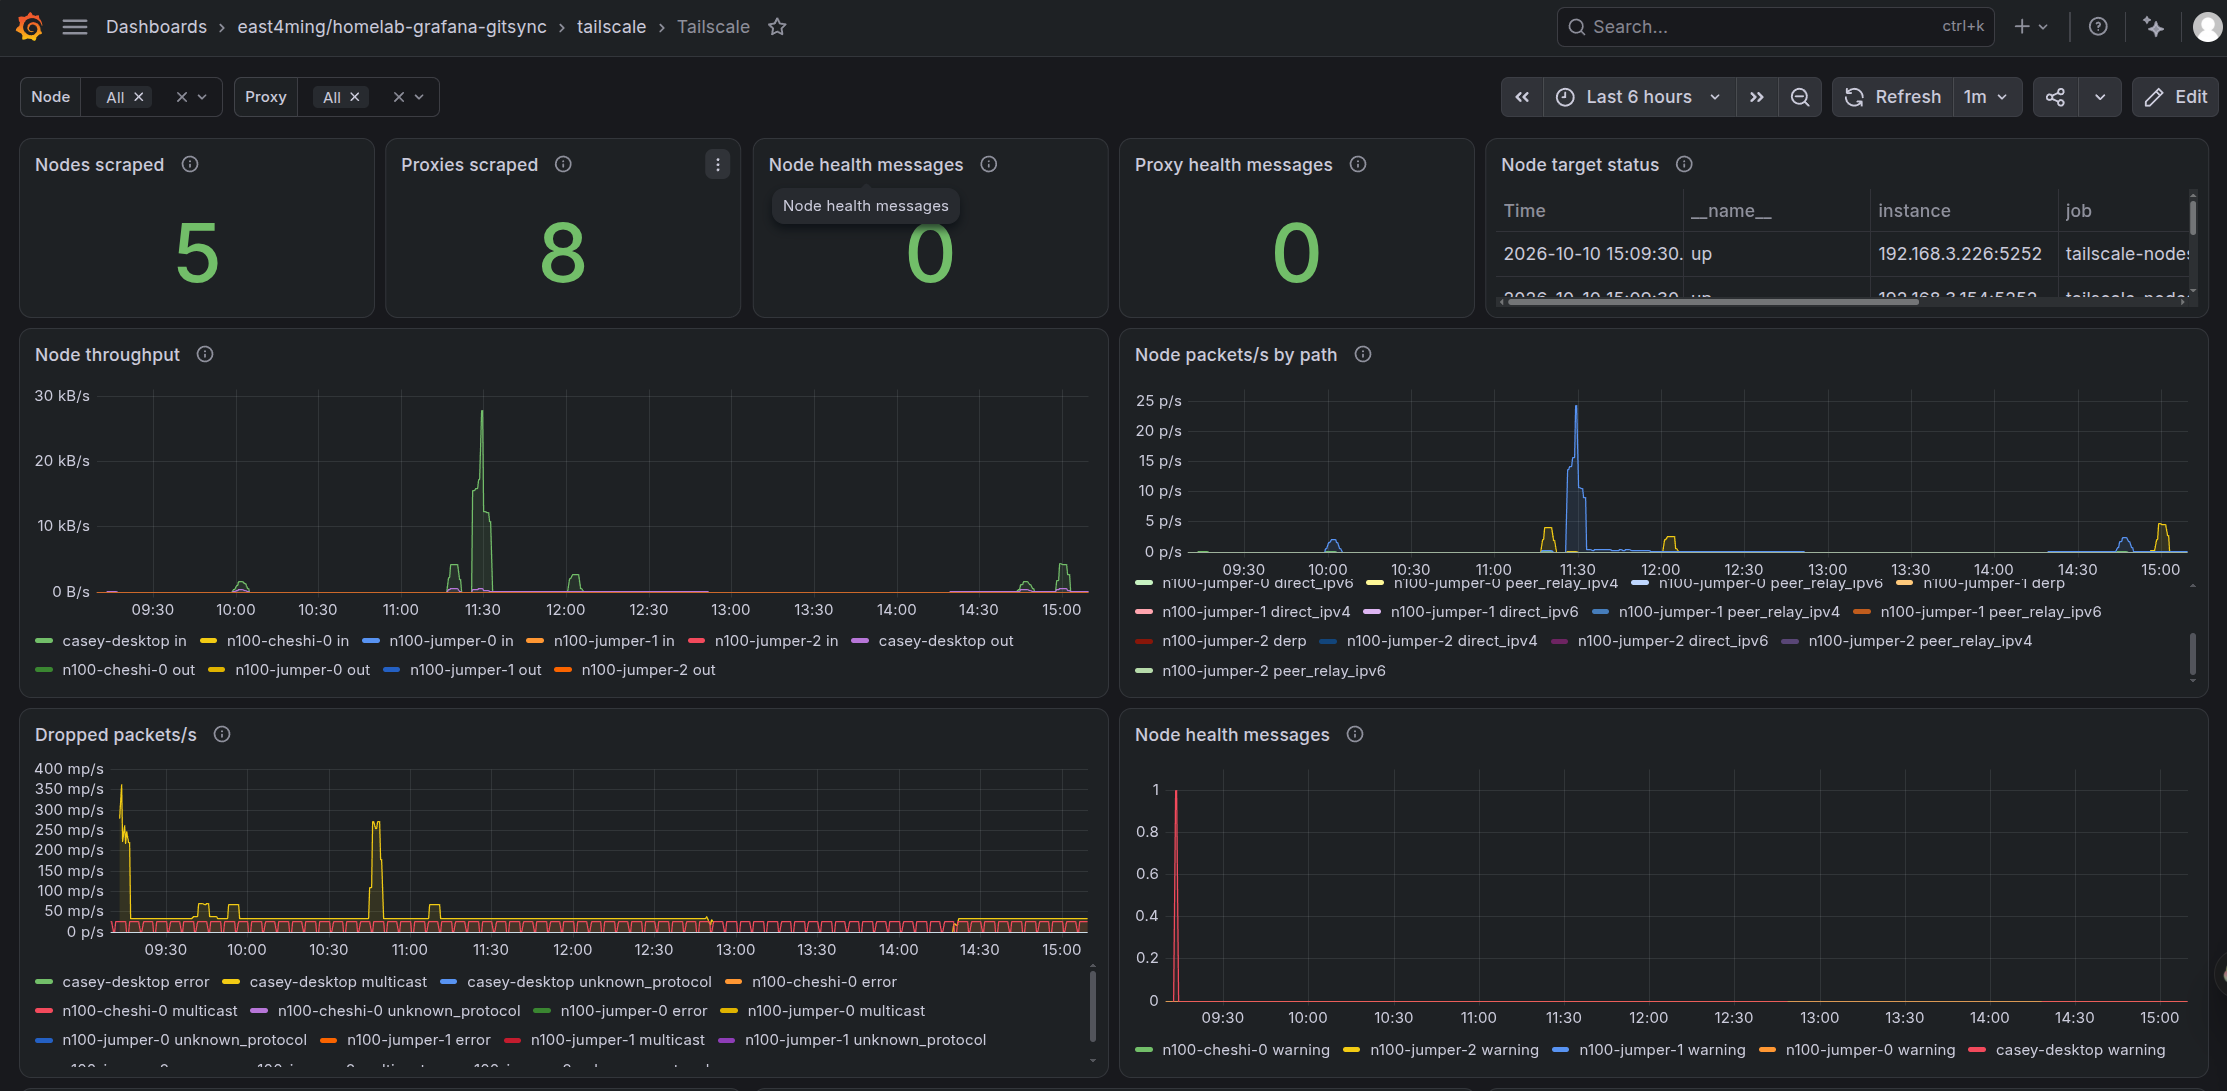
Tailscale Dashboard 1
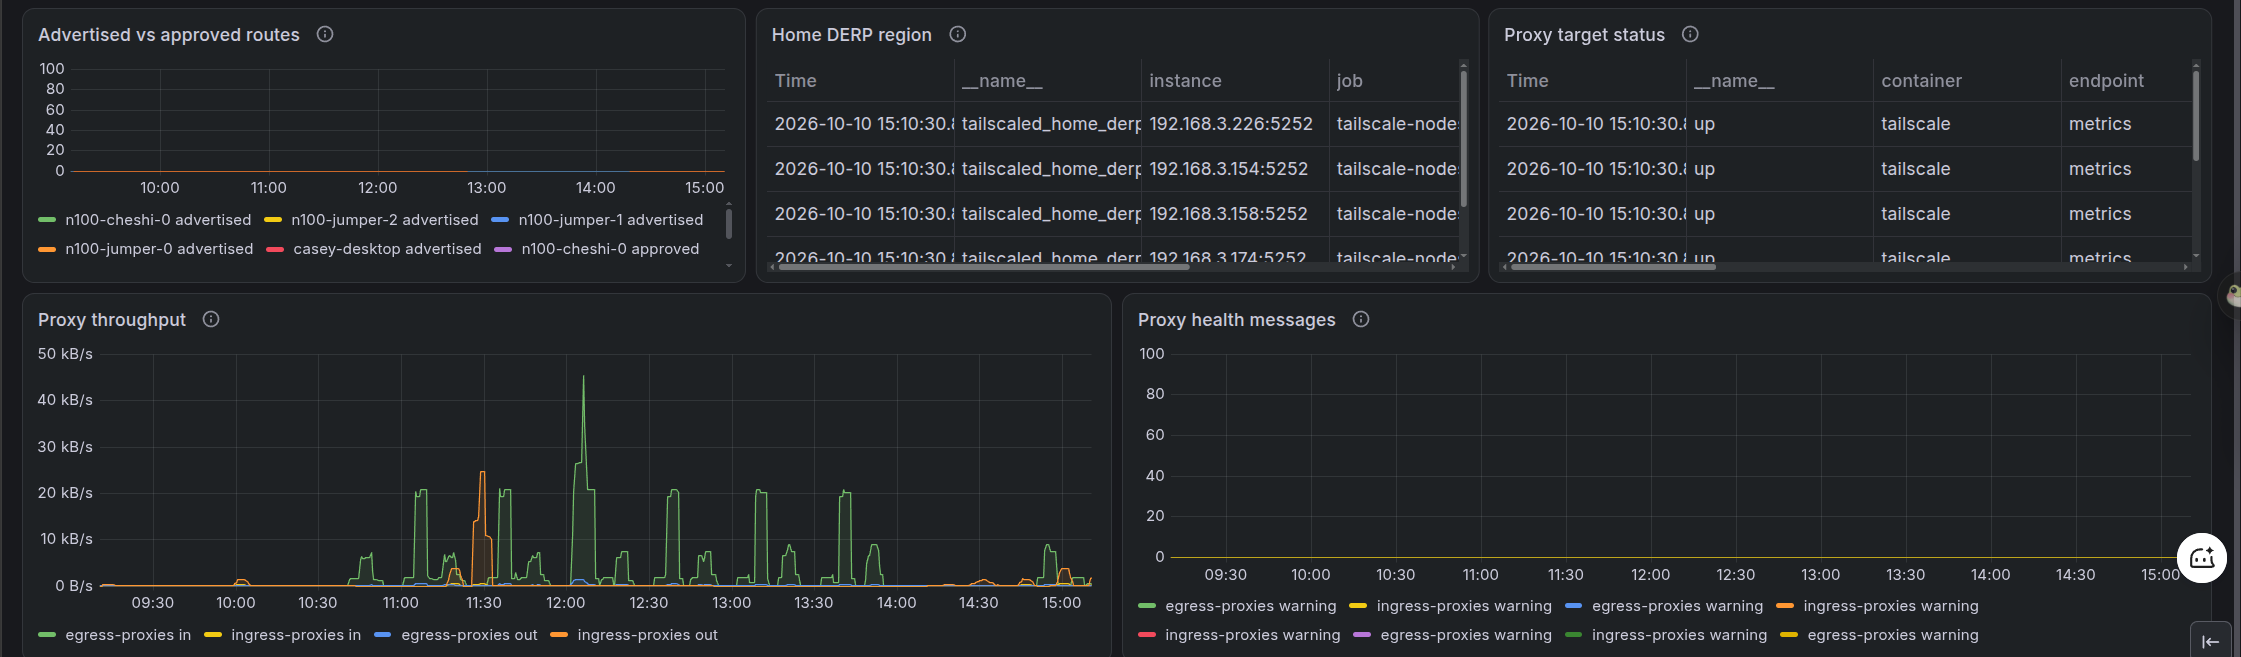
Tailscale Dashboard 2
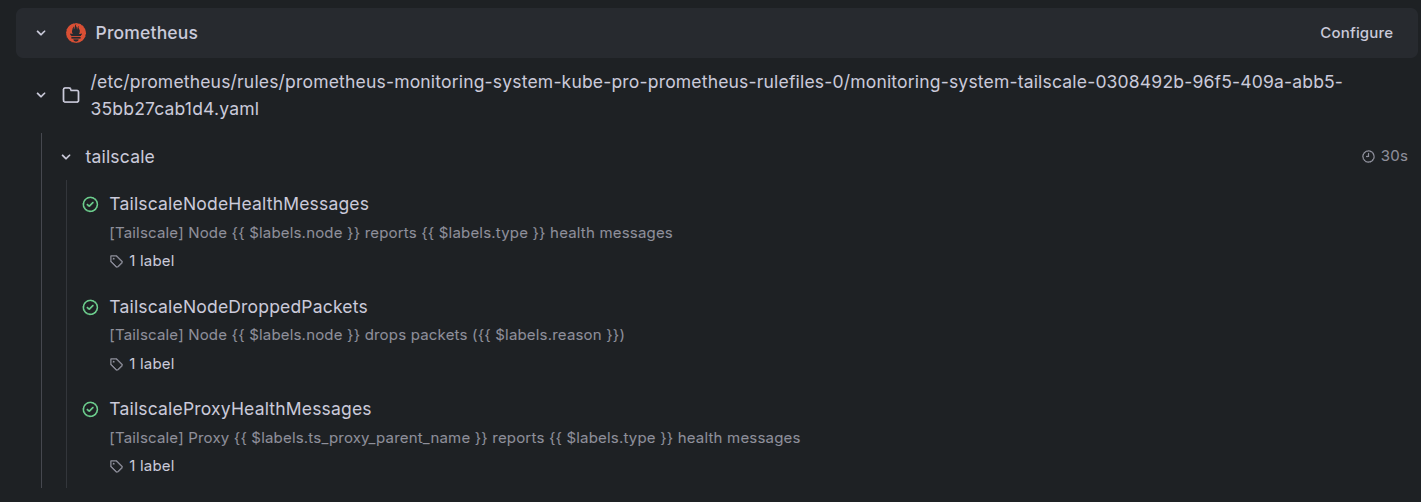
Tailscale Prometheus Alertrule
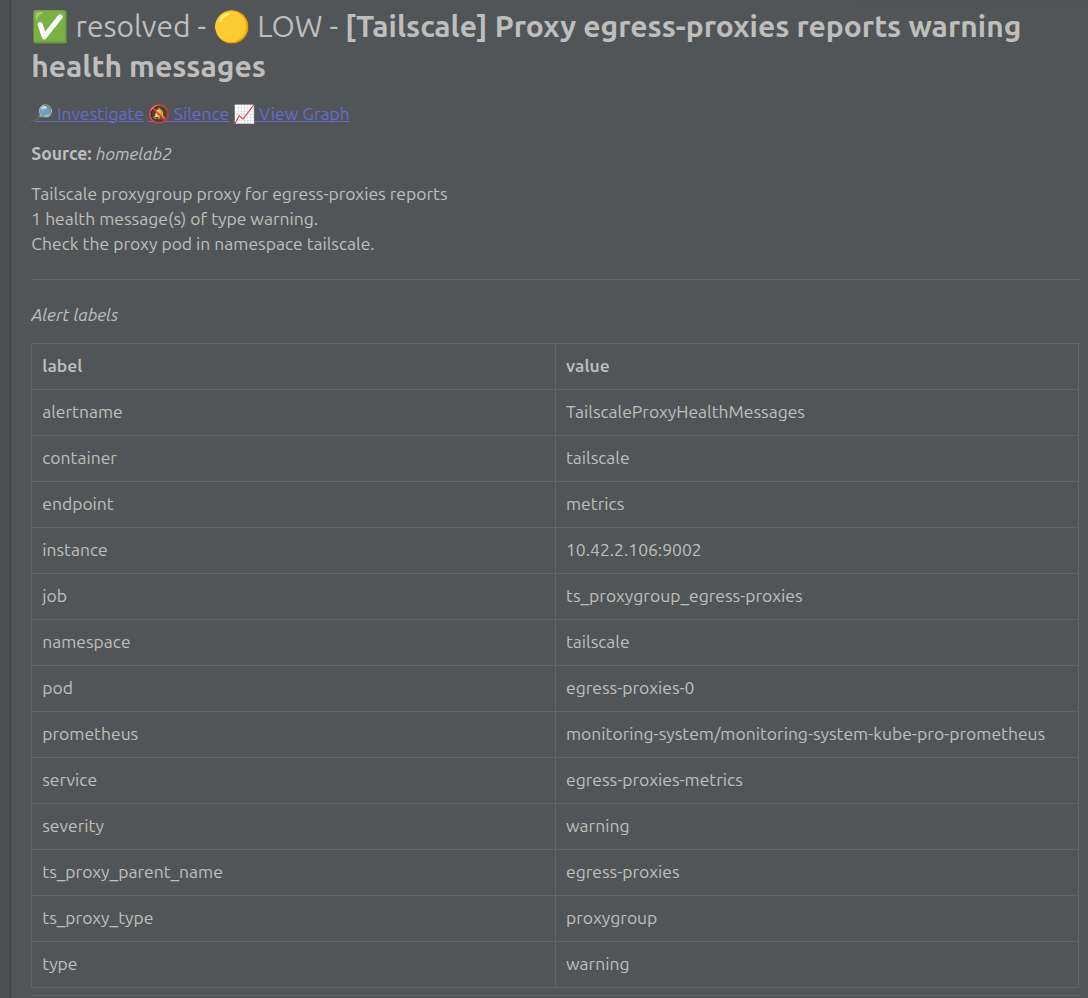
Tailscale Alert 1
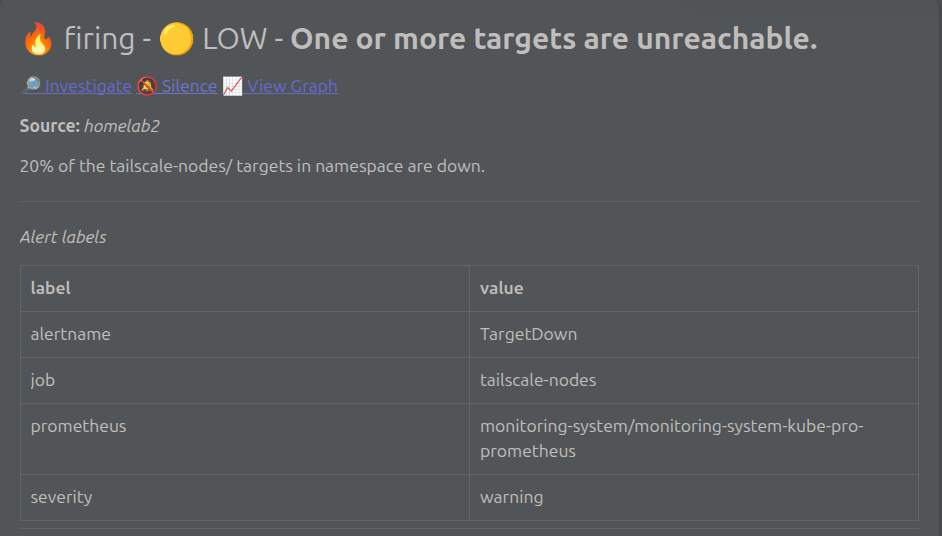
Tailscale Alert 2
整体设计:两条链路,各用其道
先说结论:这套方案不是"一套机制走天下",而是明确分成两条链路。
链路 | 采集对象 | 机制 | target 数 |
|---|---|---|---|
节点侧 | 4 台 node 上的 | Ansible 部署 systemd 服务 + Prometheus 静态抓取 | 4 |
集群侧 | ProxyGroup 管理的代理 Pod | ProxyClass(metrics + ServiceMonitor) + operator 自动发现 | 8 |
节点侧不用 ServiceMonitor,是因为 tailscaled 跑在宿主机上,不在 K8s 里,Prometheus Operator 根本看不见它,只能走静态 additionalScrapeConfigs(其实也能基于 prometheus nodescrape)。集群侧反过来,代理 Pod 是 operator 动态创建和销毁的,硬编码 IP 就是给自己挖坑,必须用 ServiceMonitor 让 operator 自己声明。
两条链路边界清楚,这也是我想强调的一点。
节点侧:只读端点 + 静态抓取
节点侧实现很短,本质就是一条命令包成 systemd 服务:
# /etc/systemd/system/tailscale-metrics.service
[Unit]
Description=Tailscale read-only metrics endpoint
After=tailscaled.service

[Service]
ExecStart=/usr/bin/tailscale web --readonly --listen <node-lan-ip>:5252
Restart=always

[Install]
WantedBy=multi-user.target
两个细节:
--readonly:不加这个参数,tailscale web暴露的是完整可写控制界面。放到监控端口上,这跟把控制台挂公网没区别。只读模式只暴露指标和状态,安全边界清晰。- 绑定
<node-lan-ip>而不是0.0.0.0:跟既有的 node-exporter 保持一致的暴露模型,只在内网可达,UFW 单独放行。顺手也验证了一下,100.100.100.100:5252(Tailscale 自己的 local API)返回000,说明这个 web 端点是独立于 tailscaled 本地 API 的,不会误打误撞。
实测这个端点返回 12 个 metric family / 27 条序列,我实际用得上的是这些:
tailscaled_advertised_routes/tailscaled_approved_routes——路由有没有被批准,一眼看穿tailscaled_health_messages{type=...}——tailscaled自己报的健康问题tailscaled_home_derp_region_id——home DERP 在哪个 regiontailscaled_inbound/outbound_bytes_total、..._packets_total——流量tailscaled_inbound/outbound_dropped_packets_total{reason=...}——丢包,带 reason,这个我最喜欢tailscaled_serve_inbound/outbound_bytes_total——tailscale serve的流量
Prometheus 侧就是在 kube-prometheus-stack 的 additionalScrapeConfigs 里加一段静态 job:
- job_name: tailscale-nodes
  static_configs:
    - targets: ["192.168.3.226:5252"]
      labels:
        node: n100-jumper-0  # 每台单独打 node 标签方便识别
    - targets: ["192.168.3.174:5252"]
      labels:
        node: n100-jumper-1
    - targets: ["192.168.3.158:5252"]
      labels:
        node: n100-jumper-2
    - targets: ["192.168.3.154:5252"]
      labels:
        node: n100-cheshi-0
    - targets: ["192.168.3.246:5252"]
      labels:
node: casey-desktop 📝Notes:
这里没走 node-exporter 的 textfile collector。两个原因:一是不想动 node-exporter 的启动参数和 hostPath 挂载(改一处牵连一片);二是 textfile 有文件写入的 staleness 问题,tailscaled 挂了但文件还在,指标会"骗人"。独立 job 抓不到就是抓不到,语义干净。
集群侧:ProxyClass 与那个被否决的"默认"方案
集群侧的思路是加一个专门的 ProxyClass:
apiVersion: tailscale.com/v1alpha1
kind: ProxyClass
metadata:
  name: tailscale-metrics
spec:
  metrics:
    enable: true
  serviceMonitor:
    enable: true
然后让 ingress-proxies(4 副本,承载 22 个 Ingress)和 egress-proxies(4 副本)两个 ProxyGroup 通过 spec.proxyClass: tailscale-metrics 显式引用。operator 就会为每个代理创建 <sts>-metrics Service(端口 9002)和同名 ServiceMonitor,最终 8 个 target 全部 up=1。
到这里一切顺利。真正的坑在"要不要把它设成默认 ProxyClass"。
Helm values 里有个 proxyConfig.defaultProxyClass,会转成 operator 的 PROXY_DEFAULT_CLASS 环境变量。直觉上这是最省事的做法:设一次默认,所有代理自动带上 metrics,不用逐个 ProxyGroup 去改。
我差点就这么干了。但翻了一下源码,发现不对。
cmd/k8s-operator/sts.go:1045 这段逻辑:对于带 tailscale.com/experimental-forward-cluster-traffic-via-ingress 注解的 Ingress 代理,operator 会明确打印"不支持 metrics"然后跳过。但是 reconcileMetricsResources() 依然会老老实实给它们创建 metrics Service 和 ServiceMonitor。
结果就是:8 个带该注解的独立 Ingress 代理,会产生 8 个永久 up=0 的 target。
而这 8 个 up=0 会直接触发 kube-prometheus-stack 自带的 TargetDown 告警。我在测试环境上实测确认,告警状态确实进了 pending。
🤔 一个"更优雅"的默认配置,换来 8 个永远不会好的 target 和持续的误报噪音。这笔账怎么算都不划算。
所以最终方案是:不设默认 ProxyClass,改由两个 ProxyGroup 显式引用。
明确排除的范围:不采集,也不假装采集
顺着源码继续看,还有两处上游限制是明确要排除的:
- 带
experimental-forward-cluster-traffic-via-ingress注解的独立 Ingress 代理(8 个)——就是上面说的,不支持。 - 独立 egress 代理(10 个)——
cmd/k8s-operator/metrics_resources.go里对 egress 代理直接return nil。注意这里不报错,只是没有指标,属于"静默无指标"。
第 2 点的性质跟第 1 点不一样:第 1 点会产生 up=0 的坏 target,第 2 点只是没有 target。所以从"不制造误报"的角度看,egress 代理这边是安全的。
operator Deployment 自身的指标我也一并排除了——tailscaled_* 才是我们要的,operator 自身的 Go runtime 指标价值不高,纯属噪音。
告警:3 条新增 + 复用既有
告警规则我新增了 3 条:
TailscaleNodeHealthMessages——节点侧tailscaled_health_messages非零TailscaleNodeDroppedPackets——节点侧丢包速率异常,带 reason 维度TailscaleProxyHealthMessages——集群侧代理的健康消息
抓取中断这件事,我没有重复定义告警。kube-prometheus-stack 里已经有 TargetDown / KubePodNotReady / KubeStatefulSetReplicasMismatch,覆盖得挺好。再写一套 exporter down 告警,只会让同一件事响两遍,我会疯。
📝Notes:
这个原则我一直在用:能复用既有告警语义的,绝不重复定义。告警不是越多越好,是越准越好。
Grafana dashboard:为什么自己维护
先给调研结论,省得你再去翻一遍:
- grafana.com 上不存在基于客户端指标
tailscaled_*的 dashboard(api/dashboards?name=tailscale精确匹配无结果) - 24177 / 24178 这两个看起来相关的,依赖的是 API 型
grafana/tailscale-exporter(需要 Tailscale API Key),指标名字对不上,用不了 - Zydepoint/Tailscale-dashboard 确实用
tailscaled_*,但只有节点视角,而且不在 grafana.com 上
所以 dashboard 就放仓库里自己维护:system/monitoring-system/files/dashboards/tailscale.json,14 个面板,配 sidecar ConfigMap,uid 设成 tailscale。节点视角和代理视角都有数据。
这不是我有多爱写 JSON,纯粹是没有现成可用的 + 告诉 AI 一句话的事。
部署路径与那个凭据的坑
这套东西横跨三条部署路径,边界得分清楚:
system/monitoring-system→ 走 ArgoCD- tailscale namespace 下的 CR(ProxyClass、ProxyGroup)→ 走
metal/roles/tailscale(operator 本身就是 Ansible 管的。因为 tailscale 先于 ArgoCD 安装。) - 节点侧 systemd 服务 → 沿用唯一的 node 级收敛 role
prerequisites(UFW 例外也在这)
验证
# 端到端
curl -s http://<node-ip>:5252/metrics | head   # 4 台都返回 200
# Prometheus API
# up{job="tailscale-nodes"}  → 全 1
# up{job=~"ts_.*"}           → 全 1
成功标准就是几条硬指标:4 个节点 target + 8 个代理 target 全部 UP,且没有任何 up=0 的 Tailscale target;3 条告警规则已加载且无持续误报;Grafana 节点与代理面板均有数据;5252 端口只读且未监听 0.0.0.0。
还有一条我特别看重:IaC + GitOps, 即重新同步 ArgoCD + 重跑 Ansible 就能复现全部配置,不需要 Git 之外的手工 kubectl apply。这条不满足,前面做得再漂亮也是白搭。
总结
回到标题。为什么放弃默认 ProxyClass?因为它的"优雅"是假的:
- 👍 设一次默认,所有代理自动带 metrics,配置量最小
- 👎 会给 8 个带特定注解的 Ingress 代理制造永久
up=0的 target - 👎 直接触发既有
TargetDown告警,持续误报,污染告警通道
改用两个 ProxyGroup 显式引用,多写两行 YAML,换来的是零误报、零坏 target。这个取舍我认为没有任何犹豫空间。
几条可以带走的原则:
- 接入监控的第一原则是"不制造噪音"——一个永久失败的 target 比没有监控更糟,它会训练值班的人忽略告警。
- 上游行为有疑问就去看源码,别猜。
sts.go:1045那一行比任何文档都靠谱。 - 分层设计,各用其道:宿主机上的东西走静态抓取,K8s 里的东西走 ServiceMonitor,不要硬凑成一套。
- 告警能复用就复用,重复定义只会让同一个故障响两遍。
- 凭据边界要刻在脑子里,"看起来无害"的命令可能直接把生产凭据冲掉。
纸上得来终觉浅,绝知此事要躬行。文档说"支持 metrics",实测告诉你"只支持一部分代理",中间那段落差,只能靠自己一行行核实。
以上。
📚️参考文档
- Tailscale Kubernetes Operator - ProxyClass
- tailscale-operator Helm chart
- Tailscale 官方仓库
cmd/k8s-operator/sts.go - Tailscale 官方仓库
cmd/k8s-operator/metrics_resources.go - kube-prometheus-stack - additionalScrapeConfigs
EOF
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号