#WorkBuddy# 近 700 页乱序扫描件 → 一份可直接交付的资料汇编:8 个坑、3 条铁律与完整代码思路
原创
#WorkBuddy# 近 700 页乱序扫描件 → 一份可直接交付的资料汇编:8 个坑、3 条铁律与完整代码思路
原创
用户8553481
修改于 2026-10-15 10:48:14
修改于 2026-10-15 10:48:14
一个看起来"只是把 PDF 拼起来"的任务,实际做下来我踩了 8 个坑——有的非常隐蔽,静默发生、不报错,直到交付前才被发现。本文把整体工作流、技术方案与全部踩坑记录写出来,代码思路完整给出,希望能帮你少走弯路。全文已脱敏,不含任何可识别的企业、客户、人员、项目编号与产品参数信息。
目录
- 一、任务背景:一堆"不可检索"的扫描件
- 二、最终成果
- 三、整体工作流:数据与代码分离
- 四、8 个坑,逐个拆
- 五、沉淀出的 3 条硬规则
- 六、几个工程小技巧
- 七、脱敏说明与合规声明
- 八、总结
一、任务背景:一堆"不可检索"的扫描件
我手上有一批机械制造质量资料,来源五花八门:
- 扫描件(有的是照片级扫描、没有文本层;有的带 OCR 层)
- 矢量电子文档(PDF / DOCX 导出)
- 页面尺寸、方向都不统一:有横版有竖版,还有整页倒置 180° 的
要求是:按一份已有计划的序号,把这些资料组织成一份"可交付"的汇编 PDF —— 要有封面、编制说明、目录、连续页码、书签,还要在每节左上角标注"序号 + 页码",并在部分页面上框选出关键数据行。
听起来像"拼 PDF",但真正做下来,难点全在对位和可追溯上。
二、最终成果
项目 | 结果 |
|---|---|
汇编成品 | 696 页 / 68 个书签 |
内部结构 | 10 个大节 + 13 个子节 |
页面元素 | 自动连续页码;页眉公司抬头 Logo;逐节序号标注 |
数据定位 | 44 页红框框选;5 页方向校正(含整页倒置) |
资料整理 | 200+ 个文件按序号归位,零删除 |
磁盘占用 | 从 7.5 GB 精简到 1.2 GB |
三、整体工作流:数据与代码分离
核心思路只有一句话:数据与代码分离,配置驱动。
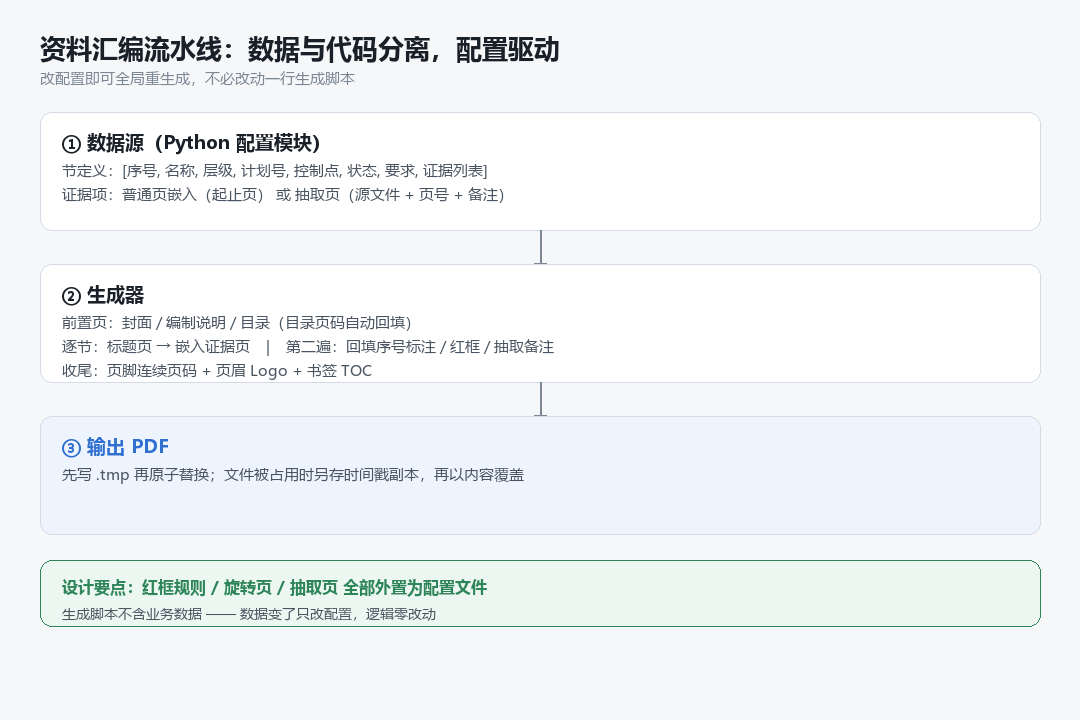
资料汇编流水线:数据与代码分离、配置驱动
关键设计:红框规则、旋转页、抽取页全部外置为配置文件;生成脚本里不含任何业务数据。改配置就能全局重新生成,不必改动一行生成脚本。
数据源长这样(伪代码):
节定义 = [序号, 名称, 层级, 计划号, 控制点, 状态, 要求, 证据列表]
证据项 = 普通页嵌入(起止页)  或  抽取页(源文件 + 页号 + 备注)
四、8 个坑,逐个拆
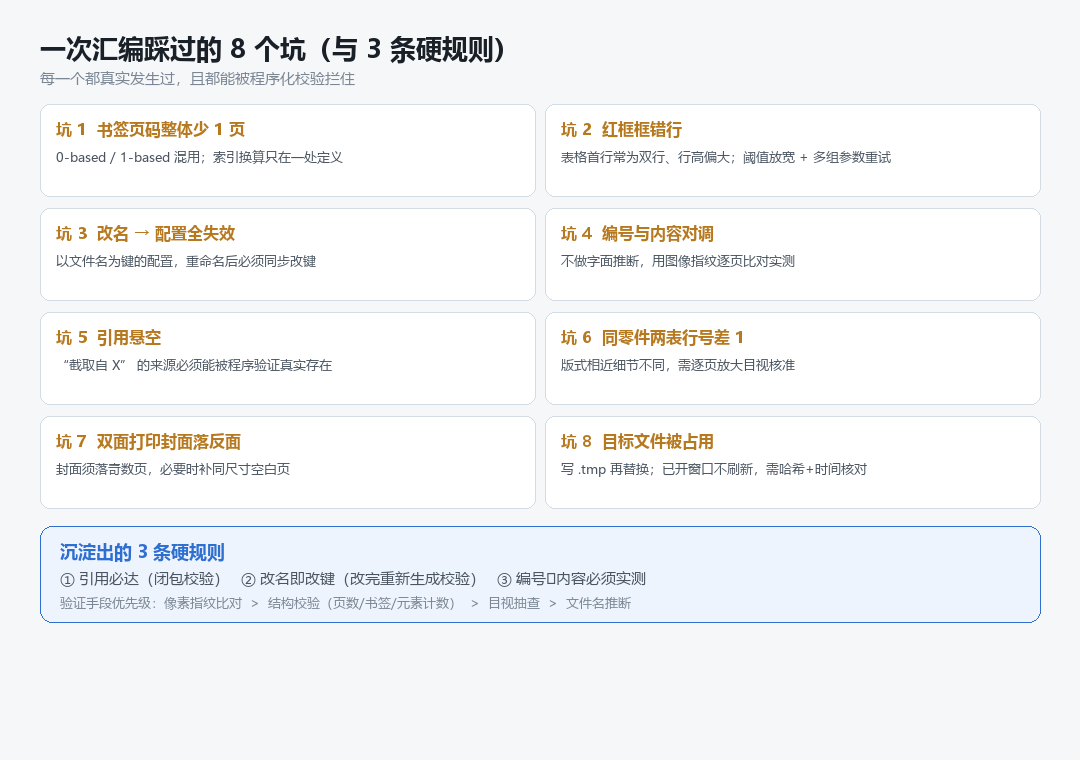
一次汇编踩过的 8 个坑与 3 条硬规则
坑 1:书签页码整体少 1 页
现象:点书签跳到第 168 页,内容其实在第 169 页。
根因:0-based 与 1-based 混用。标注和页映射都写了 front + idx + 1,唯独书签漏了 +1。
教训:跨模块的索引换算,只在一处定义,其他所有地方引用它。
坑 2:红框框错行
现象:某页本该框第 2 行,却框到了第 3 行。
排查:把程序检测出来的"表格行边界线"直接画到页面上目视——发现该页检出了 14 条线(尾部多了一条表格外线)。
真实根因:表格第 1 行常常是双行标注,行高比常规行大 30%,而等距筛选的阈值设成了"中位行距 × 0.30",正好卡在临界点上。这一页失败后就回退到固定几何常量,于是整体偏移一行。
解决:阈值放宽到 × 0.45;同时改成多组参数依次重试,只有第一组失败才启用备选——这样已正确的页面零回归。
PARAMS = [(150, 0.22), (205, 0.20), (205, 0.14), (210, 0.10)]
for gray, frac in PARAMS:
    result = detect_once(page, gray, frac)
    if result:
        return result
坑 3:改文件名 → 配置全部失效(最惨的一个)
现象:整理文件(重命名)后重新生成,页数完全正确,但红框从 44 页变成 0 页。
根因:红框配置的 key 是源文件名:
{"某零件表.pdf#3#6.3": {"groups": [{"rows": [6], "label": "割齿"}]}}构建时用 os.path.basename(path) 拼 key 去查。文件一改名,46 条 key 全部失配,于是红框静默消失、不报任何错。
教训(血泪):
- 以文件名为键的配置,重命名文件必须同步改 key;
- 引用常量/变量的配置(如按路径取页)会自动跟随,不受影响;
- 重命名后必须重新生成并校验。我这次就是靠"红框页数 = 0"这个断言发现的。
坑 4:编号和内容对调了
现象:整理完重新生成,总页数 576 → 575,少了 1 页。
根因:改写文件路径时,我按"文件名的字面含义"推断编号,把同组的两项(力学性能 / 金相组织)弄反了。实际编号顺序和直觉顺序相反。
怎么发现的:像素比对——把两个文件逐页渲染成灰度图做相关性计算,7 组比对相似度全是 1.0000,确认是同一份文件,于是按正确编号修正,页数恢复 576。
教训:整理资料时,"编号 ↔ 内容"的对应关系必须实测,不要按命名直觉推断。像素指纹是个便宜又可靠的手段。
坑 5:引用悬空——标注说"截取自某处",但那里根本没有
现象:正文抽取页的角标写着"截取自 10.3.4 过程检验记录",但当资料被新版替换后,该页在该节里已经不存在了。对审核方来说这是硬伤:按角标去查,查不到。
解决:建立引用闭包校验——程序遍历所有"截取"类引用,逐个检查:
来源(文件名 + 页号)是否真实存在于目标节的页段范围内?
for section in SECTIONS:
    for ev in section.evidences:
        if ev.note.startswith("截取自"):
            target = parse_target(ev.note)
assert (ev.source_basename, ev.page) in provided_pages(target)成效:一次性查出 4 类悬空,当场修复 2 类,剩余 3 处明确列出待决。这个校验建议所有做资料汇编的人都用上。
坑 6:同一零件两张表,行号差 1
现象:某零件有"首件表"和"批量表"两张记录表,同一个尺寸在两张表里的行号不一样。
根因:批量表少了一行重复项,导致后续行号整体前移 1。而且三张表的序号编排还各不相同。
解决:逐页渲染 + 裁切序号列放大目视,逐页确定行号映射。三张表三种规则,绝不能套用。
教训:自动检测在这些"版式相近但细节不同"的扫描页上不够稳,目视放大核对是最可靠的兜底。
坑 7:双面打印,封面不能落在反面
需求:导出打印稿时,每份检测报告的封面必须落在正面(奇数页);某些分节页要独占一张纸(背面留白)。
做法:
for page in pages:
    if page.is_report_cover and (pos + 1) % 2 == 0:
        add_blank_page(size=page.size)   # 先补一页空白
    add(page)
pos += 1结果:7 份报告封面全部落在第 7 / 13 / 19 / 25 / 31 / 37 / 43 页(都是正面)。
坑 8:目标文件被占用
现象:os.replace() 报 WinError 5 拒绝访问——PDF 正被预览窗口打开。
解决:先写 .tmp 再原子替换;替换失败就另存带时间戳的文件,再用 copyfile 覆盖内容。
⚠️ 一个隐藏大坑:内容覆盖成功后,已经打开的窗口不会自动刷新,用户看到的还是旧版。验证时必须用 修改时间 + 文件哈希 + 首页文本 三重确认,不能只看文件名。
五、沉淀出的 3 条硬规则
1. 引用必达(闭包校验)
任何"截取自 X"的标注,来源必须能被程序验证真实存在。
2. 改名即改键
以文件名为键的配置,重命名后必须同步;改完必须重新生成 + 校验。
3. 编号 ↔ 内容必须实测
不按命名直觉推断对应关系。验证手段优先级:
像素指纹比对 > 结构校验(页数/书签/元素计数)> 目视抽查 > 文件名推断六、几个工程小技巧
场景 | 做法 |
|---|---|
中英混排数字间距怪 | 中文字体用 CJK 字体、ASCII 单独用西文字体分段渲染 |
标注压住扫描件上的二维码 | 只在贴合文字处铺小白底,不铺整条白条 |
长任务中断 | 后台任务 + 日志落盘,避免前台超时 |
大批量文件搬运 | 同盘用 |
破坏性操作 | 先备份、先列清单、逐批校验,只移动不删除 |
工具自动重跑 | 命令被"提权重跑"时会产生重复日志,以最终磁盘状态为准复核 |
七、脱敏说明与合规声明
本文已做完整脱敏,替换规则如下:
原信息类型 | 脱敏后 |
|---|---|
客户名称、公司名称 | 「某船舶配套企业」「我方公司」 |
产品型号、图号、规格参数 | 「某型液动执行器」 |
项目编号、内部表单编号 | 删除或写为「内部编号」 |
零部件具体名称 | 「某盘类件」「某轴类件」等通用表述 |
人员姓名、机构全称 | 删除 |
具体尺寸、公差、试验数据 | 删除(只保留方法论) |
具体日期 | 相对表述 |
文件路径 | 结构示意 |
脱敏原则:
- 最小必要——只保留方法论与通用技术,不保留任何可定位到具体项目/客户/人员的信息;
- 不可反推——任何单条信息都不足以反推出主体;
- 一致性——同类信息统一替换为同一代号,避免交叉比对;
- 等同公开物——脱敏后内容等同于一篇通用技术教程。
合规声明:内容为原创,无敏感信息、无商业机密、无第三方版权内容。
八、总结
这个任务最大的收获不是"拼出了一份 PDF",而是:
资料类工作的质量,取决于"可追溯"三个字。 每一页从哪来、每个标注指向哪、每次改动影响了什么——这些必须能被程序验证,而不是靠记忆和目测。
如果你也在做类似的资料整理 / 汇编工作,欢迎在评论区交流。上面这些坑,能少踩一个是一个。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号